

Python怎么获取集合(set)的长度
详细讲解在Python中获取集合(set与frozenset)长度的方法、内置len()函数的底层实现机制、O(1)时间复杂度原理,以及元素去重与等价键判定等关键边界注意事项。
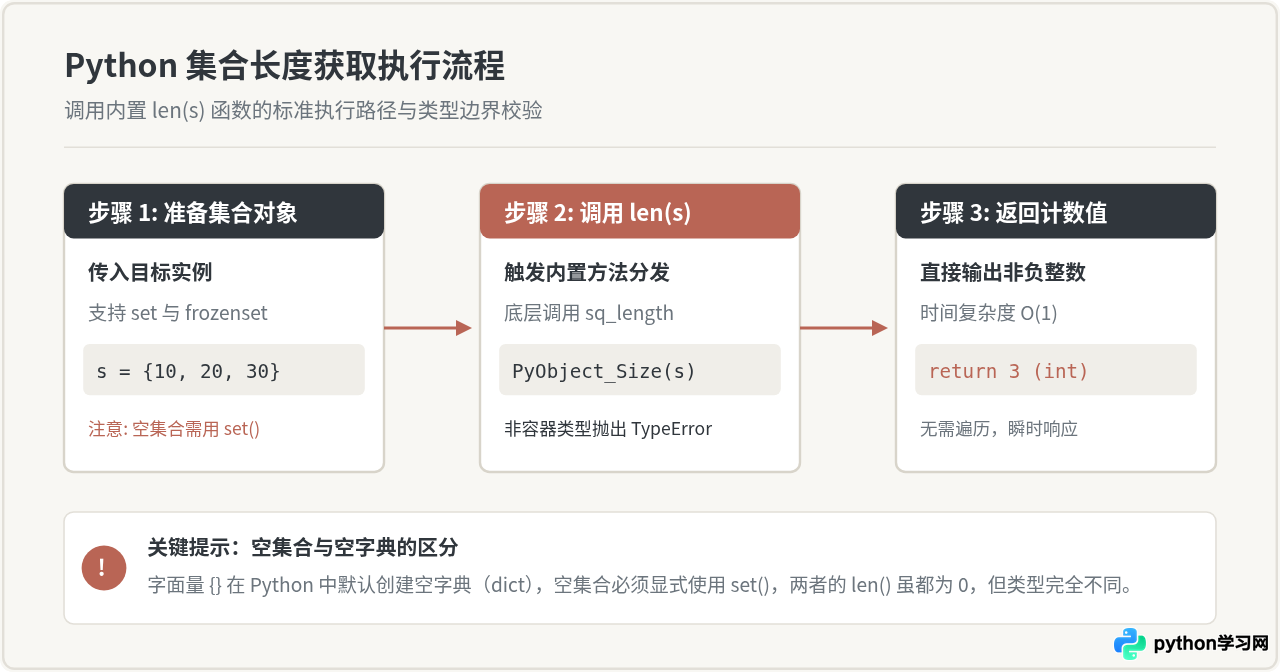
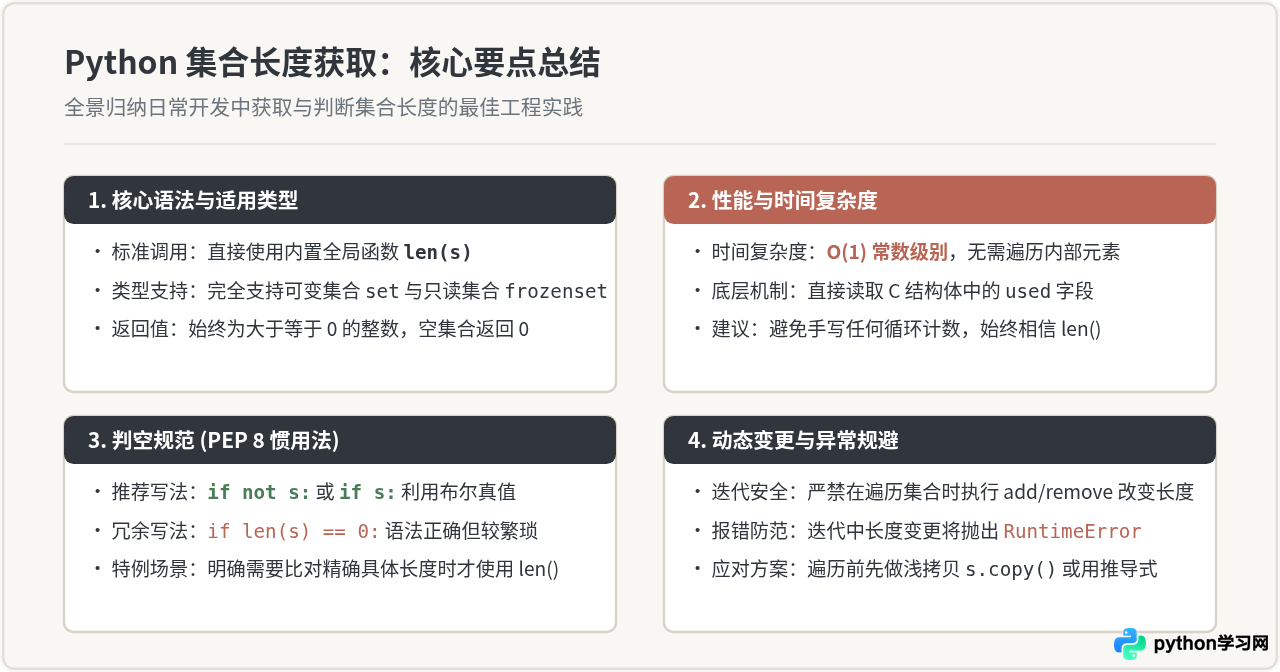
set 与不可变集合 frozenset)长度的标准且唯一推荐做法是使用内置全局函数 len()。该函数直接读取底层数据结构维护的元素计数字段,执行耗时恒定,时间复杂度为严格的 \(O(1)\)。
一、核心语法与基础使用
内置函数 len() 接收目标集合作为参数,直接返回该集合内当前所包含的唯一元素总数。返回值始终为非负整数(int)。
1. 常规集合长度获取
通过传入已经初始化的集合实例,即可立即获得其中的元素数量:
# 示例代码:获取包含不同类型元素的集合长度
fruits = {"apple", "banana", "orange", "grape"}
count = len(fruits)
print(f"集合 fruits 的长度为: {count}")

# 同样支持不可变集合 frozenset
frozen_nums = frozenset([10, 20, 30, 40, 50])
print(f"不可变集合 frozen_nums 的长度为: {len(frozen_nums)}")不可变集合 frozen_nums 的长度为: 5
2. 空集合的长度与初始化陷阱
集合为空时,len() 返回 0。但需要特别提醒初学者:在 Python 中定义空集合必须使用构造函数 set(),而不能使用大括号 {}。字面量 {} 在语法上专门用于创建空字典(dict)。
# 正确创建空集合
empty_set = set()
print("empty_set 长度:", len(empty_set))  # 输出 0
print("empty_set 类型:", type(empty_set))  # 输出 <class 'set'>

# 容易混淆的空字典
wrong_empty = {}
print("wrong_empty 长度:", len(wrong_empty))  # 长度虽也是 0
print("wrong_empty 类型:", type(wrong_empty)) # 但类型是 <class 'dict'>empty_set 类型: <class 'set'>
wrong_empty 长度: 0
wrong_empty 类型: <class 'dict'>
二、底层原理:为什么 len() 能达到 O(1) 性能
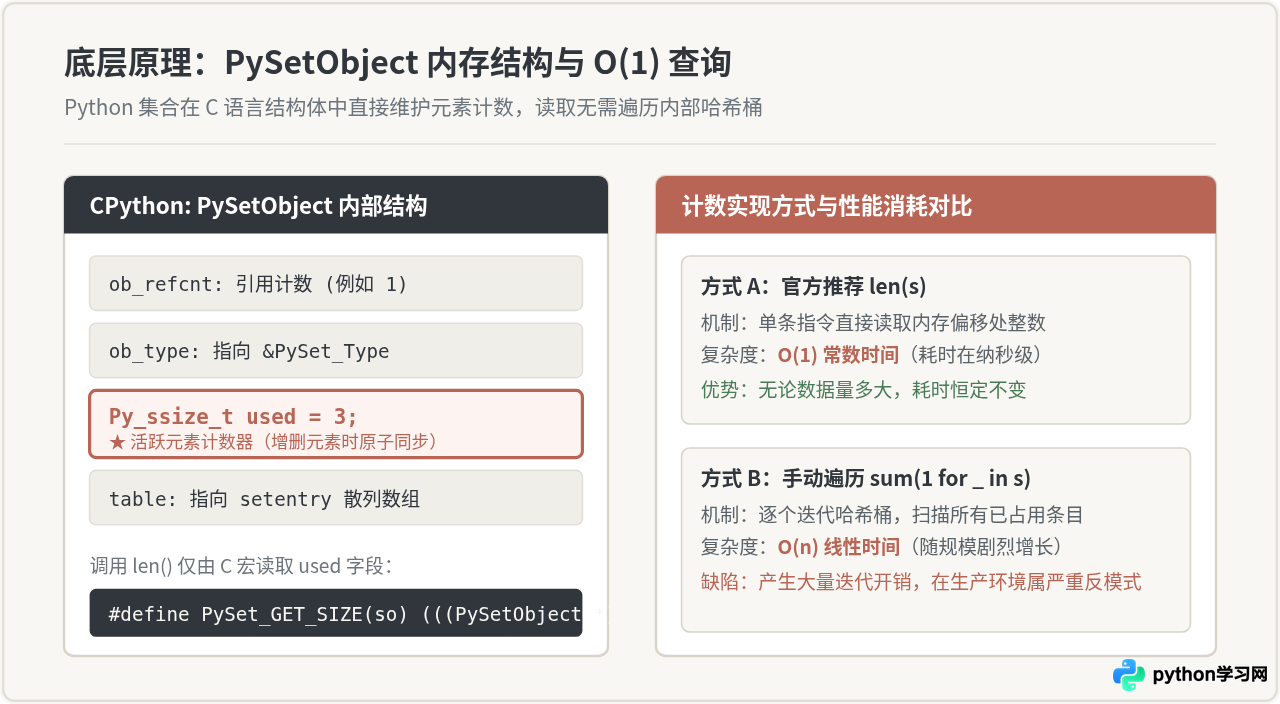
不少开发者会下意识地认为“集合是无序散列表,计算长度需要统计所有非空哈希桶”。但事实并非如此:len(s) 在 Python 中并不执行任何遍历操作。
1. CPython 中 PySetObject 的内部结构
在 Python 的官方 CPython 实现中,集合对应于 C 结构体 PySetObject。该结构体内部不仅包含底层哈希表指针 table,还专门维护了一个名为 used 的字段:
- 添加元素时:如果元素尚未存在于集合中,哈希表中写入该元素的同时,
used计数器直接加 1。 - 删除元素时:移除对应条目后,
used计数器同步减 1。 - 调用 len(s) 时:Python 解释器直接通过宏指令
PySet_GET_SIZE(so)访问结构体内存中的used变量并返回。
这意味着无论集合中包含 10 个元素,还是 10,000,000 个元素,获取长度的机器指令数完全相同。这是一项时间复杂度为 \(O(1)\) 的瞬时操作。
三、集合特性对长度计算的实际影响
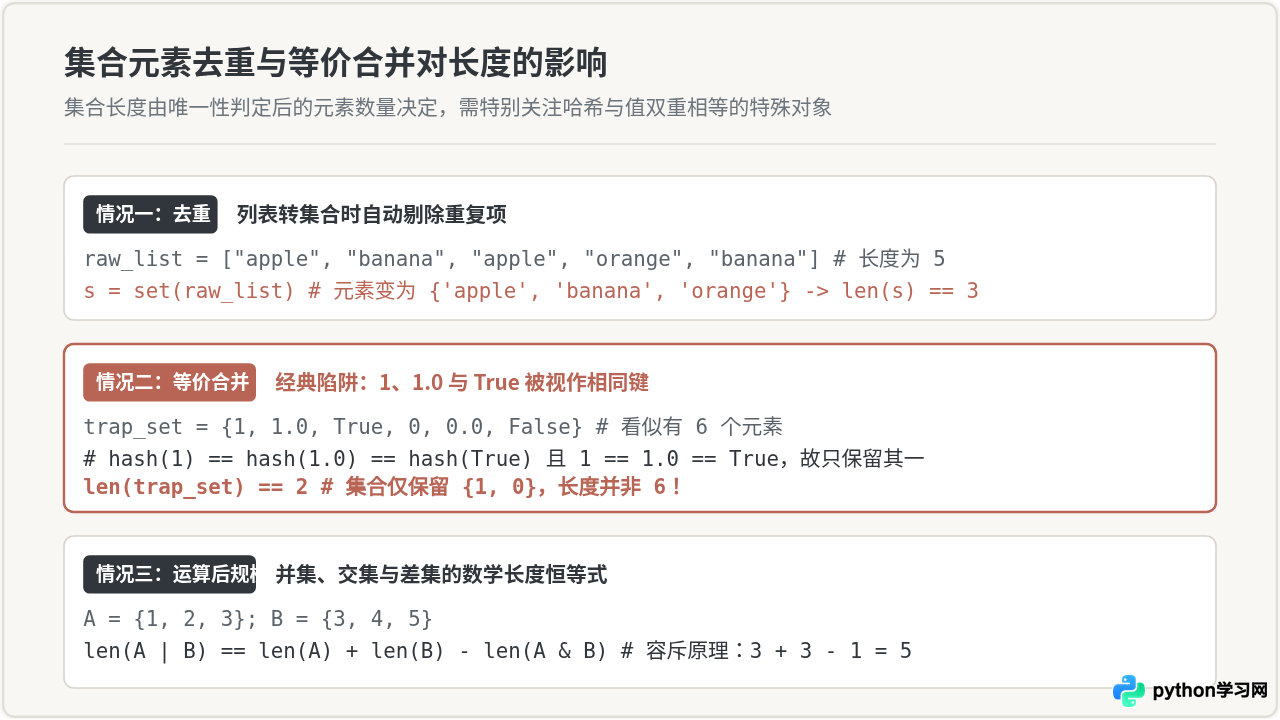
集合长度反映的是“互不相同”的元素个数。在实际业务中,许多开发者容易忽略集合的去重规则与等价键判定机制,从而对 len() 得到的结果产生困惑。
1. 列表去重后的长度缩减
利用 set(seq) 对序列去重是日常高频操作。转换后的集合长度通常小于或等于原列表长度:
raw_records = ["user_101", "user_102", "user_101", "user_103", "user_102"]
unique_records = set(raw_records)

print("原始列表长度:", len(raw_records))        # 长度为 5
print("去重后集合长度:", len(unique_records)) # 长度变为 3去重后集合长度: 3
2. 经典陷阱:数值与布尔类型的等价合并
Python 集合判断两个元素是否重复的标准是:二者的哈希值相等(hash(a) == hash(b))且值相等(a == b)。
在 Python 中,布尔类型 bool 是整数 int 的子类。因此:
1 == 1.0 == True均为真,且它们的哈希值均为1;0 == 0.0 == False均为真,且它们的哈希值均为0。
如果将它们放入同一个集合,后出现的项将被视为重复元素而忽略,最终计算出来的长度会远小于传入的项数:
# 包含整型、浮点型和布尔值的集合
confusing_set = {1, 1.0, True, 0, 0.0, False}

print("集合内容:", confusing_set)
print("集合计算长度:", len(confusing_set))集合计算长度: 2
避坑指南:如果你的业务逻辑需要区分数字 1 与布尔值 True,切勿直接将其放入集合中统计规模,否则会导致统计计数被动缩减。
四、工程实战:判空规范与动态修改风险
1. 集合判空:推荐写法的演进
当需要检测一个集合中是否包含元素时,新手常写 if len(s) == 0:。虽然这在语法上完全正确,但在 Python PEP 8 风格规范中,更推荐利用集合自身的布尔真值特性进行隐式判断:
active_sessions = set()

# 方式一:不推荐(虽然有效,但略显繁琐)
if len(active_sessions) == 0:
    print("没有活跃会话 (通过 len 判定)")

# 方式二:强烈推荐(Pythonic 惯用法)
if not active_sessions:
    print("没有活跃会话 (通过布尔真值判定)")
空集合在布尔上下文中自动评估为 False,非空集合评估为 True。除非业务场景必须精确比较具体的数量阈值(例如 len(s) > 5),否则判空应优先采用 if not s:。
2. 遍历中动态修改长度导致的 RuntimeError
Python 集合在遍历时会维护迭代状态。如果在迭代同一个集合的过程中添加或删除了元素导致其长度发生改变,解释器将立即抛出 RuntimeError:
numbers = {1, 2, 3, 4, 5}

try:
    for item in numbers:
        if item % 2 == 0:
            numbers.remove(item)  # 错误:遍历过程中动态缩减长度
except RuntimeError as err:
    print("捕获异常:", err)
安全修改方案:若需要在过滤条件满足时删除元素,应遍历集合的浅拷贝副本 numbers.copy(),或者直接使用集合推导式生成符合要求的新集合:
# 解决方案:使用集合推导式安全过滤
numbers = {1, 2, 3, 4, 5}
numbers = {x for x in numbers if x % 2 != 0}
print("过滤后的集合:", numbers, "新长度:", len(numbers))五、常见容器长度获取方式与特性对照
Python 的 len() 具有统一的多态接口,不同容器类型的计数原理与特性如下表所示:
| 容器类型 | 调用方式 | 时间复杂度 | 底层计数存储 | 长度受去重规则影响 |
|---|---|---|---|---|
| set(可变集合) | len(s) |
\(O(1)\) | PySetObject.used |
是(唯一性哈希去重) |
| frozenset(不可变集合) | len(s) |
\(O(1)\) | PySetObject.used |
是(创建时去重固化) |
| list(列表) | len(lst) |
\(O(1)\) | PyListObject.ob_size |
否(允许元素重复) |
| dict(字典) | len(d) |
\(O(1)\) | PyDictObject.ma_used |
是(键名唯一去重) |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









