

Python二分法查找end减一与不减一的区别:闭区间与开区间实现对比
深入对比Python二分查找中end减一与不减一的本质逻辑:闭区间与左闭右开区间的循环条件、指针收缩机制、死循环陷阱及模板选择指南。
end 初始化到底是 len(nums) - 1 还是 len(nums),以及在收缩区间时到底写 end = mid - 1 还是 end = mid,常常困扰许多开发者。其实这并不是死记硬背的代码习惯,其根本区别在于你所选择的区间定义(循环不变量)。本文通过几何图解、代码对照与边界推导,彻底理清闭区间 [left, right] 与左闭右开区间 [left, right) 的设计逻辑。
一、核心结论:区间定义决定指针操作
二分查找的本质是在一个有序序列中,通过不断将候选范围折半来定位目标值。在整个查找过程中,维护一个始终包含目标候选值的有效区间,称为循环不变量(Loop Invariant)。
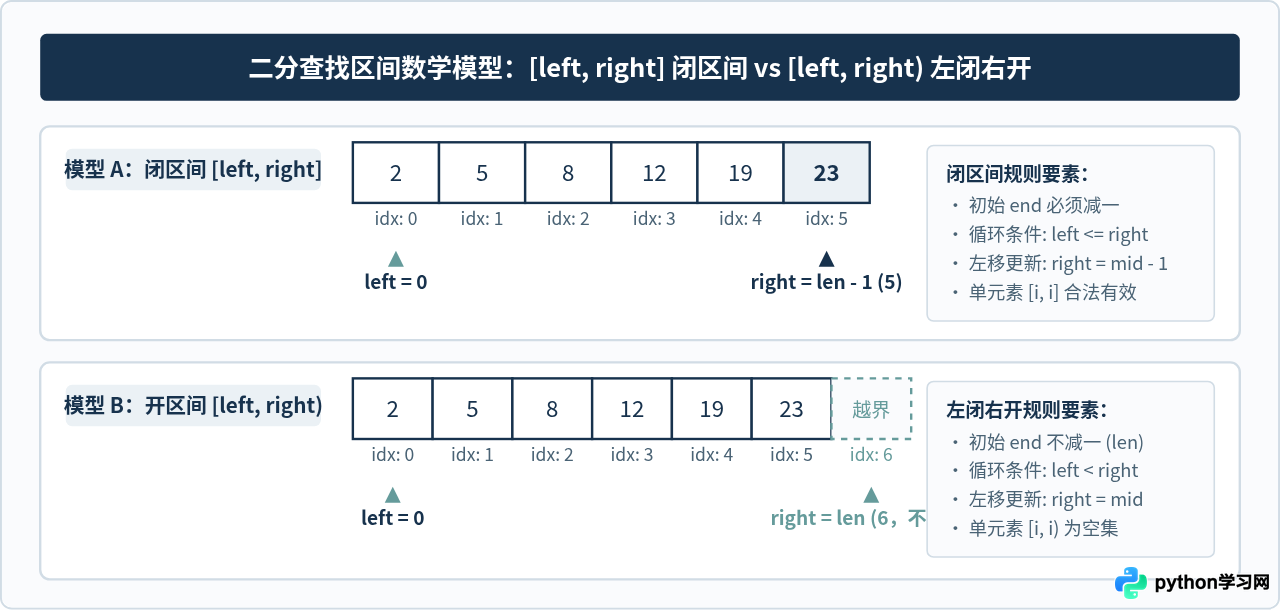
所谓的“减一”还是“不减一”,由两处代码协同决定:
- 初始化时:
end = len(nums) - 1代表候选范围是闭区间[left, right];而end = len(nums)则代表左闭右开区间[left, right)。 - 更新右边界时:当中间值大于目标值时,说明
mid处的元素已被排除。如果是闭区间,下一轮的右边界必须不包含mid,因此设为right = mid - 1;如果是左闭右开区间,右边界本身在数学上就是不包含的开端,因此直接设为right = mid即可将mid排除在有效搜索范围之外。
二、两套实现方案的代码与推导
为了看清内部机制,我们分别编写两套标准且符合 Python 规范的实现函数,并对照它们的每一处逻辑分支。
1. 方案一:闭区间写法(end 减一)
在闭区间模型中,我们认为区间 [left, right] 内的所有索引都是合法且待核验的候选。
def binary_search_closed(nums: list[int], target: int) -> int:
    left = 0
    right = len(nums) - 1  # 初始区间 [left, right] 包含最后一个有效元素

    while left <= right:   # 当 left == right 时,[left, right] 仍包含一个元素,需要继续判断
        mid = left + (right - left) // 2

        if nums[mid] == target:
            return mid
        elif nums[mid] < target:
            left = mid + 1  # target 在右半部分,排除当前 mid
        else:
            right = mid - 1 # target 在左半部分,排除当前 mid,右边界必须减一

return -1 # 未找到目标值- 为什么
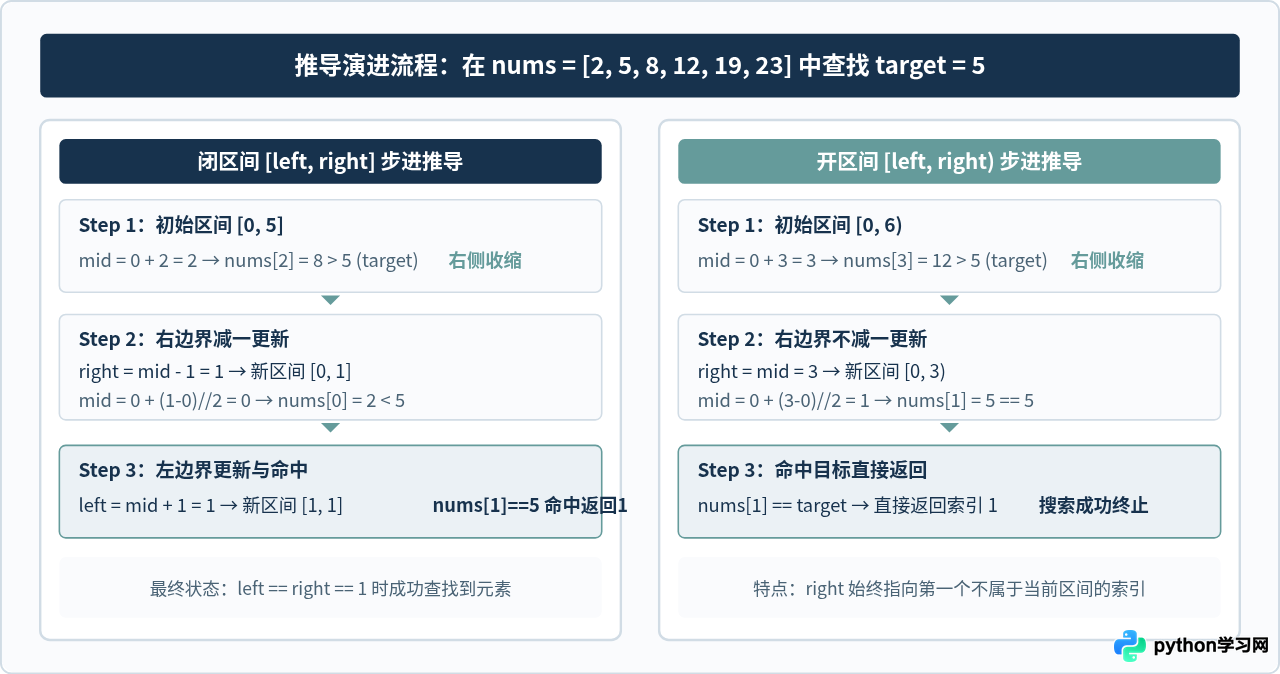
while left <= right? 当搜索缩减到只剩一个元素时,left == right。例如在[3, 3]中,索引 3 仍未与 target 进行比对,必须进入循环执行一次检查。 - 为什么
right = mid - 1? 当nums[mid] > target时,已知nums[mid]绝不可能是目标值。既然区间是两端闭合的,如果不把right移到mid - 1,下一次搜索范围[left, right]就会依然包含mid,这破坏了“待查区间”的不变量定义。
2. 方案二:左闭右开区间写法(end 不减一)
在左闭右开模型中,right 仅作为搜索边界的开端标记,表示“搜索范围包含 left,但直到 right 前一位为止(不包含 right)”。这与 Python 原生的 range(0, n) 和切片 nums[0:n] 逻辑完全一致。
def binary_search_half_open(nums: list[int], target: int) -> int:
    left = 0
    right = len(nums)      # 初始区间 [left, right),不减一,末位元素索引为 right - 1

    while left < right:    # 当 left == right 时,[left, right) 为空集,无元素可查,循环退出
        mid = left + (right - left) // 2

        if nums[mid] == target:
            return mid
        elif nums[mid] < target:
            left = mid + 1  # target 在右半部分,排除当前 mid
        else:
            right = mid     # target 在左半部分,排除当前 mid;因右边界开区间,设为 mid 即可排除

return -1 # 未找到目标值- 为什么
while left < right? 如果left == right,例如[4, 4),在数学定义上这是一个空区间,没有任何元素可以被访问。此时循环必须终止。 - 为什么
right = mid而不减一? 当nums[mid] > target时,我们需要排除mid。因为右边界本身不包含在候选范围内,将right设置为mid后,新的搜索区间变成[left, mid),它恰好包含left到mid - 1,完美排除了mid。
三、混用区间导致的典型错误与死循环根源
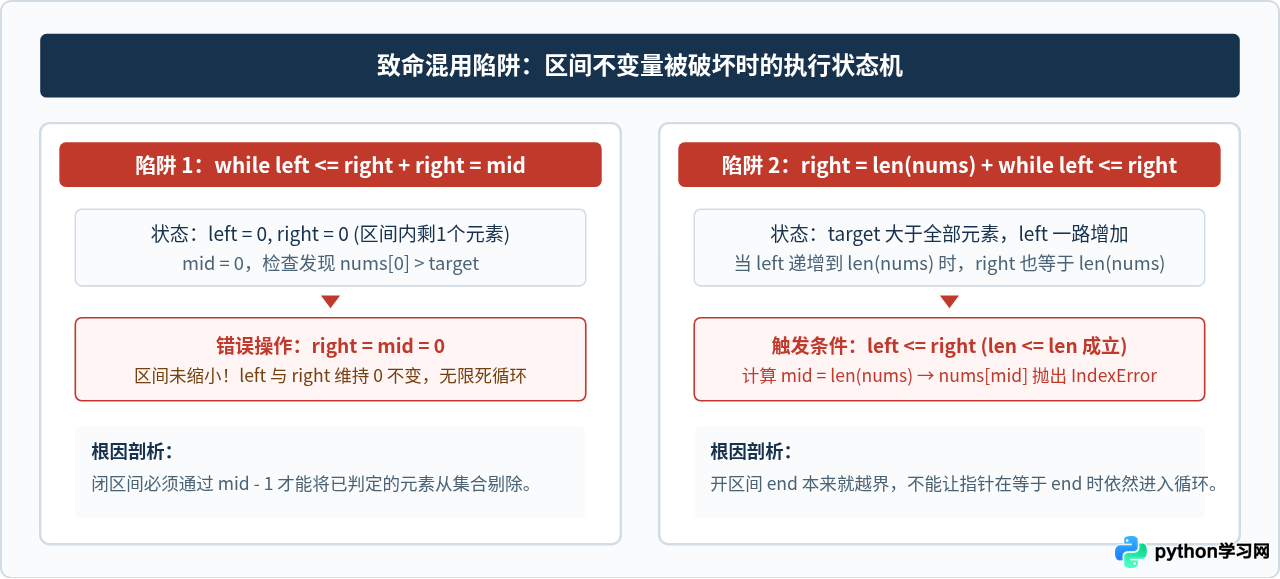
许多开发者在写二分查找时出现 Bug 或死循环,90% 以上的原因都是因为混淆了区间模型,把闭区间的循环条件和开区间的边界更新拼凑在了一起。
1. 错误案例一:闭区间条件下写了 right = mid(死循环)
如果在闭区间 while left <= right 下错误地把右侧收缩写成 right = mid,在查找不存在的数或数组仅剩两个元素时,极易陷入死循环。
例如当 nums = [2, 8],要找 target = 1:
- 初始状态:
left = 0, right = 1。 - 第一轮:
mid = 0,nums[0] = 2 > 1,执行right = mid = 0。 - 第二轮:
left = 0, right = 0,条件0 <= 0成立进入循环。计算mid = 0,由于nums[0] = 2 > 1,再次执行right = mid = 0。 - 指针永远停在
left = 0, right = 0,程序进入无限循环。
2. 错误案例二:开区间条件下写了 while left <= right(数组越界)
如果采用了 right = len(nums) 的开区间初始值,却在循环条件中写成 while left <= right:
- 当目标值比数组中所有元素都大时,
left会一路右移直到left = len(nums)。 - 因为条件是
left <= right,此时left == right == len(nums)依然满足循环条件! - 进入循环后计算
mid = len(nums),接着执行nums[mid],立即引发IndexError: list index out of range异常崩溃。
四、两套区间的对比与选型指南
两种方式在时间复杂度上完全一致,均为 \(O(\log n)\),在空间复杂度上也均为 \(O(1)\)。实际编码中应当如何选择?
| 对比维度 | 闭区间 [left, right] |
左闭右开区间 [left, right) |
|---|---|---|
初始 end 设置 |
len(nums) - 1(减一,指向末位元素) |
len(nums)(不减一,指向虚拟右界) |
| 循环继续条件 | while left <= right |
while left < right |
| 向左收缩(排除mid) | right = mid - 1 |
right = mid |
| 向右收缩(排除mid) | left = mid + 1 |
left = mid + 1 |
| 单元素区间表示 | [i, i](有效,含1个元素) |
[i, i+1)(有效,含1个元素) |
| 空区间判定 | left > right 时为空 |
left == right 时为空 |
| Python生态契合度 | 符合数学直觉,边界左右对称 | 完全契合 range() 与切片语法,契合标准库 bisect |
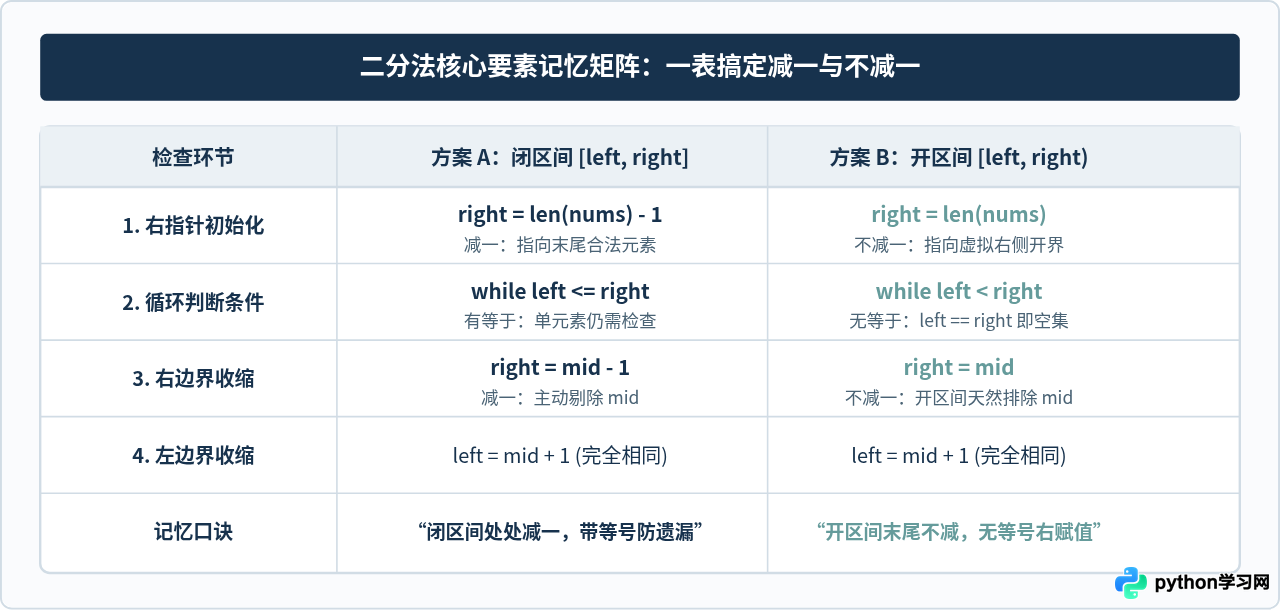
五、编写二分法的实践建议
- 选定一种形成肌肉记忆:在面试或日常算法题中,建议初学者固定使用闭区间模型(
len(nums) - 1与left <= right),因为它的左右边界更新形式都是对称的(left = mid + 1与right = mid - 1),最符合数学直觉,不容易遗漏减号。 - 处理切片和子区间时用开区间:如果你经常需要将二分找到的索引与 Python 的
range()、列表切片nums[:idx]或者标准库bisect.bisect_left()配合,左闭右开区间能让你的返回值直接作为切片右界,无需任何+1或-1修正。 - 牢记循环不变量:动手写代码前,先问自己一句:“我的
right指向的那个位置,到底还需不需要被检查?”如果是,就减一用闭区间;如果只是个哨兵边界,就不减一用开区间。始终保持初始状态、循环条件与收缩逻辑的一致性,就能彻底告别死循环与越界 Bug。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









