

Python新手必学的10个常用库及核心功能清单

针对Python初学者精选的10个核心常用库,详细整理核心功能清单、经典实操示例、常见混淆点辨析及学习选型指南。
一、认识Python生态:标准库与第三方库的分工
很多初学者在刚开始写代码时,常会遇到“这个功能到底需要额外安装还是直接导入”的困惑。Python的设计哲学被称为“自带电池”(Batteries Included),这意味着语言本身自带了功能完备的内置标准库,无需借助网络安装即可直接使用;而数据分析、网络爬虫、办公自动化等专业场景,则由活跃的开源社区提供了功能强大的第三方库。
理解这二者的分工是高效开发的第一步:内置库解决基础系统交互、数据结构与轻量计算;第三方库解决生产环境中的专业与高频业务需求。
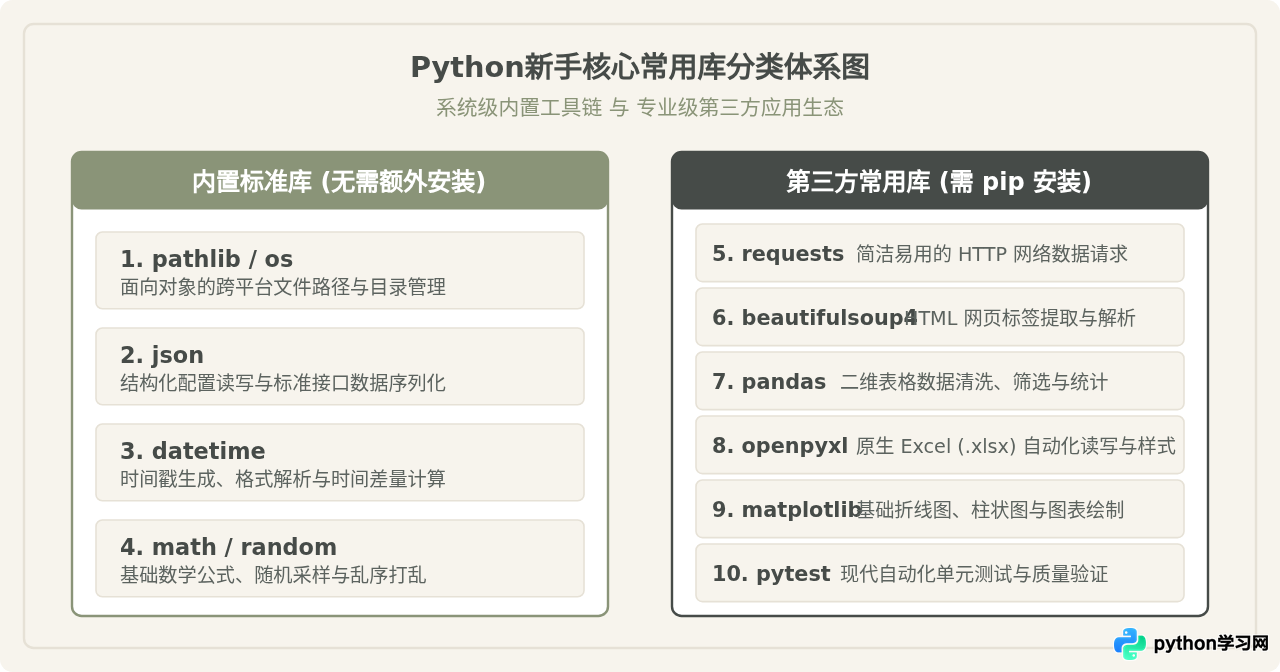
二、四款必备内置标准库:夯实底层脚本功底
1. pathlib 与 os:跨平台文件与目录处理
在早期的Python教程中,文件路径往往依靠 os.path 和字符串拼接。但在现代Python(3.6+)中,官方强烈推荐使用 pathlib.Path。它采用面向对象的方式封装路径操作,能自动处理 Windows 反斜杠(\)与 macOS/Linux 正斜杠(/)的差异,大幅减少路径书写错误。
- 核心定位:本地文件寻址、遍历目录、创建文件夹及检查文件属性。
- 高频方法:
Path.cwd()(当前路径)、path.exists()(是否存在)、path.mkdir(parents=True, exist_ok=True)(递归创建目录)、path.glob()(模式匹配搜索)。
from pathlib import Path

# 获取当前脚本所在目录并创建数据输出文件夹
base_dir = Path.cwd()
output_dir = base_dir / "data" / "reports"
output_dir.mkdir(parents=True, exist_ok=True)

# 写入纯文本文件
file_path = output_dir / "summary.txt"
file_path.write_text("Hello Python Pathlib", encoding="utf-8")

# 遍历所有 txt 文件并输出名称与大小(字节)
for item in output_dir.glob("*.txt"):
print(f"文件名: {item.name}, 大小: {item.stat().st_size} 字节")pathlib 负责绝大部分路径与文件属性操作;但当涉及系统底层环境变量读取(如 os.environ.get("API_KEY"))或进程退出控制(os._exit())时,依然需要导入 os 模块。二者是互补关系而非对立关系。
2. json:轻量级数据交换与配置读写
JSON 是现代网络通信、API 交互和本地程序配置的绝对事实标准。Python 的内置 json 库能在 Python 原生字典/列表与 JSON 字符串/文件之间实现无缝转换。
- 核心功能:内存转换(
json.dumps/json.loads)、文件流直读直写(json.dump/json.load)。 - 核心参数:
ensure_ascii=False(支持中文字符正确显示,防止转义为 unicode 码点)、indent=4(格式化美化输出)。
import json
from pathlib import Path

config = {
    "project": "DemoApp",
    "version": 1.2,
    "features": ["auth", "report"],
    "enabled": True
}

# 写入 JSON 配置文件
file_path = Path("config.json")
with open(file_path, "w", encoding="utf-8") as f:
    json.dump(config, f, ensure_ascii=False, indent=2)

# 读取并转换为 Python 字典
with open(file_path, "r", encoding="utf-8") as f:
    loaded_data = json.load(f)

print("加载的项目名称:", loaded_data["project"])
3. datetime:日期时间与时间戳计算
许多业务脚本需要打时间戳、记录日志时间或统计任务耗时。datetime 模块提供了 date、time、datetime 及 timedelta 四个核心类。
- 核心功能:获取当前时间(
datetime.now())、格式化为字符串(strftime)、字符串解析为时间对象(strptime)、时间跨度加减(timedelta)。
from datetime import datetime, timedelta

# 获取当前时间并自定义格式化输出
now = datetime.now()
print("当前格式化时间:", now.strftime("%Y-%m-%d %H:%M:%S"))

# 时间计算:计算 7 天后的日期
future_date = now + timedelta(days=7)
print("7天后日期:", future_date.strftime("%Y-%m-%d"))

# 将用户输入的文本解析为日期对象
input_str = "2026-10-01"
parsed_date = datetime.strptime(input_str, "%Y-%m-%d")
print("解析后的年份:", parsed_date.year)
4. math 与 random:基础计算与随机数控制
在需要进行数值处理、模拟随机抽样或洗牌时,math 与 random 提供了轻量且开箱即用的解决方案。
- math 核心功能:上取整
math.ceil()、下取整math.floor()、开平方math.isqrt()、常量math.pi。 - random 核心功能:闭区间随机整数
random.randint(a, b)、列表随机选择random.choice(seq)、无放回抽样random.sample(seq, k)、原地乱序打乱random.shuffle(list)。
import math
import random

# 数学运算
radius = 5
circle_area = math.pi * math.pow(radius, 2)
print("圆面积:", round(circle_area, 2))

# 随机抽样与打乱
candidates = ["Alice", "Bob", "Charlie", "David"]
winner = random.choice(candidates)
lucky_two = random.sample(candidates, 2)
print("幸运获奖者:", winner)
print("二等奖人选:", lucky_two)
三、六款高频第三方库:开启工程与实用项目大门
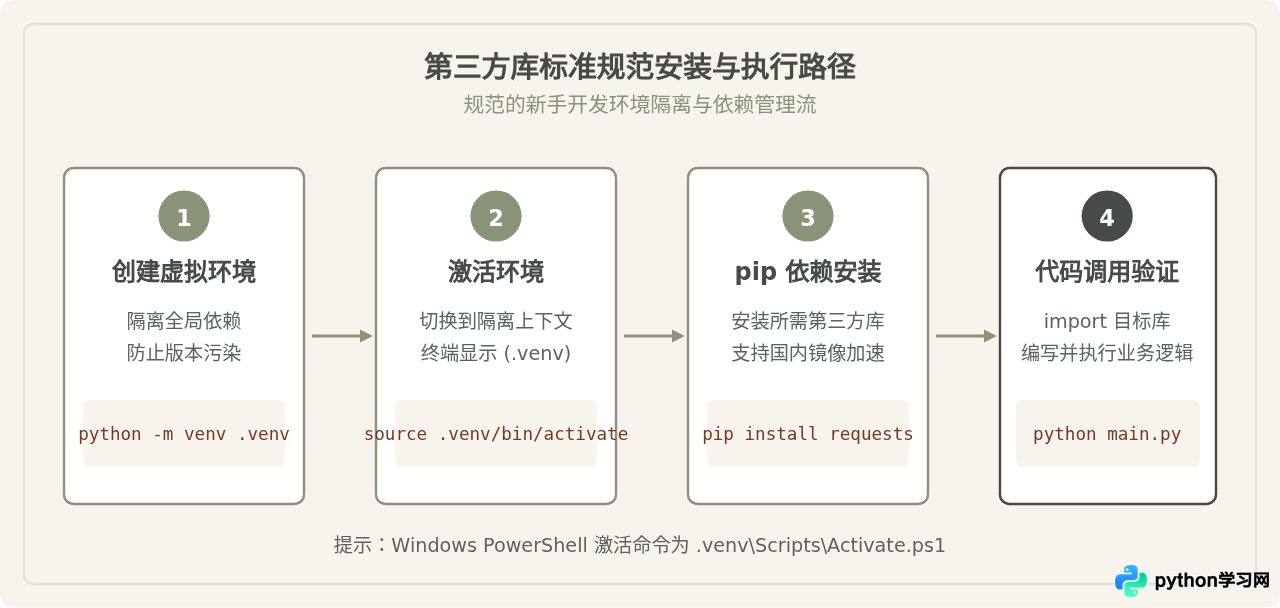
5. requests:优雅的 HTTP 请求客户端
Python 内置了 urllib 模块,但其 API 较为繁复且处理 Cookie、编码和会话时较为繁琐。第三方库 requests 以“人类友好的 HTTP”著称,已成为事实上的网络请求标准。
- 安装命令:
pip install requests - 核心功能:GET/POST 请求、自定义 Headers 与超时、自动解析 JSON 响应、持久化 Session。
import requests

url = "https://httpbin.org/get"
headers = {"User-Agent": "MyDemoApp/1.0"}
params = {"category": "python", "page": 1}

try:
    # 始终设置超时时间(timeout),避免网络阻塞导致程序无响应
    response = requests.get(url, headers=headers, params=params, timeout=5)
    response.raise_for_status()  # 状态码非 200 时自动抛出异常

    data = response.json()
    print("服务器响应参数:", data.get("args"))
except requests.exceptions.RequestException as e:
    print("网络请求失败:", e)
6. BeautifulSoup4 (bs4):轻量网页内容解析
当使用 requests 下载了网页 HTML 内容后,如何从中精准提取文本、超链接和图片地址?BeautifulSoup 提供了解析 DOM 树的最简易方式。
- 安装命令:
pip install beautifulsoup4 - 核心功能:CSS 选择器查找(
select/select_one)、标签属性获取(tag["href"])、纯文本提取(tag.get_text(strip=True))。
from bs4 import BeautifulSoup

html_doc = """
<div class="content">
    <h1>文章标题</h1>
    <ul class="item-list">
        <li><a href="/item/1">项目一</a></li>
        <li><a href="/item/2">项目二</a></li>
    </ul>
</div>
"""

soup = BeautifulSoup(html_doc, "html.parser")

# 通过 CSS 类选择器定位
title = soup.select_one("div.content h1").get_text(strip=True)
print("提取标题:", title)

# 批量提取超链接
for link in soup.select("ul.item-list li a"):
    print(f"文本: {link.get_text()}, 链接: {link['href']}")
7. pandas:结构化数据清洗与统计分析
在需要处理 CSV、Excel 或数据库导出的多维表格数据时,pandas 提供了类似 SQL 和 Excel 聚合运算的强大接口。其核心结构为一维的 Series 和二维的 DataFrame。
- 安装命令:
pip install pandas - 核心功能:读取文件(
read_csv)、条件过滤、缺省值填充、按组聚合(groupby)、结果导出。
import pandas as pd

# 创建示例数据表格
data = {
    "姓名": ["张三", "李四", "王五", "赵六"],
    "部门": ["技术", "运营", "技术", "市场"],
    "成绩": [88, 92, 79, 85]
}
df = pd.DataFrame(data)

# 过滤技术部员工
tech_team = df[df["部门"] == "技术"]
print("技术部门人员:\n", tech_team)

# 计算各部门平均分
avg_score = df.groupby("部门")["成绩"].mean().reset_index()
print("各部门平均成绩:\n", avg_score)pandas.read_csv()。若数据量很小或只需遍历行,内置的 csv 库更为轻量。pandas 的真正威力在于批量向量化计算、多表连接(Merge)与分组统计。
8. openpyxl:原生 Excel 文件自动化处理
openpyxl 是专门用来读写 Office Open XML(即 .xlsx 格式)的专业库。与 pandas 侧重数据统计不同,openpyxl 能够精确控制工作表名称、单元格公式、字体颜色、边框和合并单元格。
- 安装命令:
pip install openpyxl - 核心功能:创建工作簿(
Workbook)、单元格坐标定位(ws['A1'])、设置公式与字体样式。
from openpyxl import Workbook
from openpyxl.styles import Font, PatternFill

# 新建 Excel 工作簿
wb = Workbook()
ws = wb.active
ws.title = "销售汇总"

# 写入表头并添加背景色
headers = ["品类", "单价", "数量", "总额"]
ws.append(headers)

header_fill = PatternFill(start_color="EFECE4", fill_type="solid")
for col in range(1, 5):
    cell = ws.cell(row=1, column=col)
    cell.font = Font(bold=True)
    cell.fill = header_fill

# 写入数据行与 Excel 公式
ws.append(["键盘", 150, 3, "=B2*C2"])
ws.append(["鼠标", 80, 5, "=B3*C3"])

# 保存文件
wb.save("sales_report.xlsx")
print("Excel 文件已成功生成!")
9. matplotlib:轻量级数据可视化
matplotlib.pyplot 是 Python 绘图生态的基石。掌握它可以将冰冷的数据快速转换为直观的折线图、柱状图或散点图。
- 安装命令:
pip install matplotlib - 核心功能:图表绘制(
plot/bar)、轴标签与标题设置(xlabel,title)、保存图像(savefig)。
import matplotlib.pyplot as plt

# 准备月份与销售量数据
months = ["1月", "2月", "3月", "4月", "5月"]
sales = [12, 19, 15, 25, 22]

# 绘制折线图
plt.figure(figsize=(6, 4))
plt.plot(months, sales, marker="o", color="#8A9478", linewidth=2)
plt.title("月度产品销量趋势图")
plt.xlabel("月份")
plt.ylabel("销量 (单位: 百件)")
plt.grid(True, linestyle="--", alpha=0.5)

# 保存图表至本地
plt.savefig("sales_trend.png", dpi=150, bbox_inches="tight")
plt.close()
print("图表已保存为 sales_trend.png")
10. pytest:现代工程化测试框架
Python 虽然自带了 unittest 模块,但它沿用了 Java JUnit 的风格,必须继承 TestCase 类并使用专有断言方法。而第三方框架 pytest 允许直接使用 Python 原生 assert 关键字,语法简洁且生态极其健全。
- 安装命令:
pip install pytest - 核心功能:自动发现以
test_开头的文件与函数、原生断言提示、夹具(fixture)依赖注入。
# 业务函数
def calculate_discount(price, discount_rate):
    if not 0 <= discount_rate <= 1:
        raise ValueError("折扣率必须在 0 到 1 之间")
    return round(price * (1 - discount_rate), 2)

# 测试用例函数(函数名以 test_ 开头)
def test_normal_discount():
    assert calculate_discount(100, 0.2) == 80.0

def test_zero_discount():
    assert calculate_discount(100, 0) == 100.0

# 运行方式:在项目根目录终端执行命令 `pytest`
四、任务驱动:新手选库决策路径
面对具体的实际任务,很多初学者容易盲目堆砌依赖。为了让选型更有章可循,可以参考下面的场景决策路径:
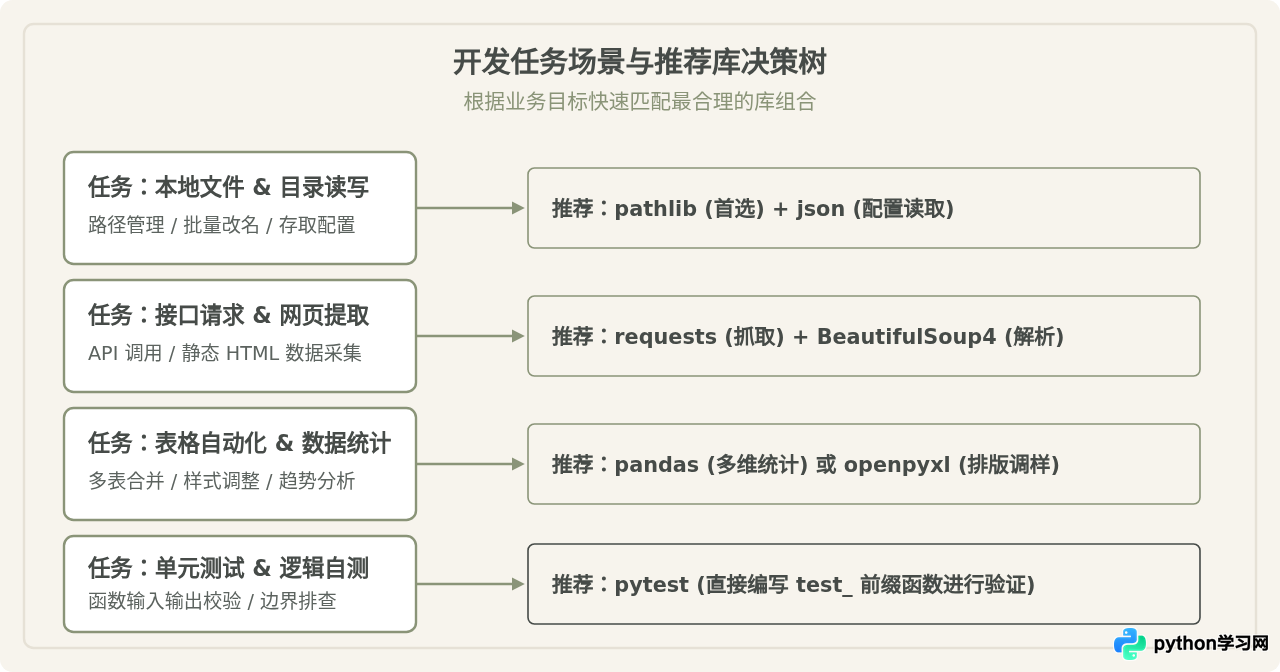
五、10个常用库核心功能对照清单与避坑指南
为了便于查阅与长期参考,下表汇总了这10个核心库的模块名称、类型归属、关键函数及新手最容易遇到的典型问题:
| 库名称 | 类型 | 主要应用场景 | 核心高频方法/类 | 新手避坑要点 |
|---|---|---|---|---|
| pathlib | 内置标准库 | 路径拼接、文件操作 | Path.cwd(), mkdir(), glob() |
避免继续使用 + 进行字符串拼接,直接用 / 符号。 |
| json | 内置标准库 | 配置文件存取、接口解析 | load(), dump(), loads() |
保存中文内容时必须加上 ensure_ascii=False。 |
| datetime | 内置标准库 | 时间戳生成、耗时计算 | datetime.now(), strftime(), timedelta |
区分大小写格式符:%m 为月份,%M 为分钟。 |
| math / random | 内置标准库 | 数学运算、随机抽样 | ceil(), randint(), choice() |
random.randint(a, b) 包含两端端点值。 |
| requests | 第三方库 | HTTP 网络交互、API 请求 | get(), post(), json() |
务必设置 timeout 参数,避免网络无响应引起挂起。 |
| beautifulsoup4 | 第三方库 | HTML 文本与网页数据提取 | select(), select_one(), get_text() |
find() 返回单一节点,找不到时返回 None,直接取属性会抛 AttributeError。 |
| pandas | 第三方库 | 表格数据清洗、过滤统计 | read_csv(), groupby(), to_excel() |
多条件过滤时必须用括号隔开,如 (df['a'] > 1) & (df['b'] < 5)。 |
| openpyxl | 第三方库 | Excel 文件排版与样式生成 | Workbook(), cell(), save() |
单元格行列索引从 1 开始计(非 0 开始),与常规列表切片不同。 |
| matplotlib | 第三方库 | 基础数据图表可视化 | plot(), bar(), savefig() |
中文字体可能出现方块乱码,需显式设置 plt.rcParams['font.sans-serif']。 |
| pytest | 第三方库 | 自动化测试与代码自检 | assert, fixture, mark.parametrize |
测试脚本与测试函数名必须以 test_ 开头才会被自动识别。 |
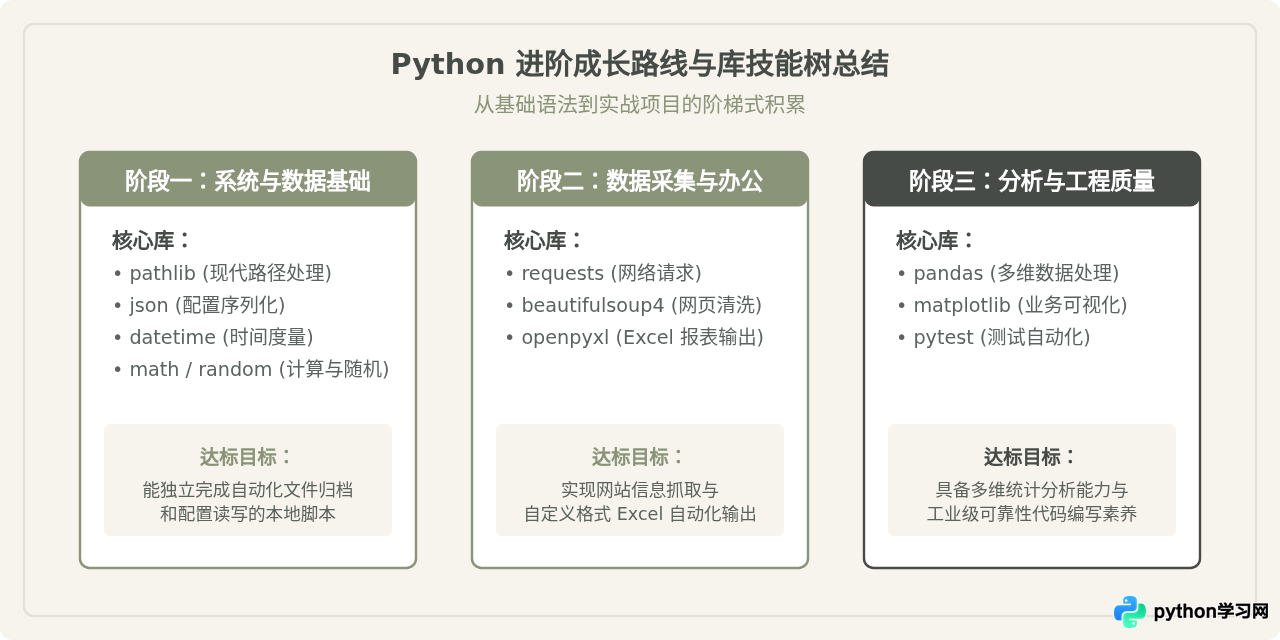
六、新手高效学习与实践建议
在掌握这10个库的过程中,初学者往往容易陷入“阅读了文档却写不出程序”的窘境。结合实际开发经验,以下三条习惯能帮助你快速将知识转化为肌肉记忆:
- 使用虚拟环境(venv)管理依赖:养成每个项目独立建立
.venv的习惯,避免因全局安装不同版本的第三方库导致包冲突报错。 - 坚持“小步跑通”原则:每次只引入一个库解决一个微型问题(如先只用
pathlib找到文件,再用json读取),确认无误后再将各模块串联为完整流水线。 - 善用终端帮助文档:在 Python 交互模式中输入
help(模块名.函数名)或dir(对象),可以快速查看参数列表与可用方法,无需频繁切出编辑器查询搜索引擎。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









