

Python新手必装的10个常用库及pip安装教程
面向Python新手的完整实用指南:系统讲解pip包管理工具的安装、镜像加速配置、运行机制与环境排查,并精选网络请求、数据处理、自动化办公及工程测试等领域的10个核心第三方库,附带具体代码示例与避坑建议。
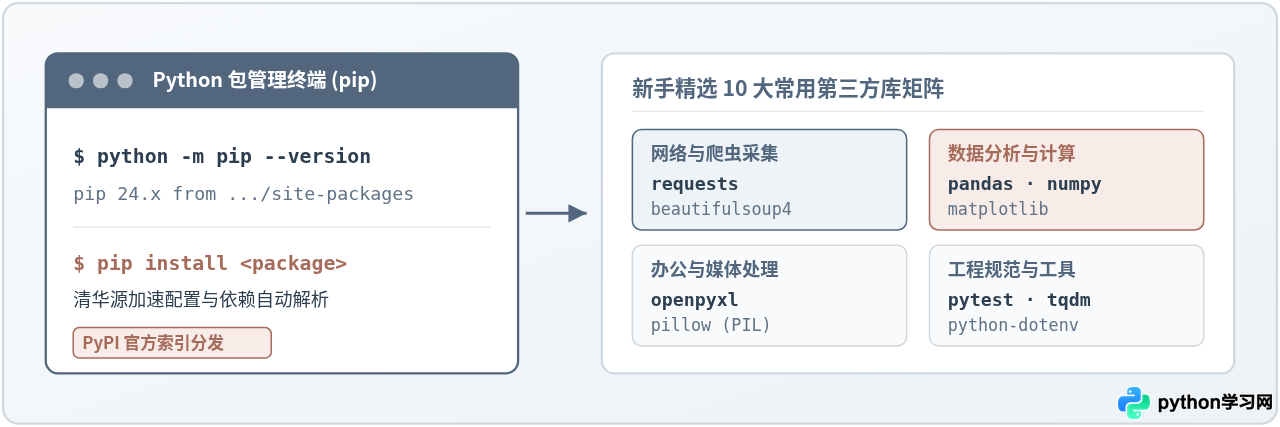
刚安装完 Python 解释器时,内置的“电池”(标准库)虽能满足基础数学运算和常规文件读取,但在面对现代开发中的网络请求、Excel 表格处理、数据清洗与工程测试时,原生写法往往冗长且难以维护。Python 生态之所以繁荣,关键在于其拥有庞大且成熟的第三方开源库。而获取并管理这些库的标准官方工具就是 pip。掌握 pip 的规范用法与排查方法,并熟练运用最核心的 10 个第三方库,是新手脱离简单语法练习、真正进入实际项目开发的基础路径。
一、pip 包管理工具的认知与核心命令
pip 是 Python 官方推荐的软件包管理系统,其名称意为“Pip Installs Packages”。自 Python 3.4 起,官方安装包已经默认集成了 pip,读者在安装 Python 时只要勾选了“Add Python to PATH”或标准可选组件,系统便已具备 pip 运行环境。
在命令行终端(Windows 的 CMD / PowerShell,macOS / Linux 的 Terminal)中,新手往往习惯直接输入 pip install 包名。虽然这在单一 Python 环境下可以运行,但一旦电脑中同时存在多个 Python 版本(如系统自带版本、Anaconda 版本或编辑器新建的虚拟环境),直接调用 pip 极易将包安装到错误的 Python 目录中。因此,强烈建议始终采用带有解释器前缀的显式命令:
# 规范推荐写法:确保 pip 与当前调用的 python 严格对应
python -m pip <subcommand>
以下是日常开发中使用频率最高的核心命令汇总:
- 查看 pip 版本与关联环境:
python -m pip --version
该命令会打印 pip 版本号以及当前所绑定的解释器site-packages物理路径。 - 安装指定第三方库:
python -m pip install 库名
例如安装网络库:python -m pip install requests。若需指定版本,可使用等号:python -m pip install requests==2.31.0。 - 升级已有库到最新版:
python -m pip install --upgrade 库名(简写为-U)。 - 查看已安装的全部库:
python -m pip list
以列表形式展示当前环境下所有第三方包及其版本号。 - 查看单个库的详细信息与存放位置:
python -m pip show 库名
展示包名、版本、作者、依赖项以及具体安装在磁盘的哪个文件夹。 - 卸载不再使用的库:
python -m pip uninstall 库名
根据终端提示输入y确认即可干净移除该包。
二、国内镜像源配置与网络加速教程
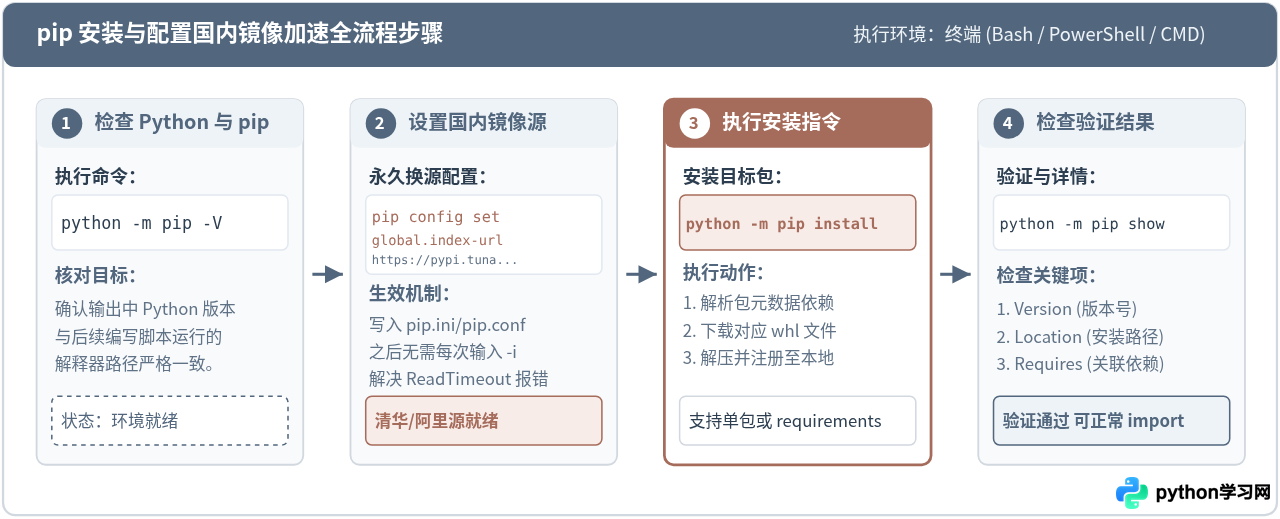
许多初学者在第一次执行 pip install 时,终端常在 Collecting ... 处停滞不前,最终抛出 ReadTimeoutError 或连接重置错误。这是因为 pip 默认连接的是位于国外的官方 PyPI(Python Package Index)主服务器。在国内网络环境下,从官方源下载几十兆的文件极易因网络抖动超时。
解决这一问题的标准做法是切换为国内知名机构提供的同步镜像源(这些镜像站通常每隔数分钟与官方 PyPI 完全同步一次,内容完全一致且带宽充裕)。常用稳定镜像源地址如下:
| 镜像服务提供方 | 镜像源地址 URL | 特性说明 |
|---|---|---|
| 清华大学开源软件镜像站 (TUNA) | https://pypi.tuna.tsinghua.edu.cn/simple |
国内主流推荐,同步速度极快,高可用性稳定 |
| 阿里云镜像站 | https://mirrors.aliyun.com/pypi/simple/ |
全国 CDN 节点丰富,企业级网络环境访问优异 |
| 腾讯云镜像站 | https://mirrors.cloud.tencent.com/pypi/simple/ |
云服务器与华南地区访问延迟极低 |
| 中国科学技术大学 (USTC) | https://pypi.mirrors.ustc.edu.cn/simple/ |
高校老牌镜像,稳定性与带宽兼备 |
1. 临时指定镜像源安装
如果只是偶尔临时加速某一个包的安装,可以使用 -i 参数后接镜像源地址:
# 临时使用清华镜像源下载 requests 库
python -m pip install requests -i https://pypi.tuna.tsinghua.edu.cn/simple
2. 永久配置镜像源(一劳永逸)
每次手动输入长网址既繁琐又易出错。通过 pip 自带的 config 指令,可以直接将镜像源持久化写入本机的全局配置文件中:
# 写入全局镜像配置(Windows、macOS、Linux 通用)
python -m pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple
执行该命令后,终端会打印出配置文件的生成路径(如 Windows 上的 %APPDATA%\pip\pip.ini 或 macOS/Linux 上的 ~/.config/pip/pip.conf)。此后直接执行 python -m pip install 包名,pip 会自动默认从清华大学镜像站高速下载,彻底告别超时困扰。
三、pip 安装机制与 Python 解释器运行架构
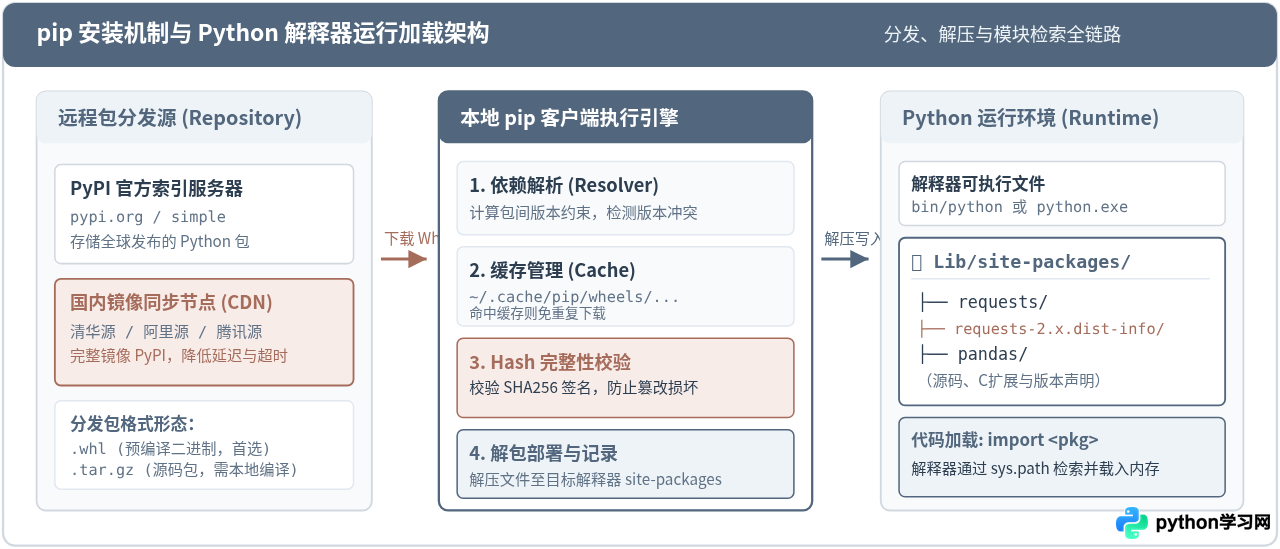
为了在遇到报错时具备独立排查能力,理解 pip 在操作系统背后所做的事情十分关键。表面上只是一行命令,背后实际经历了网络请求、依赖计算、解压和注册的全过程:
- 解析元数据与依赖关系:当请求安装某个库时,pip 首先拉取该库的最新元数据,并根据当前 Python 版本及操作系统架构,计算其依赖的所有子包。如果依赖之间存在版本约束,pip 的依赖解析器(Resolver)会自动寻找兼容的版本组合。
- 下载 Wheel 二进制分发包:Python 第三方包目前绝大多数以
.whl(Wheel)格式分发。Wheel 是官方标准的预编译压缩格式。如果本地缓存(位于系统 Cache 目录)已有该包,pip 会直接使用缓存;若没有则下载后落盘。 - 解压并存入 site-packages:下载完成后,pip 将其解压至当前 Python 解释器专用的
Lib/site-packages/目录下,同时生成一个包含版本声明、安装清单与文件 Hash 的.dist-info文件夹。 - 运行时检索(Runtime Search):当我们在 Python 脚本中执行
import xxx时,Python 解释器会遍历sys.path路径列表,并在site-packages中找到该目录并将其加载进内存运行。
四、Python新手必装的10个常用库详解
在面对 PyPI 上数十万个软件包时,新手最容易陷入“不知道学哪个、盲目堆砌工具”的困惑。以下甄选的 10 个库均经过长期工业界检验,涵盖了网络交互、数据分析、办公自动化与工程开发等核心方向,是初学者快速构建实用技能树的基石。
1. requests —— 优雅直观的 HTTP 网络请求库 网络通信必选
定位与解决的问题:在没有 requests 之前,Python 开发者需要使用内置的 urllib 模块发送网络请求,其代码繁冗、Cookie 与会话管理反人类。requests 践行“HTTP for Humans”哲学,通过清晰明了的 API,使新手能够用几行代码轻松发起 GET、POST 等各类请求,支持自动处理请求头、编码判断与 JSON 结果解析。
安装命令:python -m pip install requests
典型使用示例:
import requests

# 访问公开的测试 API
url = "https://httpbin.org/get"
params = {"query": "python_learning", "page": 1}
headers = {"User-Agent": "MyPythonClient/1.0"}

try:
    # 始终养成显式传递 timeout 超时参数的习惯(单位:秒)
    response = requests.get(url, params=params, headers=headers, timeout=5)

    # 状态码判断(200 为成功)
    if response.status_code == 200:
        data = response.json()  # 直接将响应正文解析为 Python 字典
        print("请求成功,远端返回参数:", data.get("args"))
    else:
        print(f"请求失败,HTTP 状态码: {response.status_code}")
except requests.exceptions.RequestException as e:
    print(f"网络通信发生异常: {e}")
timeout 参数。若目标服务器无响应,程序将永远阻塞挂起。务必始终指定合理的超时秒数。
2. beautifulsoup4 —— 网页 HTML/XML 数据提取解析器 爬虫入门利器
定位与解决的问题:当我们用 requests 拿到网页的 HTML 源代码后,如何把新闻标题、商品价格或文章正文提取出来?用正则表达式不仅书写容易出错,而且面对杂乱的 HTML 容错率极低。beautifulsoup4(通常简称为 bs4)能将 HTML 源码构建成一棵树状结构,允许通过 CSS 选择器或标签属性快速定位目标内容。
安装命令:python -m pip install beautifulsoup4
典型使用示例:
from bs4 import BeautifulSoup

# 示例 HTML 片段
html_doc = """
<div class="content">
    <h1>Python 入门指南</h1>
    <ul class="book-list">
        <li class="item"><a href="https://example.com/1">基础语法篇</a></li>
        <li class="item"><a href="https://example.com/2">函数与模块篇</a></li>
    </ul>
</div>
"""

# 使用 Python 内置的 html.parser 解析器
soup = BeautifulSoup(html_doc, "html.parser")

# 提取大标题文本(strip=True 去除首尾空白)
title_text = soup.find("h1").get_text(strip=True)
print(f"文章大标题: {title_text}")

# 遍历所有链接标签并提取超链接与锚文本
for a_tag in soup.find_all("a"):
    link_url = a_tag.get("href")
    link_text = a_tag.get_text(strip=True)
    print(f"链接名称: {link_text} -> 地址: {link_url}")
3. pandas —— 结构化表格数据分析与处理事实标准 数据分析核心
定位与解决的问题:在现实业务中,绝大多数数据都以 CSV、Excel 或数据库二维表的形式存在。内置的 csv 模块只能按行读写字符串,而 pandas 引入了类似电子表格的核心数据结构 DataFrame。它提供了强大的数据过滤、去重、缺失值填补、分组统计(groupby)和跨表合并能力,是 Python 成为数据科学领域首选语言的关键推手。
安装命令:python -m pip install pandas
典型使用示例:
import pandas as pd

# 构建模拟的销售数据字典
raw_data = {
    "城市": ["北京", "上海", "广州", "北京", "深圳", "上海"],
    "产品": ["笔记本", "平板", "笔记本", "台式机", "手机", "笔记本"],
    "销售额": [8500, 4200, 7800, 6200, 3900, 9100]
}

df = pd.DataFrame(raw_data)

# 1. 条件筛选:销售额大于 5000 的记录
high_sales = df[df["销售额"] > 5000]
print("高销售额记录:")
print(high_sales)

# 2. 按城市聚合统计总销售额与平均额
city_summary = df.groupby("城市")["销售额"].agg(["sum", "mean"]).rename(
    columns={"sum": "总销售额", "mean": "平均销售额"}
)
print("\n按城市统计销售指标:")
print(city_summary)
4. numpy —— 高性能多维科学计算与矩阵运算基石 底层数值计算
定位与解决的问题:Python 自带的列表(list)是一个通用对象容器,内部存储的是对象的指针,在执行海量数值运算时需要频繁寻址与类型检查,效率极低。numpy(Numerical Python)采用连续内存块存储同构数据类型,底层用 C 语言实现矢量化指令运算。它是 pandas、scipy、OpenCV、PyTorch 等众多科学计算与机器学习库共同的底层依赖。
安装命令:python -m pip install numpy
典型使用示例:
import numpy as np

# 将普通 Python 列表转为 numpy 数组 (ndarray)
arr = np.array([10, 20, 30, 40, 50], dtype=np.float64)

# 矢量化运算:对所有元素统一乘以 1.5 并加 5,无须写显式 for 循环
transformed = (arr * 1.5) + 5
print("矢量变换后数组:", transformed)

# 计算常用统计量
print(f"均值: {np.mean(transformed)}, 方差: {np.var(transformed)}, 最大值: {np.max(transformed)}")

# 创建 2x3 二维矩阵并进行转置变换
matrix = np.array([[1, 2, 3], [4, 5, 6]])
print("原矩阵形状:", matrix.shape)
print("转置后矩阵形状:", matrix.T.shape)
5. matplotlib —— 专业 2D 统计图表可视化绘图库 图形绘制
定位与解决的问题:数据经过清洗与计算后,直观呈现结论离不开图表。matplotlib(及其子模块 pyplot)是 Python 生态中最经典的绘图工具,能够绘制高质量的折线图、柱状图、散点图、直方图以及热力图,支持极其细致的图例、坐标轴、刻度与标注自定义。
安装命令:python -m pip install matplotlib
典型使用示例:
import matplotlib.pyplot as plt

# 模拟月份与对应的访问量数据
months = ["1月", "2月", "3月", "4月", "5月"]
visits = [1200, 1900, 2800, 3100, 4200]

# 创建图表画布与坐标系
fig, ax = plt.subplots(figsize=(7, 4), dpi=100)

# 绘制折线图并设置样式
ax.plot(months, visits, marker="o", color="#52677D", linewidth=2, label="月度活跃量")
ax.set_title("季度网站访问量增长趋势")
ax.set_xlabel("月份")
ax.set_ylabel("访问人次")
ax.grid(True, linestyle="--", alpha=0.5)
ax.legend()

# 保存图表为本地图片文件(免去在无图形界面服务器上弹窗失败的问题)
plt.savefig("traffic_trend.png", bbox_inches="tight")
plt.close(fig)
print("趋势图已成功保存为 traffic_trend.png")
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'SimHei'] 即可正常显示汉字。
6. openpyxl —— Excel 工作簿自动化读写与排版 办公自动化首选
定位与解决的问题:在日常企业办公中,绝大多数报表数据均以 .xlsx 文件为载体。openpyxl 允许我们在无需安装任何 Office 软件的前提下,用 Python 直接创建、读取、修改 Excel 工作簿、管理多个工作表(Sheet)、写入公式、设置字体加粗与背景单元格填色,是写出“一键批量处理日常重复报表”脚本的必备武器。
安装命令:python -m pip install openpyxl
典型使用示例:
from openpyxl import Workbook
from openpyxl.styles import Font, PatternFill, Alignment

# 新建工作簿
wb = Workbook()
ws = wb.active
ws.title = "员工绩效汇总"

# 写入表头数据
headers = ["员工编号", "姓名", "考核部门", "季度评分"]
ws.append(headers)

# 表头美化:主色背景与纯白加粗文字
header_fill = PatternFill(start_color="52677D", end_color="52677D", fill_type="solid")
header_font = Font(name="微软雅黑", size=11, bold=True, color="FFFFFF")

for cell in ws[1]:
    cell.fill = header_fill
    cell.font = header_font
    cell.alignment = Alignment(horizontal="center")

# 写入具体业务数据
rows = [
    [1001, "张伟", "研发部", 92],
    [1002, "王芳", "运营部", 88],
    [1003, "李强", "产品部", 95]
]
for row in rows:
    ws.append(row)

# 保存生成新文件
wb.save("employee_scores.xlsx")
print("自动化 Excel 文件生成完毕: employee_scores.xlsx")
7. pillow (PIL) —— 强大易用的数字图像基础处理库 多媒体处理
定位与解决的问题:开发中常需要对用户头像进行缩放裁切、将大量产品图片压缩为标准尺寸、转换图片格式(如将 PNG 转为 WebP / JPEG),或者给图片批量盖水印。由已停止维护的经典 PIL 分支而来的 pillow,是 Python 社区中最通用、兼容格式最全的图像处理基础库。
安装命令:python -m pip install pillow(注意:代码中导入时使用 from PIL import Image,而非 import pillow)
典型使用示例:
from PIL import Image, ImageOps

# 打开本地图片
# 假设当前目录下存在一幅名为 example.jpg 的图片
try:
    with Image.open("example.jpg") as img:
        print(f"原图尺寸: {img.size}, 颜色模式: {img.mode}, 格式: {img.format}")

        # 1. 等比例缩放为最大 400x400 的缩略图
        img.thumbnail((400, 400))

        # 2. 顺时针旋转 90 度
        rotated = img.rotate(-90, expand=True)

        # 3. 另存为高质量 WebP 现代轻量格式
        rotated.save("example_optimized.webp", format="WEBP", quality=85)
        print("图片处理并转换格式完成: example_optimized.webp")
except FileNotFoundError:
    print("未找到测试图片,代码逻辑演示完毕。")
8. pytest —— 极简高效的工程级单元测试框架 代码质量保障
定位与解决的问题:很多新手测试代码的方式是在脚本底部写满 print(...),随着项目扩大,测试输出混杂、难以自动化验证。Python 内置的 unittest 框架需要定义继承自 unittest.TestCase 的类,充斥样板代码。pytest 摒弃了复杂的类继承,直接使用 Python 原生的 assert 关键字,测试用例编写极其清爽,且能在执行测试后输出精准的变量上下文报错细节。
安装命令:python -m pip install pytest
典型使用示例:
# 文件保存为 test_math_util.py
def calculate_discount(price: float, rate: float) -> float:
    """计算折后价格,折扣率必须在 0 到 1 之间"""
    if not (0 <= rate <= 1.0):
        raise ValueError("折扣率必须在 0 到 1 之间")
    return round(price * rate, 2)

# pytest 测试函数直接以 test_ 开头
def test_valid_discount():
    # 使用纯粹的 Python assert 断言
    assert calculate_discount(100.0, 0.8) == 80.0
    assert calculate_discount(199.0, 0.5) == 99.5

def test_invalid_discount():
    import pytest
    # 验证是否会正确抛出预期的异常类型
    with pytest.raises(ValueError):
        calculate_discount(100.0, 1.5)
在终端直接执行命令 pytest test_math_util.py,pytest 会自动搜集以 test_ 开头的所有测试函数并输出执行进度与用时报告。
9. tqdm —— 循环与耗时任务终端动态进度条 交互体验增强
定位与解决的问题:当新手编写数据批处理、文件批量下载或多重算法循环时,控制台往往陷入数十秒甚至数分钟的静默状态。此时开发者常常产生“程序是不是卡死了还是崩溃了”的疑虑。tqdm(源于阿拉伯语“taqaddum”,意为“进展”)只需在普通循环的可迭代对象外包裹一层,就能在终端实时渲染出一个兼具完成百分比、处理速率(iters/s)和剩余时间预估的动态进度条。
安装命令:python -m pip install tqdm
典型使用示例:
import time
from tqdm import tqdm

# 模拟处理 100 个文件或网络任务
total_items = 100

# 仅需使用 tqdm(...) 包裹原有的 range() 或列表对象
for i in tqdm(range(total_items), desc="数据批量清洗进度", unit="项"):
    time.sleep(0.02)  # 模拟实际计算或 I/O 耗时

print("全量任务执行完毕!")
10. python-dotenv —— 环境变量隔离与配置安全管理 安全与工程规范
定位与解决的问题:初学者常常将数据库连接密码、第三方平台 API Secret Key 直接写死在 .py 源代码中。一旦将代码提交推送至 GitHub 或 Gitee 等公开平台,容易引发严重的安全凭据泄漏事故。业界标准最佳实践是将机密配置写入独立的本地 .env 文件中,通过 python-dotenv 库在程序启动时自动注入为系统环境变量,同时将 .env 加入 .gitignore 排除列表。
安装命令:python -m pip install python-dotenv
典型使用示例:
# 步骤 1:在项目根目录创建名为 .env 的纯文本文件,内容如下:
# DATABASE_URL=mysql://admin:secret123@localhost:3306/shop_db
# API_SECRET_TOKEN=sk-live-abc998877665544

# 步骤 2:在 Python 代码中加载并安全读取
import os
from dotenv import load_dotenv

# 加载当前目录下的 .env 文件
load_dotenv()

# 从环境变量中读取配置,可提供默认安全值
db_url = os.getenv("DATABASE_URL")
api_token = os.getenv("API_SECRET_TOKEN", "default_guest_token")

print("从 .env 安全获取的配置:")
print("数据库地址:", db_url)
print("Token 前缀鉴权:", api_token[:8] + "********")
五、新手高频报错与环境排查指南
在安装和使用第三方库的过程中,几乎每位新手都会遭遇一些典型的报错。理解报错根源能够帮助初学者建立系统的问题排查能力:
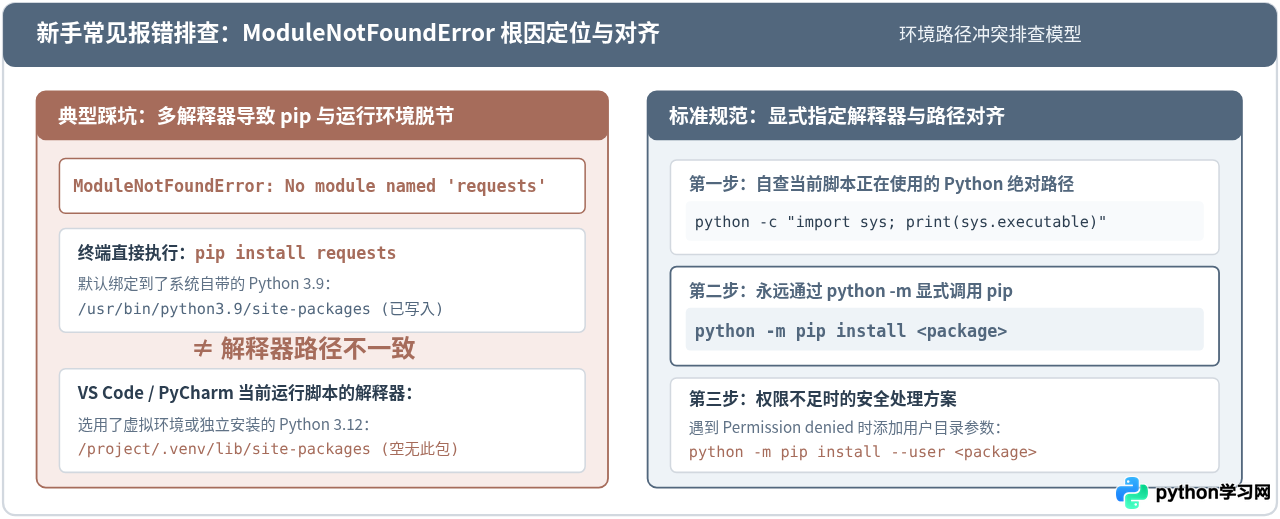
1. “明明提示安装成功了,为什么运行依然报 ModuleNotFoundError?”
这是出现频率最高的痛点。表面现象是:在终端执行 pip install requests 显示已存在或安装成功,但一在 VS Code、PyCharm 或 Jupyter 中运行脚本就报错:ModuleNotFoundError: No module named 'requests'。
根本原因:终端执行命令的 Python 解释器与编辑器/IDE 当前选中的解释器不是同一个程序。例如,系统全局有 Python 3.9,而你的 VS Code 选择了另外安装的 Python 3.12 或虚拟环境。终端的 pip 将包写进了 3.9 的目录,而 3.12 目录中依然是空的。
排查与解决步骤:
- 在报错的 Python 脚本开头加入两行代码打印当前解释器的真实物理路径:
import sys print("当前解释器路径:", sys.executable) - 打开终端,使用该完整路径显式调用 pip 安装:
# 用打印出来的具体解释器路径进行精准安装 "C:\Users\xxx\AppData\Local\Programs\Python\Python312\python.exe" -m pip install requests - 或者在 VS Code 界面右下角点击 Python 版本号,将解释器切换为与终端中
python --version一致的环境。
2. “Permission denied” 或“拒绝访问”权限错误
在 Linux / macOS 或受限制的 Windows 账户下,试图向系统全局目录写入文件时,pip 会报错没有写权限。新手切忌盲目滥用 sudo pip install,这会破坏操作系统自带工具链的依赖。
规范解法:在命令后加上 --user 标志:
python -m pip install --user requests该命令会将第三方库下载并安装到当前用户专属的主目录(如 ~/.local/lib/pythonX.X/site-packages),既不需要管理员提权,也不会污染系统底层全局环境。
3. “WARNING: You are using pip version X, however version Y is available”
很多初学者会将带有橙黄色的 WARNING 误认为报错。这只是 pip 提醒你有更新的版本。虽然旧版本仍可继续正常使用,但升级到新版可以获得更快的下载速度与更智能的依赖解析机制。执行以下命令即可完成升级:
python -m pip install --upgrade pip六、10大常用库选型矩阵与工程依赖管理
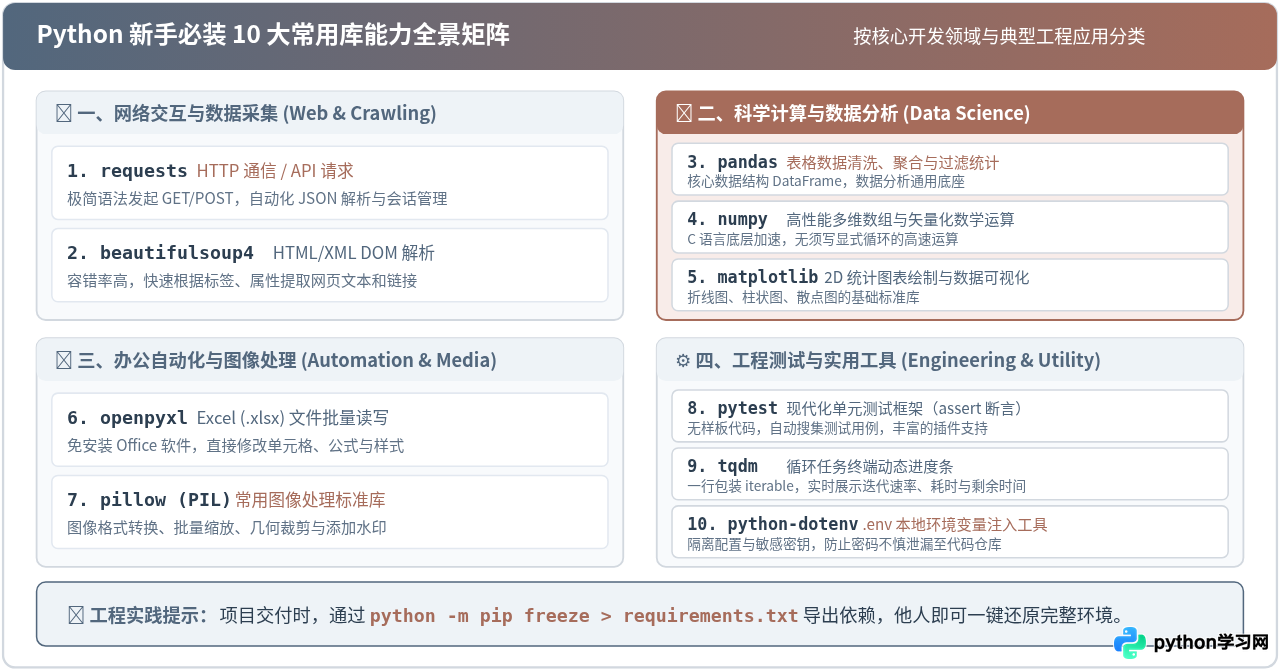
将上述 10 个库的能力定位、核心解决场景与导入模块名进行系统归纳,读者可根据当前所面临的具体开发需求进行针对性选型:
项目交付规范:requirements.txt 依赖文件
在团队协作或将代码部署到云端服务器时,一个一个手动安装第三方库效率低下且容易遗漏版本信息。Python 项目的标准工程惯例是维护一份名为 requirements.txt 的纯文本依赖清单:
- 一键导出当前环境全部依赖:
导出的文件中记录了所有库及其精确版本号(例如python -m pip freeze > requirements.txtrequests==2.31.0)。 - 在另一台电脑或新环境中一键还原全部库:
pip 会自动按清单顺序依次下载并安装所有匹配的软件包。python -m pip install -r requirements.txt
通过掌握 python -m pip 规范调用、合理配置国内镜像加速、理解 site-packages 加载原理,并根据任务场景熟练选用这 10 个常用库,读者便已经具备了独立开发各类自动化脚本与实用工程项目的扎实工具基础。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









