

Python文件读写经典考题与异常处理机制

深入解析Python文件读写中的高频考题与核心底层机制,涵盖with上下文管理、文件读写指针、大文件流式迭代、OSError异常继承层级及原子化写入实操。
掌握Python文件读写与异常处理的核心,在于理解文件描述符的生命周期管理、I/O缓冲机制以及异常的精细捕获链路。表面上看,文件操作只涉及 open()、read() 和 write() 三个函数,但在面试考核与生产实践中,考题往往直指底层细节:例如上下文管理器的协议实现、千万级大文件的流式遍历、打开模式对文件指针与截断行为的影响,以及 OSError 家族的异常归属与资源兜底释放。本文将逐层拆解这些经典问题,剖析其运作原理与防错设计。
一、with 语句底层机制与资源管理考点
在各类技术考评中,最常见的开篇问题之一是:“为什么推荐使用 with 语句操作文件?如果不使用 with,会有什么隐患?其底层协议是如何运作的?”
很多初学者只知道“with 会自动帮我们调用 close()”,但这只是表象。在操作系统层面,每个进程所能打开的文件描述符(File Descriptor)上限是有限的。若只依赖垃圾回收(GC)通过析构函数(__del__)回收文件对象,由于CPython的循环引用清理或垃圾回收时机不确定,极易导致“Too many open files”(打开文件过多)系统报错。更关键的是,如果写入数据后未显式关闭且发生异常退出,用户态缓冲区中的数据未能及时刷盘(flush),会导致数据丢失或文件损坏。
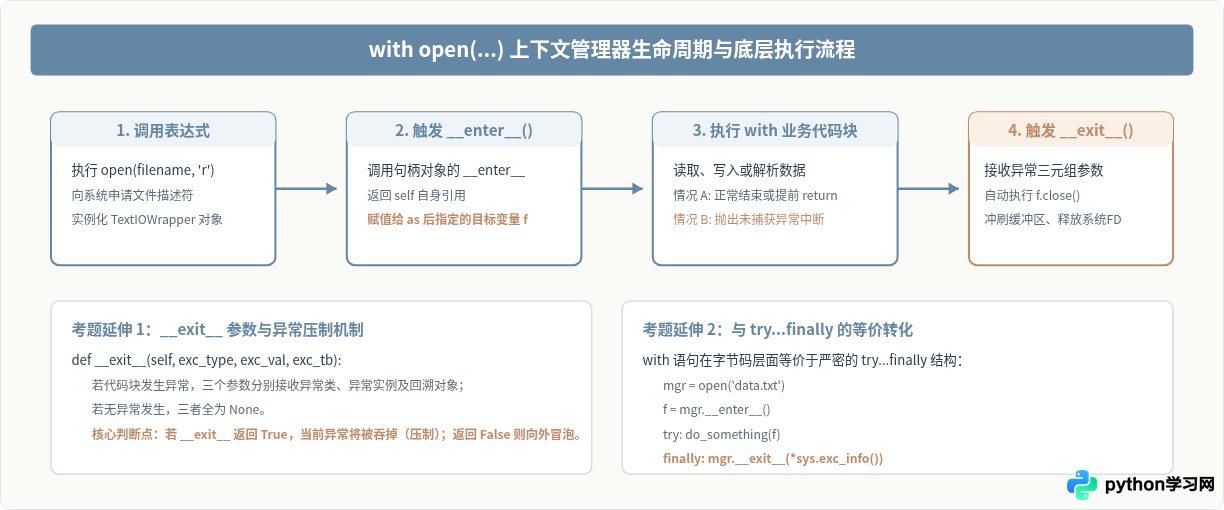
with 语句的本质是 Python 的上下文管理器协议(Context Manager Protocol)。任何对象只要实现了 __enter__() 和 __exit__() 这两个魔术方法,就可以配合 with 使用:
__enter__(self):在进入with代码块前被调用,其返回值被绑定到as后面的变量上。对于文件对象,它返回文件句柄本身。__exit__(self, exc_type, exc_val, exc_tb):在离开代码块时触发。无论代码块是正常执行完毕、遇到return、break还是抛出未捕获的异常,该方法都保证被调用。在方法内部,文件对象会执行真正的close()清理并冲刷缓冲区。
二、打开模式细节与文件读写指针陷阱
考察文件读写的第二类高频考题聚焦于打开模式(mode)的边界差异。许多开发者容易混淆 'w'、'w+'、'r+' 与 'a+' 的行为,特别是文件是否被截断、指针初始位置以及读写交替时的底层限制。
| 打开模式 | 文件不存在时 | 初始指针位置 | 是否截断清空原内容 | 可执行操作与典型考点 |
|---|---|---|---|---|
'r' |
抛出 FileNotFoundError |
文件开头(0) | 否 | 只读。默认模式。 |
'w' |
自动创建新文件 | 文件开头(0) | 立即清空(截断至0字节) | 只写。只要执行 open() 成功,无论是否写入,原内容即刻丢失。 |
'a' |
自动创建新文件 | 文件末尾 | 否 | 追加写入。每次写入都会强制定位在末尾,不会覆盖原有内容。 |
'r+' |
抛出 FileNotFoundError |
文件开头(0) | 否 | 读写模式。直接写入会从当前指针位置覆写等长字节,不会自动平移后文。 |
'w+' |
自动创建新文件 | 文件开头(0) | 立即清空(截断至0字节) | 读写模式。常见考题陷阱:误以为 w+ 能读取已有文件,实际上打开瞬间原文件已被清空。 |
'a+' |
自动创建新文件 | 文件末尾 | 否 | 读写追加模式。打开后立即 read() 会返回空字符串(因指针在末尾),需先 f.seek(0) 才能读。 |
在文本模式下,
f.seek(offset, whence) 中当 whence 取 1(当前位置)或 2(文件末尾)时,offset 只能为 0。若需要根据相对字节偏移跳转,必须使用二进制模式(如 'rb' 或 'rb+')。此外,在 'r+' 或 'w+' 模式下进行读写交替操作时,根据 C 运行时库规范,中间必须调用 seek()、tell() 或 flush() 重新同步缓冲区,否则可能触发未定义行为或数据覆写错乱。
三、海量数据读取经典考题:内存暴涨与流式处理
考题情景:“服务器内存只有 4GB,现在有一个 20GB 的巨型日志文件,要求统计某一关键词的出现频次,如何用 Python 正确读取?”
这是考察 I/O 流式处理与生成器机制的经典考题。答题者需要清晰指出不同读取方式的内存分配差异:
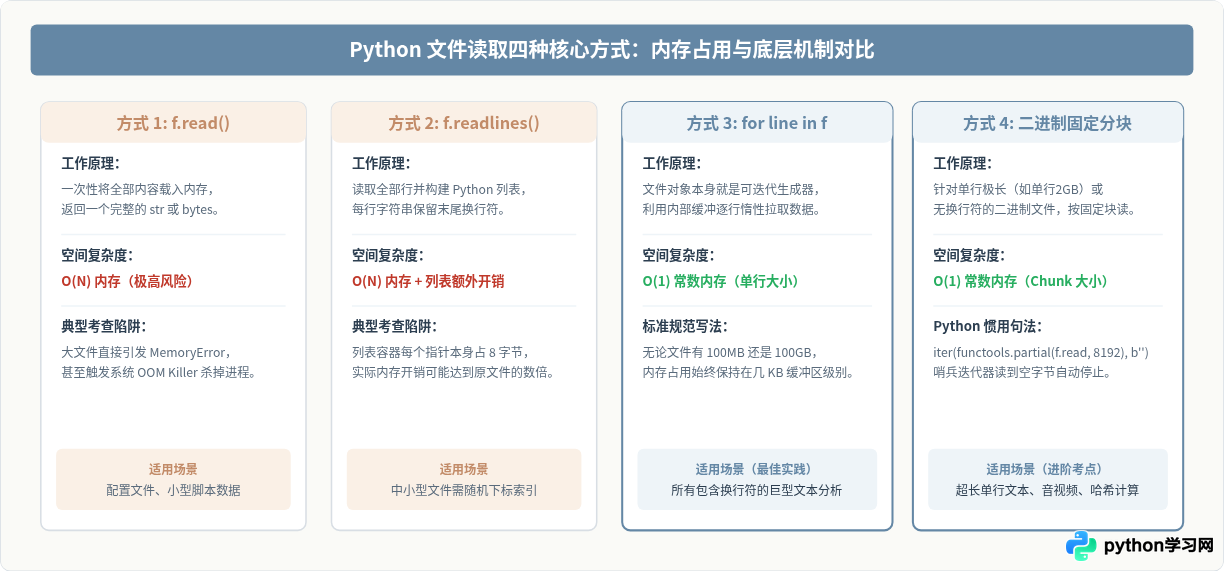
标准大文件处理的代码实现示例:
import functools

# 场景 1:标准文本日志,按行统计关键词
def count_keyword_in_log(filepath, keyword):
    count = 0
    # 利用 f 自带的生成器协议,每次仅驻留一行文本
    with open(filepath, 'r', encoding='utf-8', errors='replace') as f:
        for line in f:
            if keyword in line:
                count += 1
    return count

# 场景 2:计算大文件 SHA256 哈希值(无换行或二进制流)
import hashlib

def calculate_sha256(filepath, chunk_size=65536):
    hasher = hashlib.sha256()
    with open(filepath, 'rb') as f:
        # iter(callable, sentinel) 当 callable() 返回 sentinel 时终止循环
        for chunk in iter(functools.partial(f.read, chunk_size), b''):
            hasher.update(chunk)
    return hasher.hexdigest()
四、异常处理体系与 OSError 继承层级
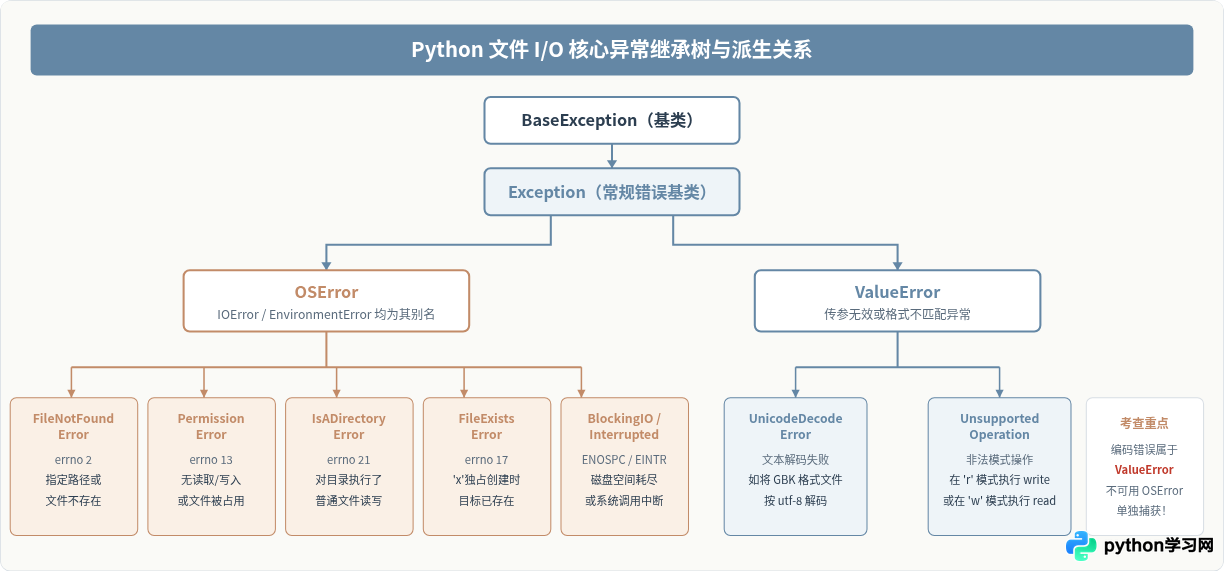
Python 3 对文件与操作系统层面的异常体系进行过重大重构。在 Python 2 时代,很多错误分别散落在 IOError、EnvironmentError 和 WindowsError 中;而自 Python 3.3 起,官方统一将其合并归入 OSError,并基于错误码(errno)派生出了细分异常。
考官经常会问:“在捕获文件异常时,except Exception、except IOError 和 except FileNotFoundError 之间有何异同与最佳实践?”
理解这个问题的关键在于理清 Python 异常体系的继承树:
- 避免宽泛捕获:切忌无脑使用
except Exception: pass。这不仅会掩盖磁盘配额已满、文件损坏等真实故障,还可能吞掉逻辑 Bug。 - 继承捕获顺序:必须“由具体到通用”。如果先
except OSError,其后的except FileNotFoundError永远不会被触发,因为子类已经被父类分支提前截获。 - 编码异常分类:
UnicodeDecodeError是ValueError的子类,而不是OSError!若仅编写except OSError:,文本解码报错仍会导致程序直接崩溃。
五、try-except-else-finally 与安全原子写入
考察文件读写的另一个深水区是:“当向关键配置文件写入数据时,如何避免因意外断电、进程崩溃导致旧文件被清空且新数据未写全?”
如果直接采用 with open('config.json', 'w') as f: f.write(new_data),存在极高的故障隐患:因为 'w' 模式在执行的一瞬间就把原文件长度清空为 0。如果在 write() 过程中系统崩溃或空间耗尽,原有的正常配置已永久丢失,新配置又不完整。
工业级生产标准通常采用“原子化临时文件写入 + 目录刷盘 + 原地重命名(Atomic Write)”策略:
- 在目标文件所在的同一个文件系统分区中创建临时文件(通常使用
tempfile.NamedTemporaryFile(dir=...))。 - 将新数据完整写入临时文件。
- 调用
f.flush()并调用os.fsync(f.fileno()),强制操作系统把文件页缓存刷入持久化物理介质。 - 关闭临时文件。
- 调用
os.replace(temp_path, target_path)进行原子重命名。在 POSIX 系统(Linux/macOS)以及现代 Windows NT 内核中,os.replace是原子操作,要么原文件完好无损,要么彻底替换为新文件,绝不会出现中间截断态。
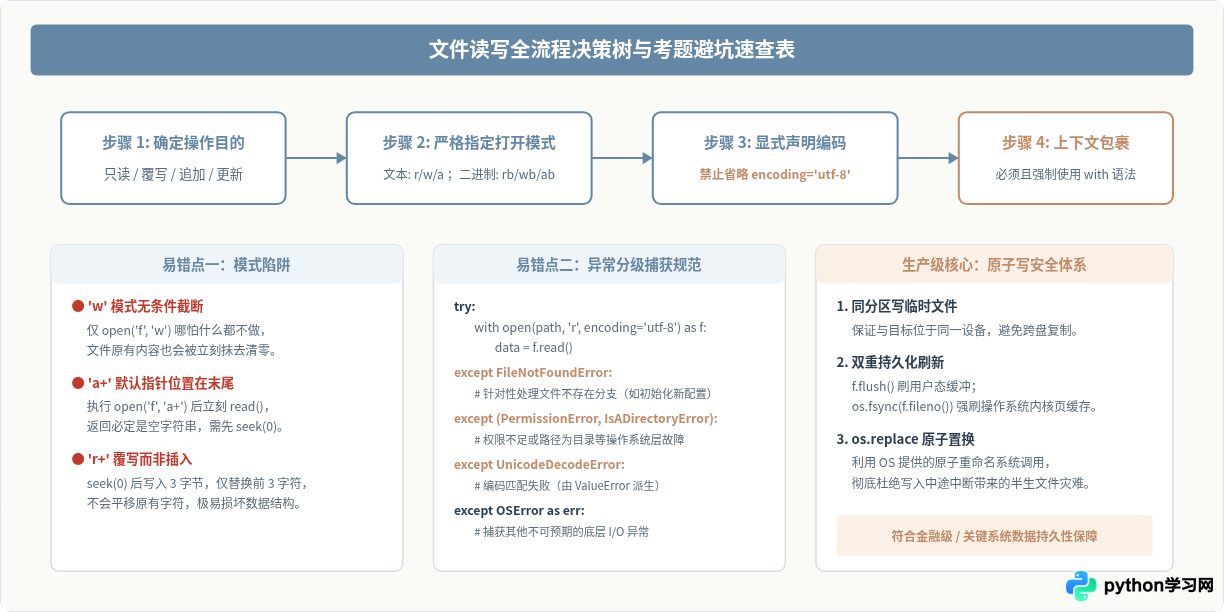
原子化写入的工程代码模式:
import os
import tempfile

def safe_atomic_write(filepath, content, encoding='utf-8'):
    """
    原子化安全写入文件,防止进程崩溃导致原数据清空或截断损坏
    """
    dirname = os.path.dirname(os.path.abspath(filepath))
    # 在同级目录创建临时文件,确保处于同一物理文件系统卷
    temp_file = tempfile.NamedTemporaryFile('w', dir=dirname, delete=False, encoding=encoding)
    temp_path = temp_file.name
    try:
        temp_file.write(content)
        temp_file.flush()
        # 强制将操作系统内核页缓存同步到物理硬盘
        os.fsync(temp_file.fileno())
        temp_file.close()
        # 原子重命名覆盖目标文件
        os.replace(temp_path, filepath)
    except Exception:
        temp_file.close()
        if os.path.exists(temp_path):
            os.remove(temp_path)
        raise
六、经典考题深度答辩要点总结
在面试或工程考核中,面对“Python文件读写与异常处理”相关的题目,条理清晰、层次分明的回答能够展现扎实的底层功底:
- 关于上下文管理:核心不在于少写一行
close(),而在于基于协议的__enter__与__exit__保证在任何退出路径下(包括未捕获异常与系统信号)资源必然释放,并可通过__exit__的返回值精确控制异常是否冒泡。 - 关于大文件与内存:熟练运用
for line in f的行流式生成器与iter(functools.partial(f.read, chunk), b'')的块流式迭代器,将空间复杂度严格控制在 $O(1)$ 常数级。 - 关于异常细分:准确区分系统级错误(
OSError及其子类FileNotFoundError,PermissionError)与应用协议级错误(UnicodeDecodeError,ValueError),禁止宽泛吞并异常。 - 关于文件持久化:明确从“应用缓冲区”到“操作系统内核页缓存”再到“物理介质”的三层刷新逻辑,结合原子重命名机制提供工业级的容灾安全性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









