

Python汉诺塔递归函数代码详解与执行流程

深入详解Python实现汉诺塔问题的递归函数代码、核心逻辑拆解与底层执行流程,配合四幅完整内联SVG图示直观展示三步拆解模型、递归调用树、七步物理状态演变及算法要点总结。
汉诺塔(Tower of Hanoi)是经典的算法问题,也是理解分治与递归思维的关键案例。面对多个圆盘的转移约束,直接推演每个单步往往容易混乱;而递归解法的核心,在于将“移动 n 个圆盘”的宏观目标降维拆解为三个标准化动作:先把上方的 n-1 个盘子借助目标柱移到辅助柱,再把最底部的最大盘子移到目标柱,最后将辅助柱上的 n-1 个盘子借助起始柱复位到目标柱。本文通过完整的 Python 代码实现、分治模型、函数调用树与逐步移动状态演变,详细解析汉诺塔递归函数的构成与执行流程。
一、汉诺塔规则与递归拆解逻辑
汉诺塔问题设定了三根柱子(常记为 A、B、C)与 n 个大小不等的圆盘。初始状态下,全部 n 个圆盘均套在源柱 A 上,且严格遵守“大盘在下、小盘在上”的规则。任务要求将全部圆盘平移至目标柱 C,并在转移过程中严格遵守两条铁律:
- 每次只能移动一个圆盘,且只能取走任一柱子最顶部的圆盘;
- 在任何移动时刻、任何柱子上,均严禁出现大盘压在小盘上方的情况。
初学者面对该问题时,常常试图推算“第一步移动哪块、第二步移动哪块”。当圆盘数量增加时,这种微观视角极易陷入局部死循环。递归方法则采取宏观分治视角:若要将最大的第 n 个圆盘从 A 移到 C,必须满足一个唯一前提——前 n-1 个较小的圆盘必须全部离开 A 且不能位于 C 上,即它们必须整齐存放在辅助柱 B 上。
基于这一必然前提,无论总盘数 n 为多少,求解过程均能统一形式化为三个标准阶段:
- 阶段一:以 C 为中转辅助,将上方 n-1 个圆盘从 A 移到 B;
- 阶段二:此时 A 上仅剩最大的第 n 号盘,直接将其从 A 移到 C;
- 阶段三:以 A 为中转辅助,将暂存在 B 上的 n-1 个圆盘从 B 移到 C。
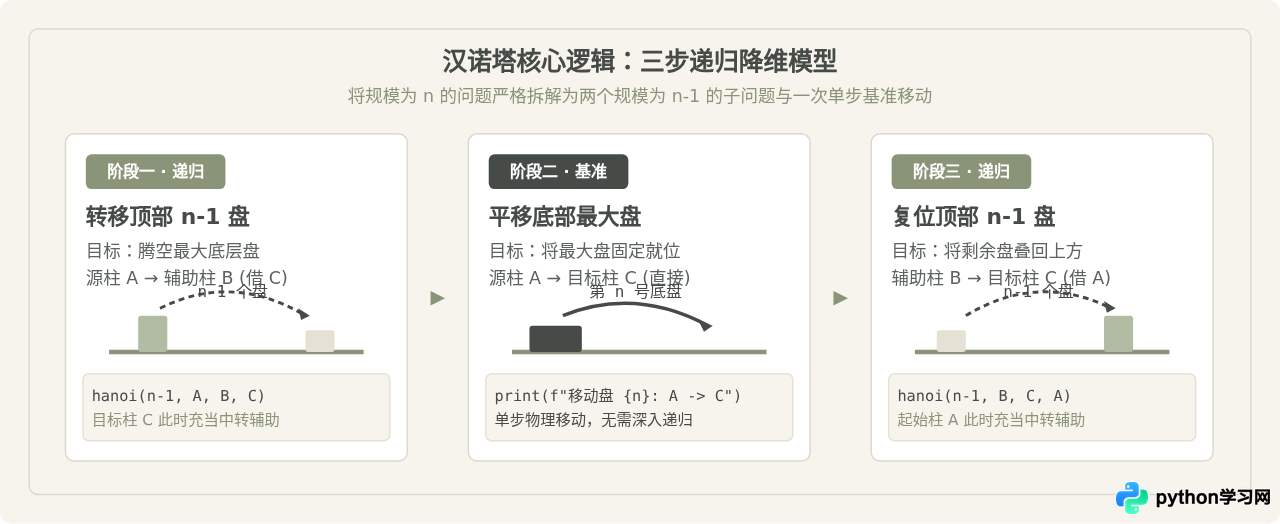
图 1:汉诺塔问题的三阶段递归拆解模型与代码动作映射
二、完整 Python 递归函数代码实现
根据上述三步分治模型,我们可以直接编写出 Python 递归函数。递归实现的精髓在于建立正确的“基线条件(Base Case)”与“递推推进条件(Recursive Case)”。当 n == 1 时,只有一个盘子,无需借助任何辅助柱,直接将其移动到目标柱即可;当 n > 1 时,按三步法递推展开。
以下为在标准 Python 3 环境下可直接执行的完整代码:
def hanoi(n, source, target, auxiliary):
    """
    汉诺塔递归求解函数
    :param n: 当前需要移动的圆盘总数(正整数)
    :param source: 当前圆盘所在的起始柱标识(如 'A')
    :param target: 目标柱标识(如 'C')
    :param auxiliary: 辅助中转柱标识(如 'B')
    """
    # 基线条件:若只剩 1 个盘子,直接从起始柱移到目标柱
    if n == 1:
        print(f"移动盘 1 从 {source} 到 {target}")
        return

    # 步骤一:将上方 n-1 个盘子从 source 移到 auxiliary,此时 target 充当辅助柱
    hanoi(n - 1, source, auxiliary, target)

    # 步骤二:此时底部的第 n 个盘子已暴露,将其直接从 source 移到 target
    print(f"移动盘 {n} 从 {source} 到 {target}")

    # 步骤三:将留在 auxiliary 上的 n-1 个盘子移到 target,此时 source 充当辅助柱
    hanoi(n - 1, auxiliary, target, source)


if __name__ == "__main__":
    disk_count = 3
    print(f"=== 开始求解 {disk_count} 阶汉诺塔移动方案 ===")
    hanoi(disk_count, 'A', 'C', 'B')
    print("=== 移动方案全部执行完毕 ===")
许多初学者对代码中 source、target、auxiliary 的传递顺序感到困惑。必须明确:这三个形参代表的是当前函数帧内的逻辑角色,而非物理上固定的柱子。例如在第一次递归调用中,传入实参是 (n-1, source, auxiliary, target),这意味着把当前帧的 auxiliary(柱B)绑定给了下一帧的 target 形参。柱子的物理标签始终是 'A'、'B'、'C' 字符串,但在不同递归层级的函数调用中,它们承担的“源”、“辅”、“目”角色在动态互换。
三、执行流程剖析:以 3 阶汉诺塔调用树为例
为了具体掌握程序的执行路径,以 disk_count = 3、初始调用 hanoi(3, 'A', 'C', 'B') 为例。程序并不会并发执行,而是严格按照 Python 函数调用栈进行“深度优先遍历(Depth-First Search)”。
当调用 hanoi(3, 'A', 'C', 'B') 时,系统先将其压入栈底。由于 n != 1,它首先触发步骤一的 hanoi(2, 'A', 'B', 'C');该子调用继续触发其内部步骤一的 hanoi(1, 'A', 'C', 'B')。到达 n == 1 后触发输出,随后逐步回溯弹栈。
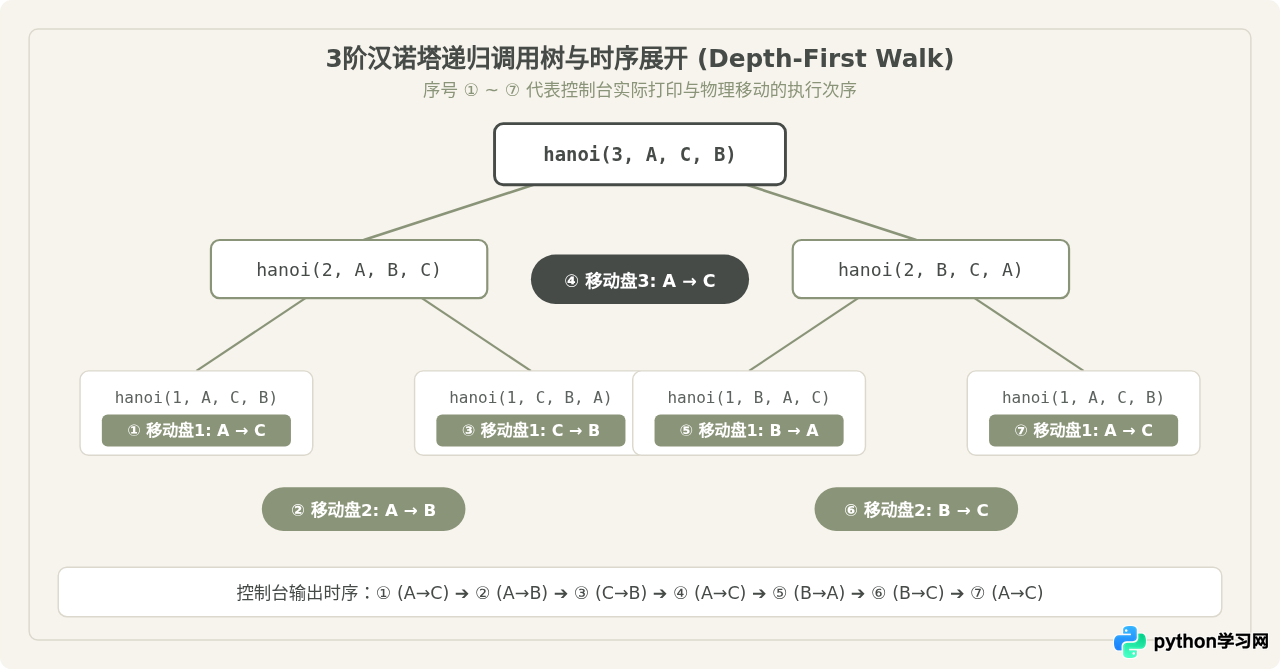
图 2:3阶汉诺塔递归调用树分解与中序遍历执行轨迹
四、物理移动步骤分解与状态演变
为了让代码输出与物理世界的圆盘运动完全对应,下表展示了 3 阶汉诺塔在代码运行过程中的完整控制台输出:
| 步骤 | 控制台输出动作 | 对应代码调用位置 | 柱子瞬时状态 (A / B / C) |
|---|---|---|---|
| 初始 | — | 函数调用前 | [3, 2, 1] / [ ] / [ ] |
| 第 1 步 | 移动盘 1 从 A 到 C | hanoi(1, A, C, B) 基线返回 |
[3, 2] / [ ] / [1] |
| 第 2 步 | 移动盘 2 从 A 到 B | hanoi(2, A, B, C) 中间打印 |
[3] / [2] / [1] |
| 第 3 步 | 移动盘 1 从 C 到 B | hanoi(1, C, B, A) 基线返回 |
[3] / [2, 1] / [ ] |
| 第 4 步 | 移动盘 3 从 A 到 C | hanoi(3, A, C, B) 根调用中间打印 |
[ ] / [2, 1] / [3] |
| 第 5 步 | 移动盘 1 从 B 到 A | hanoi(1, B, A, C) 基线返回 |
[1] / [2] / [3] |
| 第 6 步 | 移动盘 2 从 B 到 C | hanoi(2, B, C, A) 中间打印 |
[1] / [ ] / [3, 2] |
| 第 7 步 | 移动盘 1 从 A 到 C | hanoi(1, A, C, B) 基线返回 |
[ ] / [ ] / [3, 2, 1] |
通过上述记录可以看到:前 3 步完成了将盘 1、盘 2 从 A 转移到 B 的子任务;第 4 步执行了关键的底盘转移(A 到 C);后 3 步则将盘 1、盘 2 从 B 顺利复位至 C。下图直观展现了这 7 步中圆盘在三根柱子上的空间位置迁移:
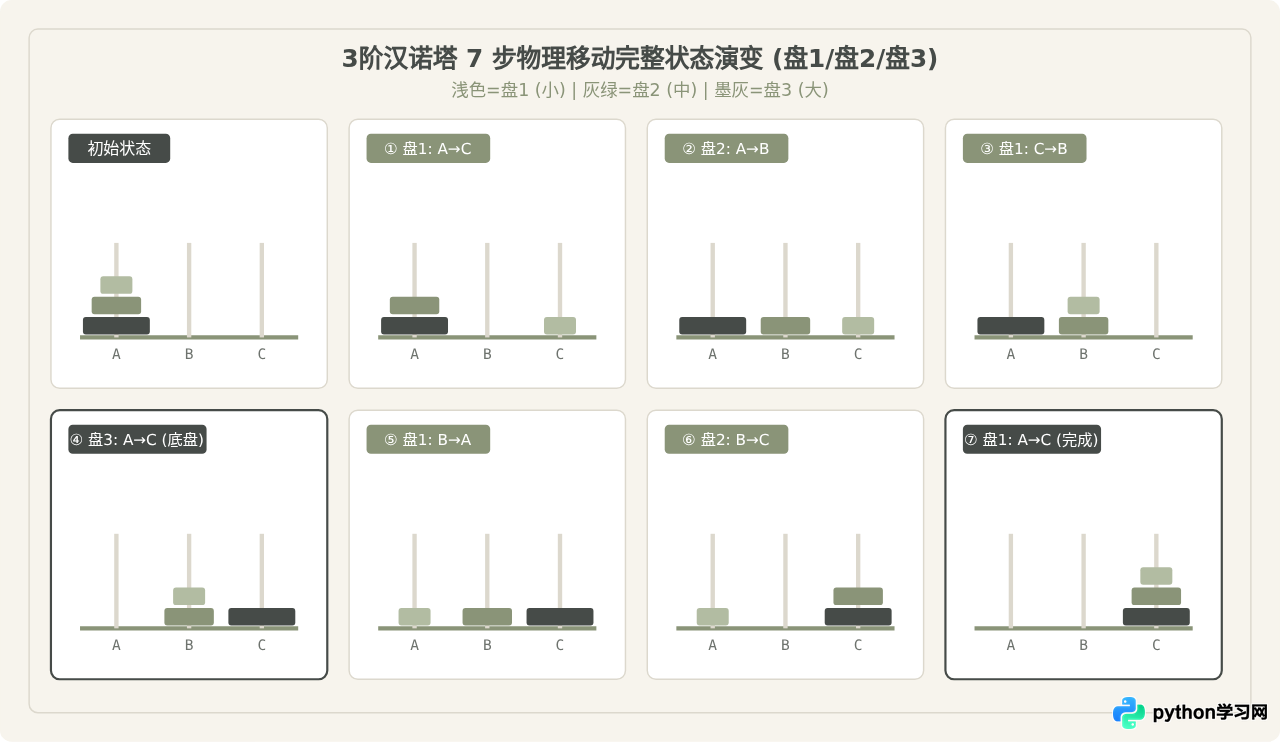
图 3:3阶汉诺塔 7 步移动中圆盘分布状态演进全貌
五、递归复杂度分析与关键规律总结
理解汉诺塔算法不仅要掌握代码如何书写,还要清楚其时空性能特征与理论边界:
1. 移动总次数与时间复杂度
设移动 n 个圆盘所需的总步数为 \(T(n)\)。根据三步分解逻辑,移动 n 个盘子需要两次移动 n-1 个盘子,再加上移动最大底层盘的 1 次操作,由此可建立递推关系式:
\(T(1) = 1\)
\(T(n) = 2T(n-1) + 1 \quad (n \ge 2)\)
两边同时加 1,可得 \(T(n) + 1 = 2[T(n-1) + 1]\)。这是一个公比为 2 的等比数列,由此求得通项公式:
\(T(n) = 2^n - 1\)
由于每移动一步对应一次常数时间的输出操作,因此该算法的时间复杂度为严格的 \(O(2^n)\)。这意味着随着盘数线性增长,所需移动步数将呈指数级爆炸。例如当 \(n = 10\) 时需 1,023 步;\(n = 20\) 时已超过 104 万步;而对于传说中的 \(n = 64\),总步数高达 \(2^{64}-1 \approx 1.84 \times 10^{19}\) 步,即使计算机每秒能执行十亿次移动,也需要超过 580 年才能完成。
2. 空间复杂度与调用栈深度
与时间复杂度的指数爆炸不同,该递归算法的辅助空间消耗却非常克制。在任何特定时刻,Python 解释器所保留的最大栈帧数仅取决于当前调用分支的最大深度。由于每次递归调用都会使盘数减 1(即从 n 降至 1),因此调用栈的最大深度严格为 n。
在不考虑每次打印输出占用的缓冲区前提下,汉诺塔递归算法的空间复杂度仅为 \(O(n)\)。
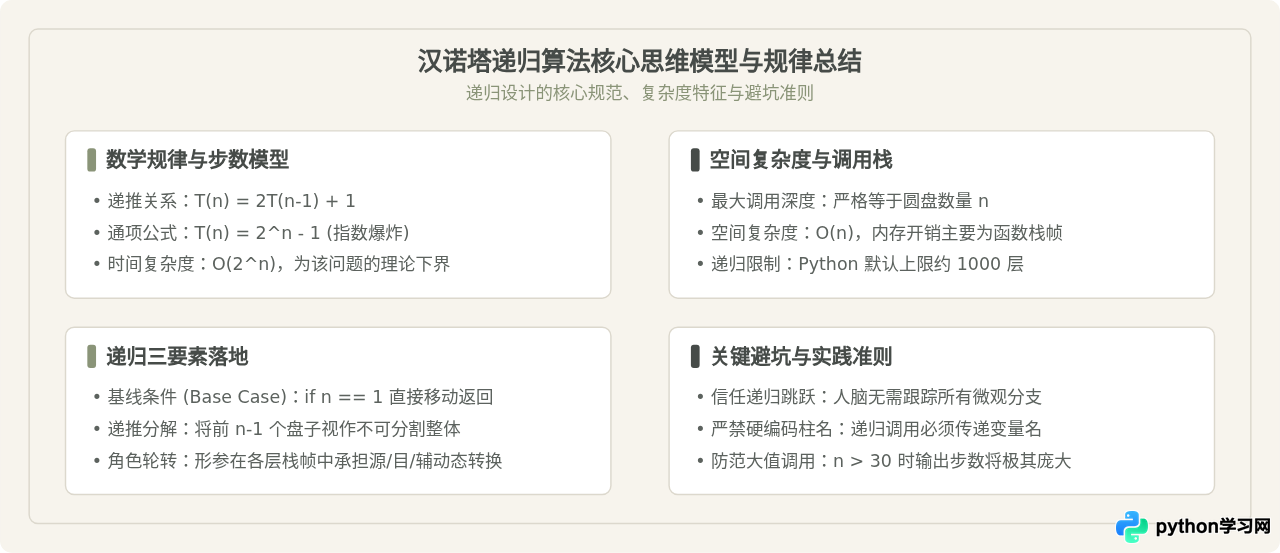
图 4:汉诺塔递归算法核心思维模型与工程要点全貌总结
3. 工程实践注意事项
-
信任递归跳跃(Leap of Faith):书写递归函数时,最常见的心理障碍是试图用肉眼或心智去穷举每一层的每个分支。正确的做法是“只管当前层”:假定
hanoi(n-1, ...)能够正确完成前 n-1 个盘子的移动,确保当前第 n 盘移动与前后两次子调用的逻辑衔接无误,最后补齐n == 1的边界条件即可。 -
递归深度限制:Python 解释器为了防止栈溢出(Stack Overflow),内置了递归深度检查(通常通过
sys.getrecursionlimit()查看,默认约为 1000)。虽然汉诺塔的最大调用深度仅为 n,在正常盘数下绝不会触发深度超限,但如果在递归过程中遗漏了return或基线条件编写错误,将迅速抛出RecursionError: maximum recursion depth exceeded。 -
区分求解策略与打印输出:本文代码直接在单步发生时执行
print。在实际软件工程中,更推荐将每一步动作记录为一个结构化元组或生成器(yield (disk, source, target)),以便将算法逻辑与 UI 渲染或日志解耦。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









