

Python增强赋值运算符+=在列表中的原地修改行为
深入解析Python中列表增强赋值运算符+=的原地修改行为,对比+=与+的底层机制、内存地址变化、多重引用副作用及元组嵌套列表经典异常。
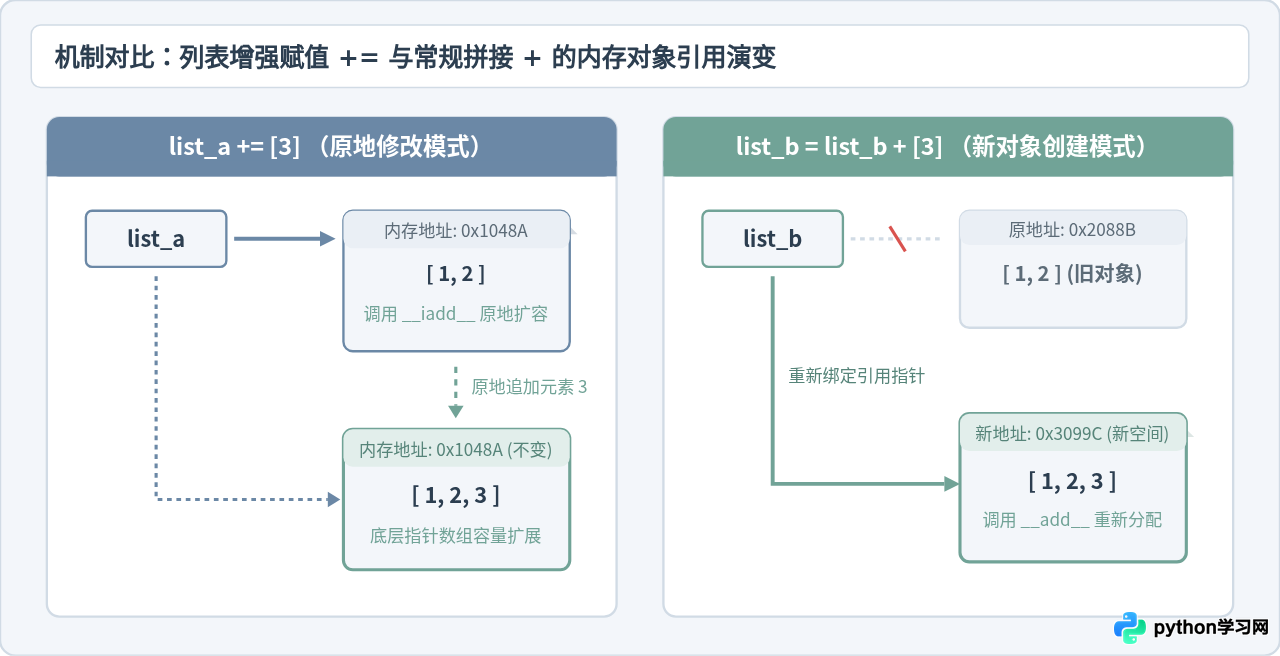
在 Python 中,针对列表这类可变对象,增强赋值运算符 += 的底层实现调用的是特殊方法 __iadd__,其行为等价于调用列表的 extend() 方法,直接在原有列表对象的底层内存槽中进行扩容与元素追加(即原地修改,In-place Modification),而不会创建新的列表对象。这与普通的拼接赋值 a = a + b(调用 __add__,创建全新列表对象并重绑定变量引用)存在本质的内存机制与执行副作用差异。掌握这一行为,不仅能规避共享引用时的隐蔽数据污染,也是理清“元组内嵌列表执行 += 报错却成功修改”等经典异常的关键所在。
一、核心机制解析:+= 与 + 的底层方法与内存地址差异
Python 语言规范为增强赋值运算符设计了专门的原地运算协议。当解释器评估表达式 a += b 时,会优先查找 a 所属类中是否定义了 __iadd__(In-place Addition)特殊方法。对于内置列表类型 list 而言,该方法已被默认实现,并且其功能与 list.extend() 完全一致;若该方法不存在,解释器才会退化为调用常规加法 __add__ 并执行重新赋值。
与此相对,常规二元加法 a = a + b 强制调用 list.__add__,要求两边同为列表类型,并在堆内存中申请一块崭新的连续存储空间以容纳拼接后的所有元素指针,最后将新对象的地址绑定给变量名 a。原有对象若无其他引用,则进入垃圾回收候选序列。
# 示例 1:对比 += 与 + 的内存地址变化
# 场景 A:使用 += 执行操作
list_a = [1, 2]
address_before_a = id(list_a)
list_a += [3, 4]
address_after_a = id(list_a)

print("+= 修改前内存地址:", address_before_a)
print("+= 修改后内存地址:", address_after_a)
print("是否为同一对象:", address_before_a == address_after_a)  # 输出: True

# 场景 B:使用 a = a + b 执行操作
list_b = [1, 2]
address_before_b = id(list_b)
list_b = list_b + [3, 4]
address_after_b = id(list_b)

print("+ 拼接前内存地址:", address_before_b)
print("+ 拼接后内存地址:", address_after_b)
print("是否为同一对象:", address_before_b == address_after_b) # 输出: False从以上测试输出可以清晰验证:+= 操作执行前后,变量所指向的内存首地址(通过 id() 获取)完全没有发生变动,属于彻底的原地修改;而 + 操作则分配了全新的内存对象,并将变量名重新绑定到了新对象上。
二、执行推导步骤:Python 解释器处理 a += b 的推导链
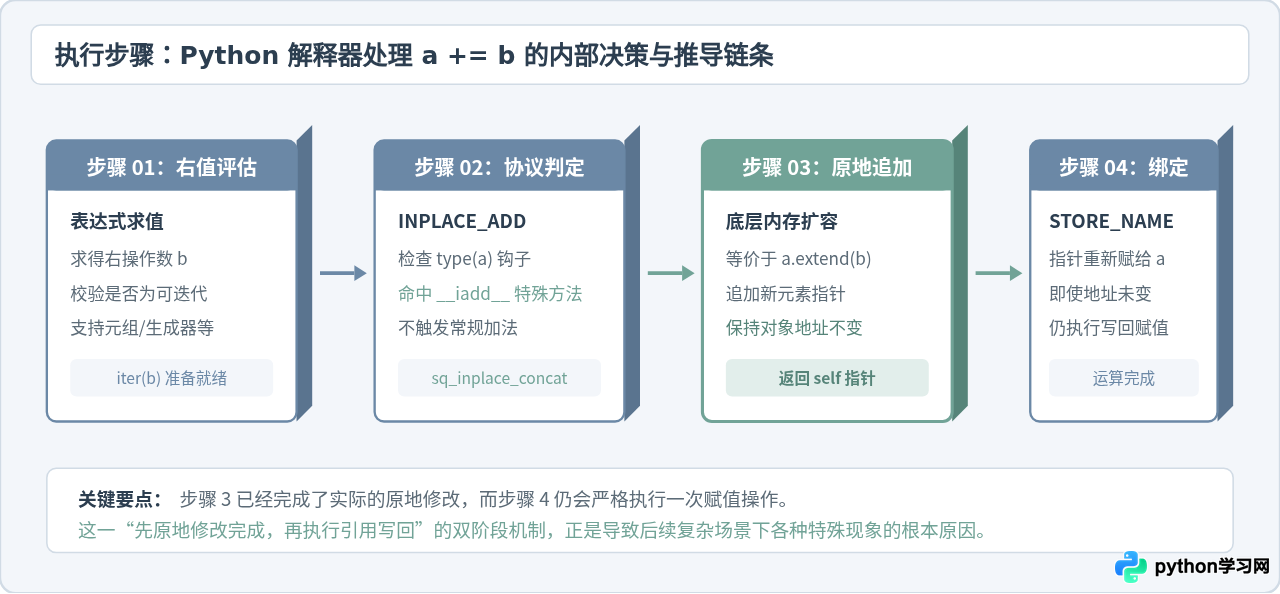
为了透彻理解这一行为,我们需要沿着 Python 字节码与虚拟机调度机制,拆解 a += b 的完整处理阶段:
- 步骤一:右操作数求值。解释器首先对右侧表达式
b进行求值。需要特别指出的是,与常规加法+必须要求两端同为list类型不同,list.__iadd__允许右侧操作数是任意合法的可迭代对象(如元组、集合、生成器或字典键列表),并自动解构追加。 - 步骤二:原地协议检查(__iadd__)。解释器调用
INPLACE_ADD字节码,检查左侧操作数所属类型是否实现了__iadd__槽位(在 CPython 源码中对应sq_inplace_concat)。列表对象明确实现了该函数。 - 步骤三:底层缓冲区动态扩容与原地复制。对于
list,CPython 直接调用list_inplace_concat,其本质逻辑是执行list_extend。若现有分配的容量不足,按倍增策略扩展底层指针数组空间,并将右侧可迭代对象中的元素指针逐一填充进末尾,最后返回对象自身的指针self。 - 步骤四:引用重绑定。根据 Python 语法规范,增强赋值始终包含一次隐式写回操作,即无论原地方法是否修改了对象,都会将步骤三返回的指针重新赋给左侧的变量标识符。
三、多重引用的副作用与常见陷阱
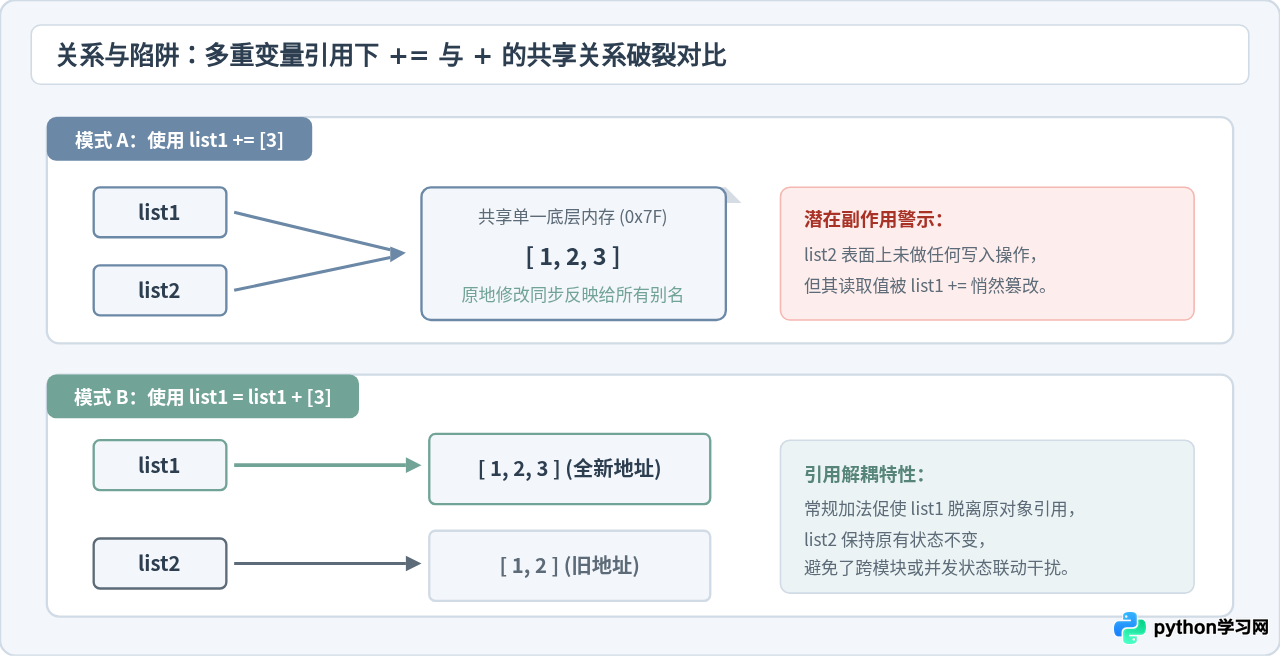
在实际工程代码中,列表的原地修改行为最容易在“别名引用(Aliasing)”和“函数参数传递”中引发隐蔽的业务 Bug。当多个变量绑定到同一个列表实例时,任何一个变量通过 += 执行的操作,都会无差别地反映在其余所有变量中;而如果使用的是 = a + b,则会立刻打破这种共享关系。
# 示例 2:别名引用下的不同表现
def test_aliasing():
    # 场景 1:+= 导致别名联动被修改
    original_list = [10, 20]
    alias_list = original_list
    original_list += [30]
    print("alias_list (受 += 影响):", alias_list)  # 输出: [10, 20, 30]

    # 场景 2:+ 使得引用脱钩分离
    original_list2 = [10, 20]
    alias_list2 = original_list2
    original_list2 = original_list2 + [30]
    print("alias_list2 (不受影响):", alias_list2)  # 输出: [10, 20]

test_aliasing()
同样,将列表作为实参传递给函数时,在函数体内部如果执行 arg += items,修改将直接外溢至调用方作用域;若想要保证调用方数据不受影响,防御性编程的最佳做法是显式创建浅拷贝(如 arg = arg[:] + items)或明确在设计上遵守不可变约定。
四、经典边界案例深度剖析:元组嵌套列表执行 += 的“半成功”异常
在所有与增强赋值相关的面试题与技术陷阱中,最著名也是最令人困惑的莫过于对“元组内部的可变列表执行 += 操作”。请看以下代码:
# 示例 3:元组嵌套列表的经典异常
t = (1, 2, [3, 4])

try:
    t[2] += [5, 6]
except TypeError as e:
    print("捕获到异常:", e)

print("最终元组内容:", t)
# 输出: 捕获到异常: 'tuple' object does not support item assignment
# 输出: 最终元组内容: (1, 2, [3, 4, 5, 6])
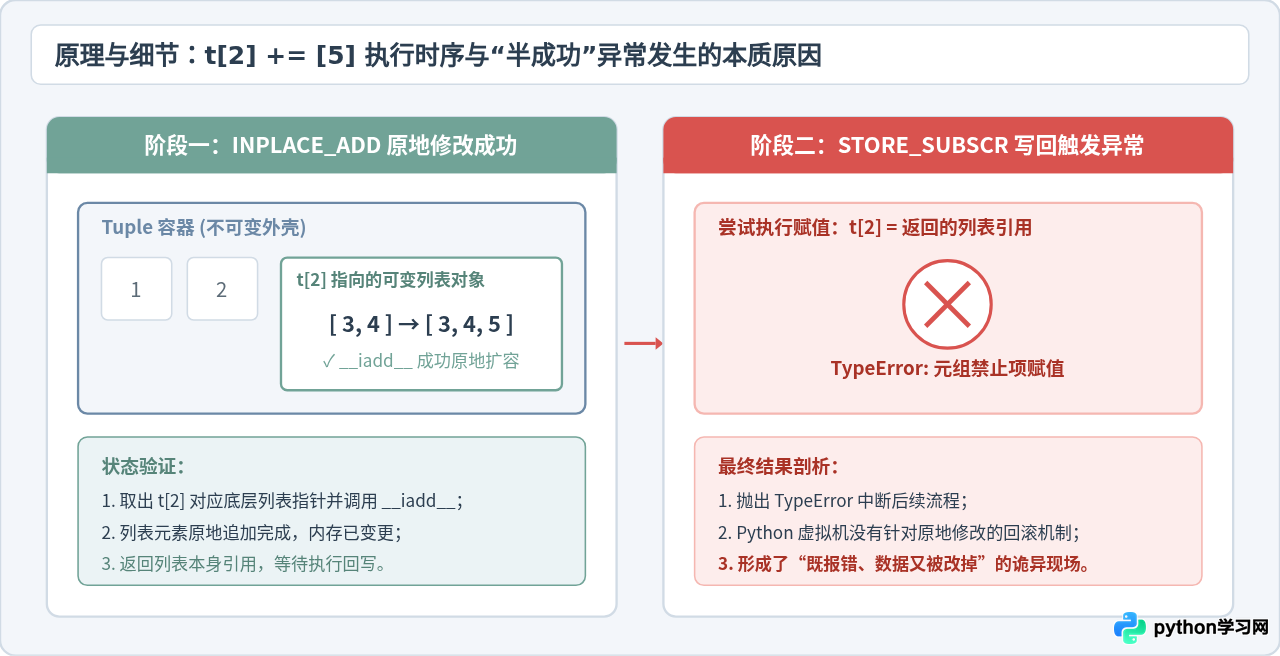
为什么既抛出了 TypeError,列表的数据却依然被修改成功了?
这个现象初见极其反直觉,但只要结合前面讲解的“执行推导步骤”即可迎刃而解:
- 第一阶段(原地修改成功): 解释器将
t[2] += [5, 6]解析为先执行INPLACE_ADD。此时取出的对象是元组索引为 2 的元素——即那个列表。列表执行自身的__iadd__,成功在其原有底层内存中追加了元素5和6,并返回列表自身的内存指针。至此,列表内部数据已经完成变更。 - 第二阶段(重新赋值触发异常): 紧接着,Python 解释器必须按照赋值语法执行最后的写回操作,即尝试将步骤一返回的对象指针重新存入
t[2](对应底层字节码STORE_SUBSCR)。此时虚拟机检测到t是不可变类型元组(tuple),元组严厉禁止项赋值(Item Assignment),立刻抛出TypeError。
换句话说:修改行为发生在检查元组不可变性之前,异常中断了赋值流程,但并没有事务回滚机制能够撤销已经生效的原地内存修改。
五、核心规则总结与开发建议
理解了 Python 增强赋值运算符在列表中的原地修改特性后,我们可以将 += 与常见拼接手段的核心区别汇总如下:
| 运算方式 | 底层调用方法 | 内存分配行为 | 右操作数类型约束 | 典型适用场景 |
|---|---|---|---|---|
a += b |
__iadd__ (等价 extend) |
原地扩容,内存地址不变 | 任意可迭代对象 (Iterable) | 高性能大量元素追加,明确不需要保护原引用的场景 |
a = a + b |
__add__ |
新建全新列表,内存地址改变 | 必须严格同为 list 类型 |
不可变设计、需与旧引用解绑脱钩、防御性编程 |
a.extend(b) |
extend |
原地扩容,无赋值回写步骤 | 任意可迭代对象 (Iterable) | 推荐在工程中显式替代 +=,语意清晰,避免元组嵌套报错 |
1. 避免在不可变容器中对内嵌可变对象使用增强赋值: 例如对 tuple 中的列表,切勿编写 t[0] += [...],若确实需要修改,请显式使用 t[0].extend(...),这样完全跳过了无意义且会报错的 STORE_SUBSCR 写回步骤。
2. 防范共享引用的静默污染: 当函数接收列表作为参数时,优先将内部修改限制在局部副本中,或显式向调用方声明此函数会原地修改入参。
3. 善用 += 的性能优势: 在大循环或大数据集追加时,+= 避免了频繁申请整块新内存与复制旧元素的巨大开销,执行效率显著优于 a = a + b。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









