

新手必学:Python最核心的10个常用库及学习优先级建议
系统梳理Python初学者必须掌握的10个核心常用库,包含标准库与第三方生态的关键定位、可运行代码示例、三阶段学习优先级建议及常见认知误区辨析,帮助新手建立清晰的学习路径。
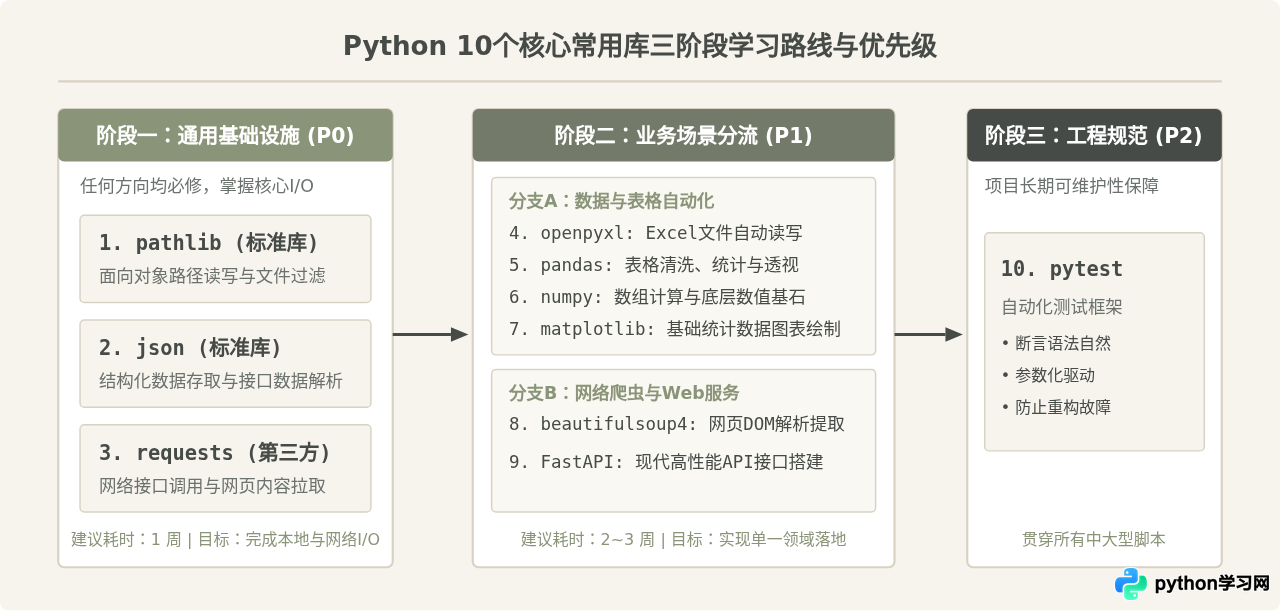
学习 Python 最常见的挫败感,往往不是来自语法本身,而是面对庞大第三方生态时的无所适从。初学者不需要一次性掌握成百上千个功能包,真正支撑起 80% 日常开发、自动化任务与数据处理的,其实是 10 个最基础且高频的核心库;按照“通用基础设施 → 场景业务分流 → 工程规范保障”的三阶段优先级推进,能够以最短路径建立解决实际问题的能力。
一、为什么必须聚焦这10个核心库
很多初学者在刚学完变量、循环与函数后,容易陷入两种极端:要么盲目安装各类大型框架导致环境混乱,要么只用原生代码手写所有逻辑导致效率低下。Python 生态之所以繁荣,在于其标准库提供的稳固地基以及第三方社区提炼出的事实行业标准。
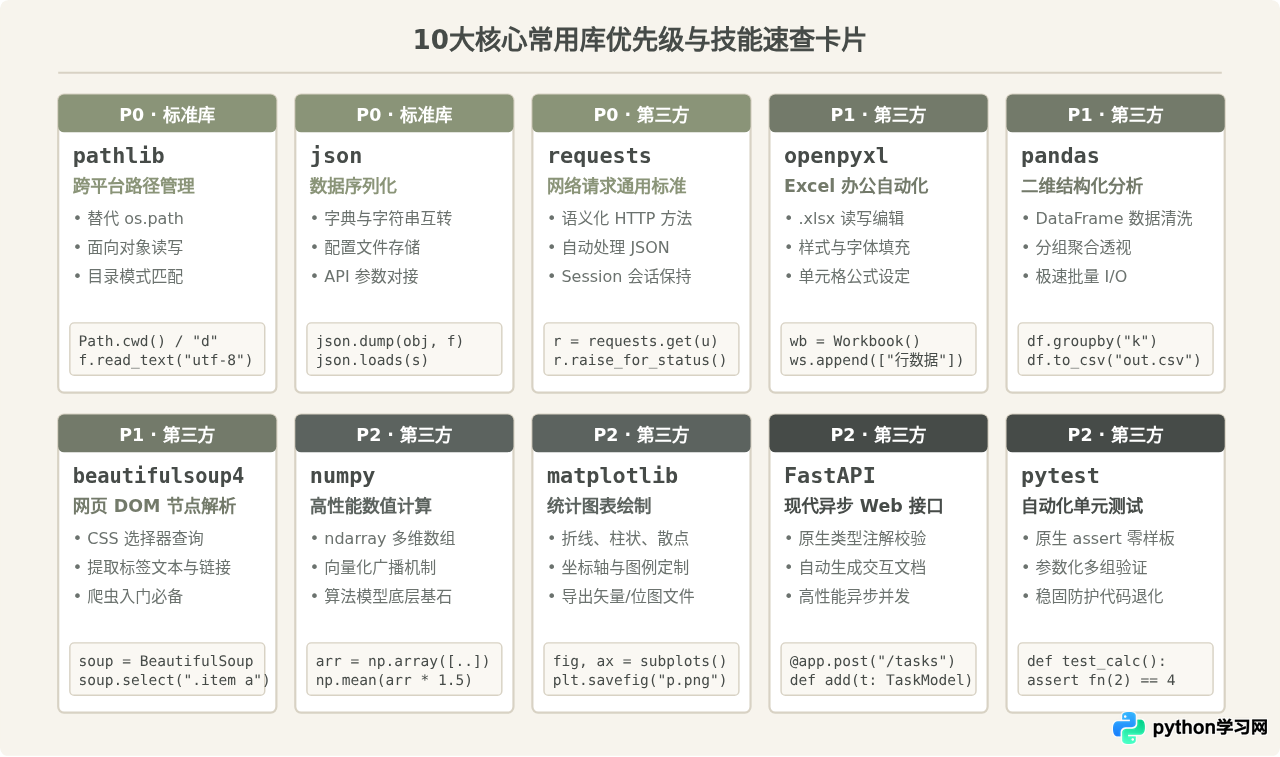
本文选取的 10 个库分为两大类别:
- 标准库(2个基础骨架):
pathlib与json。无需安装即可直接使用,负责解决最底层的本地文件组织与结构化数据交换问题。 - 第三方库(8个行业标准):涵盖网络请求(
requests)、数据抓取(beautifulsoup4)、表格处理(openpyxl)、数据分析与计算(pandas、numpy、matplotlib)、Web服务(FastAPI)以及代码质量守护(pytest)。
二、核心库详解与典型代码示例
1. pathlib:告别字符串拼接的现代文件路径库(标准库)
在 Python 3.4 之前,文件路径处理主要依赖 os.path,需要不断使用字符串分割和拼接函数。pathlib 采用面向对象设计,使用斜杠运算符 / 组合路径,跨平台自动适配 Windows 与 Unix 分隔符。
from pathlib import Path

# 获取当前工作目录并在其下创建子目录
data_dir = Path.cwd() / "report_data"
data_dir.mkdir(parents=True, exist_ok=True)

# 写入文本文件并重新读取
target_file = data_dir / "summary.txt"
target_file.write_text("任务已就绪\n文件行数: 100", encoding="utf-8")

# 列出目录下所有 txt 文件
txt_files = [f.name for f in data_dir.glob("*.txt")]
print(f"找到的文件: {txt_files}")
print(f"文件内容:\n{target_file.read_text(encoding='utf-8')}")文件内容:
任务已就绪
文件行数: 100
2. json:轻量级数据持久化与交换核心(标准库)
几乎所有现代 Web API 和配置文件都使用 JSON 格式。json 库负责在 Python 原生字典/列表与 JSON 字符串之间进行双向转换(序列化与反序列化)。处理中文时务必注意指定 ensure_ascii=False,否则输出会转为 Unicode 转义字符。
import json
from pathlib import Path

user_profile = {
    "user_id": 1024,
    "user_name": "李明",
    "roles": ["developer", "reviewer"],
    "is_active": True
}

# 序列化并写入文件
json_path = Path("user_info.json")
with open(json_path, "w", encoding="utf-8") as f:
    json.dump(user_profile, f, ensure_ascii=False, indent=2)

# 读取并反序列化回字典
with open(json_path, "r", encoding="utf-8") as f:
    loaded_data = json.load(f)

print(f"解析后的用户名: {loaded_data['user_name']}")
print(f"角色数量: {len(loaded_data['roles'])}")角色数量: 2
3. requests:人类友好的 HTTP 网络客户端(第三方)
虽然标准库有 urllib,但 requests 凭借优雅的 API 设计成为了事实上的行业通用标准。它自动处理连接复用、Cookie 保持、表单编码与 JSON 解码。调用外部网络资源时,必须养成显式指定 timeout 参数的习惯,避免请求永久挂起。
import requests

api_url = "https://httpbin.org/get"
query_params = {"source": "python_tutorial", "status": "active"}

try:
    response = requests.get(api_url, params=query_params, timeout=5)
    response.raise_for_status()  # 若返回4xx或5xx状态码则抛出异常
    result = response.json()
    print(f"响应状态码: {response.status_code}")
    print(f"接收到的参数: {result.get('args')}")
except requests.exceptions.RequestException as e:
print(f"网络请求失败: {e}")接收到的参数: {'source': 'python_tutorial', 'status': 'active'}
4. beautifulsoup4:网页数据抓取与解析利器(第三方)
对于不需要执行复杂 JavaScript 的静态网页抓取任务,requests 与 beautifulsoup4(通常简写为 bs4)是黄金搭档。bs4 允许通过 CSS 选择器或标签属性定位网页元素,从杂乱的 HTML 中准确抽离纯文本与链接。
from bs4 import BeautifulSoup

html_doc = """
<div class="content">
  <h2>常用技术清单</h2>
  <ul class="item-list">
    <li class="item" data-id="101"><a href="/python">Python基础</a></li>
    <li class="item" data-id="102"><a href="/pandas">Pandas分析</a></li>
  </ul>
</div>
"""

soup = BeautifulSoup(html_doc, "html.parser")
items = soup.select(".item-list .item a")

for item in items:
    title = item.get_text(strip=True)
    link = item.get("href")
print(f"条目名称: {title} | 链接: {link}")条目名称: Pandas分析 | 链接: /pandas
5. openpyxl:办公自动化与 Excel 表格读写(第三方)
日常工作中大量的业务报表以 .xlsx 形式流转。不同于 Pandas 偏向纯数据统计,openpyxl 专注于 Excel 文件本身的读写、样式调整、单元格公式设置和多 Sheet 管理,是初学者编写日常办公自动化脚本的首选。
import openpyxl
from openpyxl.styles import Font, PatternFill

# 创建新工作簿并激活默认工作表
wb = openpyxl.Workbook()
ws = wb.active
ws.title = "销售月报"

# 写入表头并设置简单样式
headers = ["月份", "部门", "成交额"]
ws.append(headers)

for cell in ws[1]:
    cell.font = Font(bold=True, color="464B48")
    cell.fill = PatternFill(start_color="EFECE6", end_color="EFECE6", fill_type="solid")

# 追加业务数据
ws.append(["10月", "华东分部", 158000])
ws.append(["10月", "华南分部", 214000])

wb.save("monthly_report.xlsx")
print("Excel 文件已成功生成并写入数据。")6. pandas:表格化数据清洗与结构化分析核心(第三方)
当数据量超过几万行,或需要进行复杂的分组聚合、透视表分析和数据缺失值处理时,原生列表与字典往往力不从心。pandas 提供了 DataFrame 二维表格对象,将数据筛选与统计浓缩为极简的声明式语法。
import pandas as pd

# 构建示例数据集
records = [
    {"department": "技术部", "level": "中级", "salary": 14000},
    {"department": "技术部", "level": "高级", "salary": 22000},
    {"department": "市场部", "level": "初级", "salary": 8500},
    {"department": "市场部", "level": "中级", "salary": 12500},
]

df = pd.DataFrame(records)

# 按部门分组计算平均薪资与人数
grouped = df.groupby("department")["salary"].agg(["mean", "count"]).reset_index()
grouped.columns = ["部门", "平均薪资", "员工人数"]

print(grouped.to_string(index=False))市场部 10500.0 2
技术部 18000.0 2
7. numpy:底层多维数组与数值计算基石(第三方)
numpy 是 Pandas、Matplotlib 以及几乎所有机器学习算法库的底层依托。其核心是 ndarray 数组对象,在内存中连续存储同类型数据,并通过 C 语言底层实现了高效的向量化计算,运算速度比原生 Python 循环快数十倍。
import numpy as np

# 生成等差序列并进行向量化四则运算
base_array = np.array([10, 20, 30, 40, 50], dtype=float)

# 统一上浮 15% 并计算开方
adjusted = base_array * 1.15
mean_val = np.mean(adjusted)
std_dev = np.std(adjusted)

print(f"调整后数组: {np.round(adjusted, 2)}")
print(f"均值: {mean_val:.2f} | 标准差: {std_dev:.2f}")均值: 34.50 | 标准差: 16.26
8. matplotlib:统计图表可视化基础工具(第三方)
通过代码直观观察数据趋势是验证分析结论的关键步骤。matplotlib 及其面向对象接口 pyplot 是 Python 可视化的基石,折线图、柱状图、散点图均可通过明确的坐标轴与图例控制精准绘制。
import matplotlib.pyplot as plt

categories = ["第1周", "第2周", "第3周", "第4周"]
actual_sales = [45, 62, 58, 80]
target_sales = [50, 55, 65, 75]

fig, ax = plt.subplots(figsize=(6, 3.5))
ax.plot(categories, actual_sales, marker="o", label="实际销量", color="#464B48")
ax.plot(categories, target_sales, marker="s", linestyle="--", label="目标销量", color="#8A9478")

ax.set_title("月度各周销量对比")
ax.set_ylabel("销量 (万件)")
ax.legend()
ax.grid(True, linestyle=":", alpha=0.6)

plt.tight_layout()
plt.savefig("sales_chart.png", dpi=150)
print("可视化图表已成功保存为 sales_chart.png。")9. FastAPI:现代、类型提示驱动的 Web 接口框架(第三方)
传统的 Web 框架(如 Django、Flask)各有特色,但现代后端开发高度依赖 RESTful API。FastAPI 基于 Python 3.6+ 的类型注解(Type Hints),提供了自动数据校验、异步高并发支持以及开箱即用的交互式文档(Swagger UI)。
from fastapi import FastAPI
from pydantic import BaseModel

app = FastAPI(title="任务管理服务")

class TaskCreate(BaseModel):
    title: str
    priority: int = 1

@app.post("/tasks/")
def create_task(task: TaskCreate):
    return {
        "status": "success",
        "task_title": task.title,
        "priority_level": task.priority,
        "assigned_id": 8801
    }

# 启动命令: uvicorn main:app --reload10. pytest:简单而强大的自动化测试框架(第三方)
编写脚本与维护工程最大的区别在于是否具备持续验证能力。内置的 unittest 框架需要编写繁重的样板类与特定的断言方法,而 pytest 允许直接使用原生 assert 关键字,支持参数化测试与灵活的 Fixture 夹具机制。
# test_calculator.py
import pytest

def calculate_discount(price: float, discount: float) -> float:
    if not (0 <= discount <= 1):
        raise ValueError("折扣率必须在0到1之间")
    return round(price * discount, 2)

def test_valid_discount():
    assert calculate_discount(100.0, 0.8) == 80.0
    assert calculate_discount(250.0, 0.5) == 125.0

def test_invalid_discount():
    with pytest.raises(ValueError, match="折扣率必须在0到1之间"):
calculate_discount(100.0, 1.5)collected 2 items
test_calculator.py .. [100%]
============================== 2 passed in 0.03s ===============================
三、学习优先级与阶段落地建议
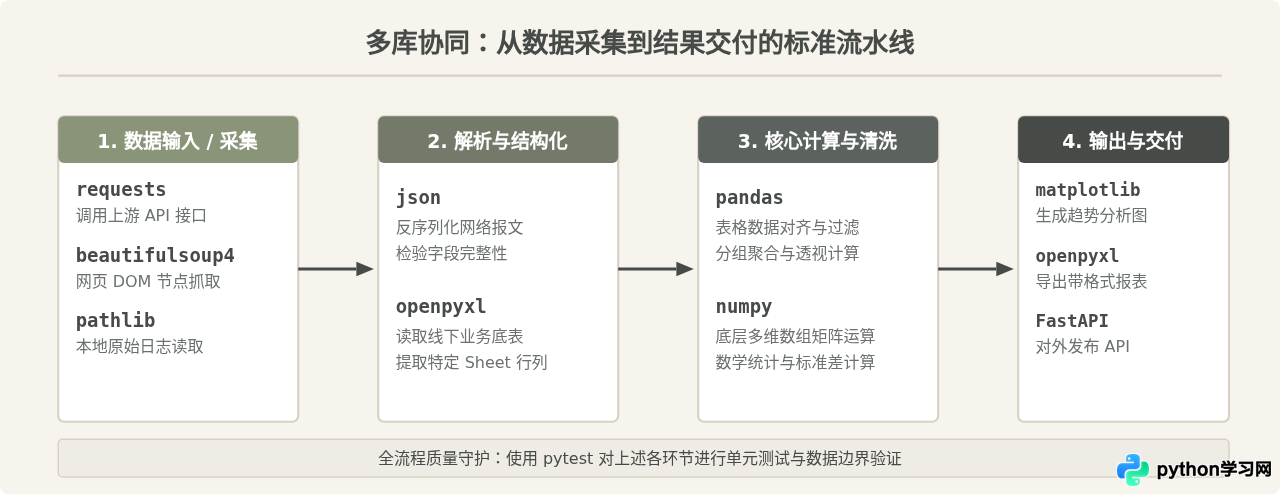
很多新手之所以感到内容杂乱,是因为把不同层级的工具混在同一时间段学习。建议将学习过程分为三个有明确验收标准的阶段:
第一阶段:通用基础设施(建议耗时 1 周)
目标是打通单机环境与网络环境的数据读写闭环。优先掌握 pathlib、json、requests:
- 验收标准:能用
pathlib遍历某个文件夹并过滤指定格式;能用requests请求一个公开的 RESTful API 并通过json模块将返回数据完整保存到本地。 - 避坑要点:不要在此阶段去钻研网络并发(如 asyncio/aiohttp)或复杂正则表达式,现阶段只关注稳定读取与单次写入。
第二阶段:按业务方向分流深化(建议耗时 2~3 周)
根据自身的核心工作目标进行二选一,切忌两路并行:
- 方向 A(办公自动化与数据分析):以
openpyxl为切入点,快速完成自动填充报表的实用脚本获得正向反馈;随后学习pandas掌握表格清洗与分组统计;需要更高级数学运算时补充numpy;最后使用matplotlib生成统计图。 - 方向 B(网络爬虫与接口开发):结合第一阶段的 requests,深入学习
beautifulsoup4处理 HTML 文档树;随后学习FastAPI,尝试把自己写好的数据处理逻辑包装为 HTTP 接口供前端或其他程序调用。
第三阶段:工程规范与代码保障(贯穿中长期)
当单文件脚本逐渐演进为包含多个模块的小型项目时,引入 pytest:
- 验收标准:对项目中的关键计算函数编写至少 3 个正常输入与 2 个异常输入的测试用例,运行 pytest 命令能够全部通过。
- 收益:后续无论如何重构代码或升级依赖库,一条测试命令即可确认原有业务功能未受破坏。
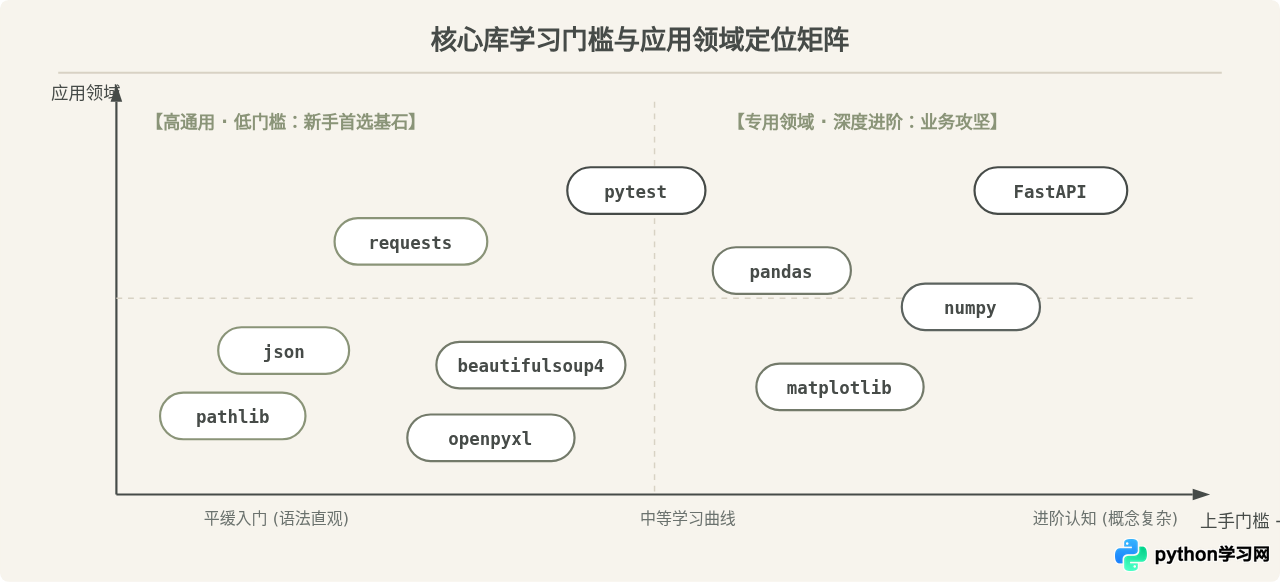
四、容易混淆的三个常见认知辨析
看似合理的理由:在大多数教程与榜单推荐中,Pandas 与 NumPy 几乎总是排在最前面,各大数据分析课程也把它们作为必修第一课。
成立的条件:如果你的学习目标非常明确,就是要从事专职数据分析、商业智能(BI)或量化交易,那么掌握多维数组切片和数据透视确实是刚需。
修正建议与反例:对于日常办公自动化或开发脚本的读者,过早陷入 Pandas 复杂的索引层级(MultiIndex)和多轴运算,反而会极大地打击信心。例如,只是想把几份格式固定的 Excel 汇总到一起,使用 pathlib 遍历路径搭配 openpyxl 逐行追加,仅用 20 行代码即可平稳解决,完全不需要为每个数据框建立庞大的内存视图。
看似合理的理由:标准库开箱即用,免去 pip 安装依赖的步骤,且在极度精简的服务器镜像中部署阻力最小。
成立的条件:如果在完全无法访问外部镜像源的隔离生产机中,仅仅需要发送一次非常简单的 HTTP GET 请求读取静态文本,urllib.request 确实能完成任务。
修正建议与反例:一旦遇到需要维持登录状态(Session)、自动解析 JSON 响应、配置连接超时或设置复杂代理的场景,urllib 需要编写大量底层处理代码,且容易因为忽视超时而导致主线程假死。requests 封装了底层 socket 连接池与异常类型,能大幅减少防范网络抖动所需的防御性代码。
看似合理的理由:很多初学者习惯像背诵词汇表一样逐个记忆函数名与可选参数,认为能默写出来才算掌握。
成立的条件:每个库中最基础且高频的 3~5 个方法(如 Path.read_text()、requests.get()、pd.read_csv())确实需要熟记,以保持流畅的书写节奏。
修正建议与反例:第三方库的版本更迭非常频繁,不同版本的参数名可能微调,死记硬背效率极低。真正关键的是掌握库的“职责边界”与“数据输入输出流转方式”——知道什么问题找哪个库处理,并能够看懂官方文档的快速上手指南(Quickstart),这才是能够长期复用的专业开发能力。
五、核心库关键信息速查清单
下表汇总了这 10 个库的定位、类型、建议优先级及核心使用场景,供学习时对照查阅:
| 库名称 | 来源分类 | 优先级建议 | 核心功能与职责 | 推荐掌握的关键对象/函数 |
|---|---|---|---|---|
| pathlib | 标准库 | 第一阶段 (P0) | 面向对象跨平台文件与路径操作 | Path, glob(), read_text() |
| json | 标准库 | 第一阶段 (P0) | 结构化文本与原生字典/列表互转 | dump(), load(), dumps() |
| requests | 第三方 | 第一阶段 (P0) | 发起 HTTP 网络请求与接口交互 | get(), post(), Response.json() |
| openpyxl | 第三方 | 第二阶段 (P1) | 针对 .xlsx 格式的单元格样式与报表操作 |
Workbook, load_workbook() |
| pandas | 第三方 | 第二阶段 (P1) | 大规模二维数据清洗、聚合统计与透视 | DataFrame, read_csv(), groupby() |
| beautifulsoup4 | 第三方 | 第二阶段 (P1) | 解析 HTML/XML 结构并提取网页节点内容 | BeautifulSoup, select(), find_all() |
| numpy | 第三方 | 第二阶段 (P2) | 高性能同构多维数组与底层矩阵数学运算 | ndarray, array(), mean() |
| matplotlib | 第三方 | 第二阶段 (P2) | 绘制折线、柱状、散点等二维统计数据图表 | pyplot.subplots(), plot(), savefig() |
| FastAPI | 第三方 | 第二阶段 (P2) | 高并发现代化 RESTful API 后端接口搭建 | FastAPI, BaseModel, 路由装饰器 |
| pytest | 第三方 | 第三阶段 (P2) | 轻量高效的自动化单元测试与质量验证 | assert 原生断言, raises(), Fixture |
六、新手落地实践与防踩坑建议
在开始安装和使用上述核心库时,请保持以下良好习惯:
- 必须使用虚拟环境管理依赖:不要在全局 Python 环境中盲目执行
pip install。每个新项目开始前,先在项目根目录执行python -m venv .venv,激活后再安装所需库,避免不同项目间的依赖版本产生冲突。 - 使用 requirements.txt 锁定版本:项目开发稳定后,通过
pip freeze > requirements.txt记录依赖清单。协同他人或迁移服务器时,只需执行pip install -r requirements.txt即可一键还原完整运行环境。 - 掌握“查手册”而非“硬记”的心态:标准库可以直接查看 Python 官方文档中的标准库索引;第三方库(如 Requests、Pandas、FastAPI)均有极其详尽的官方 Quickstart。熟悉官方文档结构,在实践中遇到问题先查对应章节,是开发者最关键的核心技能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









