

怎么挑选基于Python 3的程序设计基础书
针对零基础与不同学习目标的读者,系统梳理挑选基于Python 3的程序设计基础书的核心标准、避坑指南、结构拆解与实操挑选步骤。
挑选一本实用的Python 3程序设计基础书,核心在于“版本基准是否现代化、代码组织是否符合Python惯用法、例题梯次是否支持动手实操,以及编排逻辑是否契合自身学习目标”。只要依据清晰的筛选指标与试读流程,就能在众多书目中快速过滤低质教材,找到适合自学或入门的读本。
一、硬性底线:区分真假“Python 3”教材
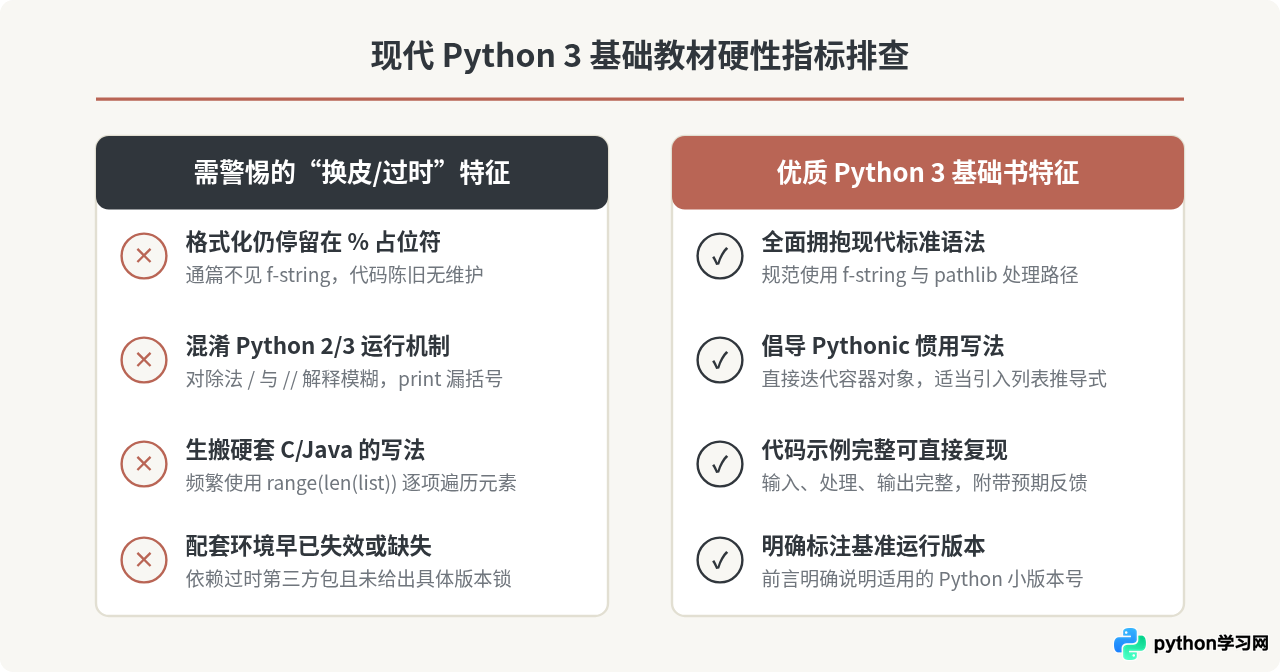
虽然Python 2早在2020年便已正式停止维护,但市场上仍有部分入门图书存在“换汤不换药”的现象。这类图书在封面上标注文明支持Python 3,正文代码却残留了大量过时的语法与思维惯性。如果读者按照这类教材起步,不仅会在运行代码时频繁报错,还会形成落后的编程习惯。
在翻阅或选购任何基础书时,建议直接定位以下两三个具体的代码细节进行核验:
- 字符串格式化语法:现代Python 3(Python 3.6及以上)普遍推崇格式化字符串字面值(即f-string,形如
f"Hello, {name}")。如果一本书在全书各章节依然通篇使用旧式的%运算符(如"Hello, %s" % name),甚至连str.format()都鲜有提及,说明其内容更新极不彻底。 - 除法运算与print函数:核对
print是否作为函数使用(带括号),以及整数相除(如5 / 2)是否得到浮点数2.5。如果书中还在大篇幅讨论“两个整数相除只保留整数商”且未引入//整除运算符,则属于典型的旧版本残留。 - 字典与迭代器机制:Python 3中
dict.keys()、dict.values()返回的是动态视图而非独立列表;标准内置函数range()本身也是惰性求值的序列对象。劣质翻新教材常会在这些概念上出现含混不清的表述。
二、目标匹配:明确两类典型的读者定位
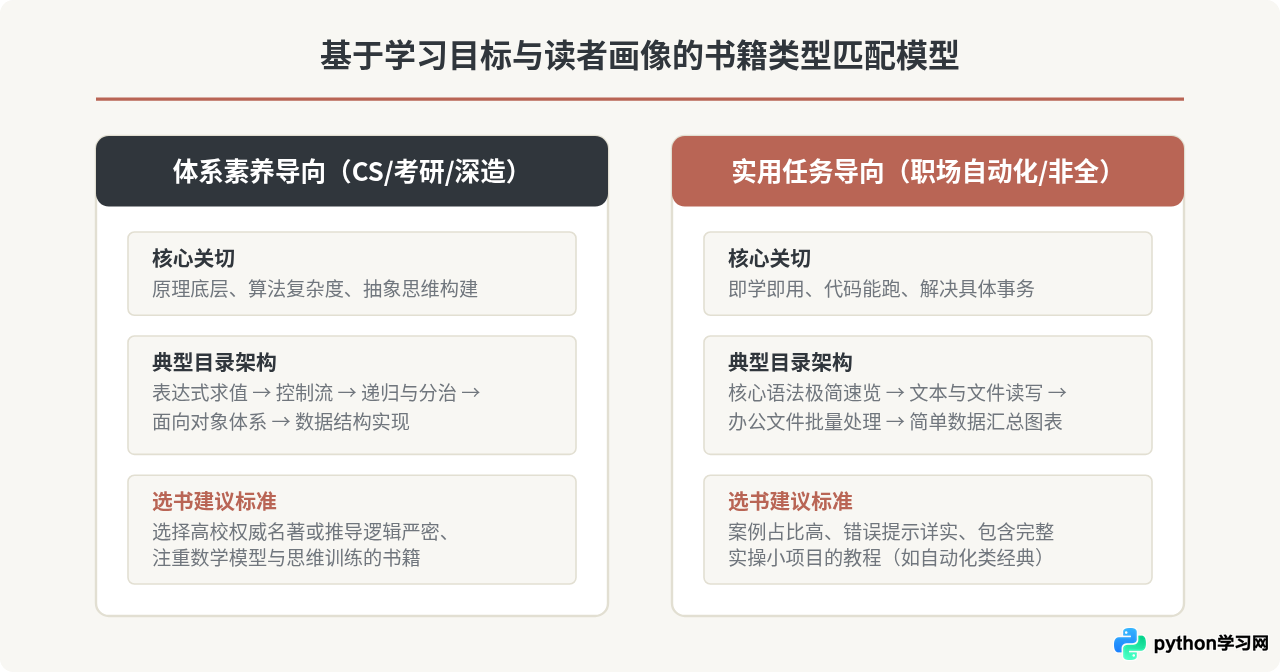
没有放之四海而皆准的“神作”,图书的价值取决于它与读者当前知识储备和学习目的的吻合度。挑选基础书的第一步,是认清自己究竟属于以下哪种类型:
1. 计算机专业素养型(重在原理与计算思维)
如果读者的目标是系统建立计算机科学的基础知识体系,未来计划深入学习算法、数据结构、底层架构或软件工程,那么应当挑选偏向“计算机科学导论”性质的教材。这类书籍通常具备以下特点:
- 章节编排严格遵循计算模型、数据抽象、控制抽象、算法复杂度(Big-O)、递归设计与面向对象体系;
- 习题具有较强的数学性或逻辑推演性质,例如数值近似计算、排序查找算法实现、递归遍历二叉树;
- 典型代表风格如国内外高校计算机专业的经典教材,强调“如何像计算机科学家一样思考”。
2. 任务驱动应用型(重在实用与效率转化)
如果读者来自非计算机专业(如财务、运营、科研、数据分析等领域),学习Python的核心目的是快速编写脚本处理Excel表格、抓取网络数据、自动化整理文件,那么挑选理论大部头往往会导致在初期被枯燥的指针抽象和语法规范劝退。此时应当选择以实际任务驱动的基础书:
- 前三分之一精炼介绍语法核心(变量、列表、字典、条件循环与函数),后三分之二直接进入办公自动化、文件系统操作或简单数据清洗;
- 练习题贴近日常实际工作场景,能迅速看到实操产出,获得正向反馈;
- 讲解重点放在标准库与实用第三方库的运用逻辑,不过早深入元类、装饰器、底层内存回收等进阶机制。
三、内文质量:四个维度的关键细节考察
翻开一本备选图书的样章或目录时,切忌泛泛阅读概念介绍。高质量的编程入门书与低质量粗制滥造之作,往往在以下四个维度拉开明显差距:
1. 代码的完整性与自洽性
初学者最大的挫败感往往来自于“照着书上抄代码,运行却报错”。好的基础教材在给出代码示例时,必须满足“全闭环”要求:
- 包含完整的变量初始化、模块导入(
import语句)和输出捕获; - 明确区分用户的输入指令与解释器的输出结果,而不是把代码片段散落在长篇大论中,让读者猜测上下文;
- 变量名和逻辑保持一致,不出现前文用
data_list后文突然跳出未定义的items等排版或校对低级错误。
2. 梯次进阶的习题与反馈机制
编程是一门高度依赖动手的技艺,光看懂文字不代表掌握技能。重点观察书后的习题设计:
- 拒绝纯记忆填空题:例如“简述Python有哪几种标准数据类型”,这种考查方式对编程实操几乎没有意义;
- 推崇场景实操题:例如“编写一个程序,读取包含逗号分隔的成绩文本,计算平均分并输出前三名”,这种题目能有效检验变量、循环、文件IO与列表排序的综合运用;
- 提供获取参考解答与源码的公开途径:作者或出版社是否提供了干净规范的代码仓库(如GitHub或随书资源包)。
3. 面向对象(OOP)的引入时机与铺垫
面向对象是很多初学者的“拦路虎”。劣质图书往往在讲完基本循环后,立刻生硬地列出类、对象、多态、单继承多继承等一堆晦涩名词,并用诸如“人是类,张三是对象,动物会叫”等空洞例子搪塞。
真正懂得教学的作者,会先让读者写出过程式的函数,展示当程序规模扩大、数据与行为紧密耦合时的管理困境,随后自然引出class如何把状态和操作打包在一起。翻看第7至9章关于“类与对象”的讲解,是检验作者教学功底的试金石。
4. 异常处理与调试排错的重视程度
新手编写代码时,报错是家常便饭。一本负责任的教材,不会假定读者每次都能输入合规的数据。观察书中是否尽早且系统地讲授了try...except语句、常见内置异常类型(如ValueError、IndexError、KeyError),以及如何读懂Python解释器打印的追溯栈信息(Traceback)。懂得教读者看懂报错信息的书,能帮读者省去大量自学卡壳的痛苦。
四、落地实操:四步挑选与试读评估流程
在实际购书或挑选借阅时,推荐按照标准化的四个步骤依次进行排查:
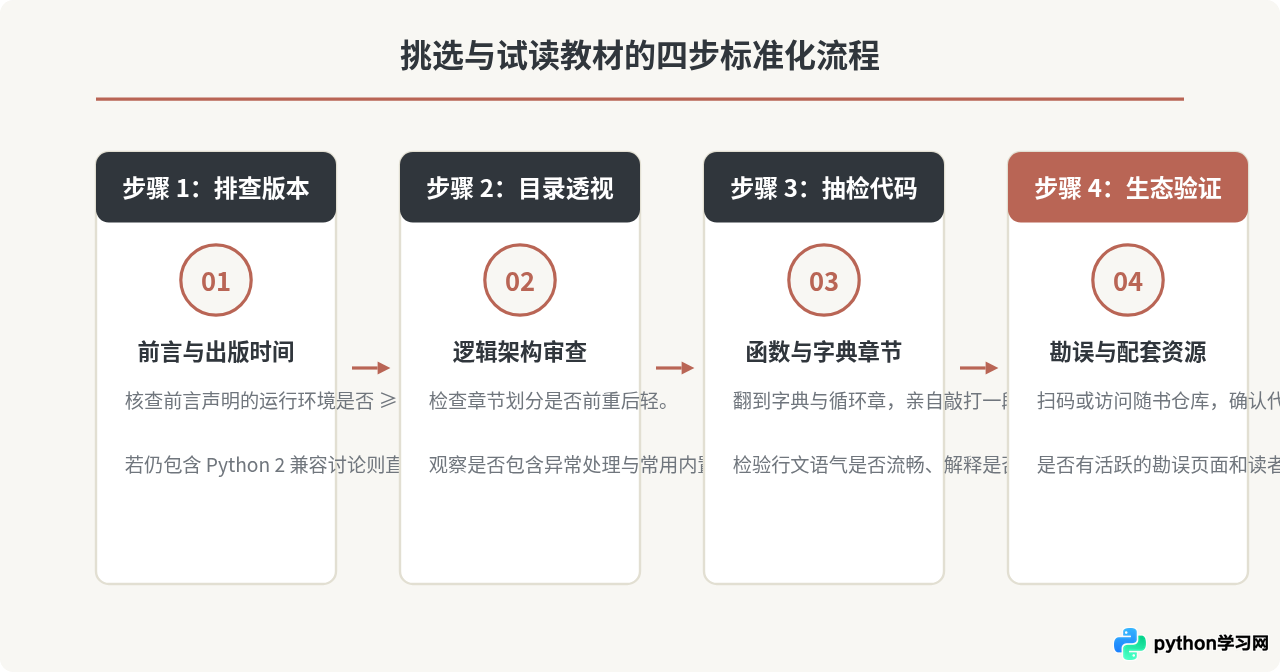
为了让这套流程能够具体落地,以下是每个步骤的操作细则:
- 步骤一:排查版本声明。翻到前言或版权页,查看图书付印时间以及前言中提及的基准Python版本。优先选择明确以Python 3.8至3.12为基准的新近版本,避免选择2015年以前出版且未曾全面修订的老旧教材。
- 步骤二:目录结构透视。合格的基础书应该呈现平缓且持续上升的坡度:从数据类型、条件循环、函数式封装,过渡到容器高级特性、文件与目录处理、错误处理。若目录前两章还在用几十页纸罗列操作系统发展史、计算机二进制转换,后文却骤然切入复杂算法,说明全书缺少教学节奏规划。
- 步骤三:抽样试读中段核心章。通常推荐抽检第5章或第6章(多为字典、集合或函数定义)。观察作者如何讲解字典的键唯一性、如何解释函数参数传递(引用与对象变动),代码示例是否能在本地终端或IDLE中一次性运行通过。
- 步骤四:验证配套支持与勘误。任何编程书籍都难以百分之百避免排版错漏。查验书籍是否附带在线源码仓库。如果有持续更新的勘误表(Errata)或答疑论坛,说明作者与出版机构对内容质量保持负责态度,自学过程遇到的阻碍也会大幅减少。
五、常见误区与辨析
在挑选基础书的过程中,初学者往往容易陷入以下两个极端观念:
像《Python核心编程》或官方参考手册类书籍,定位是“工具书与全景字典”,适合已经掌握编程思维的开发者随时查阅特性边界。初学者若以此入门,往往会在繁杂的元类、内置魔术方法、C底层实现等细节中耗尽学习热情。入门阶段应优先选择250至400页左右、专注核心骨架与高频技能的精炼教程。
虽然网络零散文章更新迅速,但碎片化博文通常缺乏前后知识依赖的严密推导,读者很容易陷入“知其然不知其所以然”的碎片拼接状态。一本结构严谨的高质量纸质基础书,能提供系统化的认知路径和连贯的动手实验链条,这种系统性思维的培养是碎片搜索无法替代的。
六、综合选书评估与总结
综合上述标准,在选定一本基于Python 3的程序设计基础书之前,可以通过下方的评分矩阵进行快速权衡:
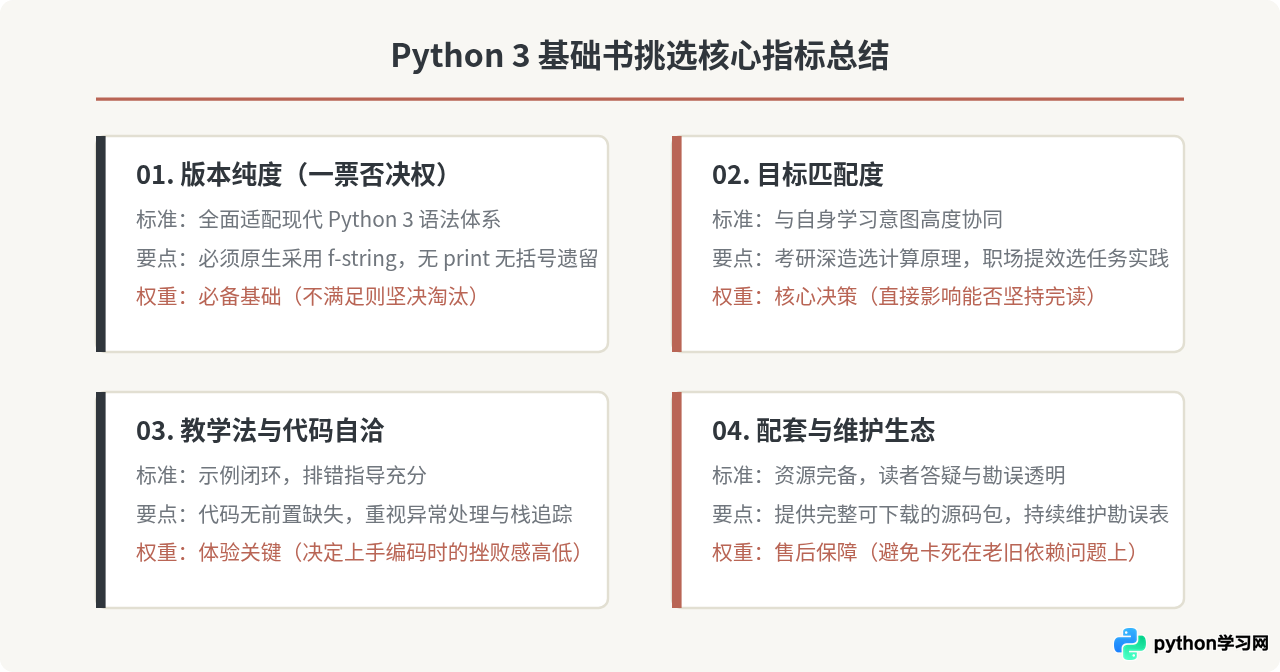
挑选一本好书是程序设计学习旅程中最省时的一步投资。通过先定版本真伪、再定应用目标、抽检代码自洽、核验配套生态的务实步骤,初学者完全可以在开始编写第一行代码之前,为自己构筑起坚实可靠的学习路径。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









