

Python有编译器吗?解释器与编译器的区别及CPython运行机制
深入解析Python是否有编译器、解释器与编译器的核心区别,以及官方实现CPython从源代码到字节码再到虚拟机的完整运行机制。
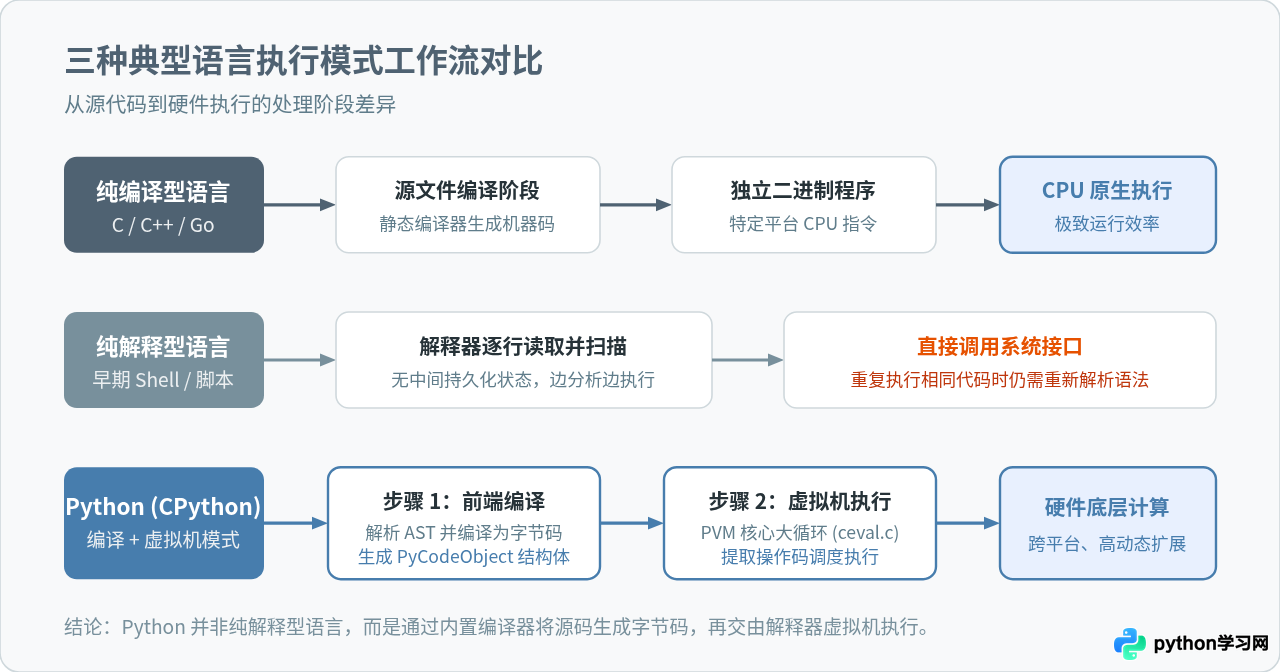
直接给出确切答案:Python 确实有编译器。很多初学者在学习编程时,经常接触到一个说法:“C 语言是编译型语言,Python 是解释型语言”。这种分类方式为了便于入门做了极大简化,但也给许多人留下了误解,以为 Python 像早期的 Shell 脚本那样,读取一行源码文本就直接让 CPU 执行一行。实际上,Python 官方标准实现(CPython)采用的是典型的“先编译后解释”的混合运行模型。任何 Python 脚本在交由虚拟机执行之前,内部都会先调用编译器将其编译成平台无关的中间指令集——字节码(Bytecode)。
一、解释器与编译器的本质区别
要透彻理解 Python 的运行方式,首先需要厘清计算机科学中“编译器”(Compiler)与“解释器”(Interpreter)在设计目标与执行路径上的核心差异。
计算机底层的中央处理器(CPU)只能识别和执行由 0 和 1 组成的机器指令(Machine Code)。无论是用 C、Rust、Java 还是 Python 编写的代码,最终都必须以某种方式转换成机器指令才能发挥作用。编译器与解释器的区别,就在于转换的时机、交付的产物以及执行的环境:
- 传统编译器(Ahead-of-Time Compiler, AOT):在程序真正运行之前,对完整的源代码进行词法分析、语法分析、语义检查和机器级代码优化,直接生成目标平台专属的原生二进制可执行文件(如 Windows 下的
.exe或 Linux 下的ELF二进制)。程序交付给最终用户时,不再需要源代码,也不依赖编译器本身,由操作系统装载后直接在硬件 CPU 上高速运行。典型代表有 C、C++、Go 和 Rust。 - 传统解释器(Pure Interpreter):直接读取原始的源码文本,边解析语句边调用解释器自身的底层逻辑去执行操作,不生成持久化的独立机器码文件。这种方式开发调试灵活,但每次执行同一段循环或代码都要重新进行字符串解析与语法推导,运行效率相对较低。早期交互式 BASIC 和部分 Shell 脚本属于这一类。
- 现代虚拟机混合模式(Bytecode + VM):为了兼顾开发效率、动态语言特性与运行性能,现代主流语言(如 Java、Python、C#)均采用了折中架构。源码先由编译器翻译为结构规整、紧凑紧凑的“字节码”(Bytecode),再由专门的虚拟机(Virtual Machine)逐条解释执行或即时编译(JIT)运行。
| 对比维度 | 纯编译型(如 C/Go) | 纯解释型(早期脚本) | 混合型(如 Python / Java) |
|---|---|---|---|
| 预处理编译阶段 | 有,直接生成原生机器指令 | 无,直接读取源码运行 | 有,先编译成中间字节码 |
| 交付与分发产物 | 机器二进制文件(特定平台) | 原始代码文本 | 源码或字节码(.pyc / .class) |
| 执行宿主 | 操作系统与硬件 CPU 直接调度 | 解释器进程边读边做 | 软件虚拟机(如 PVM / JVM) |
| 跨平台方式 | 需针对目标架构重新交叉编译 | 只要目标环境装有解释器即可 | 一次编译字节码,跨平台虚拟机运行 |
| 错误发现时机 | 编译阶段捕获绝大部分语法/类型错误 | 运行到出错行才报错 | 编译期捕获语法错误,运行期捕获类型错误 |
二、CPython 内部运行机制深度拆解
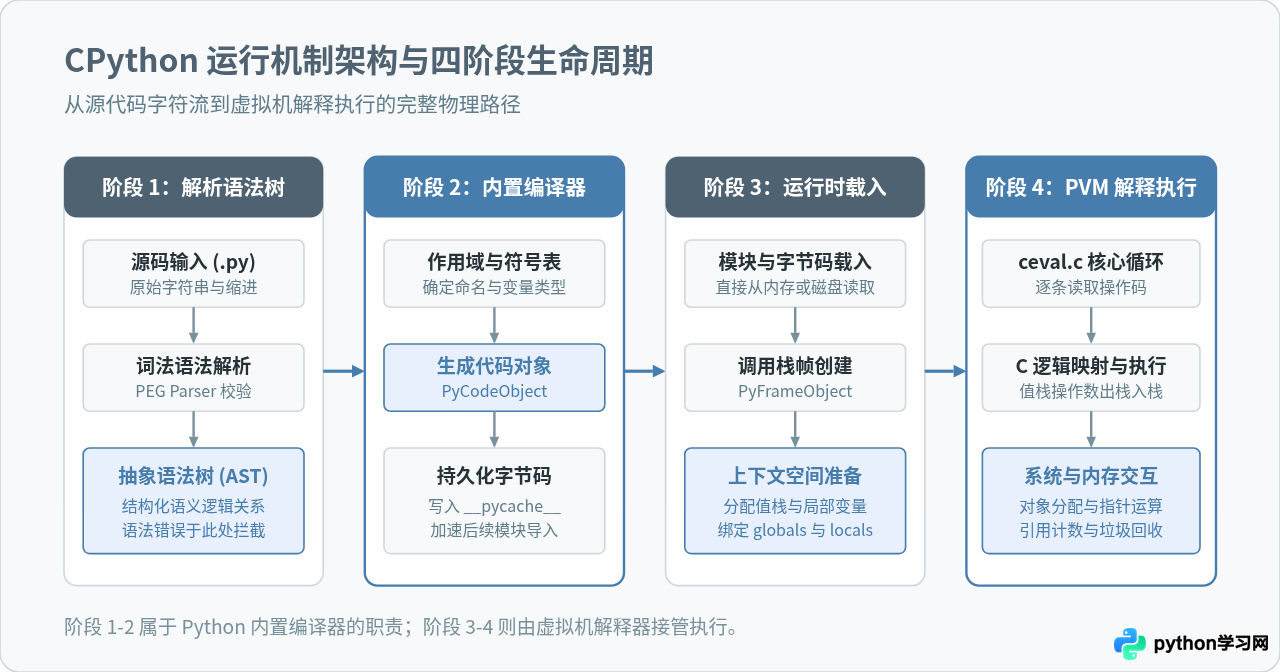
当我们在终端键入 python main.py 并回车时,CPython 解释器进程在幕后启动并完成了一系列精密的流水线作业。整个流程可以明确划分为四个阶段:
1. 词法分析、语法分析与 AST 构建
CPython 首先激活其解析器(在 Python 3.9+ 中采用先进的 PEG 解析器)。解析器将文本流转换为标记流(Tokens),随后验证语法结构,构建出一棵抽象语法树(Abstract Syntax Tree, 简称 AST)。AST 以树状结构准确描述了代码中的控制流、表达式、变量赋值和函数调用层次。如果代码中存在拼写错误(如少写冒号或括号不匹配),程序在此阶段就会立即抛出 SyntaxError 并中断退出。此时代码根本尚未开始在虚拟机中执行,这正是编译阶段的典型特征。
2. 编译器生成字节码(PyCodeObject)
AST 构建完成后,CPython 的编译器组件(主要是 compile.c)正式接管。编译器遍历 AST,结合符号表(Symtable)进行变量作用域绑定(区分全局变量、局部变量、自由闭包变量等),然后将树形节点扁平化,生成线性的操作指令序列——字节码(Bytecode)。
在 CPython 内部,这些字节码和相关元数据(如常量表、变量名元组、文件名、行号映射表等)被封装成一个 C 语言结构体,即 PyCodeObject。如果当前执行的代码是一个被引用的模块,CPython 还会将这个 PyCodeObject 序列化并附加当前 Python 版本的 Magic Number 和文件时间戳,存储到磁盘上的 __pycache__ 目录中,生成 .pyc 文件。
3. Python 虚拟机(PVM)与栈帧构建
字节码生成后,工作重心转移到 Python 虚拟机(Python Virtual Machine, 简称 PVM)。PVM 并不是像 VMware 或 VirtualBox 那样的操作系统级硬件仿真器,而是一个基于栈架构(Stack-based Architecture)的软件执行循环。
每当进入一个作用域(如调用一个函数),PVM 就会为其分配一个调用栈帧(PyFrameObject)。栈帧中保存了该函数运行所需的值栈(Evaluation Stack)、局部变量快速查找数组、全局命名空间映射字典以及当前指令指针(Instruction Pointer)。
4. 评估执行大循环(ceval.c)
PVM 的核心实现位于 CPython 源码的 Python/ceval.c 文件中,其核心逻辑是一个巨大的条件循环(在很多版本中是 _PyEval_EvalFrameDefault 函数)。虚拟机指针从头开始读取字节码中的每一条操作码(Opcode),利用 switch-case 派发机制跳转到对应的 C 语言实现逻辑,从值栈中弹出操作数、执行加减乘除、调用对象方法或处理跳转,直至整个程序退出。
三、实操验证:亲手观察与反汇编 Python 字节码
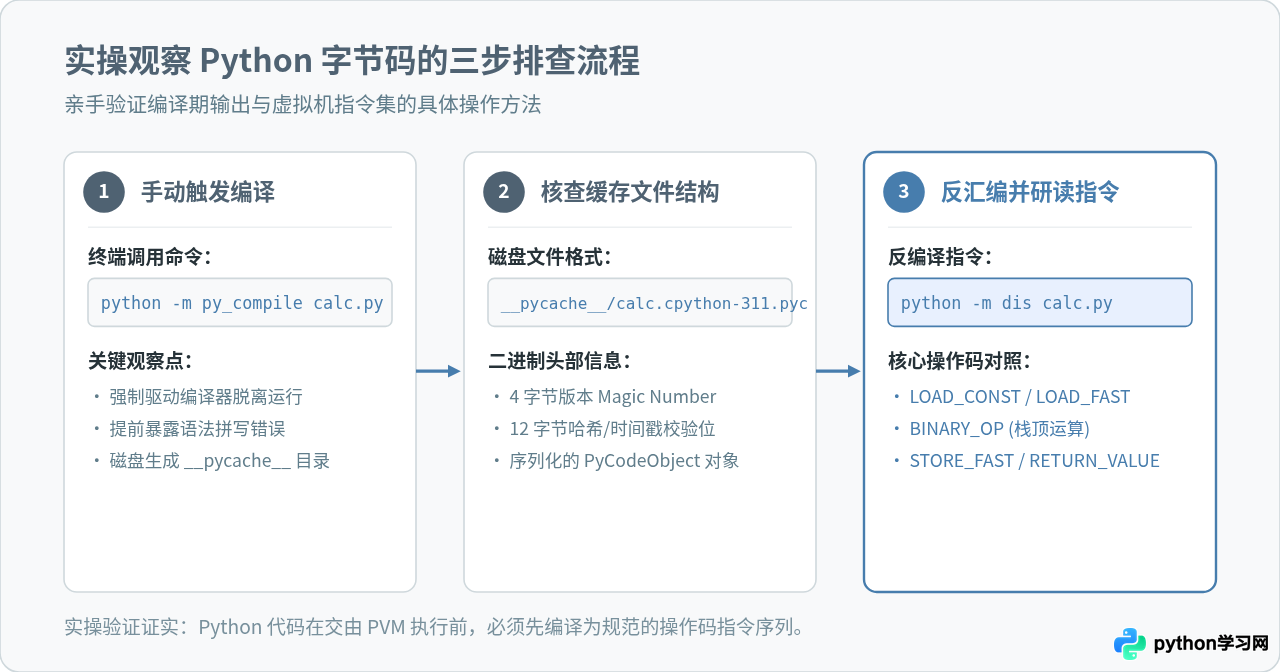
为了直观感受编译器的存在与字节码的形态,我们可以通过 Python 内置的标准库工具进行三个具体步骤的实操验证。
步骤 1:准备一个简单的测试脚本并手动触发编译
在工作目录下创建一个名为 calc.py 的文件,写入如下简单函数:
# calc.py
def add_and_multiply(a, b):
    base = 10
    total = a + b
    return total * base

if __name__ == "__main__":
    result = add_and_multiply(3, 5)
    print("计算结果:", result)
通常情况下,运行 python calc.py 时,主入口脚本的编译过程是在内存中默默完成的,不会主动写盘。如果想要像传统编译器那样显式生成字节码文件,可以使用内置模块 py_compile:
python -m py_compile calc.py执行完毕后,命令控制台不会输出任何冗余文本,但在当前目录下会立即生成一个 __pycache__ 文件夹,里面包含了类似 calc.cpython-311.pyc 的二进制文件。如果源代码存在拼写或语法错误,执行该命令会在不运行任何业务逻辑的情况下直接报错,这清晰证明了“编译”与“执行”的分离。
步骤 2:查看 .pyc 缓存结构与特征
.pyc 是一个包含魔数(Magic Number)和序列化字节码的二进制文件,直接用文本编辑器打开会显示乱码。它的标准头部包含 16 字节的元信息:
- 第 0~3 字节:特定 Python 版本的魔数(如 Python 3.11 为
\xa7\r\r\n),确保不会被错误版本的解释器加载。 - 第 4~7 字节:位字段标志位(PEP 552,用于基于哈希还是基于时间戳校验缓存有效性)。
- 第 8~11 字节:源文件
calc.py最后修改时间戳。 - 第 12~15 字节:源文件的实际大小(字节数)。
- 剩余字节:通过 Python 内部的
marshal模块序列化存储的PyCodeObject完整数据。
步骤 3:使用 dis 模块反汇编字节码
虽然字节码是二进制指令,但 Python 提供了极其方便的标准反汇编模块 dis,可以将字节码转化为人类可读的汇编助记符:
python -m dis calc.py或者在 Python 交互式命令行(REPL)中对特定函数进行反汇编:
>>> import dis
>>> from calc import add_and_multiply
>>> dis.dis(add_and_multiply)
终端将输出如下反汇编清单(以 Python 3.11 为例):
  2           0 RESUME                   0

  3           2 LOAD_CONST               1 (10)
              4 STORE_FAST               2 (base)

  4           6 LOAD_FAST                0 (a)
              8 LOAD_FAST                1 (b)
             10 BINARY_OP                0 (+)
             14 STORE_FAST               3 (total)

  5          16 LOAD_FAST                3 (total)
             18 LOAD_FAST                2 (base)
             20 BINARY_OP                5 (*)
             24 RETURN_VALUE
对照输出,我们可以清晰地看到编译器的产物:
LOAD_CONST 1 (10):从常量表中取出常量10,压入 PVM 的值栈。STORE_FAST 2 (base):将栈顶的值弹出,存储到局部变量数组的第 2 个槽位(对应变量base)。LOAD_FAST 0 (a)与LOAD_FAST 1 (b):依次将形参a和b压入栈顶。BINARY_OP 0 (+):弹出栈顶两数相加,并将相加结果重新压入栈顶。RETURN_VALUE:弹出栈顶的值作为函数最终返回值返回给调用者。
四、常见误区:.pyc 缓存到底加速了什么?
.pyc 文件只会加快程序的加载与启动耗时,丝毫不会提高程序运行中算法逻辑的纯计算执行速度。
许多初涉 Python 的工程师容易产生一个常见的误解:认为只要有了 .pyc 文件,Python 就会跑得更快,甚至接近 C 语言的速度。其实只要了解了前面的架构,就会明白这个判断的盲区在哪里:
- 省去的是前端编译开销:如果存在有效的
.pyc缓存,且源文件的修改时间戳与.pyc中记录的一致,Python 会直接把.pyc反序列化为内存中的代码对象,跳过了“字符扫描 -> 词法分词 -> AST 语法树构建 -> 字节码编译”的前端流程。对于大型项目(涉及数百个模块导入)而言,这极大地缩短了冷启动时间。 - 执行阶段毫无区别:不管是即时从
.py编译出来的字节码,还是直接从.pyc读进来的字节码,进入 PVM 虚拟机之后,指令内容是完全一致的。PVM 依然要通过ceval.c的大循环逐条解释执行操作码。因此,单纯依靠.pyc绝不会减少运行循环、数值计算或 I/O 操作的一毫秒耗时。
五、进阶拓展:JIT 编译器与不同 Python 实现
当我们讨论“Python 是否有编译器”时,默认指代的是官方用 C 语言实现的参考版本 CPython。实际上,Python 是一门语法规范,存在多种不同的运行时实现,它们在编译与执行机制上有着更显著的演进:
- PyPy(自带 JIT 编译器):PyPy 是 Python 官方规范的替代实现,其最大特点是内置了即时编译器(Just-In-Time Compiler, JIT)。在运行过程中,PyPy 不仅把代码编译成字节码,还会跟踪分析运行频率极高的“热点循环”(Hotspots),在运行期间将这些热点字节码直接动态编译成底层的原生机器码,从而使纯计算型 Python 程序的执行速度提升数倍甚至数十倍。
- Python 3.13+ 的实验性 JIT:从 Python 3.11 开始的“Faster CPython”项目逐步重构了字节码执行引擎(引入特化自适应解释器 Specializing Adaptive Interpreter),并在 Python 3.13 中正式引入了实验性的 Copy-and-Patch JIT 编译器,开启了 CPython 原生迈向 JIT 的重要里程碑。
- Cython 与 Numba(专用静态/即时编译工具):在科学计算和高频量化领域,开发者通常借助 Cython 将带有类型注解的 Python 代码静态编译为真正的 C/C++ 代码再编译成动态链接库,或者使用 Numba 借助 LLVM 在运行时将 Python 数值函数直接编译为 GPU/CPU 硬件机器指令。
六、全文总结
回到最初的问题:“Python 有编译器吗?”
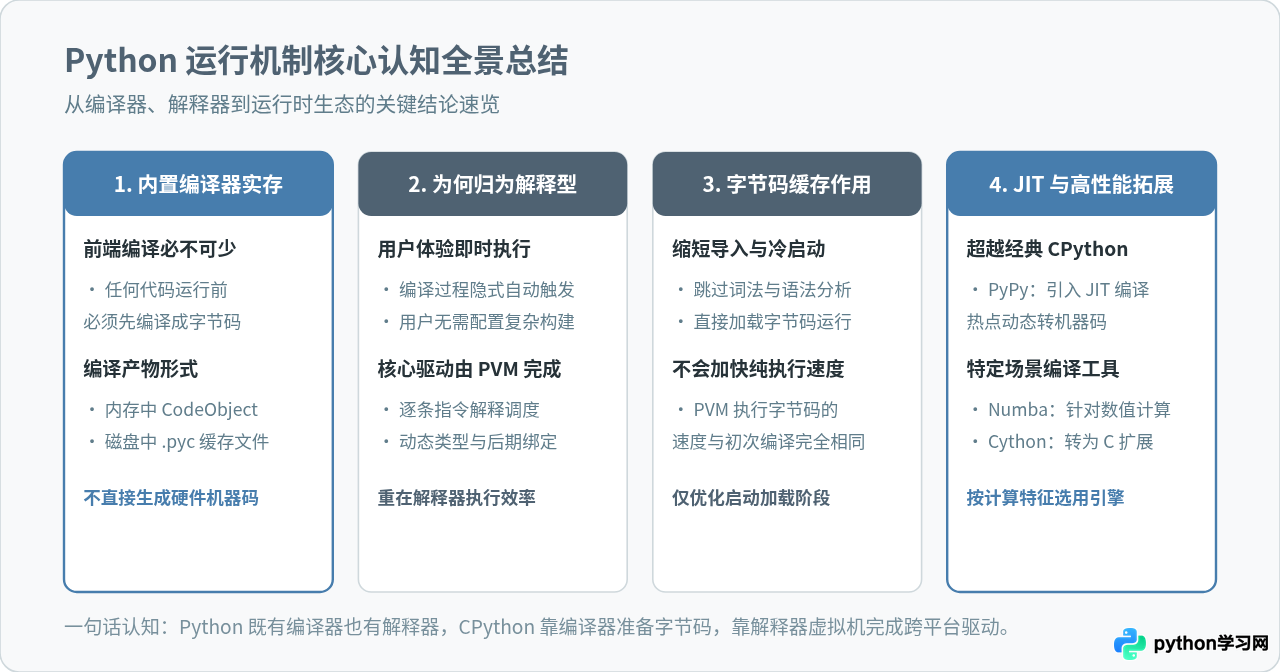
有。Python 绝不是简陋的纯解释型文本解析脚本。作为典型的字节码虚拟机架构语言,标准 CPython 内部完整内置了前端编译器与后端虚拟机解释器:
- 在执行前,Python 编译器始终负责把源文件解析成抽象语法树(AST)并编译为字节码(Code Object)。
- 在执行时,Python 虚拟机(PVM)模拟栈式计算环境,逐条解释并执行这些操作码指令。
- 之所以日常称其为解释型语言,主要是因为这一整套编译过程由解释器在后台全自动透明化完成,无需开发者手动经历类似 GCC 的构建链接流程,同时其运行时保留了动态类型、动态绑定的高度灵活性。
掌握了这一层机制,在日后面临模块导入性能优化、排查字节码版本兼容性问题(如跨 Python 大版本的 .pyc 冲突)或者评估是否需要引入 PyPy、Cython 加速计算时,就能拥有清晰底层的架构判断力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









