

Python字典链式访问:怎么优雅地读取多级嵌套数据
深入探讨Python在处理多级嵌套字典时优雅读取数据的几种方式,从常规的get级联、functools.reduce、自定义递归函数到第三方库,规避KeyError与TypeError。
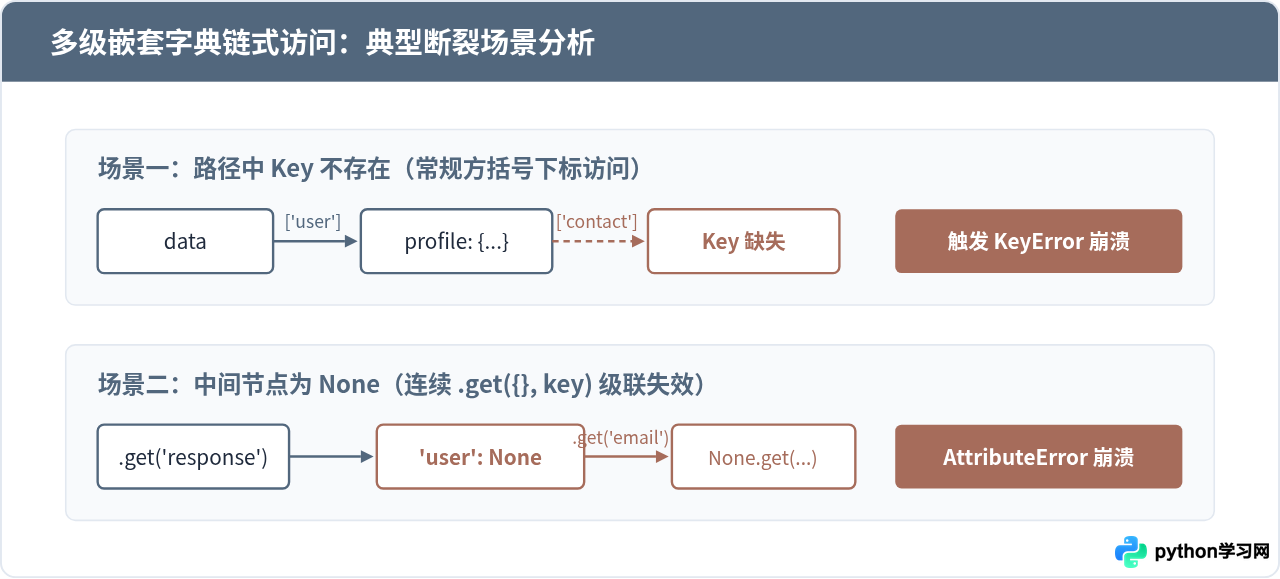
在处理外部接口响应、解析复杂 JSON 配置或抽取深层数据时,我们经常遇到类似 data['response']['payload']['user']['profile']['email'] 这样的多级嵌套字典结构。直接使用方括号索引最直观,却极度脆弱:任何一层键缺失都会触发 KeyError,而中间节点若显式为 None,更会引发 TypeError: 'NoneType' object is not subscriptable。优雅地读取嵌套数据,核心在于既能安全规避异常,又不必让代码充斥臃肿易错的判断条件。
一、层层设防的困境:为何直接索引与 get() 级联不够好
直觉上最简单的容错方式是连续调用 dict.get() 并提供默认空字典,例如:
# 常见的连续 get 尝试
email = data.get("response", {}).get("payload", {}).get("user", {}).get("email")
这种写法虽然能避开顶层键不存在的问题,但在工程实践中潜藏着致命盲点。如果服务端返回的数据中某一层确实存在,但其对应的值恰好是 None(例如用户尚未填写资料,服务端返回 "payload": None),此时 data.get("response", {}).get("payload", {}) 拿到的将是 None。由于 None 并不是字典,接下来的 .get("user", {}) 将立刻抛出 AttributeError: 'NoneType' object has no attribute 'get',防御机制彻底失效。
二、标准库函数式方案:使用 functools.reduce 优雅折叠
要摆脱多层硬编码的书写方式,最直接的思想是将访问路径抽象为一个列表,例如 ["response", "payload", "user", "email"],然后按顺序一步步“钻取”。Python 内置模块 functools 中的 reduce 函数非常契合这一场景。
from functools import reduce

def get_nested_reduce(data, keys, default=None):
    """
    使用 functools.reduce 逐级提取嵌套键值
    :param data: 目标字典
    :param keys: 键序列,如 ['a', 'b', 'c']
    :param default: 缺失或类型不匹配时的默认回退值
    """
    try:
        return reduce(
            lambda acc, key: acc[key] if isinstance(acc, dict) and key in acc else default,
            keys,
            data
        )
    except (TypeError, KeyError):
        return default

# 示例数据
payload = {
    "user": {
        "profile": {
            "name": "Alex",
            "metadata": None
        }
    }
}

# 正常提取
print(get_nested_reduce(payload, ["user", "profile", "name"]))  # 输出: Alex
# 中间缺失 key
print(get_nested_reduce(payload, ["user", "settings", "theme"], "light"))  # 输出: light
# 中间值为 None
print(get_nested_reduce(payload, ["user", "profile", "metadata", "score"], 0))  # 输出: 0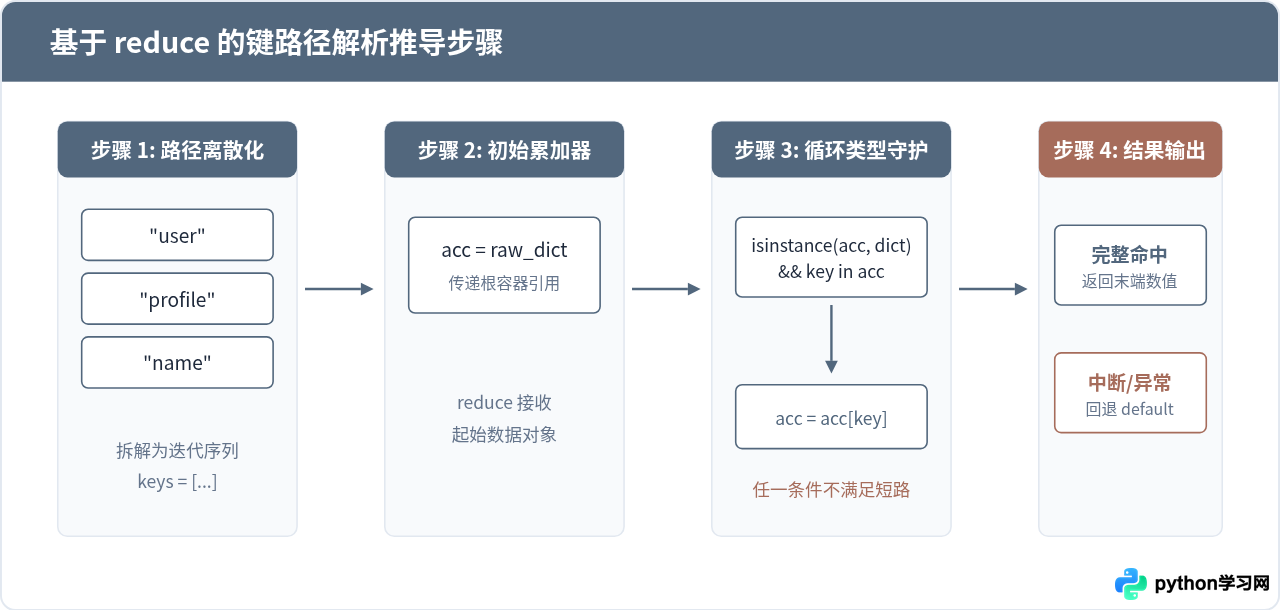
三、通用工程实践:编写健壮且支持点号路径的 deep_get
虽然 reduce 简洁,但在实际工程中,开发者通常更喜欢使用形如 "user.profile.name" 的点号字符串,甚至有时嵌套结构中包含列表索引,例如 "items.0.sku"。我们可以通过封装一个几十行的纯 Python 帮助函数,兼顾易用性与极致的安全性。
from typing import Any, Union, List

def deep_get(data: Any, path: Union[str, List[Union[str, int]]], default: Any = None) -> Any:
    """
    通用深度取值函数,支持以点号或列表形式访问嵌套字典与列表
    :param data: 待解析的嵌套容器(dict / list)
    :param path: 取值路径,支持 "a.b.c" 形式或 ["a", 0, "c"] 形式
    :param default: 任意一层失败时的保底返回值
    """
    if data is None:
        return default

    # 将点号分割路径转换为序列
    if isinstance(path, str):
        keys = path.split(".")
    else:
        keys = list(path)

    current = data
    for key in keys:
        if isinstance(current, dict):
            # 处理字典查询
            if key in current:
                current = current[key]
            else:
                return default
        elif isinstance(current, (list, tuple)):
            # 处理列表索引支持
            try:
                idx = int(key)
                if -len(current) <= idx < len(current):
                    current = current[idx]
                else:
                    return default
            except (ValueError, TypeError):
                return default
        else:
            # 当前节点已不是容器,无法继续下钻
            return default

    return current
这段实现的优势在于:
- 防御 None 破坏: 循环内部明确使用
isinstance检查当前节点的类型,避免在None上调用索引。 - 混合结构兼容: 自然支持 JSON 数组下标(如
orders.0.products.1.price),能够应对复杂混合载荷。 - 零第三方依赖: 不引入任何外部模块,随时可以内联或复制到微服务与工具库中。
四、进阶生态工具:glom 与 JMESPath 的适用边界
当业务不仅需要“读取单个深层字段”,还需要对列表中的多项数据进行聚合、投影、变形或过滤时,自写循环就容易变得繁重。此时引入成熟的专业工具更为明智。
1. glom:Pythonic 的数据重塑利器
glom 专门用于处理嵌套数据,提供了声明式的规范(Spec)机制:
# pip install glom
from glom import glom, Coalesce

target = {
    "system": {
        "clusters": [
            {"id": "node-1", "ip": "10.0.0.1"},
            {"id": "node-2", "ip": "10.0.0.2"}
        ]
    }
}

# 提取整个列表下的所有 ip 地址
ips = glom(target, "system.clusters.*.ip")
print(ips)  # ['10.0.0.1', '10.0.0.2']

# 使用 Coalesce 提供多重备选路径与兜底
result = glom(target, Coalesce("system.non_exist", default="fallback"))
print(result)  # 'fallback'
选型提醒: 若只是读取三四个固定字段,不建议为项目强行增加一个第三方依赖;但在频繁消费不规范 Webhook、爬虫输出或大型报表 JSON 时,glom 能显著减少模板样板代码。
五、工程决策:如何在实际项目中做出选择
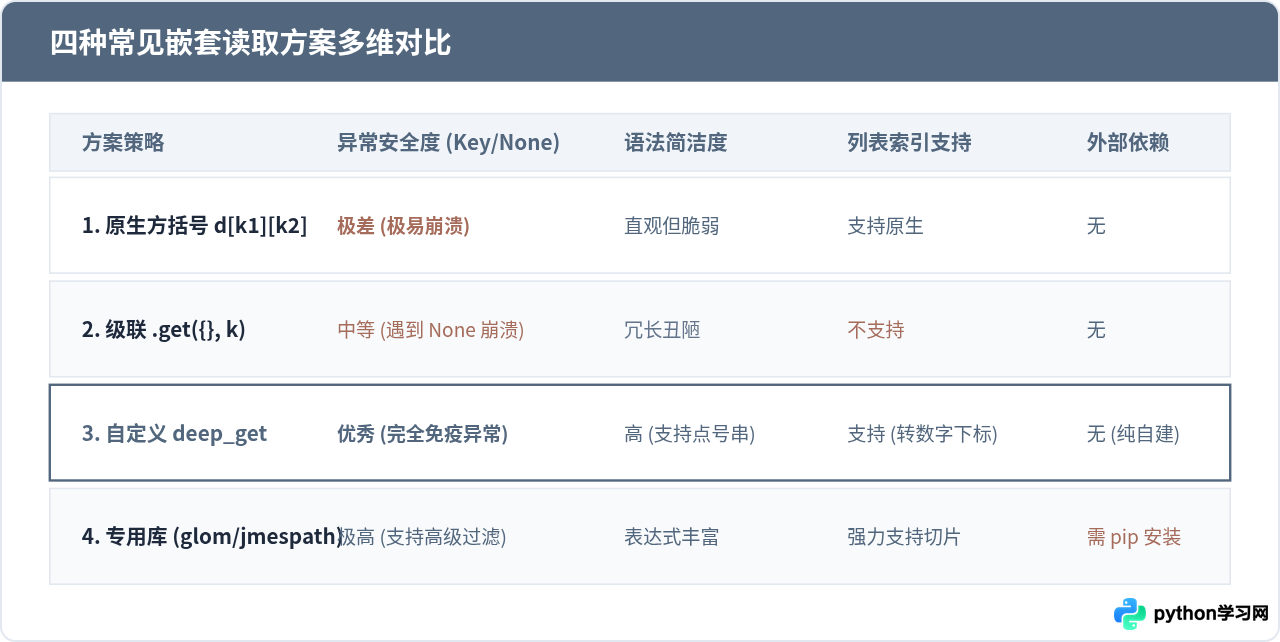
没有一种写法在所有场景下都是绝对最优的。在决定使用哪种访问方式之前,可以按照数据源的稳定度与业务复杂度进行评估:
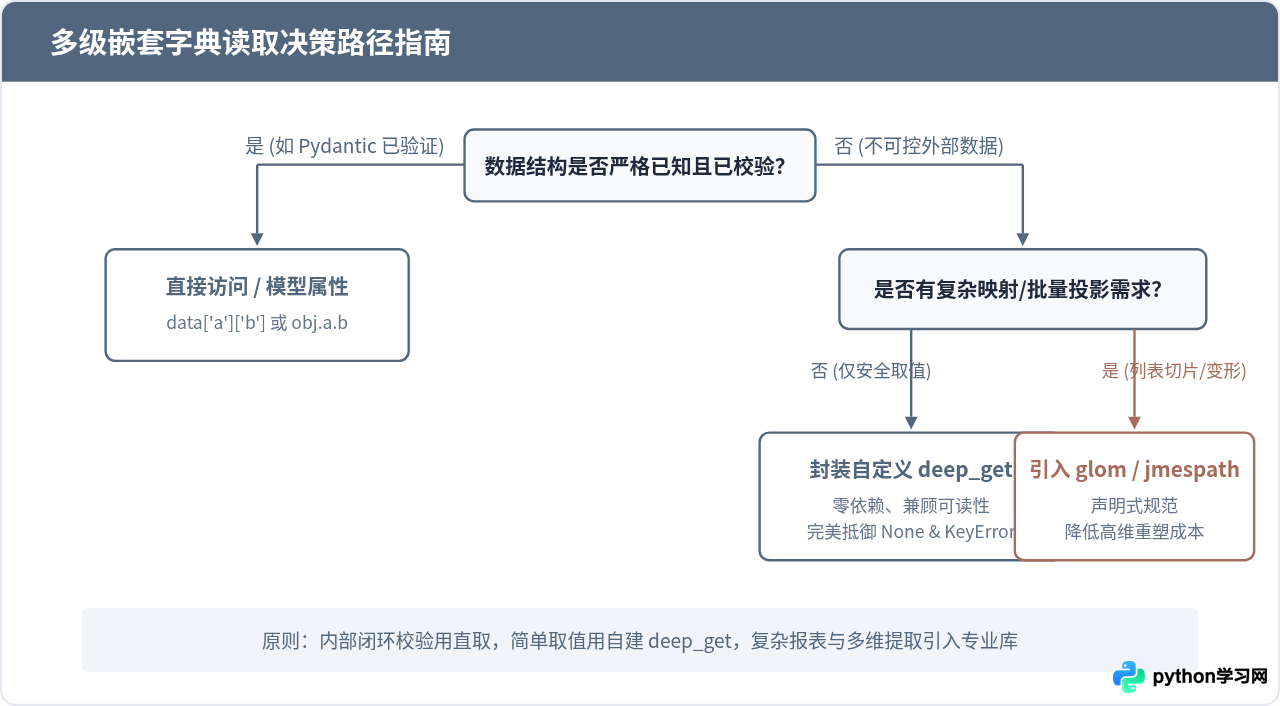
六、总结
在 Python 中读取多级嵌套字典,代码的优雅并不单纯指行数最短,而是指在兼顾代码表现力的同时,能够从容应对脏数据与边界情况。多层 .get() 容易在遭遇显式 None 时破防,而通过 functools.reduce 或仅需二十余行代码的自定义 deep_get 工具函数,我们既能享受 "user.profile.name" 这样直观简洁的点号链式调用,又彻底根除了生产环境中偶发的 KeyError 与 TypeError。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









