

怎么正确使用Python程序设计基础教程答案进行自学核对?

一、为什么直接比对终端输出并不等于完成核对?
很多初学者在完成教材课后习题时,习惯直接运行自己的代码,并在看到终端输出了题目要求的数字或字符串后,立刻翻到教材附录比对答案。只要两者的运行输出一致,就认为自己“完全掌握了这一题”。这种核对方式往往忽略了程序内部的鲁棒性、时间开销以及编码规范。
输出一致只能证明程序在特定的测试输入下产生了符合预期的表象结果,并不能证明算法逻辑具备通用性。例如,在实现“统计列表中不重复元素出现的频次”时,两段代码在输入列表只有两三个元素时输出完全相同,但底层逻辑可能存在根本差异:
# 初学者的常见实现(虽然结果正确,但存在明显缺陷)
def count_elements_naive(items):
    result = {}
    for x in items:
        # 在循环体内部反复调用 count() 方法,整体时间复杂度飙升至 O(N^2)
        result[x] = items.count(x)
    return result

# 教材参考答案的标准实现
def count_elements_standard(items):
    result = {}
    for x in items:
        # 单次遍历完成累加,时间复杂度为 O(N)
        result[x] = result.get(x, 0) + 1
    return result
如果读者仅核对终端打印的字典内容,会得出“我的写法与答案完全一样好”的错误判断。事实上,第一种写法随着输入规模的扩大,程序性能会急剧恶化。因此,核对答案绝不仅仅是核对输出,而是核对实现路径、复杂度与语言特性的运用。
二、核对答案的标准化四步执行流程
为了让参考答案真正发挥提升思维的作用,建议在每次练习中严格执行“充分自测、双重比对、规范重构、盲打复盘”的四步闭环流程。
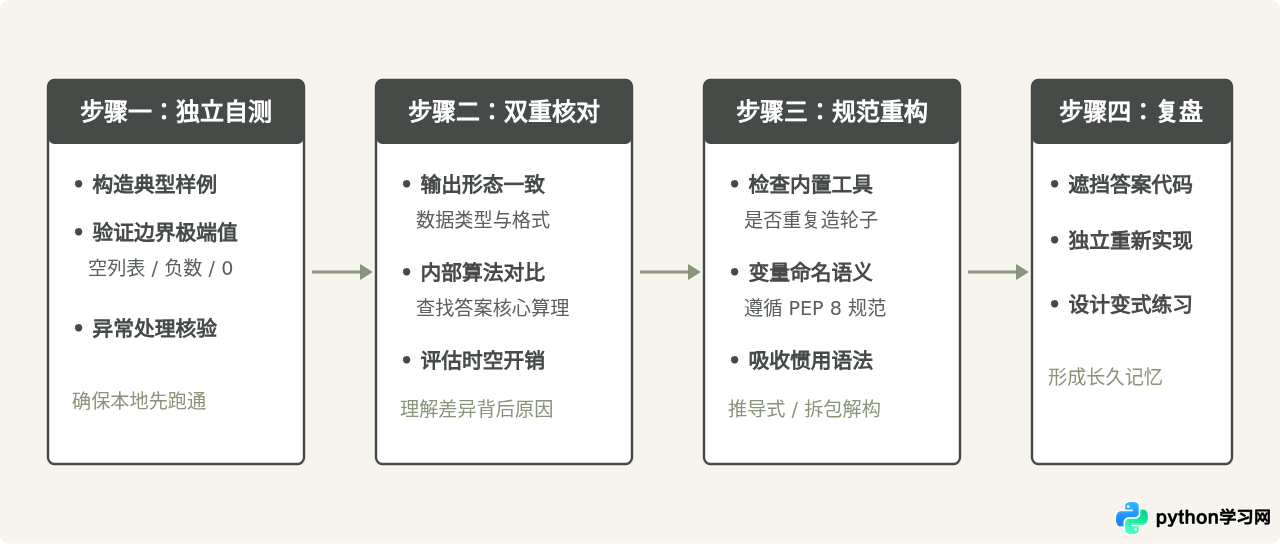
这四个步骤的具体操作要求如下:
- 步骤一:在翻开答案前完成边界测试。绝不能刚写完最后一行语句、连测试用例都没跑就迫不及待打开答案。必须自行设计3组以上的测试输入,包含常规数据、空容器(如
[]、"")以及极值输入,确认自身代码在这些场景下的表现。 - 步骤二:进行逻辑架构核对,而非字符级核对。翻开答案后,重点看教材作者采用了哪种算法思想(例如是双指针、哈希表、分治还是直接遍历),与自己的思路进行横向比对,弄清楚差异带来的执行效率变化。
- 步骤三:审视Python规范与风格。比较两者在变量命名(是否表达清晰)、结构精简度(是否存在冗余的
flag变量)和内置函数选用上的差异,吸收地道的Pythonic写法。 - 步骤四:合上答案进行盲打重构。如果发现自己的代码完全不如答案高效,或者根本没有做出来,看懂答案后不要直接跳过,必须合上答案窗口,在新窗口中独立写出完整代码并通过测试。
三、什么时候才应该查看参考答案?
自学过程中最常见的两难是:遇到卡点时,过早看答案会丧失独立思考的机会;而死磕太久又会耗尽学习热情。建立明确的翻看阈值和分级提示机制,是避免陷入这两种极端的最有效方法。
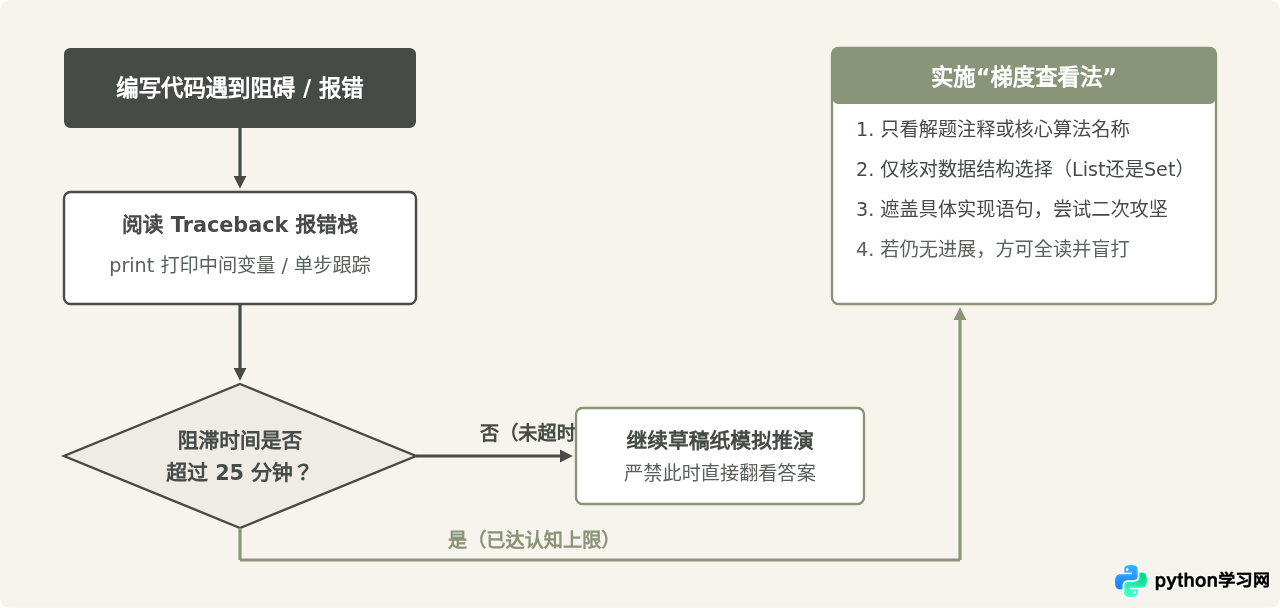
建议将调试时限设定在20到30分钟。如果在这个时间内,通过查阅Python官方文档、分析报错信息或打印关键变量依然找不到思路,说明当前题目触及了认知盲区,单纯的僵持并不会带来灵感。此时翻看答案是完全正当的,但必须遵守“梯度查看”原则:
- 第一梯度:只看解题思想说明。许多教材会在代码上方有一小段文字说明:“本题利用集合去重后反向查找……”。很多时候读者只需这一个核心提示,就能豁然开朗。
- 第二梯度:只看所使用的模块与数据类型。确认答案是否引入了
collections、math或使用了特定数据结构(如字典推导式)。 - 第三梯度:全量研读并标记盲区。如果前两步依然无法启发编写,再完整阅读答案。阅读时必须边读边问:“哪一行代码是我之前没有想到的?为什么作者会使用这个特定方法?”
四、核对深度的三层进阶维度
完成基础的功能核对后,自学者应当逐步提升审视代码的深度。优秀的代码核对应当跨越表层结果,深入到语法惯例与算法架构层面。
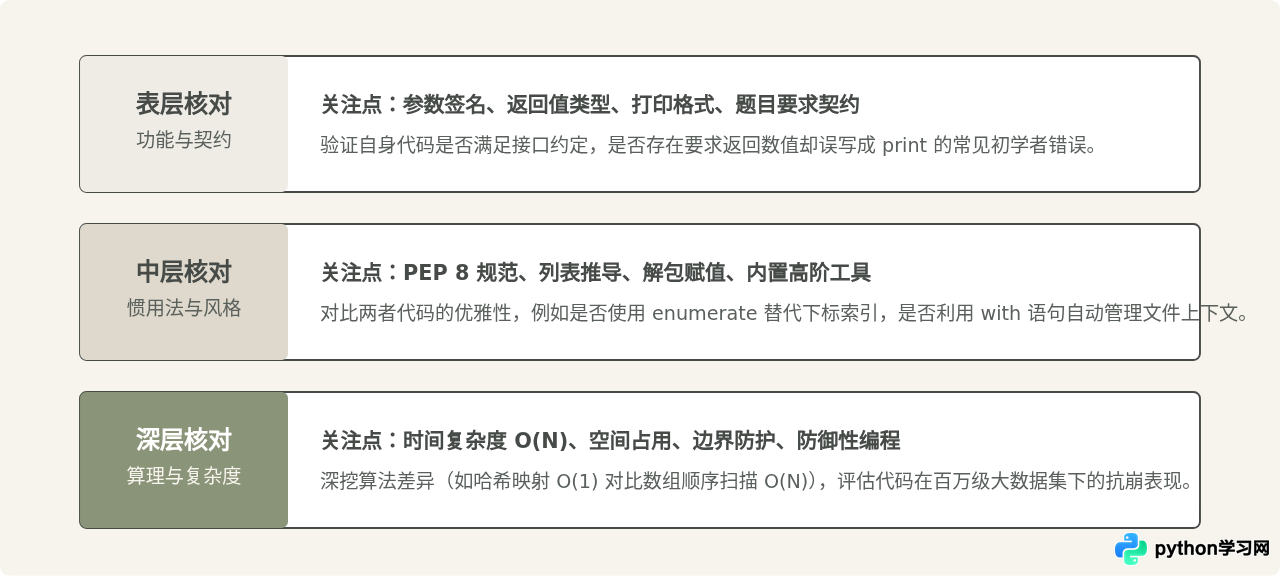
1. 表层核对:辨别“返回”与“打印”的契约差异
很多基础教程习题要求“编写一个函数,计算两数之和”。初学者极容易写出 print(a + b),并在终端看到了正确的和,而教材答案写的是 return a + b。如果在核对时把这当作“无关紧要的排版细节”,就会在后续学习模块化编程时遭遇严重的类型错误(将函数结果赋值给其他变量时得到 None)。
2. 中层核对:吸收更地道的 Python 语法糖
Python 具备高度简洁的表现力。初学者常常带着其他语言或生硬的命令式思维写代码,例如手动维护计数器变量:
# 初学者的常见写法(命令式传统循环)
i = 0
for fruit in fruits:
    print(i, fruit)
    i += 1

# 看到教材答案后应主动吸收的地道写法
for i, fruit in enumerate(fruits):
    print(i, fruit)
核对的价值正在于这种微小语法点的积累。每当发现答案比自己的写法少写两行且更加直观,就应把对应的内置函数(如 zip()、enumerate()、any()、all())记录在自学笔记中。
3. 深层核对:理解数据结构的底层代价
基础教程中频繁涉及元素查找、去重和排序。初学者往往习惯全部用 list 解决,而答案常常在适当位置使用 set 或 dict。核对时若能意识到 x in my_list 是从头到尾的线性查找(复杂度为 $O(N)$),而 x in my_set 是哈希常数级查找(复杂度为 $O(1)$),自学就真正从“照猫画虎”跃升到了“知其所以然”。
五、容易混淆的常见说法与深度辨析
在各大编程论坛和自学社群中,流传着一些关于参考答案的争论。这些说法往往看似合理,但在特定自学场景下需要做出清晰修正。
辨析与修正:这个说法只在教学初阶成立。基础教材的参考答案往往受限于该章节讲授的知识范围。例如,在尚未讲解列表推导式、生成器或高阶函数的章节中,作者为了不增加读者的认知负担,会刻意使用最基础的多层 for 循环和中间变量。随着学习的深入,读者完全可以写出比教材更精练、更高效的解法。核对时若发现自己的写法比教材更简洁且逻辑严密,应先核实是否依赖了更高级的特性,不必强行将代码改回教材的原始形态。
辨析与修正:这种做法极大地限制了编程思维的拓展。Python哲学强调“应当有一种——最好只有一种——显而易见的解决途径”,但在解决实际问题时,算法思维具有多元性。例如一道字符串逆序的问题,可以用切片 s[::-1],也可以用 reversed() 迭代,还可以用递归或双指针交换。将自己的实现与教材答案并列放置,思考各自的适用边界,是自学阶段最具性价比的复盘活动。
六、自学核对常见认知误区与避坑对照
为了保证自学效果,建议读者对照下表定期检查自己的核对行为,及时纠正可能导致“伪掌握”的坏习惯。
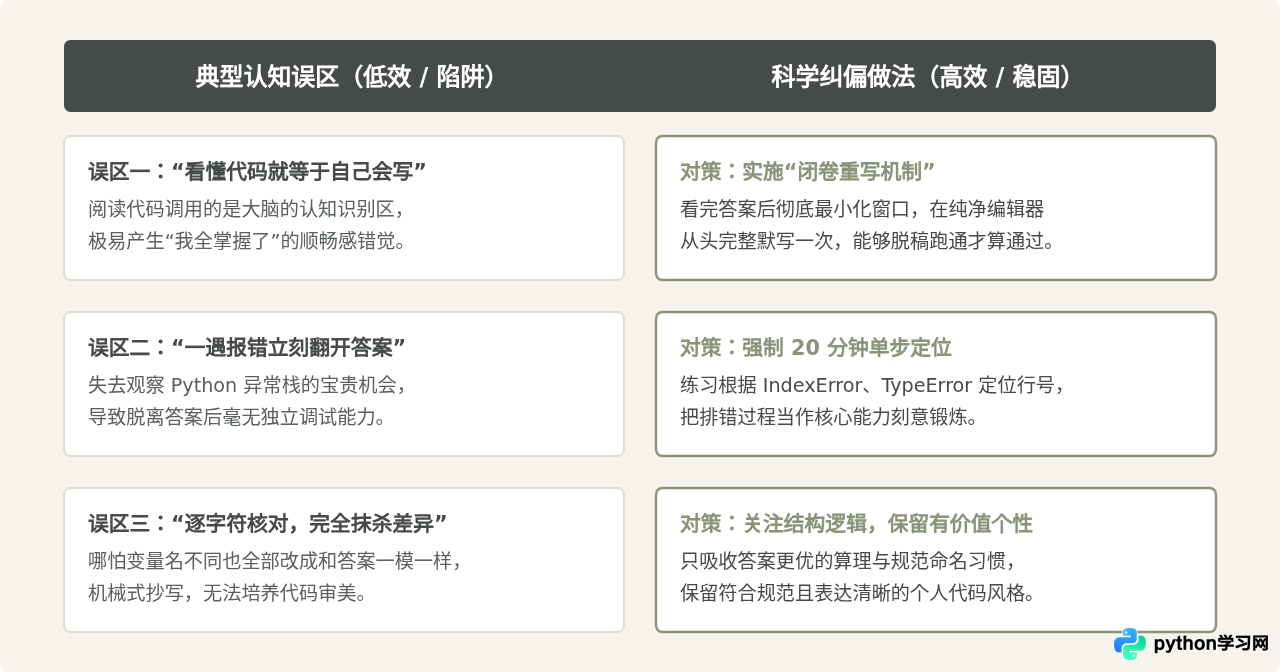
总结而言,自学Python教材中的参考答案应当是读者演练完毕后的“审校员”,而非敲击键盘时的“提示卡”。在完成每一道习题时,坚持“闭卷自测 -> 对比逻辑 -> 消化特性 -> 闭卷重写”的规范流程,不仅能够保证知识点的扎实吸收,更能快速建立面向工业界代码规范与真实工程项目的排错韧性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









