

Python自动化办公要学多深?Excel处理与文件批量的实战能力边界
深入剖析Python在办公自动化场景下的学习深度与实战能力边界,明确Excel多表处理与文件批量整理的核心技能树,厘清脚本自动化与专业软件开发之间的分水岭。
对于以提高日常工作效率为目标的非研发人员而言,Python自动化办公不需要完整掌握算法、数据结构、面向对象设计或Web全栈开发;掌握基础语法、标准库文件操作(pathlib)以及数据表格处理库(openpyxl与pandas的核心操作),就足以覆盖工作场景中85%以上的重复机械劳动。判断学习深度的关键,在于分清“脚本式自动化”与“工业级软件工程”的边界,避免在边际效用急剧递减的高阶开发技术上耗费过多精力。
一、能力进阶模型与实战产出比
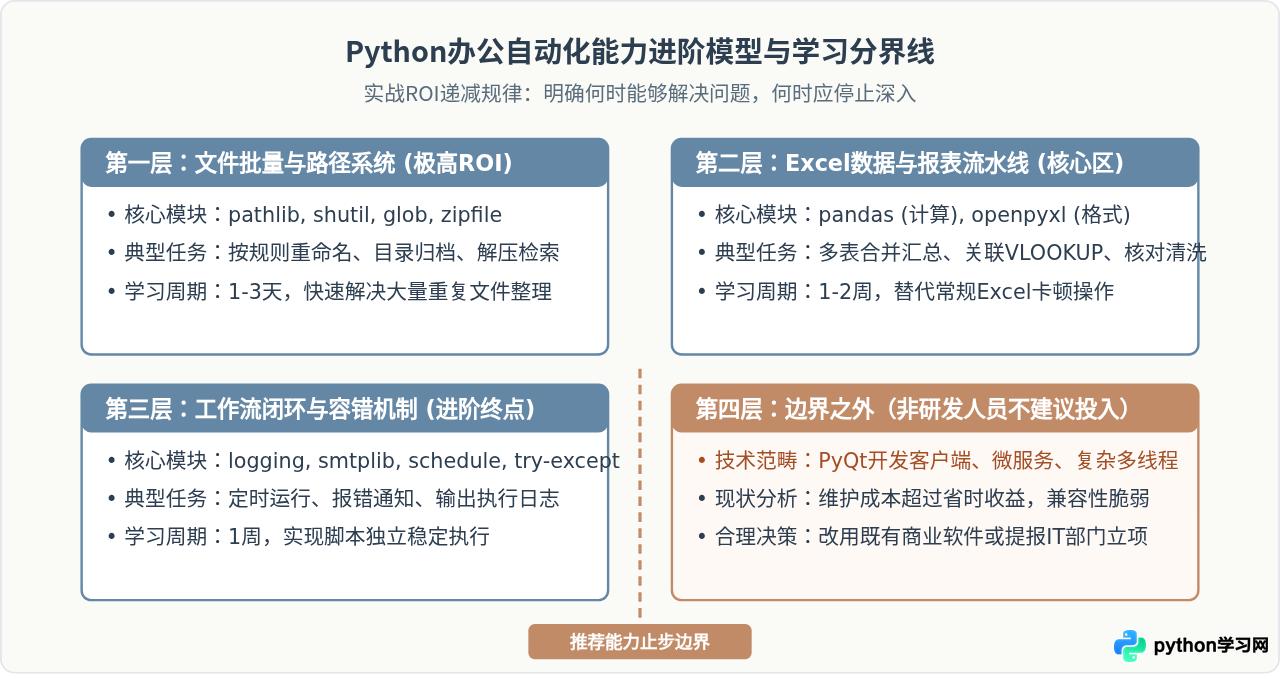
学习Python办公自动化并非越深越好。从实际工作回报来看,整个学习过程呈现出明显的阶梯特征与边际收益递减规律:
- 第一层:文件系统批量治理(投入产出比最高)——重点掌握文件的遍历、筛选、正则重命名、分类归档与解压缩。这一阶段仅需标准库支持,无需额外安装外部依赖,几行脚本即可解决数十个小时的人工整理耗时。
- 第二层:规则化表格数据处理——处理异构表格汇总、列拆分、对账查重与格式填报。这是大多数业务人员的刚需核心区,主要依赖
openpyxl维护格式模板,或用pandas跑数据流水线。 - 第三层:工作流串接与健壮性兜底——加入跨软件自动化(如自动发邮件、定时任务、运行日志与异常拦截),使自动化能在无人值守时可靠运行。
- 第四层:边界之外(边际收益极低)——编写跨平台GUI桌面客户端、多线程高并发爬虫、分布式系统或复杂的前后端架构。对于日常办公而言,此类需求开发周期长、维护成本极高,通常意味着应该采购成熟系统而非个人手写。
二、Excel自动化的实战边界:openpyxl与pandas各解决什么
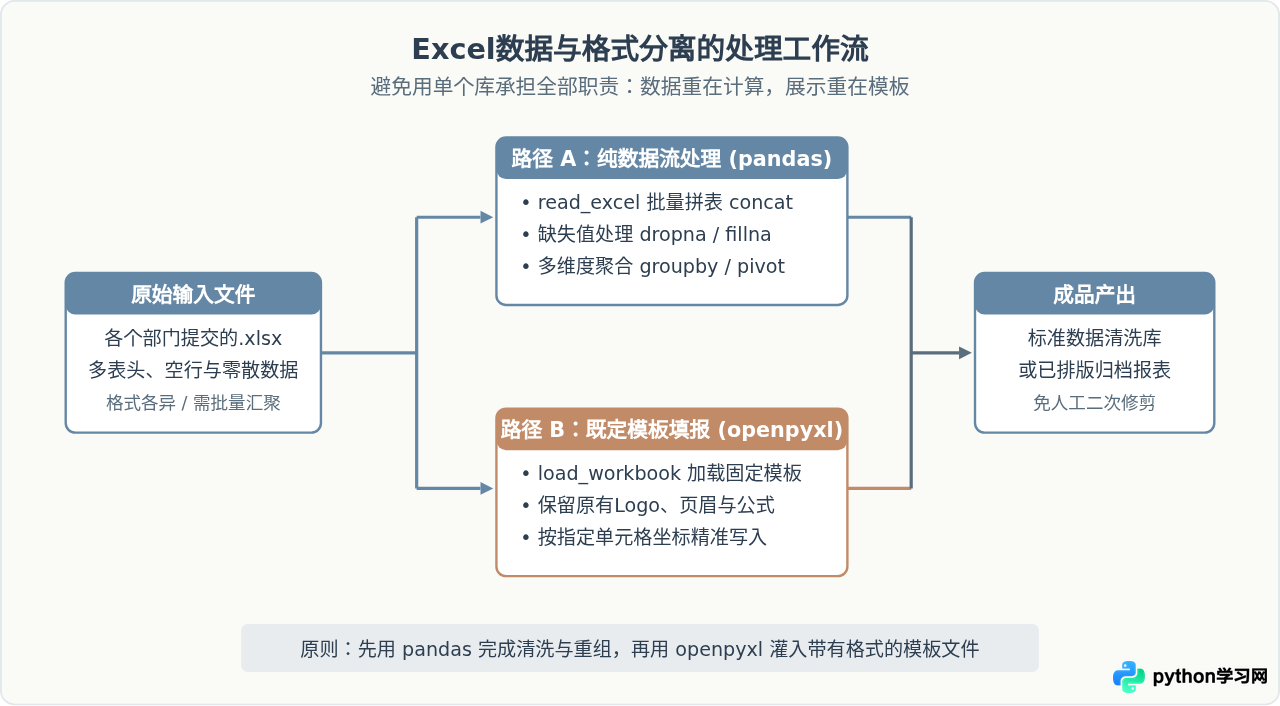
Excel自动化是办公自动化的核心重灾区,许多初学者容易在这里陷入两种极端:要么用单元格逐行读取的方式硬算几十万行数据,导致脚本耗时几个小时;要么用纯数据计算库抹除了原始表格精心调整的单元格字体、合并居中与条件格式。
处理Excel时,核心要诀在于明确 openpyxl 与 pandas 的分工边界:
| 比对维度 | openpyxl 适用场景 | pandas 适用场景 |
|---|---|---|
| 核心能力 | 读写底层单元格、字体颜色、边框、公式定义、模板填空 | 批量数据清洗、行列切片、分组聚合 (Groupby)、表关联 (Merge) |
| 性能特点 | 适合中小规模表格(几万行以内),操作整表速度随行数激增明显放缓 | 基于内存矢量化运算,轻松处理数万至百万级纯表格数据 |
| 对样式影响 | 能够精准修改指定单元格,保留工作簿原有格式与多Sheet结构 | 默认直接覆盖写入为纯粹二维矩阵,无法自动继承原有复杂视觉样式 |
| 技术终点 | 掌握工作表加载、坐标读写、区域拷贝与保存即可,无需深入底层XML解析 | 掌握DataFrame读写、字段过滤、空值处理与合并导出即可,无需掌握时间序列模型 |
实战中的代码深度:掌握到什么程度足够?
对于大部分业务人员,多表合并与对账是最频繁的Excel自动化需求。以下为使用 pandas 实现多表纵向堆叠并去重的标准脚本形态。无需引入复杂的类封装,结构平铺直叙,可读性好,容错率高:
import pandas as pd
from pathlib import Path

# 1. 明确数据目录与输出目标
DATA_DIR = Path("./monthly_reports")
OUTPUT_FILE = Path("./consolidated_result.xlsx")

# 2. 收集所有符合格式的待合并文件
all_files = list(DATA_DIR.glob("*.xlsx"))
data_frames = []

for file_path in all_files:
    # 过滤掉临时锁文件(如以 ~$ 开头的文件)
    if file_path.name.startswith("~$"):
        continue
    try:
        # 只读取关键列,减少内存占用
        df = pd.read_excel(file_path, sheet_name=0)
        df["来源文件名"] = file_path.stem  # 追踪数据源
        data_frames.append(df)
    except Exception as e:
        print(f"读取文件 {file_path.name} 失败,跳过该文件: {e}")

# 3. 合并与简单统计
if data_frames:
    final_df = pd.concat(data_frames, ignore_index=True)
    # 按主键去重,去除完全重复行
    final_df.drop_duplicates(subset=["订单编号"], keep="last", inplace=True)
    final_df.to_excel(OUTPUT_FILE, index=False)
    print(f"成功合并 {len(data_frames)} 个表格,汇总记录 {len(final_df)} 条。")
else:
    print("未找到有效表格文件,未执行写入。")
三、文件批量处理的核心范式与安全护栏
在日常办公中,处理几百个PDF命名、解压几十个压缩包、将不同后缀的附件分发至指定部门目录,是仅次于Excel的高频场景。很多初学者使用 os.listdir() 和字符串拼接 os.path.join(),不仅代码冗长,而且容易在跨平台路径斜杠(/ 与 \)上踩坑。
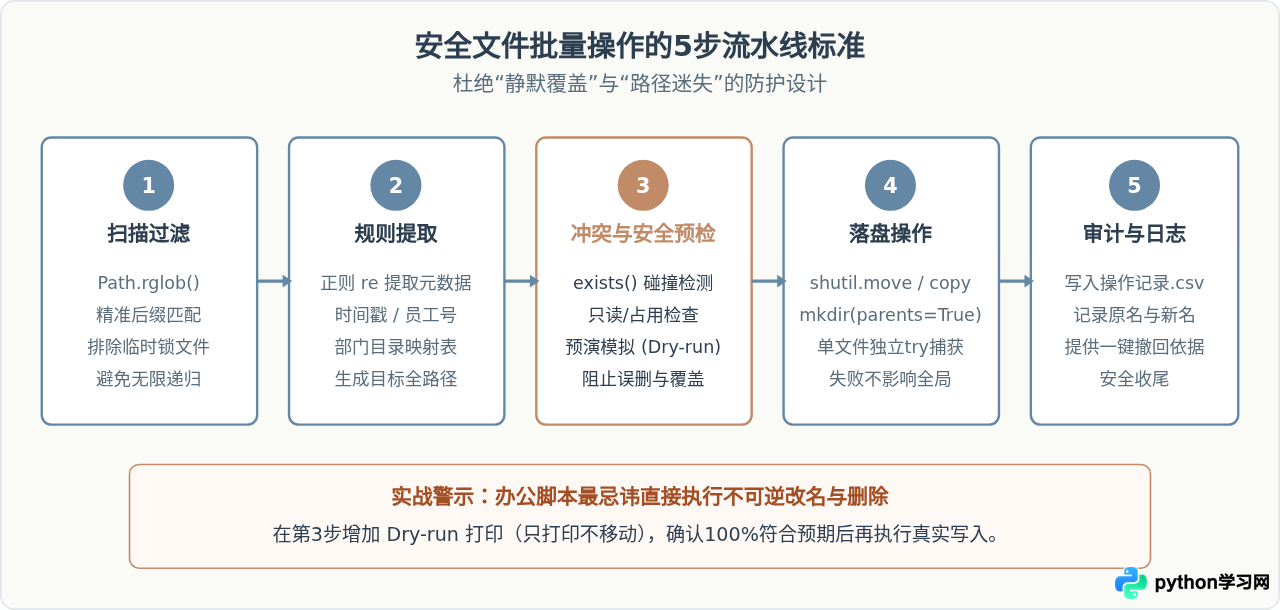
在文件批量处理领域,能力边界的标准线是全面掌握现代化的 pathlib.Path 对象,并建立起“检索—预检—防重—落盘—记录”的标准管道。
实战模式:按日期与部门自动归档发票
以下代码展示了一个典型且完整的批量整理脚本。涵盖了路径自动构建、文件名正则提取、防重名序号追加与结果记录:
import re
import shutil
from pathlib import Path

SOURCE_DIR = Path("./raw_invoices")
TARGET_ROOT = Path("./archived_invoices")
LOG_FILE = TARGET_ROOT / "archive_log.txt"

# 匹配模式:如 "202410-财务部-张三-差旅费.pdf"
PATTERN = re.compile(r"^(\d{6})-([^-]+)-([^-]+)-.*\.pdf$")

def safe_archive_file(file_path: Path, dry_run: bool = True):
    match = PATTERN.match(file_path.name)
    if not match:
        print(f"[跳过] 不符合命名规范: {file_path.name}")
        return

    year_month, department, employee = match.groups()
    # 构造分层目标目录:archived_invoices/202410/财务部/
    dest_dir = TARGET_ROOT / year_month / department
    dest_file = dest_dir / file_path.name

    # 处理目标重名情况(追加数字编号)
    counter = 1
    stem = file_path.stem
    while dest_file.exists():
        dest_file = dest_dir / f"{stem}_{counter}.pdf"
        counter += 1

    if dry_run:
        print(f"[模拟] {file_path.name} -> {dest_file}")
    else:
        dest_dir.mkdir(parents=True, exist_ok=True)
        shutil.move(str(file_path), str(dest_file))
        with open(LOG_FILE, "a", encoding="utf-8") as f:
            f.write(f"{file_path.name} -> {dest_file}\n")
        print(f"[归档成功] {dest_file.name}")

if __name__ == "__main__":
    # 首次运行建议 dry_run=True 预演,确认控制台输出无误后再改为 False
    is_dry_run = False
    for pdf in SOURCE_DIR.glob("*.pdf"):
        safe_archive_file(pdf, dry_run=is_dry_run)
四、自动化场景决策树:何时用Python,何时该止步
了解“能做什么”只是第一步,真正资深的办公自动化实践者,关键在于知道“何时不要用Python”。强行用Python解决一切问题往往会导致巨大的维护包袱。
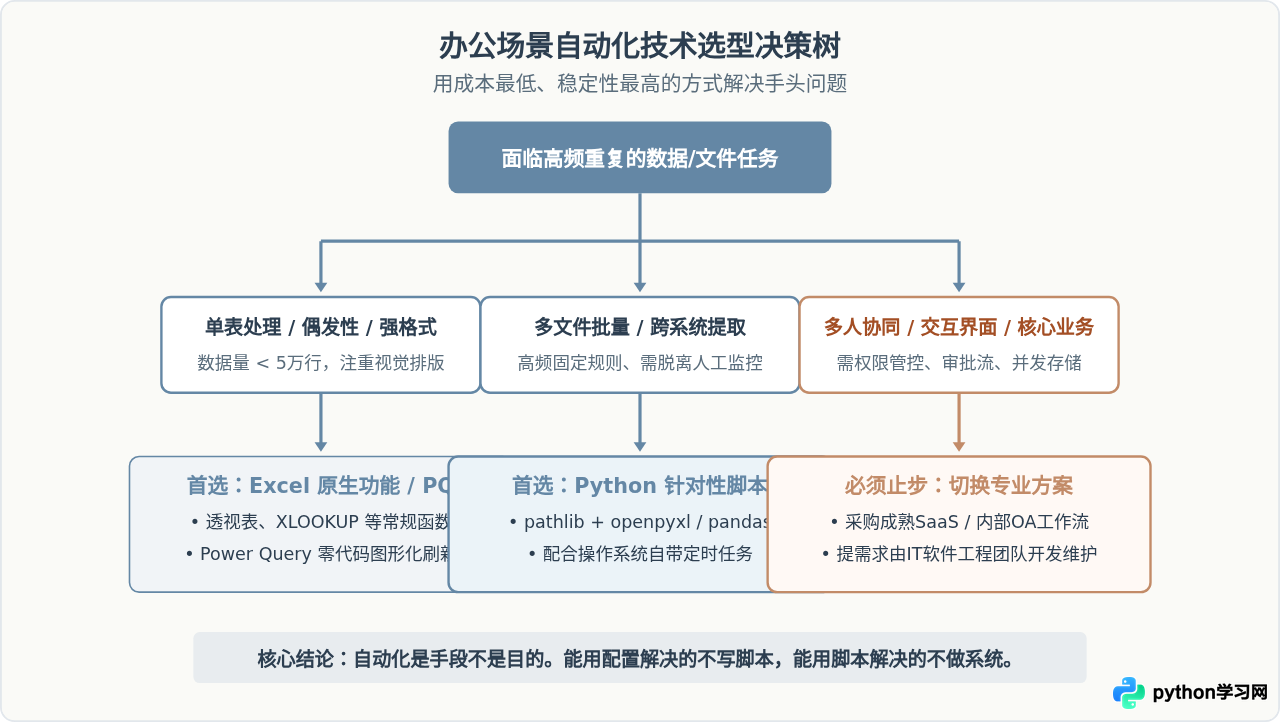
能力自测清单:你是否已经达到了最佳边界?
读者可以通过以下四条具体标准,检验自己的Python自动化能力是否已处在最具性价比的黄金区间:
- 能够熟练使用
pathlib.Path完成任意规则的文件树扫描、筛选与重命名,不再依赖拼接字符串或手动在Windows文件夹中翻找。 - 清晰分辨
openpyxl与pandas的职责边界,能够编写几十行内的脚本,在几秒内汇总数十张格式标准的工作表,并提取关键指标输出新表。 - 脚本具备基础的健壮性意识:包含异常跳过机制(
try...except)、重命名防覆盖设计以及运行日志记录,不在生产文件上裸跑不可逆操作。 - 拥有明确的技术克制力:遇到表头频繁变动、数据严重失真或跨部门协同需求时,果断拒绝“给自动化打无休止的补丁”,转而通过业务沟通推进数据源格式标准化。
达到上述能力后,无需再去钻研底层编译原理、C扩展开发或庞大的软件架构。将精力放回业务逻辑本身的洞察与价值创造,才是Python作为办公效率工具的终极使命。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









