

jieba、HanLP与LTP对比:Python中文NLP库怎么选?
深入对比Python常用中文自然语言处理库jieba、HanLP与LTP的技术路线、功能边界、资源开销及选型决策树,帮助开发者快速确定最符合业务需求的中文NLP技术方案。
一、三大中文NLP库的核心定位与架构差异
在中文文本处理任务中,分词只是第一步。由于中文没有单词之间的空格作为天然分隔符,且汉语语法具有重意合、形态变化少等特点,不同工具库在底层设计理念与算法选型上存在显著分歧。
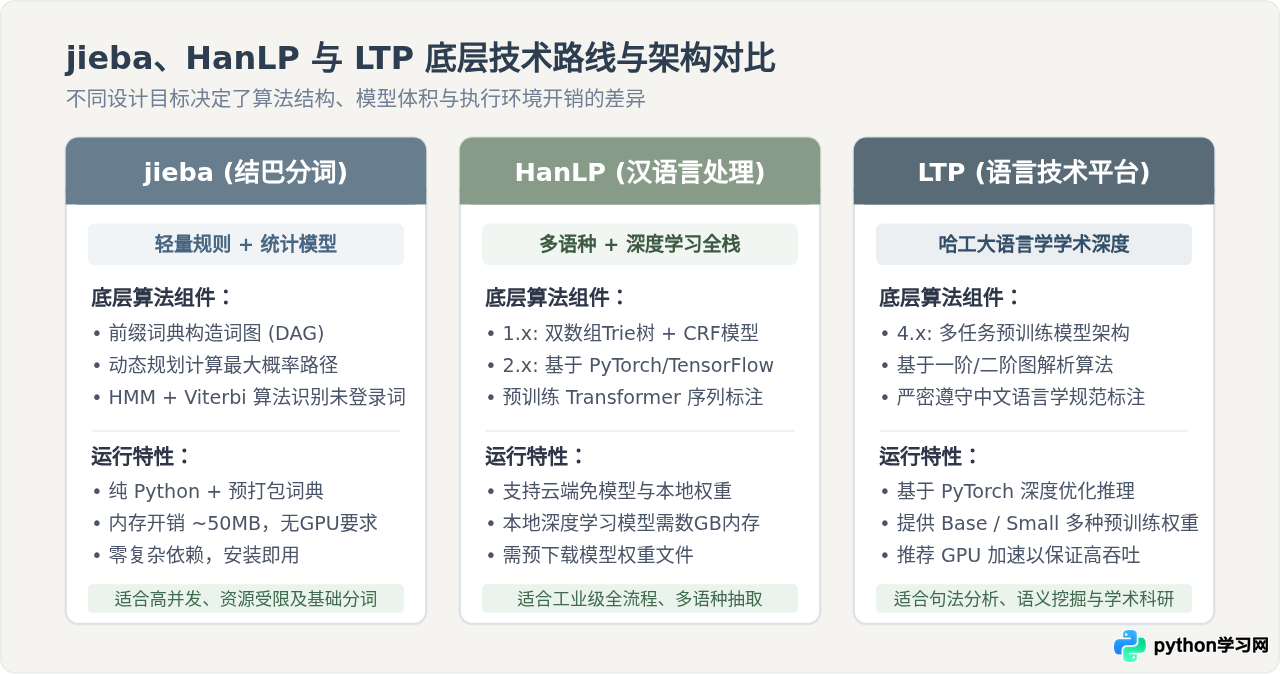
jieba(结巴分词)是国内普及率极高的轻量级分词组件。它的设计核心是“纯粹、极简、无重度依赖”。jieba 的分词基于基于前缀词典实现的高效词图扫描,生成句子中汉字所有可能成词情况构成的有向无环图(DAG),再采用动态规划查找最大概率路径。对于未登录词(未在词典中收录的新词),则借助基于汉字成词能力的隐马尔可夫模型(HMM)与 Viterbi 算法进行识别。正因为没有引入庞大的神经网络权重文件,jieba 可以在纯 CPU 甚至低配嵌入式环境秒级导入运行。
HanLP(汉语言处理包)由开源社区及相关团队持续演进,现已发展为包含经典模式(1.x)与深度学习/预训练模式(2.x)的多功能 NLP 平台。HanLP 的设计理念是提供全栈的 NLP 工具链,涵盖分词、词性标注、命名实体识别(NER)、依存句法分析,乃至文本风格转换。在 HanLP 2.x 中,核心能力全面迁移到以深度学习(如 Transformer、BERT 等预训练架构)为底层的流水线架构中,既支持开箱即用的 RESTful API/云端模型,也支持本地下载预训练模型执行端到端推理。
LTP(Language Technology Platform,语言技术平台)由哈尔滨工业大学社会计算与信息检索研究中心(HIT-SCIR)历经十余年研发。LTP 的核心优势在于深厚的计算语言学积淀。它构建了一个从词法分析、句法分析到语义分析的层递式中文处理流水线。LTP 4.x 基于预训练语言模型底座,针对依存句法、语义依存图分析、语义角色标注等高阶任务进行了深度优化,特别适合对中文语法结构和语义关联有严苛要求的科研分析或知识图谱构建任务。
二、功能覆盖与中文语言学分析深度对比
判断 NLP 库是否适用,最直接的标准是看它能否提供你所需要的功能层级。中文自然语言处理通常由浅入深分为三个层次:
- 词法分析(Lexical Analysis):包括分词(CWS)、词性标注(POS)、词频统计与关键词抽取。
- 实体与短语分析(Entity & Phrase):包括命名实体识别(NER,识别人名、地名、机构名等)与新词挖掘。
- 句法与语义分析(Syntax & Semantics):包括依存句法分析(Dependency Parsing)、语义依存分析(Semantic Dependency Parsing)、语义角色标注(SRL)。
下面的功能对比图展示了三个库在不同层级上的支持范围与成熟度:
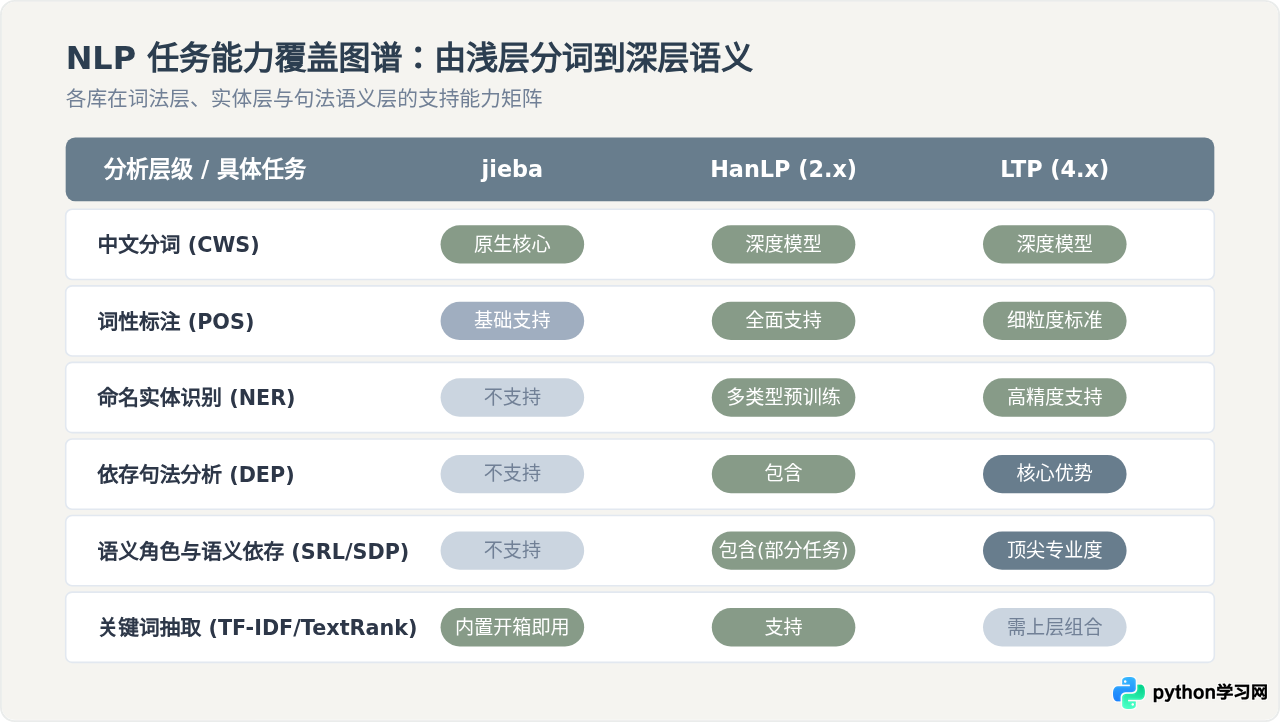
从上图可以清晰看出界限:
如果你的应用只需要做搜索分词或提取文章关键词,jieba 是效率最高、包袱最轻的工具;但只要业务场景涉及到从非结构化文本中抽取出“谁在何时向谁转账了多少元”(需要 NER 与 SRL)或者提取复杂句式中的核心主谓宾关系(需要依存句法),jieba 完全无法满足,必须转向 HanLP 或 LTP。
三、最小可用代码示例与开发体验
为了直观感受三个库的调用方式和开发体验,下面分别给出在一致环境下的核心代码示例与执行逻辑说明。
1. jieba:轻量分词与自定义词典
jieba 安装极为轻巧,仅需 pip install jieba,没有 C++ 编译环境或大型深度学习框架的硬性要求。
import jieba
import jieba.posseg as pseg

text = "自然语言处理是人工智能领域的重要分支。"

# 精确模式分词
words = jieba.lcut(text)
print("分词结果:", words)
# 示例输出: ['自然语言', '处理', '是', '人工智能', '领域', '的', '重要', '分支', '。']

# 词性标注
words_pos = pseg.lcut(text)
print("词性标注:", [(w.word, w.flag) for w in words_pos])
# 示例输出: [('自然语言', 'l'), ('处理', 'v'), ('是', 'v'), ('人工智能', 'n'), ('领域', 'n'), ('的', 'uj'), ('重要', 'a'), ('分支', 'n'), ('。', 'x')]

# 动态添加用户词典,纠正行业专有名词
jieba.add_word("自然语言处理", freq=2000, tag="n")
print("更新词典后:", jieba.lcut(text))
# 示例输出: ['自然语言处理', '是', '人工智能', '领域', '的', '重要', '分支', '。']体验特点:代码极为简练,首次调用加载内置词典耗时一般在 1~2 秒内,后续内存常驻仅数十兆,非常适合写在数据清洗脚本或日常批处理任务中。
2. HanLP:多任务流水线式调用
HanLP 2.x 提供了高层流水线(Pipeline)接口,可以通过统一的 API 一次性获取多维度标注结果。
import hanlp

# 加载多任务预训练流水线(初次运行会从官方源下载模型文件)
# 适用于需要同时获取分词、词性、NER与依存关系的场景
tok = hanlp.load(hanlp.pretrained.tok.COARSE_ELECTRA_SMALL_ZH)
print("分词结果:", tok(["自然语言处理是人工智能领域的重要分支。"]))

# 也可以加载多任务联合模型
pipeline = hanlp.load(hanlp.pretrained.mtl.CLOSE_TOK_POS_NER_SRL_DEP_SDP_CON_ELECTRA_BASE_ZH)
doc = pipeline("李华在清华大学研发知识图谱算法。")
print("分词:", doc['tok/fine'])
print("词性:", doc['pos/ctb'])
print("命名实体:", doc['ner/msra'])
# doc['dep'] 与 doc['srl'] 分别输出依存句法与语义角色体验特点:功能集大成,一次前向传播即可获取文本的全方位解析。但需要注意,首次运行必须保证机器能够访问模型存储库以下载数百兆至数吉字节的预训练权重,且推理需要 PyTorch 环境支持。
3. LTP:专业的层递式语言学解析
LTP 的 Python 封装目前基于 PyTorch,结构紧扣语言学定义,使用流程规范清晰。
from ltp import LTP

# 初始化 LTP 引擎(可选用 'base'、'small' 等模型架构)
ltp = LTP("LTP/small")

text = "李华在清华大学研发知识图谱算法。"
output = ltp.pipeline([text], tasks=["cws", "pos", "ner", "dep", "sdp"])

print("分词结果:", output.cws[0])
print("词性标注:", output.pos[0])
print("命名实体:", output.ner[0])
# 依存句法分析 (head: 依存弧所指向的父节点索引, label: 依存关系类型)
print("依存句法:", output.dep[0])体验特点:LTP 输出的数据结构高度规整,其依存标签(如 SBV 主谓关系、VOB 动宾关系、ADV 状中关系等)严格契合中文学术规范,非常便于后续编写规则遍历语法树。
四、四步选型决策路径
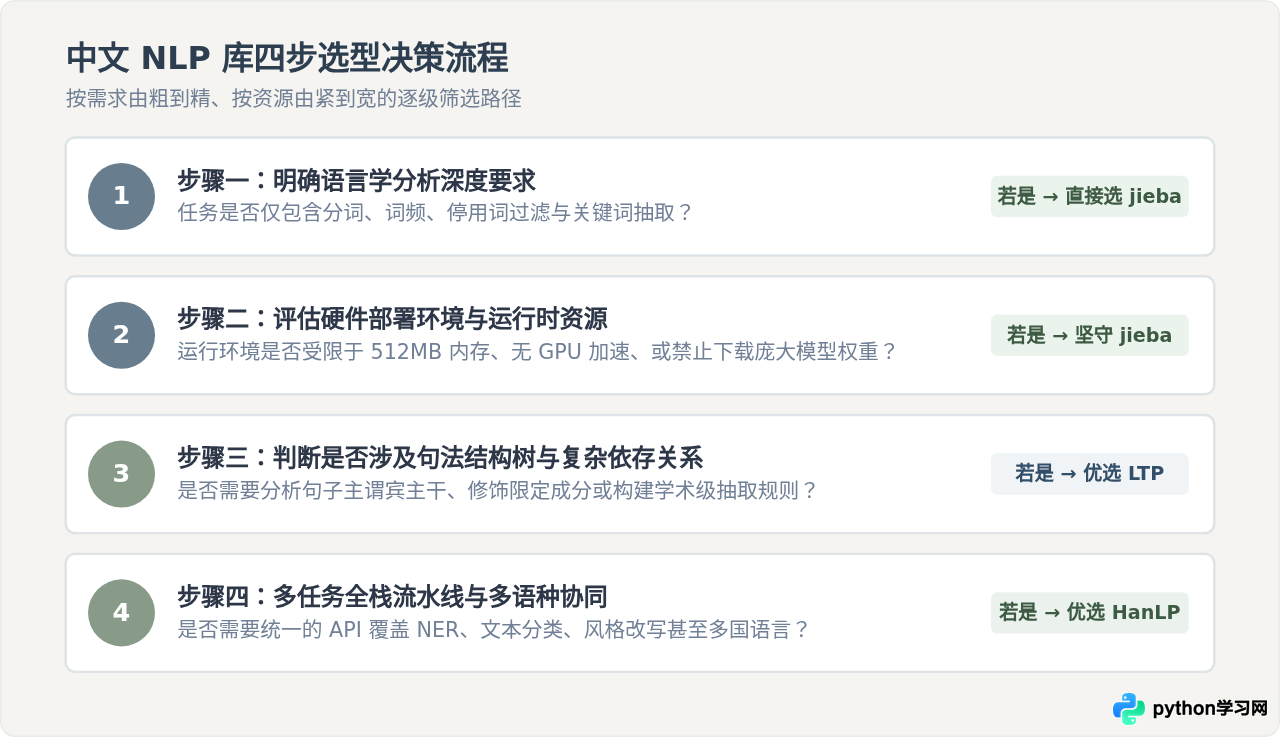
在面对具体业务需求时,不需要盲目追求“最新”或“参数量最大”的模型,而应当沿着业务目标、计算开销、实时性与维护成本四个维度进行逐级筛选。
在实际操作中,具体步骤落地建议如下:
- 第一步验证(功能基线):如果业务核心逻辑是“切词然后建倒排索引”或“统计文章词频做词云”,jieba 的分词质量足以应付 90% 以上的需求,不要过早引入深度学习模型,以避免带来不必要的维护负担。
- 第二步验证(资源约束):评估部署环境。若是部署在轻量云主机(如 1 核 1G 或 1 核 2G)或者 AWS Lambda 等无服务器计算容器中,PyTorch 庞大的体积与启动开销通常不可接受,jieba 具有绝对的工程优势。
- 第三步验证(结构抽取):如果业务需要从合同、财报或医疗病历中抽取“触发词所支配的实体对象”,必须依靠依存句法分析。此时 LTP 的严密依存句法规范(符合哈工大语言学规范)能够提供更稳健的句法树遍历能力。
- 第四步验证(生态与多任务):如果需要跨语言支持(例如中英文混杂)、或者希望利用云端托管 API 快速验证算法原型,HanLP 的全栈生态更为灵活。
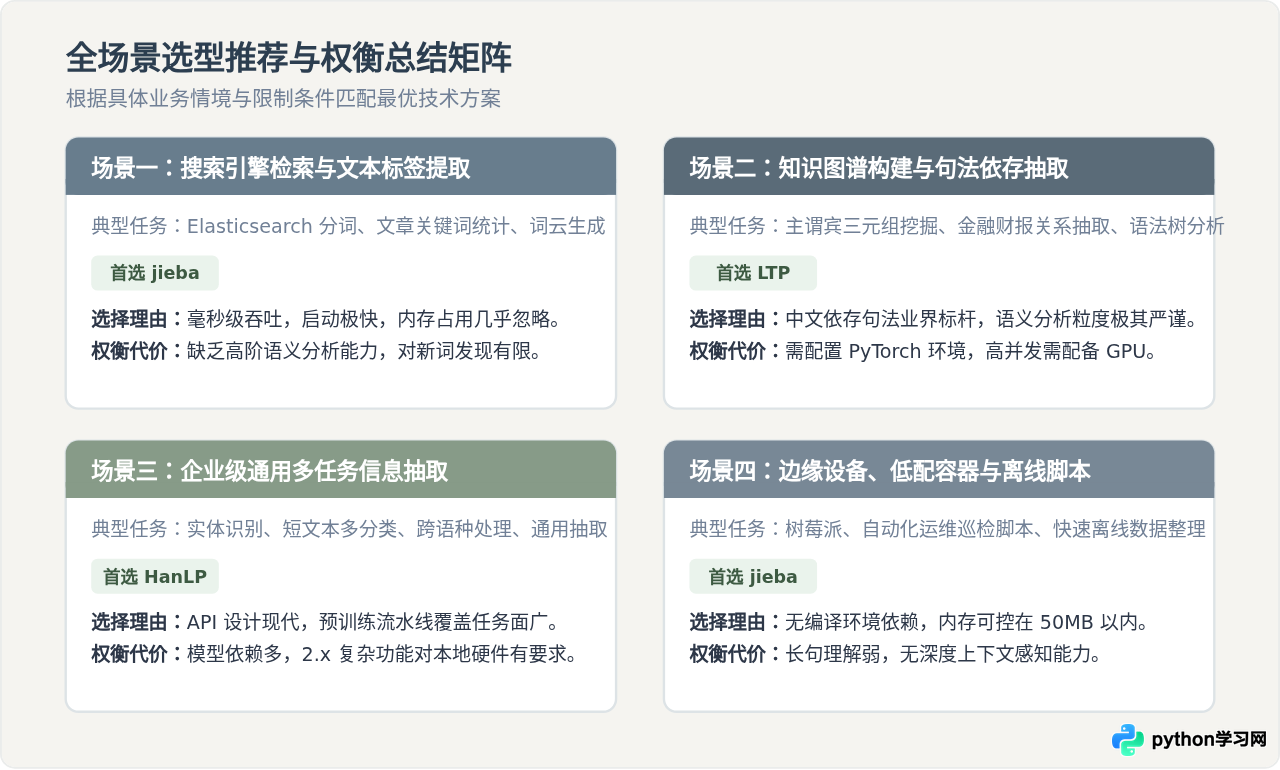
五、综合指标对比与选型全景矩阵
为了让不同场景下的选型对比更加直观,下表汇总了三个库在关键工程指标上的综合对照:
| 对比维度 | jieba | HanLP (2.x) | LTP (4.x) |
|---|---|---|---|
| 核心技术方案 | 前缀词典 + DAG + HMM | 预训练 Transformer / 多任务联合模型 | 预训练多任务模型 + 依存图解析 |
| 安装依赖要求 | 纯 Python,零外部复杂依赖 | PyTorch / TensorFlow,模型权重下载 | PyTorch,模型权重下载 |
| 内存常驻开销 | 约 30MB ~ 60MB | 约 800MB ~ 3GB (视模型而定) | 约 500MB ~ 2GB (视模型而定) |
| GPU 推理加速 | 不支持(亦无必要) | 完全支持 | 完全支持 |
| 自定义词典难度 | 极低(单行代码或文本文件挂载) | 低至中等(支持强制词典与规则干预) | 中等(支持动态词典,部分深层任务受模型影响) |
| 命名实体识别 (NER) | 仅词性标注附带粗略地名人名 | 支持(多类型预训练模型) | 支持(高精确度细粒度实体标注) |
| 依存句法 / 语义依存 | 不支持 | 支持 | 业界公认标杆水平 |
| 典型适用业务 | 搜索引擎切词、文本标签、日志清洗 | 企业级多任务信息抽取、多语种文本分析 | 事件抽取、问答系统、知识图谱、学术研究 |
六、工程落地与避坑指南
jieba.add_word("某某新词") 添加了专有名词,但分词仍然可能将其切碎。这是因为 jieba 默认基于前缀词典的 DAG 计算路径概率。如果新词中的组成字词频率极高,新词的默认词频(频率权重)如果不调高,动态规划依然会选择概率更高的切分路径。因此,在添加行业关键专有名词时,建议显式设置 freq 参数(如指定较大的整数权重,或使用 jieba.suggest_freq('新词', tune=True)),确保新词能够稳定成词。
在生产环境部署时,还需要留意以下两点工程细节:
1. 模型冷启动与内存占用预估:
对于 HanLP 2.x 和 LTP 4.x,服务启动时加载预训练权重需要几秒至数十秒的耗时。在多进程部署(例如采用 Gunicorn 或 uWSGI 启动 4 个 Worker)时,若每个 Worker 单独加载一份完整的模型副本,内存开销会成倍放大(可能瞬间消耗 4GB~8GB 内存)。在容器化部署时,建议通过独立的推理服务(如基于 FastAPI 或 Triton Inference Server)单独承载模型,业务进程通过 gRPC 或 HTTP 进行调用,避免内存爆炸。
2. 离线环境与网络策略:
无论是 HanLP 还是 LTP,默认在首次加载未见过的预训练名称时都会尝试通过网络拉取权重。如果你的生产环境是无外网权限的隔离专网,务必在开发构建阶段预先下载好完整的模型文件,并在代码中直接指定本地文件绝对路径,避免由于拉取超时导致服务启动失败。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









