

Python列表推导式与切片操作语法指南
深入解析Python列表推导式与切片操作的核心语法、底层索引机制、进阶用法与常见性能及逻辑陷阱,提供清晰规范的代码示例与完整图解。
在 Python 中,处理序列数据(如列表、元组和字符串)时,列表推导式(List Comprehension)与切片操作(Slicing)是最常用的两项基础语法。切片主要用于提取、截取或原地修改序列的局部区段;列表推导式则用于在现有迭代对象的基础上,快速完成数据过滤、映射与新列表构建。掌握两者的规范语法、底层机制与边界行为,能够写出更简洁、更符合 Python 惯用法(Pythonic)的高质量代码。
一、切片操作核心语法与索引机制
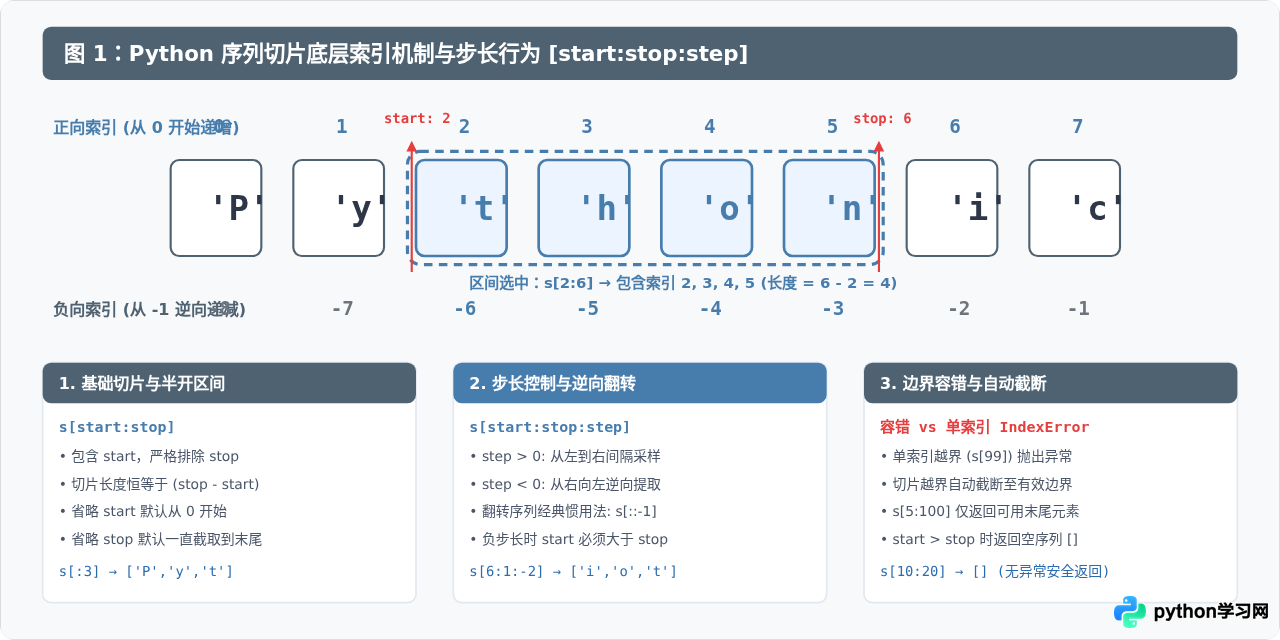
切片操作通过下标方括号完成,通用语法格式为 sequence[start:stop:step]。它支持使用正向索引或负向索引来界定数据范围,其核心机制建立在“半开半闭区间”的基础之上。
1. 参数含义与半开半闭区间
- start:切片起始位置的索引(包含该位置元素),若省略,在正步长时默认为 0,负步长时默认为序列末尾。
- stop:切片结束位置的索引(不包含该位置元素,即数学上的
[start, stop)区间),若省略,在正步长时默认为序列长度,负步长时默认为序列开头之前。 - step:步长,决定元素读取的跨度和方向,默认为 1。为正数时从左向右读取,为负数时从右向左逆向读取。
2. 常见切片代码示例
# 示例基础列表
numbers = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]

# 1. 基础提取:获取下标 2 到 6(不含 6)的元素
print(numbers[2:6])    # 输出示例:[2, 3, 4, 5]

# 2. 缺省边界:提取前 4 个元素与提取第 7 个及之后的所有元素
print(numbers[:4])     # 输出示例:[0, 1, 2, 3]
print(numbers[7:])     # 输出示例:[7, 8, 9]

# 3. 步长采样:偶数位置提取(步长为 2)
print(numbers[::2])    # 输出示例:[0, 2, 4, 6, 8]

# 4. 逆向步长:完整反转列表
print(numbers[::-1])   # 输出示例:[9, 8, 7, 6, 5, 4, 3, 2, 1, 0]

# 5. 逆向截取:从索引 7 倒序读取到索引 2(不包含 2)
print(numbers[7:2:-1]) # 输出示例:[7, 6, 5, 4, 3]

# 6. 安全边界:超过列表长度的切片不会报错
print(numbers[8:50]) # 输出示例:[8, 9]对列表执行 numbers[:] 或 numbers[1:4] 会生成一个新的顶层列表对象。对新切片列表中的元素增删改,不会影响原列表的顶层结构。但如果列表中包含嵌套的可变对象(如子列表或字典),切片仅复制子对象的引用地址,修改子对象内部属性仍会产生联动效应。
二、列表推导式核心语法与运行流程
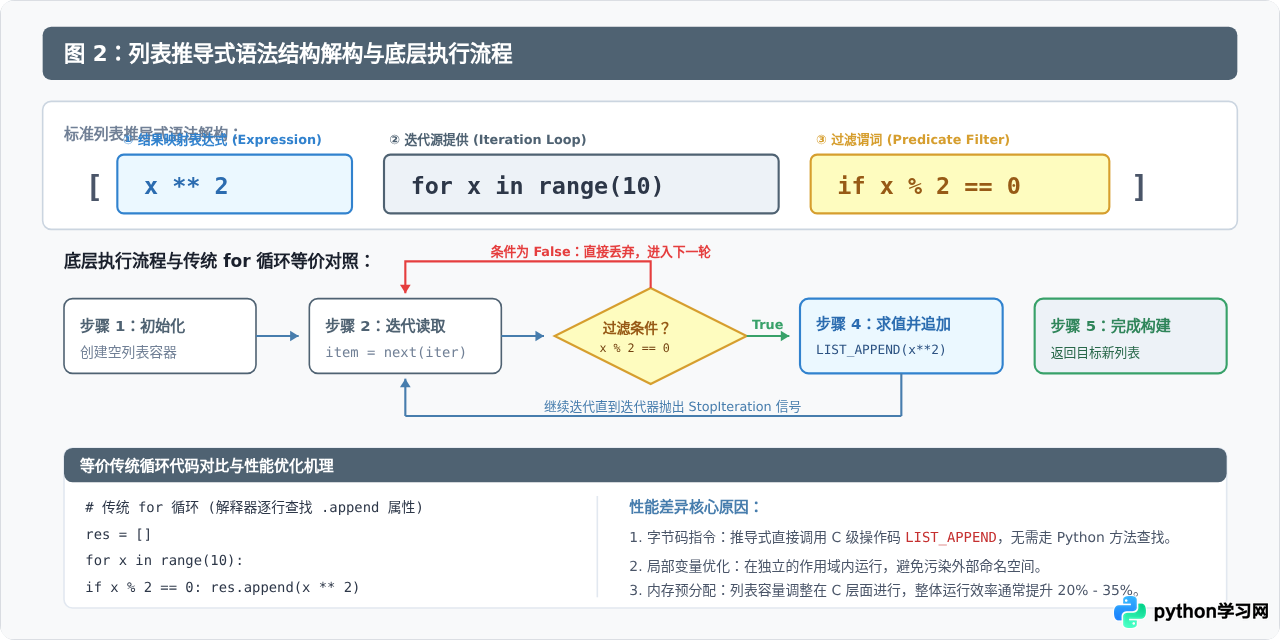
列表推导式是 Python 提供的声明式列表构造语法,其基本思想是将“循环迭代”、“条件判定”与“结果计算”整合到一行内,不仅写法直观,而且在底层字节码层面由 C 语言循环进行优化,执行效率显著高于常规的 Python 显式 append 循环。
1. 语法构成要素
最标准的列表推导式包含三个关键部分:
[ expression for item in iterable if condition ]- for item in iterable:迭代源子句,负责从可迭代对象中依次提取元素。
- if condition:过滤子句(可选),对提取的每个元素进行布尔求值,仅当为
True时才传递给左侧表达式。 - expression:结果表达式,用于对通过过滤的元素进行计算、转换或封装,最终结果依次收集存入新列表。
2. 列表推导式典型代码场景
# 1. 基础映射:对集合所有元素取绝对值或格式化
raw_data = [-5, 3, -1, 0, 8]
abs_data = [abs(x) for x in raw_data]
print(abs_data)  # 输出示例:[5, 3, 1, 0, 8]

# 2. 条件过滤:筛选偶数平方
even_squares = [x ** 2 for x in range(10) if x % 2 == 0]
print(even_squares)  # 输出示例:[0, 4, 16, 36, 64]

# 3. 字符串清洗:去除空白字符并转换为小写
words = ["  PYTHON ", " Guide ", "SLICE "]
cleaned = [w.strip().lower() for w in words]
print(cleaned)  # 输出示例:['python', 'guide', 'slice']

# 4. 结合三元表达式(if-else):数值分类打标签
# 注意:此时 if-else 属于表达式部分,位于 for 子句之前!
scores = [85, 42, 76, 58, 90]
labels = ["及格" if s >= 60 else "不及格" for s in scores]
print(labels) # 输出示例:['及格', '不及格', '及格', '不及格', '及格']末尾 if(位于 for 之后):起“过滤器”作用,满足条件的元素保留,不满足的直接丢弃,此时绝对不能加 else。
表达式 if-else(位于 for 之前):属于 Python 三元运算符,输入多少个元素就必定输出多少个元素,只是根据条件选择返回表达式 A 还是表达式 B,不可缺少 else。
三、进阶用法与操作对比
在复杂数据结构处理中,切片不仅可以用于“读取”,还广泛用于“原地修改”;而列表推导式则支持多层嵌套循环,用于多维矩阵展开与变换。
1. 切片的原地修改(Slicing Assignment)
通过切片赋值,可以在不改变原列表内存地址(即 id(lst) 不变)的前提下,实现批量替换、插入或删除:
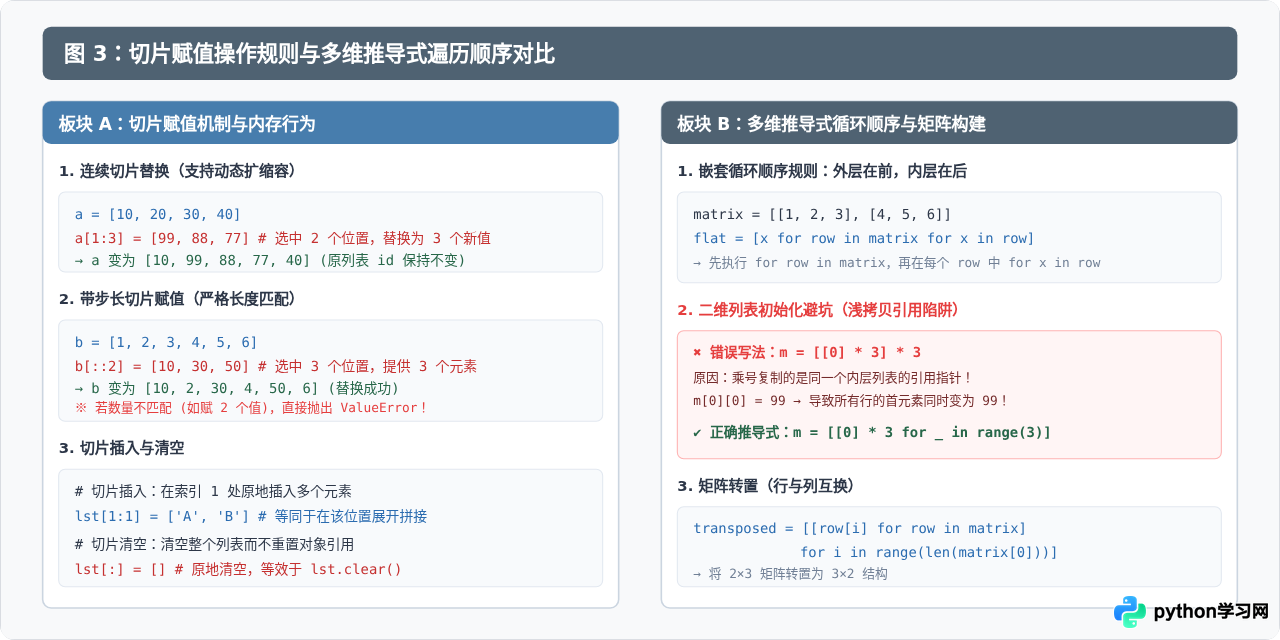
- 连续切片赋值:右侧可以是任意可迭代对象,且替换的长度不要求与被替换切片长度相等。系统会自动扩充或缩减列表长度。
- 带步长切片赋值:当指定了不为 1 的步长(如
lst[::2] = ...)时,右侧赋值的可迭代对象元素数量必须严格等于左侧被切片选中的位置数量,否则将直接抛出ValueError。
2. 多维推导式与切片赋值实操代码
# 1. 切片原地替换:替换中间特定区段
data = [1, 2, 3, 4, 5]
data[1:4] = [20, 30]  # 将 [2, 3, 4] 替换为 [20, 30],列表自动缩短
print(data)           # 输出示例:[1, 20, 30, 5]

# 2. 步长切片原地修改:偶数索引元素归零
data = [10, 11, 12, 13, 14, 15]
data[::2] = [0, 0, 0]  # 选中下标 0, 2, 4 共 3 个位置,数量严格匹配
print(data)           # 输出示例:[0, 11, 0, 13, 0, 15]

# 3. 二维矩阵扁平化
matrix = [
    [1, 2, 3],
    [4, 5, 6],
    [7, 8, 9]
]
# 注意嵌套顺序:外层循环在前,内层循环在后
flattened = [val for row in matrix for val in row]
print(flattened)      # 输出示例:[1, 2, 3, 4, 5, 6, 7, 8, 9]

# 4. 二维安全矩阵初始化(生成独立的子列表对象)
grid = [[0] * 4 for _ in range(3)]
grid[0][0] = 100
print(grid)           # 输出示例:[[100, 0, 0, 0], [0, 0, 0, 0], [0, 0, 0, 0]]
四、典型陷阱与最佳实践
在日常编写过程中,过度追求“单行代码”或忽略内存模型容易引发隐蔽的 Bug。以下是必须注意的四个核心陷阱:
1. 陷阱一:过度嵌套导致可读性急剧恶化
虽然语法支持多重嵌套和复杂条件,但只要嵌套层数超过两层,代码的可读性和维护成本就会呈指数级增加。最佳原则:如果列表推导式不能在单行或两行内一眼看清逻辑,应当拆分并回退为传统的显式 for 循环。
2. 陷阱二:在推导式中引入副作用(Side Effects)
列表推导式的核心设计意图是产出新列表。如果在表达式中调用 print()、修改外部全局字典或执行网络请求等纯副作用行为(例如 [print(x) for x in items]),不仅会凭空生成一个由 None 构成的无意义列表占用内存,而且违背了函数式编程的清晰契约。针对单纯的遍历执行,请使用标准的 for x in items: 循环。
3. 陷阱三:大数据量下的内存暴涨
列表推导式具有“急切求值”(Eager Evaluation)特性,它会在执行的一瞬间将所有计算结果全部载入内存。当处理数百万行的大数据集时,会迅速消耗大量 RAM。如果仅需要依次遍历一次数据,应当将方括号 [] 替换为圆括号 (),使用生成器表达式(Generator Expression)进行惰性流式计算:
# 列表推导式:一次性占用巨大内存
large_list = [x * 2 for x in range(10_000_000)]

# 生成器表达式:惰性计算,常数级极低内存占用
large_gen = (x * 2 for x in range(10_000_000))
print(next(large_gen))  # 输出示例:0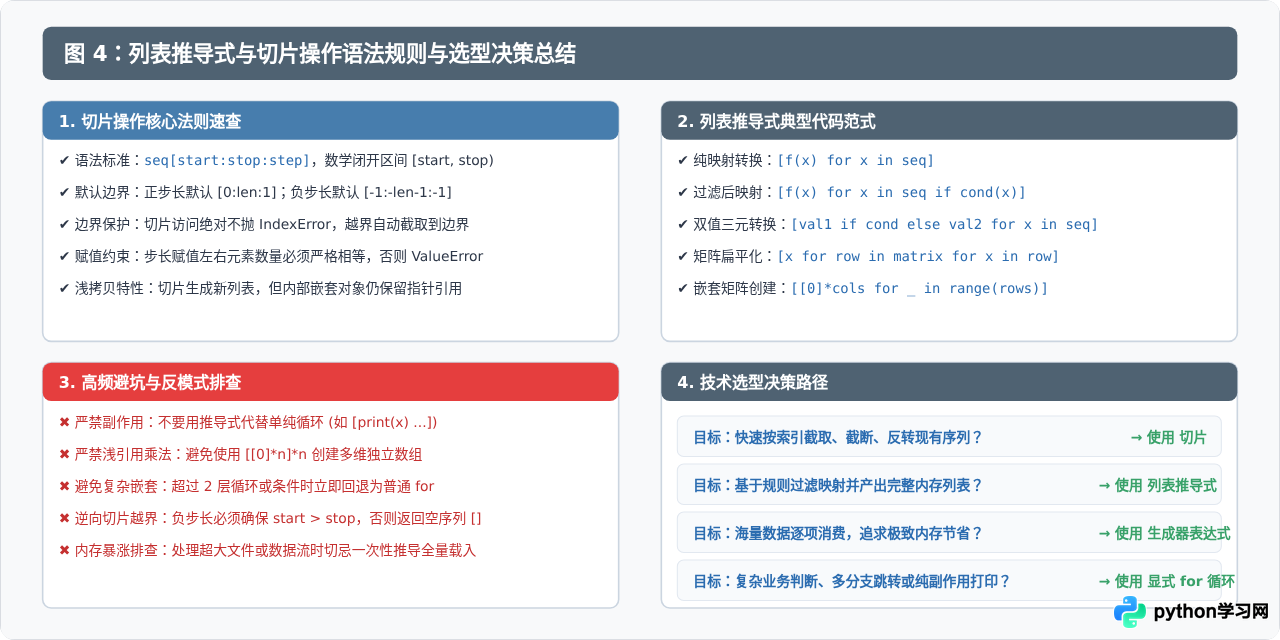
五、语法特性快速对照表
| 特性维度 | 切片操作 (Slicing) | 列表推导式 (List Comprehension) |
|---|---|---|
| 核心定位 | 按索引位置提取、反转或批量原地修改 | 按条件过滤、映射计算并构建新列表 |
| 输入要求 | 支持随机索引访问的序列(列表/元组/字符串) | 任意可迭代对象(列表/字典/集合/生成器等) |
| 越界行为 | 自动截断至有效范围,绝对不抛 IndexError | 依赖迭代器自身的边界,由 StopIteration 正常终止 |
| 返回值类型 | 与原序列类型保持一致(列表切出列表,字符串切出字符串) | 恒定返回 Python 列表(list)对象 |
| 内存分配 | 浅拷贝生成新序列容器,内部元素引用共享 | 计算所有表达式并分配连续内存存储全部结果 |
| 原地修改能力 | 支持(通过左值切片 lst[start:stop] = ... 原地修改) |
不支持(推导式始终创建并返回全新对象) |
综上所述,切片与列表推导式在 Python 编程中分别承担着“空间截取”与“内容生成”的职能。深入理解其底层的索引区间、执行流向与内存特征,不仅可以避免常见的引用与越界陷阱,还能在日常开发中准确选择最合适、最高效的代码表达方式。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









