

Python使用jieba库进行中文分词与词频统计并导出Excel及TXT

发布时间:2026-10-13| 4人浏览过
本文介绍如何利用Python的jieba库对中文论文题目进行分词与词频统计。通过安装jieba和xlwt库,读取文本文件后提取关键词并计算频率,最终将结果分别保存为txt和xls格式文件,适用于学术数据处理场景。
近期有同学撰写论文,需要将大量论文题目依据中文语言习惯进行分词,并统计各个词汇出现的频次。
应其请求协助实现该功能,经网络检索发现jieba库在此类任务中表现优异。
具体运行环境配置如下:
- 安装Python 2.7.13版本,下载地址为:https://www.python.org/downloads/release/python-2713/
- 安装jieba库,执行命令:pip install jieba
- 安装xlwt库,执行命令:pip install xlwt
详细实现代码如下:
#!/usr/bin/python
# -*- coding:utf-8 -*-

import sys
reload(sys)

sys.setdefaultencoding('utf-8')

import jieba
import jieba.analyse
import xlwt #写入Excel表的库

if __name__=="__main__":

 wbk = xlwt.Workbook(encoding = 'ascii')
 sheet = wbk.add_sheet("wordCount")#Excel单元格名字
 word_lst = []
 key_list=[]
 for line in open('1.txt'):#1.txt是需要分词统计的文档

  item = line.strip('\n\r').split('\t') #制表格切分
  # print item
  tags = jieba.analyse.extract_tags(item[0]) #jieba分词
  for t in tags:
   word_lst.append(t)

 word_dict= {}
 with open("wordCount.txt",'w') as wf2: #打开文件

  for item in word_lst:
   if item not in word_dict: #统计数量
    word_dict[item] = 1
   else:
    word_dict[item] += 1

  orderList=list(word_dict.values())
  orderList.sort(reverse=True)
  # print orderList
  for i in range(len(orderList)):
   for key in word_dict:
    if word_dict[key]==orderList[i]:
     wf2.write(key+' '+str(word_dict[key])+'\n') #写入txt文档
     key_list.append(key)
     word_dict[key]=0


 for i in range(len(key_list)):
  sheet.write(i, 1, label = orderList[i])
  sheet.write(i, 0, label = key_list[i])
 wbk.save('wordCount.xls') #保存为 wordCount.xls文件
输入文件1.txt包含待分词统计的文本内容,程序运行后将生成wordCount.txt和wordCount.xls两个输出文件。最终结果如图所示
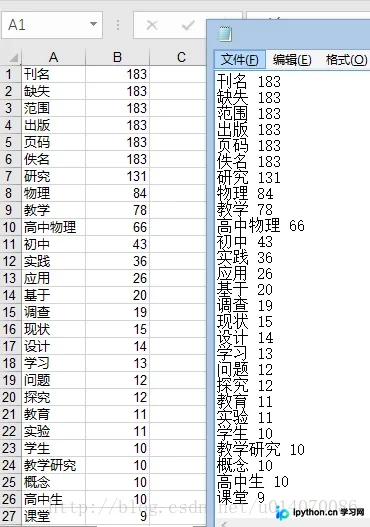
以上内容为本文全部介绍,希望能对读者的学习提供辅助,同时也期待大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









