

怎么用Python批量处理多个文本文件并生成对应词云图

在面对大量文章、会议纪要、用户调研报告或爬虫抓取的文档集合时,人工逐篇统计核心词汇既耗时又难以直观捕捉重点。批量处理多个文本文件并生成对应词云图的核心,在于构建一条“目录遍历 -> 编码自适应读取 -> 中文分词清洗 -> 词云渲染 -> 图像持久化”的自动化批处理管线。通过 Python 内置的 pathlib 模块扫描目标目录,借助成熟的 jieba 库完成中文分词与停用词过滤,再利用 wordcloud 库绑定中文字体批量输出高分辨率图像,可以实现全流程无需人工值守的高效转化。
一、批处理管线设计与数据流转机制
许多初学者在尝试批量处理文本时,容易陷入直接将多个文本拼合成一个巨大字符串的误区。这种做法会丢失各篇文档原有的语义边界,导致不同文档之间的高频词相互稀释或干扰。工业级批处理应当保持各文本的独立计算上下文,建立清晰的文件名与图片输出映射关系。
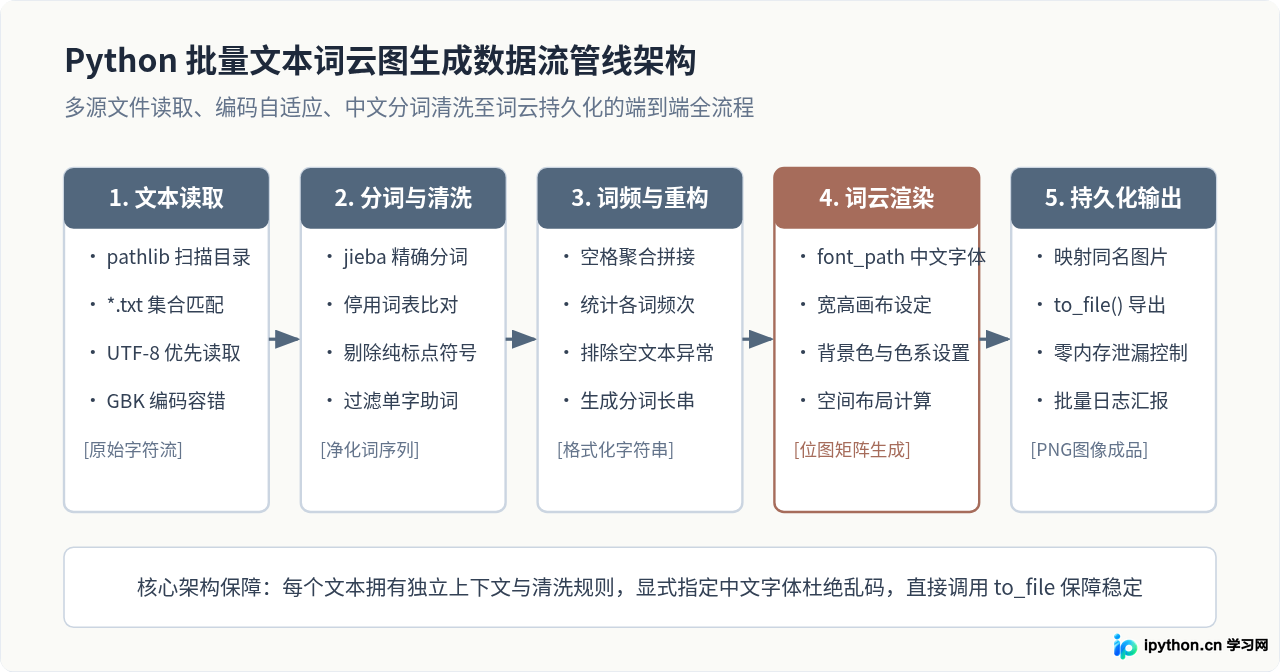
整条数据管线分为五个关键阶段:首先由文件系统驱动器遍历并校验所有文本文件;其次针对每个文件执行编码自适应读取,规避跨系统文件编码不一致带来的崩溃风险;紧接着通过词法分析器清洗掉标点、虚词及停用词;随后将清洗后的词汇序列传递给词云生成引擎,由引擎基于词频与画布尺寸进行碰撞检测与排版;最后将渲染完成的位图持久化写入指定的输出目录。
二、运行环境准备与中文字体资源配置
在编写处理脚本之前,需要安装两个核心的第三方算法与渲染库。可以在终端或命令行工具中通过包管理器直接安装:
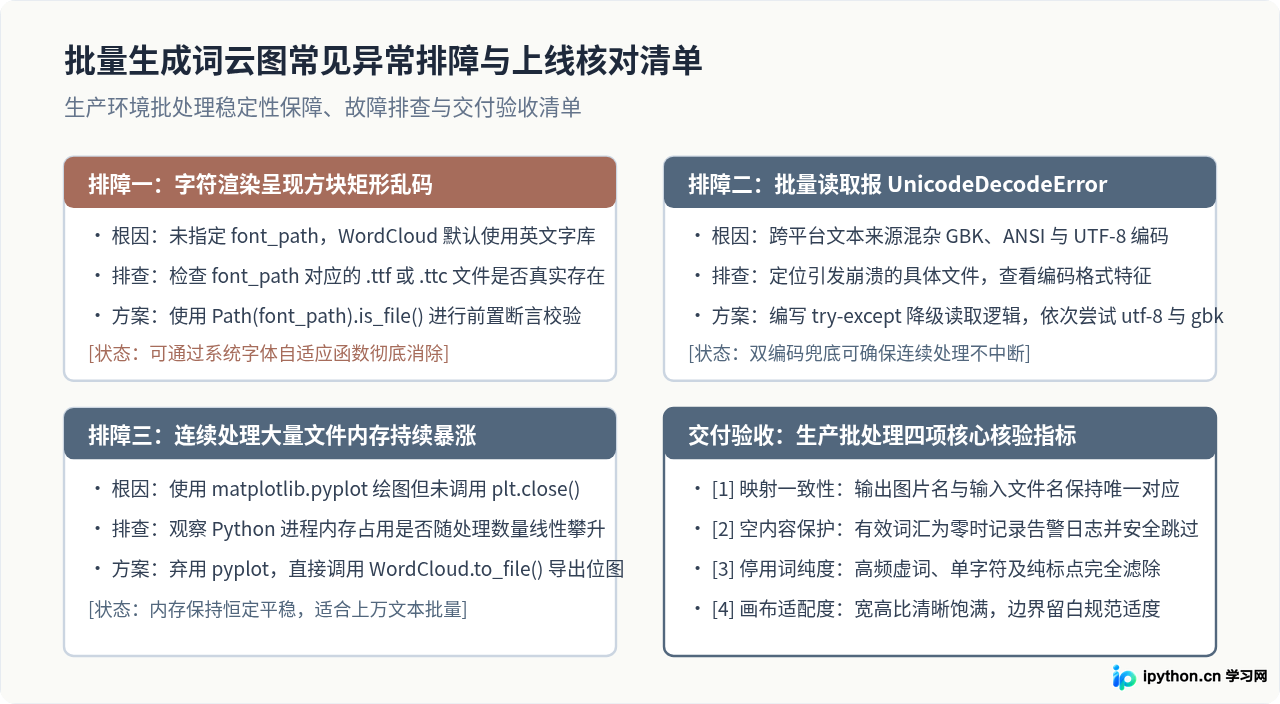
pip install jieba wordcloud在实际运行环境中,中文词云图最常见的异常是所有汉字均显示为“矩形方框”(俗称豆腐块乱码)。出现该现象的根本原因在于 wordcloud 库原生内置的字体为英文字库 DroidSansMono.ttf,该字库不包含中文字符的 Unicode 编码映射。要正确渲染汉字,必须在初始化 WordCloud 对象时通过 font_path 显式指定系统中切实存在的中文字体路径。
常见操作系统的有效中文字体绝对路径参考如下:
- Windows 操作系统:
C:/Windows/Fonts/simhei.ttf(黑体)或C:/Windows/Fonts/msyh.ttc(微软雅黑)。 - macOS 操作系统:
/System/Library/Fonts/PingFang.ttc(苹方)或/Library/Fonts/Arial Unicode.ttf。 - Linux 操作系统(Ubuntu / Debian 等):
/usr/share/fonts/opentype/noto/NotoSansCJK-Regular.ttc或/usr/share/fonts/truetype/wqy/wqy-microhei.ttc。
三、核心实施步骤:从多文件扫描到图像持久化
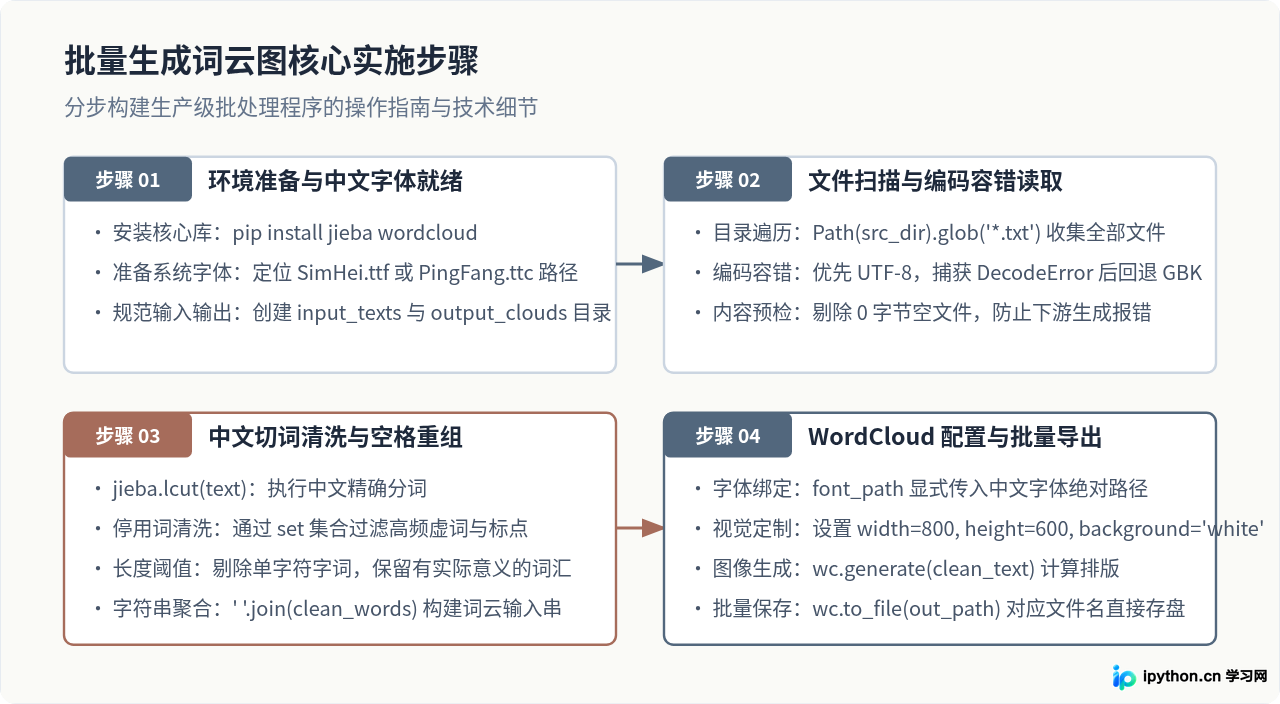
构建完整的批处理逻辑可清晰地划分为四个主要模块,每个模块承担独立的计算职责,便于后续扩展与单独维护。
步骤一:文件扫描与健壮读取
使用现代 Python 推荐的 pathlib.Path 处理文件系统操作,比传统 os.path 更加简洁直观。通过 Path(src_dir).glob("*.txt") 可以递归或单层匹配所有目标文本文件。为了避免单个格式损坏的文件中断整个批处理任务,读取阶段应采用容错机制:优先尝试以标准的 utf-8 编码读取,若抛出 UnicodeDecodeError 则自动降级尝试 gbk 编码,依然失败时再记录警告日志并安全跳过。
步骤二:中文精确切词与停用词清洗
由于中文书写没有英文那样的天然词间空格,计算机无法直接判断词语边界。借助 jieba.lcut() 可以将连续的中文段落精准切分为词语列表。然而原始切词结果中会包含大量无实际分析价值的词汇,例如“的、了、在、是、并且”等虚词以及数字和标点符号。我们需要准备一个停用词集合(set 结构以保证 O(1) 的查找效率),在遍历切词结果时剔除停用词与单字词(len(w) > 1),并将清洗后的词语重新用英文半角空格拼接为一个长字符串。
步骤三:WordCloud 实例配置与权重排版
创建 WordCloud 实例时,除了前文强调的 font_path 之外,还需要合理设置画布宽度 width、高度 height、最大显示词数 max_words、背景颜色 background_color 以及词频权重缩放模式 relative_scaling。配置完成后,调用 wc.generate(clean_text) 方法即可触发词频统计和碰撞排版算法。
步骤四:批量映射与零泄漏持久化导出
在导出图像时,应直接提取原文本文件的基本名称(file_path.stem),并拼接新的扩展名(如 f"{{file_path.stem}}_wordcloud.png")作为输出文件名。在此处务必直接调用 wc.to_file(str(out_path)) 方法将图像写入磁盘,避免引入 matplotlib.pyplot 进行中转展示。直接文件导出能从底层避免 matplotlib 频繁创建绘图窗口而引发的内存泄漏问题。
四、深层机制对比:中文分词与原生英文词云的差异
理解为什么中文词云必须经过“jieba切词”与“空格拼接”这一步,有助于我们在面对不同语种或复杂文本时做出正确的设计决策。
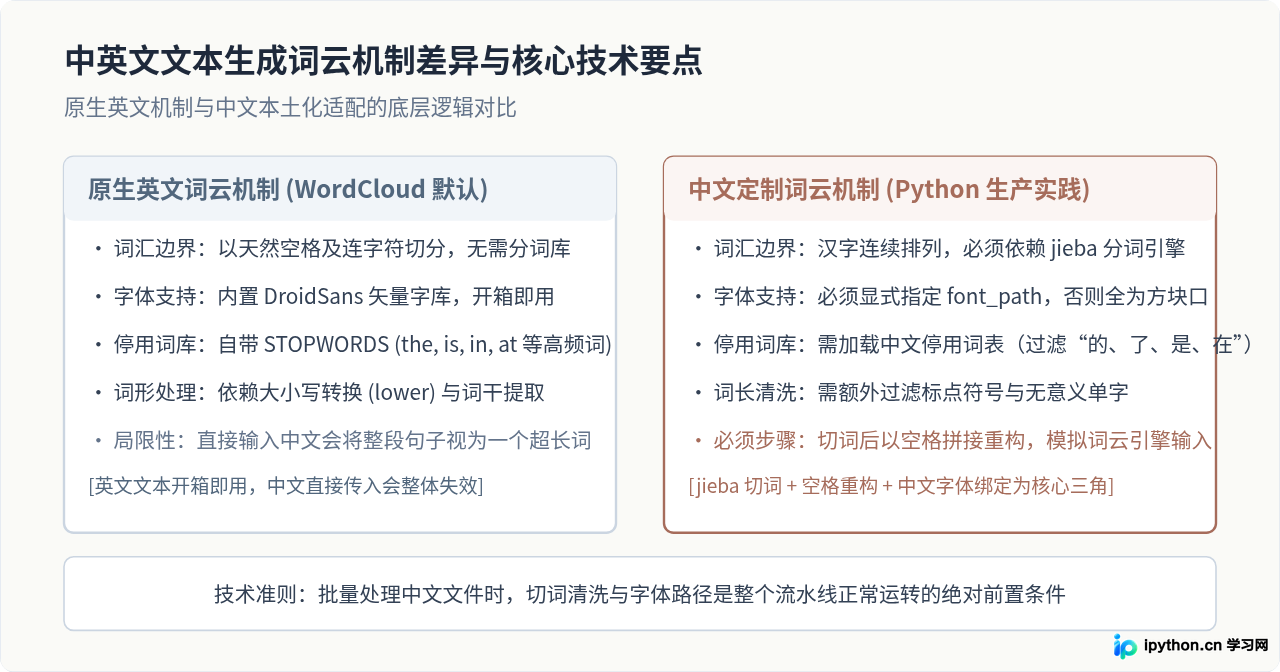
WordCloud 最初是围绕印欧语系设计的开源库。在英文等语言中,单词与单词之间本身就由空格和标点分隔开,词云库只需要简单的正则表达式就能提取出所有单词,并依赖内置的简易词典过滤常见停用词。但汉字是以字为单位连续排版的表意文字,词语之间没有任何分隔标记。如果直接将未分词的中文文本传入 WordCloud,算法会把逗号或句号之间的整个长句子识别为一个极其庞大的“单一单词”,最终导致生成的词云上只零星分布着几行完整的长句子,完全丧失了词频统计与视觉聚合的价值。
因此,“jieba 精确切词 -> 过滤清洗 -> 空格重新拼接”的本质,就是人为地为中文文本补充符合算法预期的“词汇边界”,将中文文档转化为与英文文档结构一致的空格分隔标记序列。结合外部挂载的中文字体,从而让底层的空间布局算法得以正常运转。
五、工业级完整批处理代码示例
下面给出一段结构完整、包含异常捕获、中文字体自动探测与进度输出的生产级 Python 脚本。该脚本可直接保存为独立的 batch_wordcloud.py 文件运行。
# -*- coding: utf-8 -*-
import sys
from pathlib import Path
import jieba
from wordcloud import WordCloud

# 常用停用词集合(生产环境中可从外部 stopwords.txt 读取扩展)
DEFAULT_STOPWORDS = {
    "的", "了", "在", "是", "我", "有", "和", "就", "不", "人", "都", "一",
    "一个", "上", "也", "很", "到", "说", "要", "去", "你", "会", "着", "没有",
    "看", "好", "自己", "这", "那", "对", "从", "及", "等", "与", "为", "之",
    "进行", "可以", "通过", "使用", "采用", "相关", "以及", "目前", "同时"
}

def detect_chinese_font() -> str:
    """自动检测当前操作系统的可用中文字体路径"""
    candidates = [
        # macOS 苹方与微软雅黑
        Path("/System/Library/Fonts/PingFang.ttc"),
        Path("/System/Library/Fonts/STHeiti Light.ttc"),
        Path("/Library/Fonts/Arial Unicode.ttf"),
        # Windows 黑体与微软雅黑
        Path("C:/Windows/Fonts/simhei.ttf"),
        Path("C:/Windows/Fonts/msyh.ttc"),
        Path("C:/Windows/Fonts/simsun.ttc"),
        # Linux 思源黑体与文泉驿
        Path("/usr/share/fonts/opentype/noto/NotoSansCJK-Regular.ttc"),
        Path("/usr/share/fonts/truetype/wqy/wqy-microhei.ttc"),
        Path("/usr/share/fonts/truetype/arphic/uming.ttc"),
    ]
    for font_path in candidates:
        if font_path.is_file():
            return str(font_path)
    raise FileNotFoundError("未在系统中检测到可用的中文字体,请显式指定 font_path 参数。")

def read_text_safely(file_path: Path) -> str:
    """自适应读取文件内容,兼容 UTF-8 与 GBK 编码"""
    try:
        return file_path.read_text(encoding="utf-8")
    except UnicodeDecodeError:
        try:
            return file_path.read_text(encoding="gbk")
        except UnicodeDecodeError:
            # 降级采用忽略异常字符的方式读取
            return file_path.read_text(encoding="utf-8", errors="ignore")

def clean_and_segment(text: str, stopwords: set) -> str:
    """中文精确切词并清洗停用词,返回空格拼接的词串"""
    words = jieba.lcut(text)
    cleaned_words = []
    for word in words:
        cleaned = word.strip()
        # 过滤单字词、数字、标点符号及停用词
        if len(cleaned) > 1 and cleaned not in stopwords and not cleaned.isnumeric():
            cleaned_words.append(cleaned)
    return " ".join(cleaned_words)

def process_single_file(file_path: Path, output_dir: Path, font_path: str, stopwords: set) -> bool:
    """处理单个文本文件并输出对应词云图"""
    raw_content = read_text_safely(file_path)
    if not raw_content.strip():
        print(f"[跳过] 文本内容为空: {file_path.name}")
        return False

    segmented_text = clean_and_segment(raw_content, stopwords)
    if not segmented_text.strip():
        print(f"[跳过] 清洗后无有效实词: {file_path.name}")
        return False

    # 配置词云渲染参数
    wc = WordCloud(
        font_path=font_path,
        width=1000,
        height=700,
        background_color="white",
        max_words=120,
        collocations=False,       # 避免重复单词对统计
        random_state=42           # 固定随机种子确保复现一致性
    )

    wc.generate(segmented_text)

    # 构造对应输出图片路径并保存
    output_image_path = output_dir / f"{file_path.stem}_wordcloud.png"
    wc.to_file(str(output_image_path))
    print(f"[成功] 已生成词云: {output_image_path.name}")
    return True

def batch_generate_wordclouds(input_folder: str, output_folder: str) -> None:
    """批量扫描输入目录并生成全部词云图的主控制函数"""
    in_dir = Path(input_folder)
    out_dir = Path(output_folder)

    if not in_dir.exists():
        raise FileNotFoundError(f"输入目录不存在: {in_dir}")
    out_dir.mkdir(parents=True, exist_ok=True)

    font_path = detect_chinese_font()
    print(f"使用中文字体: {font_path}")

    txt_files = sorted(list(in_dir.glob("*.txt")))
    total_files = len(txt_files)
    if total_files == 0:
        print(f"输入目录中未找到任何 .txt 文件: {in_dir}")
        return

    print(f"共发现 {total_files} 个待处理文本文件,开始批量生成...")
    success_count = 0
    for idx, txt_file in enumerate(txt_files, start=1):
        print(f"({idx}/{total_files}) 处理中: {txt_file.name} ...", end=" ")
        if process_single_file(txt_file, out_dir, font_path, DEFAULT_STOPWORDS):
            success_count += 1

    print(f"\n批处理全部完成!成功生成: {success_count}/{total_files} 幅词云图,已保存至 {out_dir}")

if __name__ == "__main__":
    # 示例调用:将 input_texts 目录下的所有文件处理到 output_clouds 目录下
    batch_generate_wordclouds("input_texts", "output_clouds")
六、常见问题排障与生产上线核对清单
在面对千万级文本或多用户提交的复杂数据时,批处理程序容易受到偶发异常的影响。针对可能遇到的边界情况与故障现象,梳理出如下排障决策与检查清单:
1. 为什么生成的大量词云图中依然包含无意义词汇?
这是因为通用停用词表往往无法覆盖特定业务领域的专业“口癖”或高频套话。例如在处理财报文本时,“报告期内”、“公司”、“实现”等词汇可能充斥全文;在电商评价中,“不错”、“感觉”、“挺好的”可能霸占画面。解决办法是建立一个业务自有的扩展停用词表文件 custom_stopwords.txt,在程序启动时使用 DEFAULT_STOPWORDS.update(custom_stopwords) 进行并集注入;同时对于专业术语,应使用 jieba.load_userdict("custom_dict.txt") 预加载自定义词典,防止专有名词被强行切碎。
2. 如何避免大批量处理导致的内存持续溢出?
在常见的教学示例中,很多人习惯使用 plt.imshow(wc) 配合 plt.savefig() 导出图片。matplotlib 会在全局维护图形画布列表,若未在每次循环末尾显式执行 plt.close('all'),成百上千幅图片堆叠在内存中会导致进程内存迅速吃紧甚至被操作系统杀掉。本文示例中推荐直接调用 wc.to_file(),该方法直接利用底层的 Pillow (PIL) 图像缓冲区执行文件写入,内存消耗恒定,单个任务处理后立即释放对象,能够稳定处理数万份文档的连续生成。
3. 如何为词云图指定自定义异形遮罩蒙版(Mask)?
若需要将词云渲染为特定形状(如圆形、公司标志或特定轮廓图),可借助 numpy 与 PIL.Image 读取黑白蒙版图片:通过 mask_img = np.array(Image.open("mask.png")) 加载,并在实例化 WordCloud(mask=mask_img, contour_width=1, contour_color='steelblue') 时传入该数组。在批量处理中,建议在循环体外部统一加载一次蒙版对象,避免重复读取同一幅蒙版图片造成的额外磁盘 I/O 开销。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









