

Python列表排序:sort()与sorted()的区别及用法
深入解析Python中列表排序方法sort()与内置函数sorted()的核心区别、底层原理、参数配置及最佳实践场景。
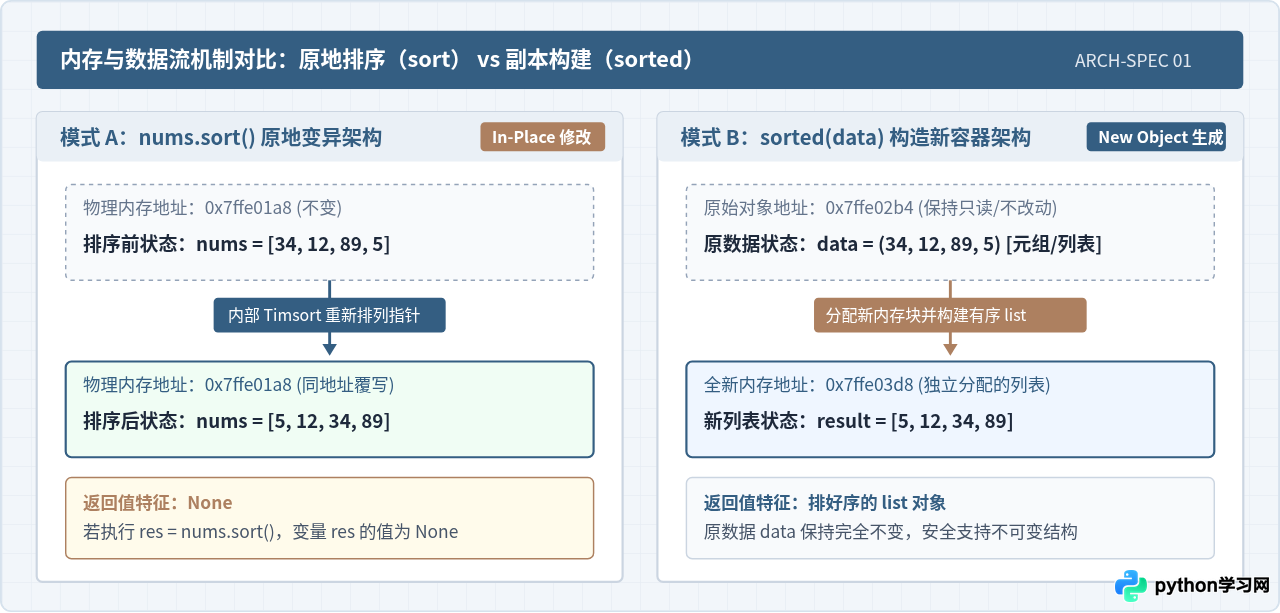
在 Python 编程中,对列表元素进行排序是高频操作。Python 提供了两种官方机制:列表对象特有的 list.sort() 方法和全局内置函数 sorted()。两者的核心区别在于:sort() 在原列表上执行“原地排序”(In-place),直接更改原列表数据且无返回值(返回 None);而 sorted() 接受任意可迭代对象,保留原对象完全不变,生成并返回一个已排序的全新列表。理解这种内存行为与接口约定的差异,有助于开发者在注重性能与保持数据不可变性之间做出明晰合理的选择。
一、核心机制与设计差异对比
初学者在学习排序时,最容易混淆的是“原处修改”与“生成副本”的概念。要准确理解这两个工具,可以从它们的作用目标、返回值以及内存行为三个维度进行拆解:
- 作用目标不同:
list.sort()是专门定义在列表类型(list)上的成员方法,不能直接作用于元组、集合、字典或生成器;sorted()则是 Python 内置的高阶函数,能够接收任何可迭代对象(Iterable)。 - 返回值机制不同:
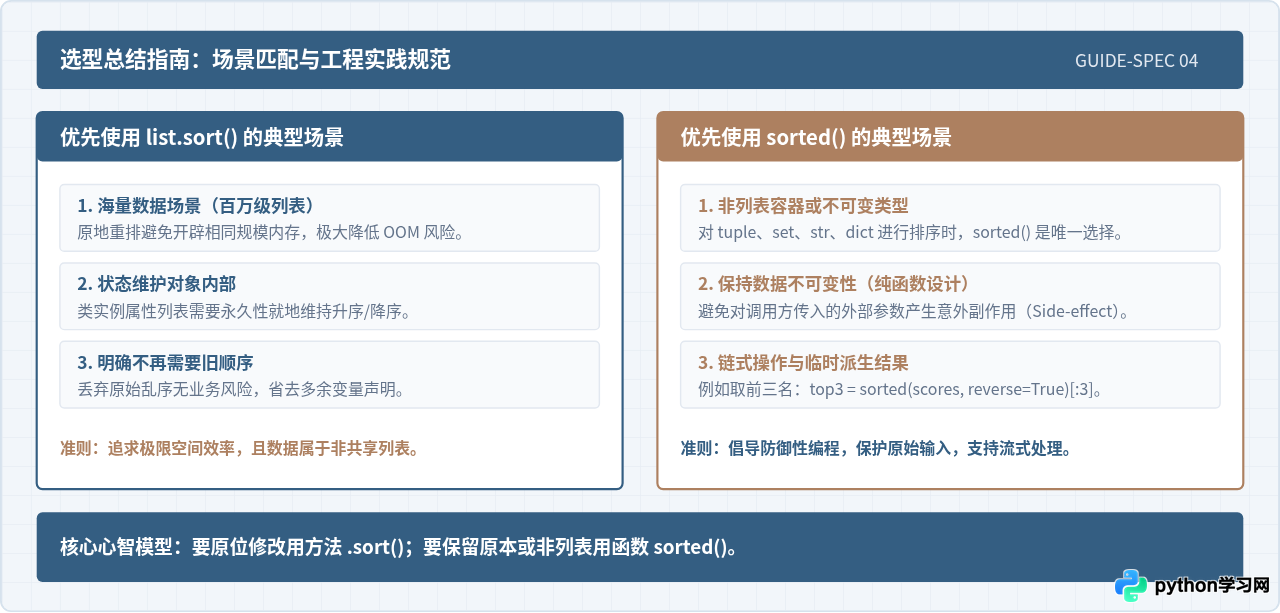
list.sort()严格遵循 Python 变异方法(Mutating Methods)的设计哲学,执行完毕后固定返回None,防止开发者误以为拿到了新对象;sorted()执行后始终构造并返回一个新的排好序的list实例。 - 内存开销不同:对于包含海量数据的大列表,
sort()不需要开辟新空间来存放同等规模的容器,空间利用率极高;sorted()则必须分配一段崭新的内存来容纳排序产物。
二、list.sort() 的详细用法与注意事项
list.sort() 是列表专属的原生方法,适用于明确需要更新当前列表顺序、且后续无需保留原顺序的场景。
1. 基础语法与核心参数
list.sort() 的标准方法签名如下:
list.sort(*, key=None, reverse=False)该方法仅接受关键字参数(通过 * 强制约束):
key:接收一个单参数可调用函数(如内置函数、自定义函数或 lambda 表达式)。该函数会在比较前作用于每个元素,以其返回值作为排序键。默认值为None,即直接比对元素自身。reverse:布尔值。默认是False,表示按升序(从小到大)排列;设置为True时表示降序(从大到小)排列。
2. 基础升序与降序示例
# 默认升序排序
scores = [88, 92, 75, 60, 99]
scores.sort()
print("升序结果:", scores)
# 示例输出: 升序结果: [60, 75, 88, 92, 99]

# 降序排序
scores.sort(reverse=True)
print("降序结果:", scores)
# 示例输出: 降序结果: [99, 92, 88, 75, 60]scores.sort() 的返回值是 None,不能写出形如 first_val = scores.sort()[0] 或 for x in scores.sort(): 的代码,这会直接抛出 TypeError: 'NoneType' object is not subscriptable 或 TypeError: 'NoneType' object is not iterable 错误。必须先单独调用 scores.sort(),再访问 scores。
三、sorted() 的详细用法与灵活性
sorted() 作为内置函数,最大的优势在于通用性与非破坏性。当原始序列不允许被篡改(例如读取的全局配置、只读元组),或者后续业务流程中仍需保留原始输入顺序时,应使用 sorted()。
1. 基础语法与接口定义
sorted(iterable, /, *, key=None, reverse=False)它的第一个参数 iterable 可以是任意迭代对象,例如 list、tuple、set、str、dict 以及生成器对象。后面的 key 与 reverse 参数与 sort() 完全一致。
2. 多类型迭代对象排序实战
# 对元组进行排序,返回新的排好序的列表
tuple_data = (42, 10, 88, 5)
sorted_list = sorted(tuple_data)
print("原元组未改变:", tuple_data)
print("生成的新列表:", sorted_list)
# 示例输出:
# 原元组未改变: (42, 10, 88, 5)
# 生成的新列表: [5, 10, 42, 88]

# 对字符串排序(返回包含单字符的排序列)
char_list = sorted("python")
print("字符排序:", char_list)
# 示例输出: 字符排序: ['h', 'n', 'o', 'p', 't', 'y']

# 对字典的键排序
user_ages = {"Charlie": 28, "Alice": 24, "Bob": 30}
sorted_keys = sorted(user_ages)
print("字典按键排序结果:", sorted_keys)
# 示例输出: 字典按键排序结果: ['Alice', 'Bob', 'Charlie']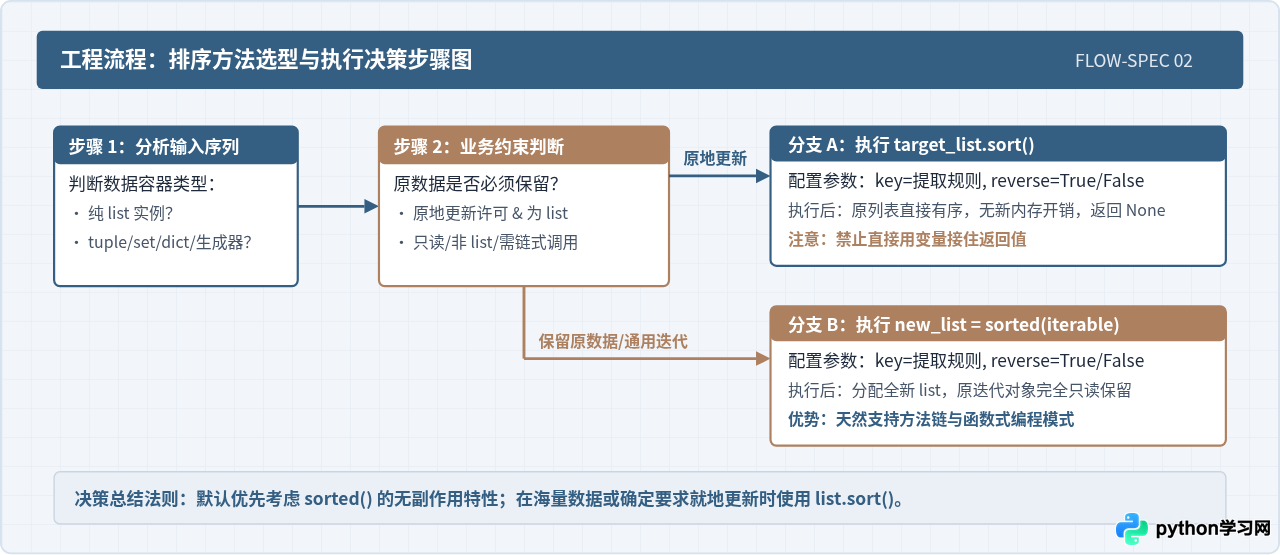
四、进阶用法:key 函数与多维度排序
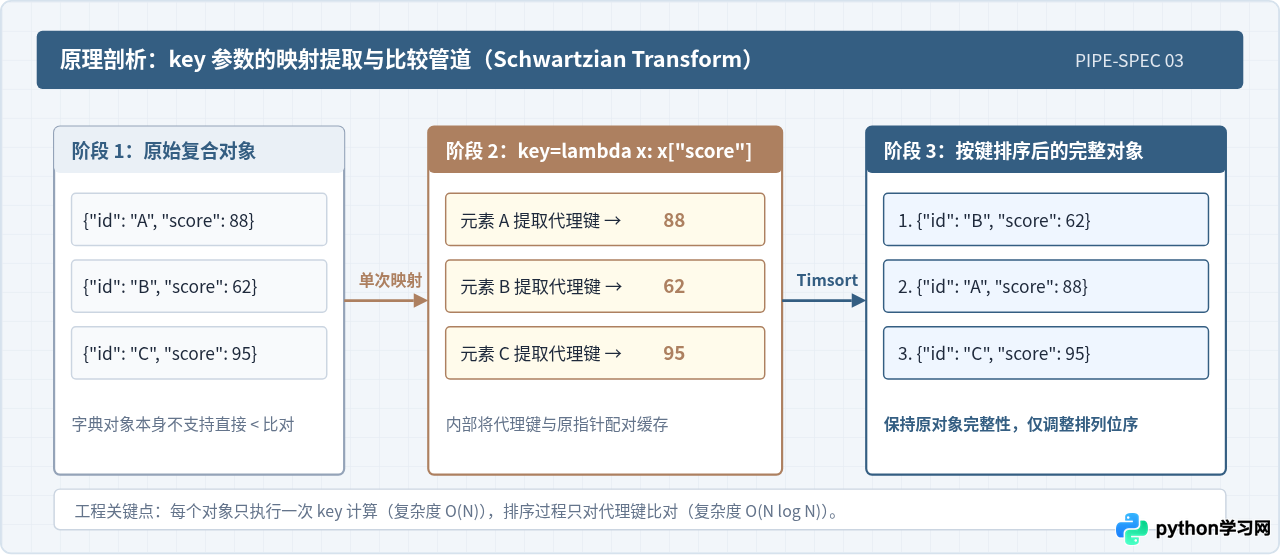
无论是 sort() 还是 sorted(),最强大的定制化能力均来自于 key 参数。key 要求传入一个只接受单个参数的可调用对象(Callable)。Python 在内部排序期间,会对每个待排序元素仅调用一次该函数,将其返回值作为真实比较的代理键(Proxy Key)。
1. key 函数的工作机制
传统的两两比较排序(如早期 Python 2 的 cmp 函数)在每次比较时都要反复计算比较逻辑,算法复杂度高。而 key 机制采用了“装饰-排序-取消装饰”(Schwartzian Transform / DSU 模式):每个元素只计算一次比较键,随后按照该键进行高速底层排序,极大减少了函数调用的开销。
2. 常见 key 使用场景示例
# 场景 1:忽略正负号,按绝对值大小排序
nums = [5, -12, 3, -8, 1]
nums.sort(key=abs)
print("按绝对值排序:", nums)
# 示例输出: 按绝对值排序: [1, 3, 5, -8, -12]

# 场景 2:按字符串长度排序
words = ["python", "c", "javascript", "go", "rust"]
sorted_words = sorted(words, key=len)
print("按长度升序:", sorted_words)
# 示例输出: 按长度升序: ['c', 'go', 'rust', 'python', 'javascript']

# 场景 3:字符串忽略大小写排序
tags = ["Python", "alpha", "Beta", "apple"]
tags.sort(key=str.lower)
print("忽略大小写排序:", tags)
# 示例输出: 忽略大小写排序: ['alpha', 'apple', 'Beta', 'Python']
3. 多字段多维度复合排序与稳定性
在实际开发中,经常需要对包含字典、对象或元组的列表进行排序。例如:先按年龄升序排列,当年龄相同时按成绩降序排列。
Python 的底层排序算法采用 Timsort(由 Tim Peters 设计),它具有严格稳定性(Stable Sort)。稳定性保证了:当两个元素的排序键相同时,它们在排序后的相对前后位置与排序前完全一致。
students = [
    {"name": "Alice", "age": 20, "score": 90},
    {"name": "Bob", "age": 19, "score": 85},
    {"name": "Charlie", "age": 20, "score": 95},
    {"name": "David", "age": 19, "score": 92}
]

# 需求:先按 age 升序;若 age 相同,则按 score 降序
# 在 Python 中,可以通过返回元组来实现多级比较;
# 数值降序可以通过取负号(-x["score"])实现
sorted_students = sorted(
    students,
    key=lambda s: (s["age"], -s["score"])
)

for s in sorted_students:
    print(s)
# 示例输出:
# {'name': 'David', 'age': 19, 'score': 92}
# {'name': 'Bob', 'age': 19, 'score': 85}
# {'name': 'Charlie', 'age': 20, 'score': 95}
# {'name': 'Alice', 'age': 20, 'score': 90}operator.itemgetter() 或 operator.attrgetter() 代替 lambda。它们是用 C 语言底层实现的,在处理数十万行数据时运行速度明显快于 Python 原生闭包调用。
五、选型矩阵与核心维度全面总结
为了帮助在实际编写代码时快速评估并选用最恰当的 API,下表总结了 list.sort() 与 sorted() 的全维度差异:
| 比对维度 | list.sort() |
sorted() |
|---|---|---|
| 所属范畴 | 列表专属方法(list.sort()) |
全局内置函数(built-in function) |
| 接收对象 | 仅限 list 实例 |
任意 Iterable(列表、元组、集合、字典、生成器等) |
| 返回值 | 固定返回 None |
返回排序后的全新 list |
| 原对象影响 | 直接原地覆写(变异操作) | 原序列保持完全不可变(无副作用) |
| 额外内存开销 | \(O(1)\) 辅助空间(仅少量内部指针交换缓冲) | \(O(N)\) 额外空间(必须构造并容纳新列表) |
| 链式调用支持 | 不支持(返回 None 会切断链式调用) |
支持(可直接后接 [:10]、join() 等操作) |
| 底层算法与稳定性 | Timsort,具备严格稳定性 | Timsort,具备严格稳定性 |
六、常见报错与排查清单
在日常开发与代码审查中,围绕列表排序最常出现以下两类典型问题:
1. TypeError: '<' not supported between instances of 'int' and 'str'
原因:Python 3 取消了对不同非兼容类型之间的默认大小比较。如果列表中混杂了整数与字符串(如 [10, "20", 5]),直接调用 sort() 或 sorted() 均会直接抛出类型异常。
修复方案:通过 key 参数显式统一数据类型:
mixed_data = [10, "20", 5, "1"]
# 统一转为整型比对
sorted_res = sorted(mixed_data, key=int)
print("统一转整型排序:", sorted_res)
# 示例输出: 统一转整型排序: ['1', 5, 10, '20']
2. 期望自定义排序却使用了已被废弃的 cmp 参数
原因:Python 2 曾经支持通过 cmp=my_cmp 传递两两比较函数,该参数在 Python 3 中已被彻底移除。强行传入会抛出 TypeError: 'cmp' is an invalid keyword argument。
修复方案:优先改写为 key 函数。对于历史遗留的复杂比较逻辑,可以使用标准库提供的转换适配器:
from functools import cmp_to_key

def custom_comparator(a, b):
    # 返回负数表示 a < b,0 表示 a == b,正数表示 a > b
    return (a > b) - (a < b)

data = [4, 2, 9, 1]
data.sort(key=cmp_to_key(custom_comparator))
print("使用 cmp_to_key 排序:", data)
# 示例输出: 使用 cmp_to_key 排序: [1, 2, 4, 9]免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









