

Python定义函数时的常见陷阱:默认可变参数问题
深入解析Python函数定义中可变对象作为默认参数的常见陷阱、底层运行原理与内存引用机制,并提供规范的None哨兵解决模式与工程排查方案。
在 Python 函数设计中,为参数设置默认值是一项非常常用的特性。然而很多开发者在初学或编写日常代码时,常会遇到这样一个典型困惑:当使用列表(list)或字典(dict)等可变对象作为函数形参的默认值时,多次调用函数会产生意想不到的数据交叉与持续累加。本文将直接说明该现象的具体表现、背后的底层运行机制,并给出工程中通用且标准的解决规范与防范方法。
一、现象重现:令人困惑的累加调用
我们先来看一段看似简单、却极具代表性的函数定义代码。该函数期望将传入的数据添加到一个列表中,并返回最终列表;如果调用者未传入列表,则默认新建一个列表来接收数据:
# 带有可变默认参数的典型代码
def append_to(item, target_list=[]):
    target_list.append(item)
    return target_list

# 第一次调用
result1 = append_to("A")
print(result1)  # 示例输出: ['A']

# 第二次调用(未传 target_list,期望得到 ['B'])
result2 = append_to("B")
print(result2)  # 示例输出: ['A', 'B']

# 第三次调用
result3 = append_to("C")
print(result3)  # 示例输出: ['A', 'B', 'C']
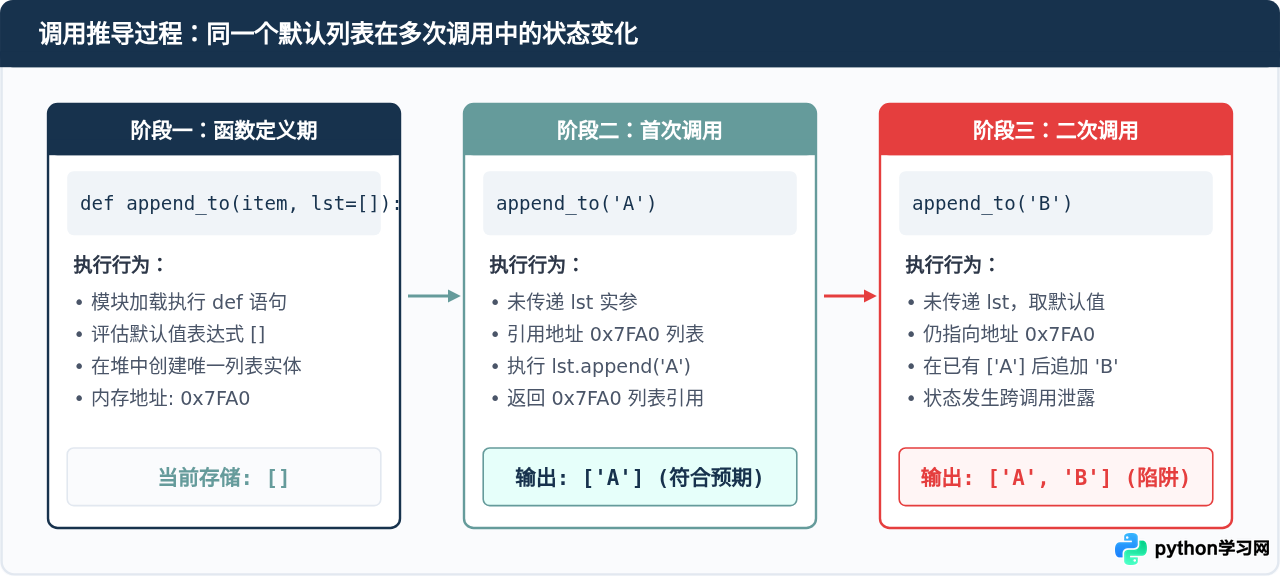
直觉上,初学者往往会认为每次调用 append_to 且不提供 target_list 时,Python 都会新建一个空列表 []。但实际输出却表明:前一次调用的结果被完整保留下来,后续的调用不断在同一个列表上追加元素。这个共享状态会导致严重的逻辑隐患,特别是在多任务或接口处理中极易引发数据污染。
二、底层原因:定义期求值与 __defaults__ 属性
要真正理解这个问题,核心在于分清 Python 运行的两个阶段:定义期(Definition time)与调用期(Execution time)。
在 Python 中,def 是一个可执行语句。当解释器读取并执行到 def append_to(...) 这一行时,会发生以下两件事:
- 默认参数只在定义期求值一次:解释器会立即计算参数默认值表达式
[],在内存堆上创建一个空列表对象。 - 将对象绑定到函数属性上:创建的函数对象拥有一个名为
__defaults__的内部元组属性,该元组直接保存了默认参数对象的内存引用。
我们可以通过 Python 内置属性来直接打印验证这个机制:
def test_func(val, container=[]):
    container.append(val)
    return container

# 观察函数对象的 __defaults__ 属性
print("初始默认值元组:", test_func.__defaults__)  # 示例输出: ([],)
print("默认列表的内存ID:", id(test_func.__defaults__[0]))

test_func("Item 1")
print("调用一次后元组:", test_func.__defaults__)  # 示例输出: (['Item 1'],)
print("再次查看内存ID:", id(test_func.__defaults__[0]))  # 内存ID完全一致!
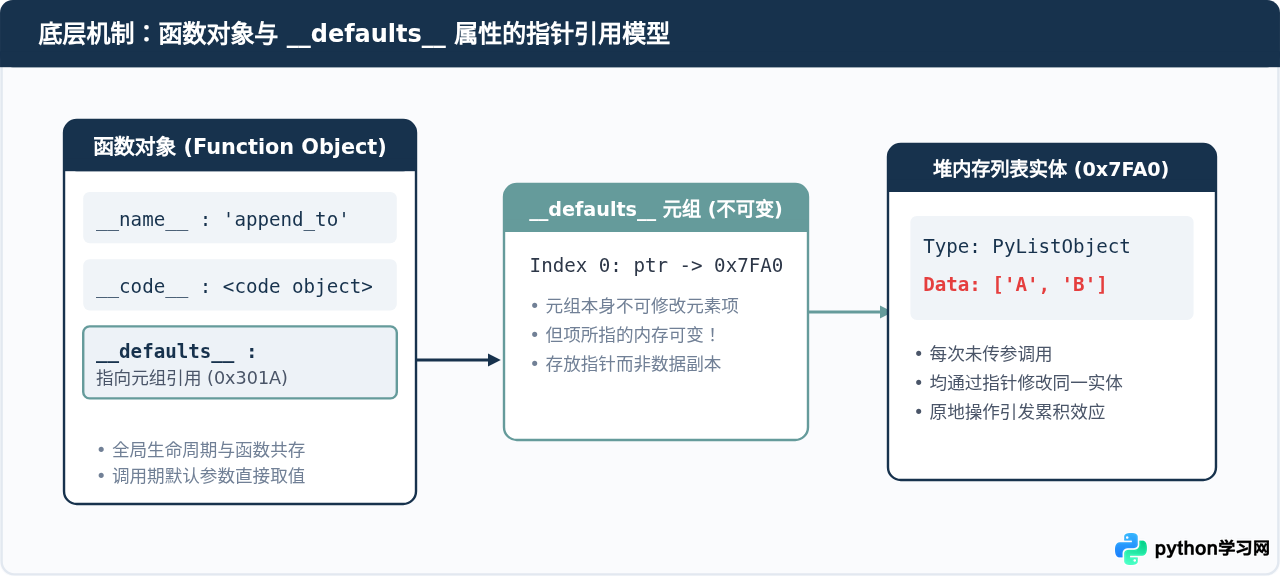
由此可见,每次调用该函数且不传递该参数时,形参变量 container 并没有被分配全新的内存空间,而是直接指向了函数对象 __defaults__ 中早已存在的同一个列表实例。因为列表属于可变对象(Mutable Object),对其进行 append() 或 extend() 会直接在原地修改其内存内容,从而永久改变了保存在 __defaults__ 中的默认数据。
三、标准解决方案:None 哨兵值模式
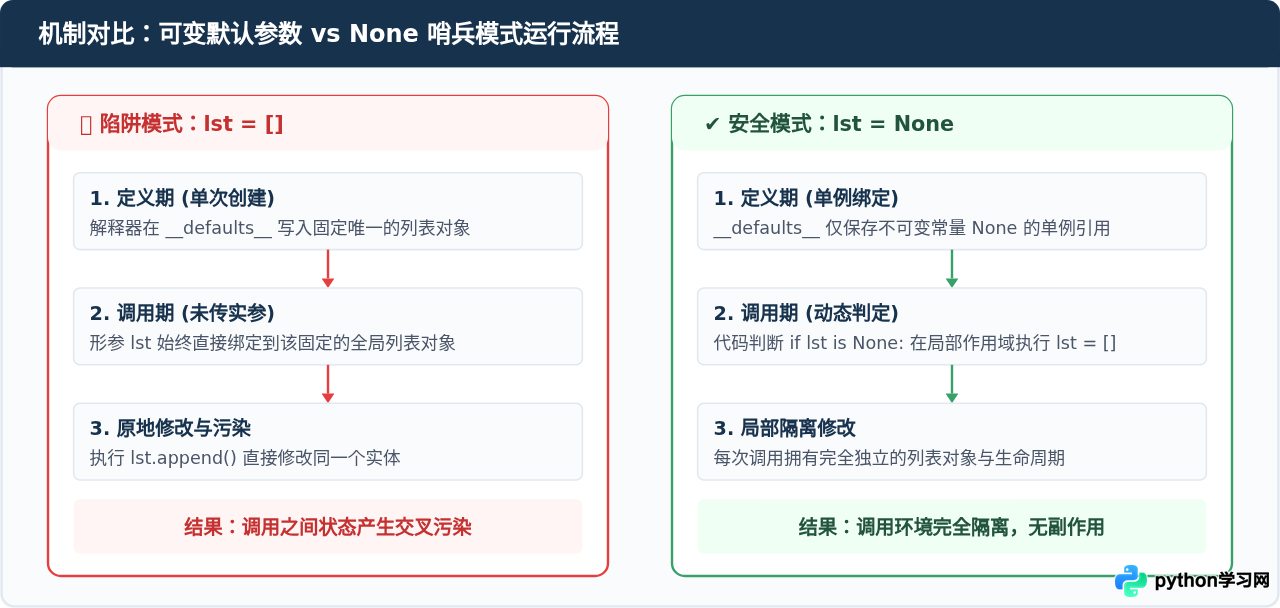
解决该问题的经典且符合 Pythonic 规范的方案是采用 None 哨兵模式。具体步骤如下:
- 将函数的默认参数值声明为不可变的
None; - 在函数体内部最前沿,通过
if target_list is None:进行动态判断; - 如果为
None,在函数执行作用域中重新创建独立的空列表[]。
标准修复代码如下:
# 推荐的标准写法:使用 None 哨兵值
def append_to(item, target_list=None):
    if target_list is None:
        target_list = []  # 每次调用动态创建新的局部列表
    target_list.append(item)
    return target_list

# 验证调用独立性
print(append_to("A"))  # 示例输出: ['A']
print(append_to("B"))  # 示例输出: ['B']  (调用隔离,符合预期)
print(append_to("C"))  # 示例输出: ['C']

# 显式传入现有列表仍能正常工作
custom_list = [1, 2]
append_to(3, custom_list)
print(custom_list)     # 示例输出: [1, 2, 3]
为什么这种写法能够彻底杜绝陷阱?因为 None 是不可变的单例对象,定义期保存在 __defaults__ 中的只是 None 的引用;而真正的新列表创建动作被延后到了调用期内部,每次执行都会在当前函数的局部栈帧作用域内生成全新的独立列表,生命周期仅限于当前调用上下文。
四、容易忽略的变种陷阱与类似场景
可变默认参数问题不仅出现在空列表 [] 上,在以下几个日常开发场景中同样非常普遍:
1. 字典(dict)与集合(set)作为默认参数
字典和集合同样属于可变容器。例如在实现一个简单的字典收集函数时:
def register_user(username, metadata={}):
    metadata["user"] = username
    return metadata

u1 = register_user("Alice")  # 输出: {'user': 'Alice'}
u2 = register_user("Bob")    # 期望 {'user': 'Bob'},但实际是同一字典被覆写!
修复方案完全相同:使用 metadata=None,在函数体内初始化 metadata = {}。
2. 动态求值表达式(如时间戳与随机数)
除数据结构外,调用返回动态值的函数作为默认参数也是高频陷阱之一:
from datetime import datetime
import time

# 陷阱:datetime.now() 只在函数定义时执行一次!
def log_event(message, log_time=datetime.now()):
    print(f"[{log_time.strftime('%H:%M:%S')}] {message}")

log_event("服务启动")
time.sleep(3)
log_event("任务处理")  # 输出的时间戳与三秒前完全一样!
这同样是因为默认参数只在定义期求值。解决办法依然是将其设为 log_time=None,在调用时通过 if log_time is None: log_time = datetime.now() 动态获取当前时间。
Optional[list] 或 list | None,例如:
def append_to(item: str, target_list: list[str] | None = None) -> list[str]:,这能帮助 IDE 和静态分析工具自动提示可能存在的 None 校验要求。
五、工程化防范与代码规范
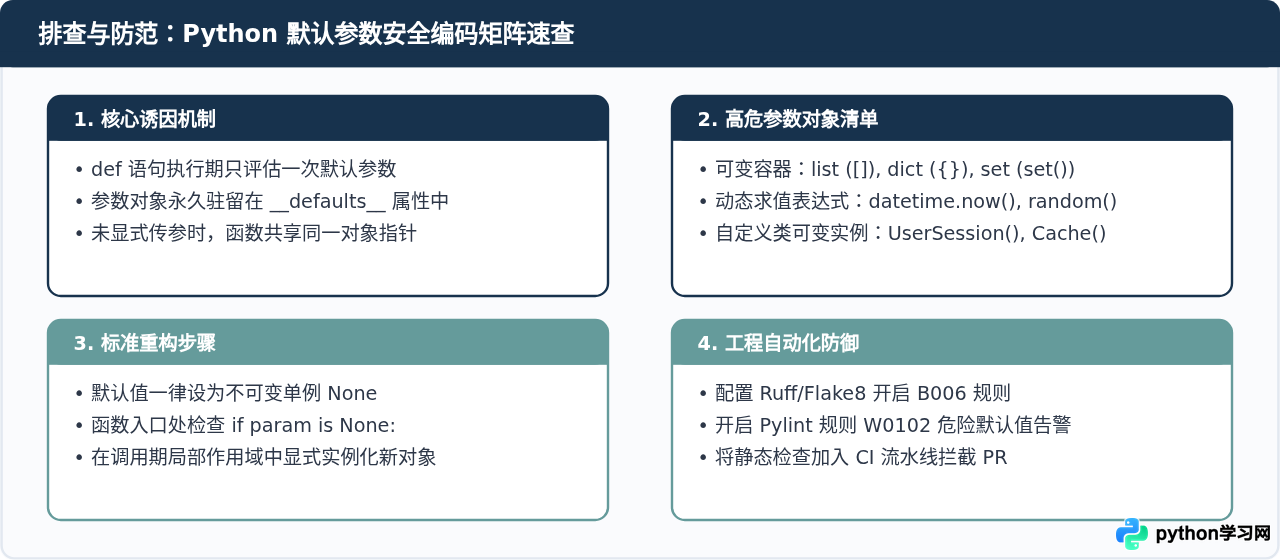
在多人协作与大型工程中,单纯依靠开发者的自律很容易百密一疏。建立自动化代码检查体系是彻底杜绝该类 Bug 的最佳实践。
| 检查工具 | 对应检测规则代码 | 检查说明 |
|---|---|---|
| Ruff / Flake8 | B006 (mutable-argument-default) |
静态检测函数声明中的可变参数(列表、字典、集合等字面量)并立即告警 |
| Pylint | W0102 (dangerous-default-value) |
直接指出使用了危险的默认值,并在 CI 阶段拦截代码合并 |
| Mypy | 参数类型与默认值一致性检查 | 强制要求使用可空类型(如 Optional),促使开发者显式编写判断逻辑 |
六、总结
Python 中“可变对象作为默认参数”带来的陷阱,其根源并非解释器的 Bug,而是 Python 语言将函数视为一等公民、在模块载入时即完成函数定义和默认值初始化的设计结果。只要牢记“默认参数使用不可变对象(如 None),并在函数内部动态初始化可变对象”这一准则,结合团队的静态分析规则,就能彻底避免此类难以追踪的数据状态污染问题。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









