

Python进阶必学库:Pandas、Requests与Flask应用指南
深入解析Python进阶三大利器Pandas、Requests与Flask的核心定位、开发技巧与协同集成实践,涵盖数据采集、数据清洗分析与Web API服务的完整生命周期。
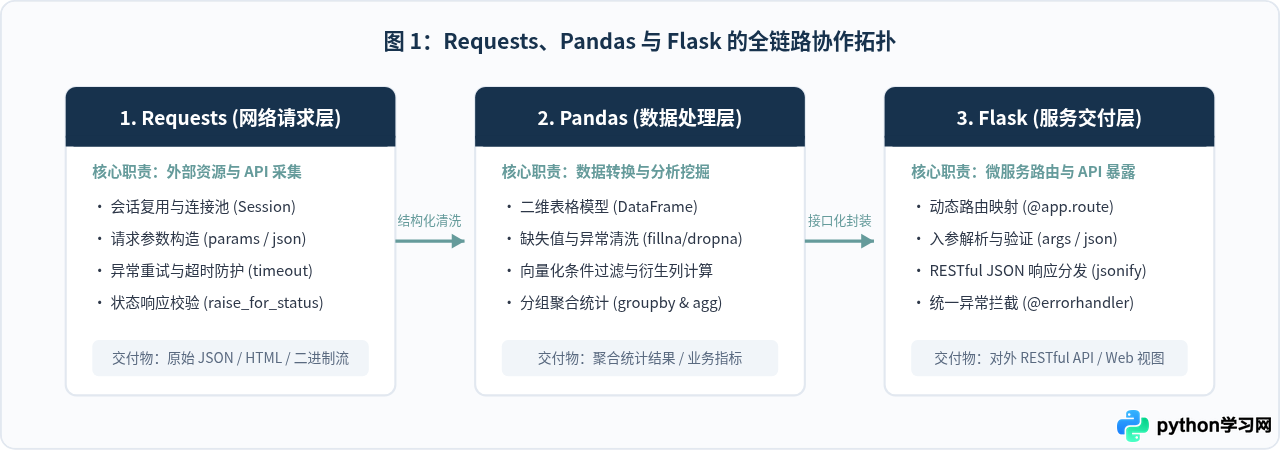
掌握了 Python 基础语法与核心数据结构后,多数开发者在迈向实际工程项目时,都会面临三项高频需求:如何从外部网络高效获取数据、如何对杂乱的数据展开清洗与统计、以及如何将计算结果包装成接口或服务提供给他人使用。针对这三项核心任务,Python 生态中最具代表性且几乎成为行业事实标准的三个库分别是 Requests、Pandas 与 Flask。本文将针对这三个库的定位、核心用法、协作模式及工程避坑点展开系统讲解,帮助你构建一套从数据获取到数据发布的一体化开发能力。
一、Requests:高可靠的外部数据获取与接口交互
在 Python 内置模块中,虽然提供了 urllib.request,但在处理复杂的请求头定制、身份认证、Cookie 保持以及 JSON 自动反序列化时,代码较为冗长且易错。Requests 提供了人性化的 API 抽象,将底层繁琐的套接字管理封装为直接表达语义的操作。
1. 核心操作规范:GET、POST 与参数传递
在发起 HTTP 请求时,最常见的两个动作是获取资源(GET)与提交数据(POST)。向服务端传参时,需根据接口契约区分 URL 查询字符串与请求体载荷:
- URL 传参(params):对于 GET 请求,使用
params=dict传参,Requests 会自动完成 URL 编码(Query String),无需手动拼接字符串。 - JSON 请求体(json):调用现代化 REST API 发起 POST 请求时,推荐使用
json=dict参数,Requests 会自动添加Content-Type: application/json头并序列化字典。 - 表单请求体(data):传统的 HTML 表单提交使用
data=dict,此时会编码为application/x-www-form-urlencoded。
2. 工程级健壮性实践:超时防护与异常捕获
许多初学者直接使用 requests.get(url) 并不显式传递 timeout,这是导致后台任务在弱网环境下永久挂死的隐蔽根源。任何生产级别或批量采集代码,都必须强制指定超时阈值,并捕获层级异常。
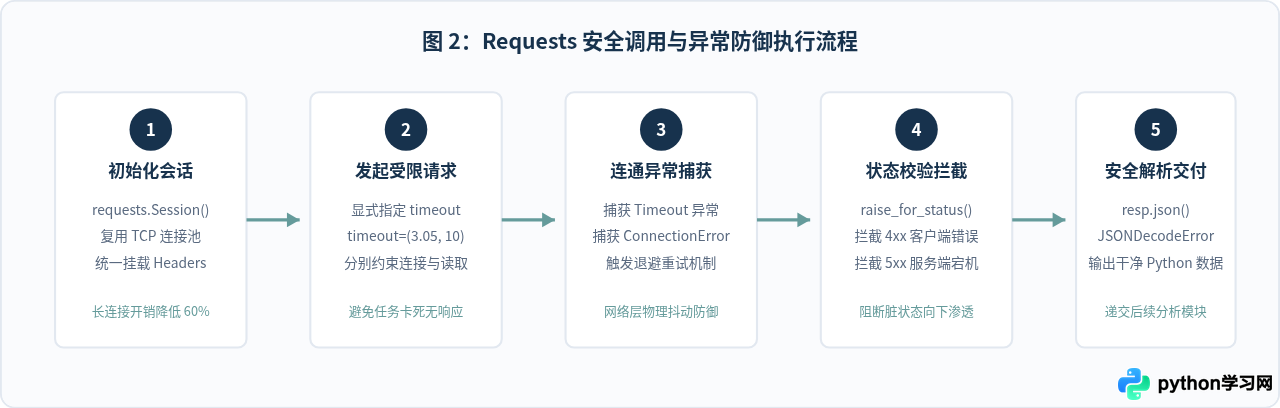
下面是一段具有完备异常处理与会话连接复用的标准代码模板:
import requests
from requests.exceptions import Timeout, HTTPError, RequestException

def fetch_remote_metrics(endpoint_url: str, query_token: str) -> list:
    """安全拉取外部 JSON 数据的标准实现"""
    headers = {
        "User-Agent": "DataCollector/2.0 (AnalysisService)",
        "Accept": "application/json"
    }
    params = {"token": query_token, "limit": 100}

    # 使用 Session 保持长连接池并提高重复请求吞吐量
    with requests.Session() as session:
        try:
            # timeout=(连接超时, 读取超时),避免无限挂起
            response = session.get(
                endpoint_url,
                headers=headers,
                params=params,
                timeout=(3.05, 10.0)
            )
            # 若返回 4xx/5xx 则立即抛出 HTTPError
            response.raise_for_status()

            # 解析 JSON 响应
            payload = response.json()
            return payload.get("data", [])

        except Timeout:
            print("错误:请求目标服务器超时,请检查网络链路或调大读取超时阈值。")
            return []
        except HTTPError as err:
            print(f"错误:HTTP 响应非正常状态码 [{response.status_code}] - {err}")
            return []
        except RequestException as err:
            print(f"错误:网络请求失败或无法连通目标主机 - {err}")
            return []
二、Pandas:结构化数据的清洗、分析与转换
获取到原始数据后,常常面临字段缺失、类型混乱、数值格式不统一或嵌套层级深等问题。如果使用纯 Python 列表嵌套与字典循环处理,不仅逻辑冗长,而且在处理成千上万条记录时性能极差。Pandas 底层基于 C 和 NumPy 实现,提供了核心二维表格对象 DataFrame 与一维序列对象 Series,支持高效的内存对齐与向量化批量运算。
1. 核心数据清洗流程
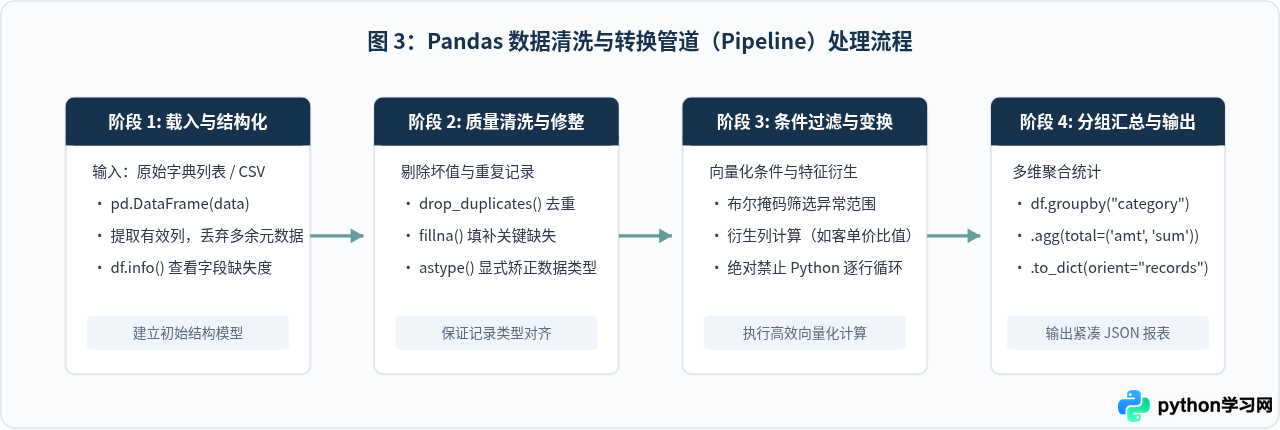
规范的数据清洗流水线通常分为四个关键阶段:数据载入、缺失值与重复项清洗、类型矫正与特征衍生、以及分组聚合统计。
2. 实战代码:典型业务指标清洗与汇总
下面展示一段将原始订单字典列表转换为分组汇总统计报表的完整 Pandas 脚本:
import pandas as pd

def process_sales_records(raw_records: list) -> list:
    """使用 Pandas 对销售明细进行清洗、过滤与分组聚合"""
    if not raw_records:
        return []

    # 1. 构建 DataFrame
    df = pd.DataFrame(raw_records)

    # 2. 检查必须包含的字段
    required_cols = {"order_id", "category", "amount", "status"}
    if not required_cols.issubset(df.columns):
        raise ValueError("输入数据缺少必需的字段列")

    # 3. 数据清洗:去重与缺失值处理
    df = df.drop_duplicates(subset=["order_id"])
    df["amount"] = pd.to_numeric(df["amount"], errors="coerce").fillna(0.0)

    # 4. 条件过滤:仅保留已支付完成且金额大于 0 的有效单据
    valid_mask = (df["status"] == "COMPLETED") & (df["amount"] > 0)
    cleaned_df = df.loc[valid_mask].copy()

    # 5. 分组与聚合统计:按品类统计订单总额、订单笔数和平均客单价
    summary_df = cleaned_df.groupby("category").agg(
        order_count=("order_id", "count"),
        total_revenue=("amount", "sum"),
        avg_order_value=("amount", "mean")
    ).reset_index()

    # 6. 四舍五入保留两位小数,并输出为字典列表供接口直接返回
    summary_df["total_revenue"] = summary_df["total_revenue"].round(2)
    summary_df["avg_order_value"] = summary_df["avg_order_value"].round(2)

return summary_df.to_dict(orient="records")df[df['col'] > 0]['col2'] = 1)时,Pandas 会发出警告,因为无法确定修改的是原数据的视图还是副本。推荐显式使用 df.loc[condition, 'col2'] = 1 或在切片后调用 .copy() 创建独立对象。
三、Flask:敏捷轻量的 Web 接口与服务发布
当通过 Requests 获取了数据、并通过 Pandas 完成了分析统计后,如何将这套计算能力共享给前端页面、移动端或其他微服务?Flask 作为微框架(Microframework),不强制约束复杂的文件目录与持久层绑定,通过极其直观的装饰器语法即可快速构建 RESTful API 服务。
1. 核心运行机制与请求对象解析
Flask 依靠 WSGI 协议接收 Web 服务器发来的请求,核心组件包括应用实例 Flask(__name__)、路由映射器 @app.route、全局请求上下文 request 以及响应封装工具 jsonify:
- 路由与 HTTP 方法绑定:通过
@app.route("/api/path", methods=["GET", "POST"])明确限定当前视图允许的 HTTP 动词,严禁不限制方法的开放路由。 - 解析 URL 查询参数:使用
request.args.get("param_name", default=None)获取 URL 中的参数,支持设置类型转换或默认缺省值。 - 解析 JSON 请求体:对于 POST/PUT 请求,使用
request.get_json(silent=True)安全提取 JSON 数据。silent=True可防止在客户端传空或非合法 JSON 时直接抛出 400 崩溃。 - 统一规范的响应输出:使用
jsonify({"code": 200, "data": ...}), 200,保证响应头正确附带Content-Type: application/json,并显式指定状态码。
2. 基础 API 骨架与错误拦截
from flask import Flask, request, jsonify

app = Flask(__name__)

# 全局错误处理器:拦截 404
@app.errorhandler(404)
def resource_not_found(e):
    return jsonify({"error": "Resource not found", "status": 404}), 404

# 全局错误处理器:拦截 500
@app.errorhandler(500)
def internal_server_error(e):
    return jsonify({"error": "Internal server error occurred", "status": 500}), 500

@app.route("/api/health", methods=["GET"])
def health_check():
    """轻量健康检查探针,常用于运维监控与负载均衡探活"""
    return jsonify({"status": "healthy", "service": "metrics-engine"}), 200

if __name__ == "__main__":
    # 本地开发测试;生产环境务必使用 Gunicorn 或 uWSGI 运行
    app.run(host="127.0.0.1", port=5000, debug=False)
四、综合实战:从请求拉取、数据清洗到 API 服务的完整闭环
在实际生产环境中,这三项工具并非孤立存在。最典型的应用拓扑是:以 Flask 为对外服务外壳,在收到前端调用指令后,使用 Requests 抓取上游原始日志或第三方行情接口,随后在内存中交给 Pandas 实时进行分组切片计算,最后由 Flask 封装成标准 JSON 格式返回给调用方。
以下为一个可直接执行的完整微服务模块:
import requests
import pandas as pd
from flask import Flask, request, jsonify

app = Flask(__name__)

# 模拟远端上游数据源 URL(在实际开发中替换为真正的上游 REST API)
UPSTREAM_DATA_SOURCE = "https://api.example.com/v1/raw-transactions"

def fetch_upstream_data(limit: int = 500) -> list:
    """第一环:Requests 负责向上游采集原始数据"""
    try:
        resp = requests.get(
            UPSTREAM_DATA_SOURCE,
            params={"limit": limit},
            timeout=(3.0, 8.0),
            headers={"User-Agent": "AnalyticsPipeline/1.0"}
        )
        resp.raise_for_status()
        json_data = resp.json()
        return json_data.get("records", [])
    except requests.RequestException:
        # 当上游不可达或网络受阻时,提供安全降级兜底示例数据以保证演示可用性
        return [
            {"order_id": 101, "category": "办公设备", "amount": 1280.5, "status": "COMPLETED"},
            {"order_id": 102, "category": "数码配件", "amount": 299.0, "status": "COMPLETED"},
            {"order_id": 103, "category": "办公设备", "amount": 450.0, "status": "PENDING"},
            {"order_id": 104, "category": "生活百货", "amount": None, "status": "COMPLETED"},
            {"order_id": 105, "category": "数码配件", "amount": 699.0, "status": "COMPLETED"},
            {"order_id": 101, "category": "办公设备", "amount": 1280.5, "status": "COMPLETED"} # 重复单据
        ]

def calculate_metrics(raw_data: list, target_category: str = None) -> dict:
    """第二环:Pandas 负责内存中的数据清洗、过滤与指标聚合"""
    if not raw_data:
        return {"total_sales": 0, "categories": []}

    df = pd.DataFrame(raw_data)

    # 1. 清除重复记录并填补空金额
    df = df.drop_duplicates(subset=["order_id"])
    df["amount"] = pd.to_numeric(df["amount"], errors="coerce").fillna(0.0)

    # 2. 状态过滤
    df = df.loc[df["status"] == "COMPLETED"]

    # 3. 若指定了品类筛选条件,则执行过滤
    if target_category:
        df = df.loc[df["category"] == target_category]

    if df.empty:
        return {"total_sales": 0, "categories": []}

    # 4. 多维指标汇总
    total_sales = round(float(df["amount"].sum()), 2)
    category_summary = df.groupby("category").agg(
        order_count=("order_id", "count"),
        subtotal=("amount", "sum"),
        average=("amount", "mean")
    ).reset_index()

    # 格式化数字
    category_summary["subtotal"] = category_summary["subtotal"].round(2)
    category_summary["average"] = category_summary["average"].round(2)

    return {
        "total_sales": total_sales,
        "categories": category_summary.to_dict(orient="records")
    }

@app.route("/api/v1/sales-summary", methods=["GET"])
def sales_summary_api():
    """第三环:Flask 对外暴露标准化查询接口"""
    # 获取调用方传递的可选参数
    category_filter = request.args.get("category", type=str, default=None)
    data_limit = request.args.get("limit", type=int, default=100)

    # 1. 抓取外部数据
    raw_records = fetch_upstream_data(limit=data_limit)

    # 2. 数据计算清洗
    result = calculate_metrics(raw_records, target_category=category_filter)

    # 3. 封装标准化响应
    return jsonify({
        "code": 200,
        "message": "success",
        "filter": {"category": category_filter, "limit": data_limit},
        "payload": result
    }), 200

if __name__ == "__main__":
    app.run(host="0.0.0.0", port=8000, debug=False)
五、三库综合对比与技术选型决策
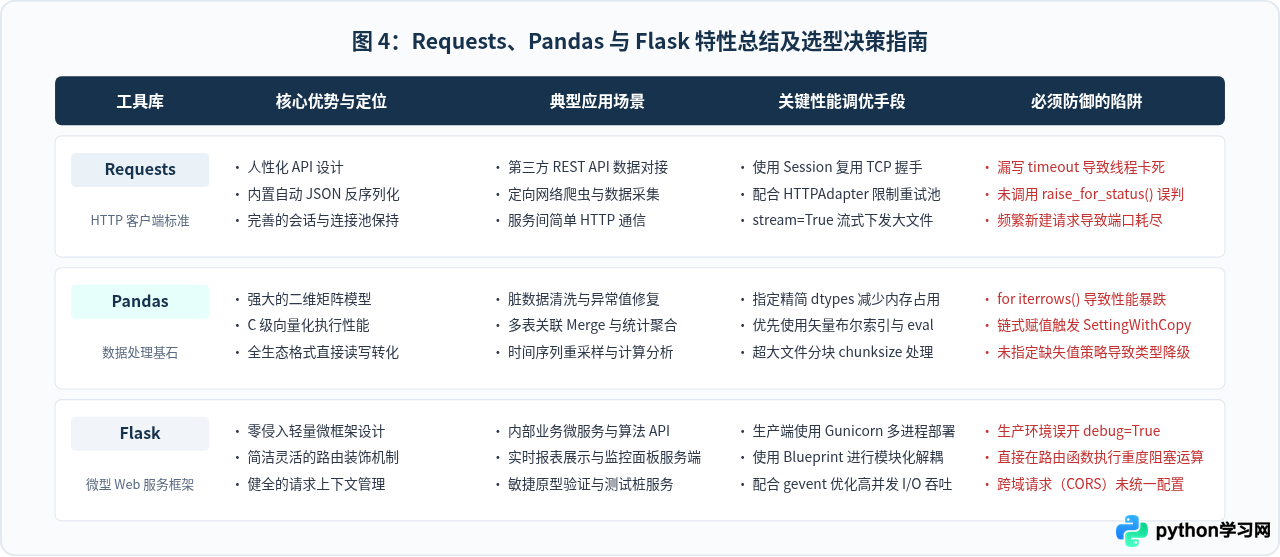
在规划 Python 项目的技术架构时,清晰理解每个库的边界与优势能够有效避免技术选型偏差与过度设计。以下从核心优势、典型应用场景与常见避坑点对这三个进阶库进行全面总结:
六、进阶避坑与架构优化准则
在实际将上述三库组合为长期运行的工程项目时,需牢记以下四条核心架构准则:
- 严禁在 Flask 路由函数内执行同步耗时采集: 如果使用 Requests 抓取多个外部网站需要耗费数秒,直接在 Flask 视图中同步等待会导致工作进程被阻塞,降低整体服务吞吐量。此时应将抓取与清洗任务抽离为后台定时任务(如结合 Celery 或轻量多线程调度器),Flask 仅读取已经预计算完成的缓存或数据库数据。
- 警惕内存膨胀: 当使用 Pandas 读取外部传入的大规模 JSON 或 CSV 时,一次性载入可能耗尽服务器内存。可通过
chunksize参数实现流式批处理分块计算,或指定仅加载计算所需的列(usecols)。 - 网络层防御与超时重试: 外部接口具有不可控性,Requests 调用必须设置合理的
timeout,并结合urllib3.util.Retry与HTTPAdapter配置指数退避重试,防止短时间网络抖动导致大面积报错。 - 严格区分开发环境与生产环境:
app.run()仅适用于本地单线程调试。在线上部署时,必须使用 WSGI 容器(如 Gunicorn / uWSGI)配合 Nginx 反向代理进行多工作进程管理。
七、总结
掌握 Requests、Pandas 与 Flask,意味着你已经拥有了一条完整的现代 Python 应用开发数据流转闭环:用 Requests 稳定、安全地连接全世界的 API 与网络数据;用 Pandas 将杂乱无序的原始记录高效转化为有商业价值的结构化指标;再用 Flask 将计算成果封装为高内聚、易调用的网络微服务。理解它们各自的职责边界与协同模式,是迈向成熟 Python 后端与数据工程开发不可或缺的一步。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









