

Python和C语言的核心区别:解释型与编译型、动态与静态类型

理解Python与C语言的核心区别,本质上是理解计算机程序从文本源码转化为硬件执行指令的两种不同工程哲学。C语言是编译型、静态类型语言,程序在运行前必须经过编译器全面检查并翻译为原生机器指令,变量在内存中的大小与布局在编译期彻底确定;Python则是解释型、动态类型语言,源码在运行时被虚拟机逐条解释执行,类型信息依附于运行中的对象本身,变量名仅作为动态指针。这种底层设计维度的差异,直接决定了两门语言在执行效率、开发周期、内存控制能力与错误暴露时机上的根本分野。
一、解释型与编译型:机器执行路径的根本差异
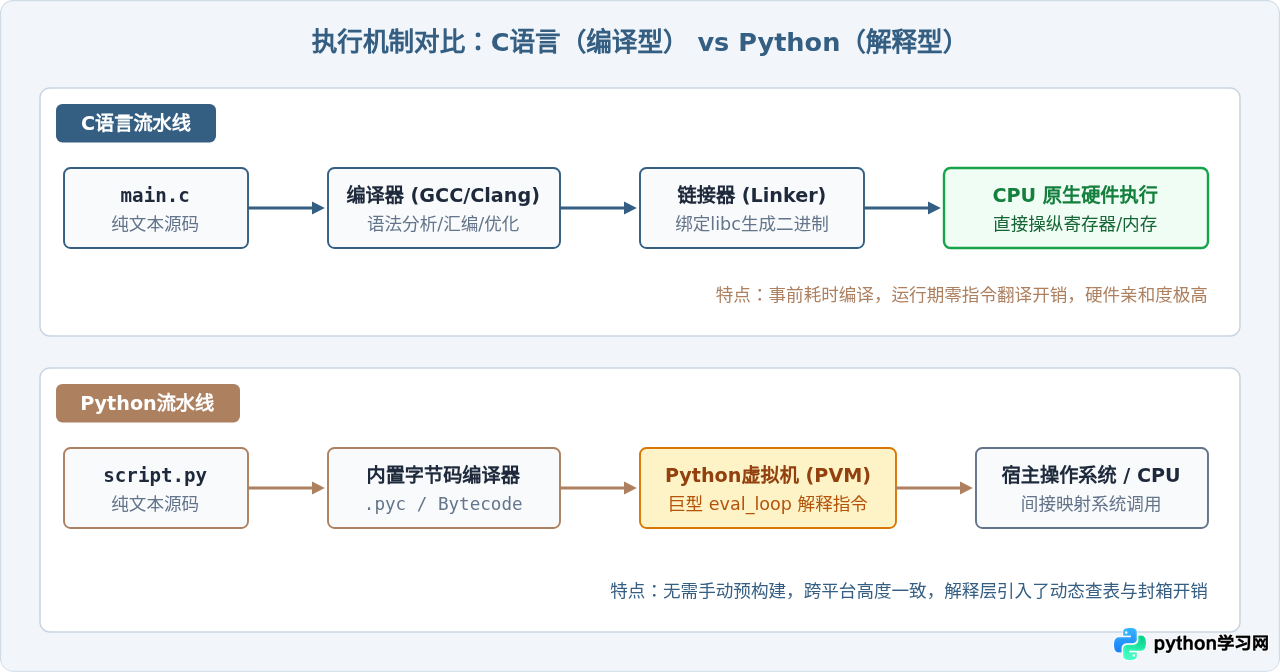
计算机CPU只能识别由0和1构成的二进制机器指令集。任何高级语言写出的文本文件,最终都必须以某种方式转换成CPU能够执行的动作。C语言与Python在“何时翻译”以及“由谁翻译”这两个问题上采取了截然相反的路径。
1. C语言的编译流水线
C语言的设计目标是紧贴硬件,追求极限执行速度与紧凑的内存占用。当你编写完一个名为 main.c 的文件后,操作系统本身并不能直接运行它,必须调用编译器套件(如 GCC 或 Clang)执行严谨的构建流水线:
- 预处理(Preprocessing):解析以
#开头的宏定义、头文件展开(#include)及条件编译指令,生成纯C源码文件(.i)。 - 编译(Compilation):编译器对语法、词法进行深入分析与语义检查,执行代码优化,并将高级语句降级翻译为平台对应的汇编语言(
.s)。 - 汇编(Assembly):汇编器将汇编指令精确翻译成CPU指令集的机器码,输出可重定位目标文件(
.o或.obj)。 - 链接(Linking):链接器将多个目标文件以及系统运行时库(如
libc)连接在一起,修正函数调用地址与全局符号,最终输出操作系统可直接加载运行的二进制可执行文件(ELF 或 PE 格式)。
一旦编译链接完成,生成的二进制程序就不再需要任何编译器的参与。CPU直接从内存载入机器指令执行,没有额外软件层的翻译消耗,因此运行速度极快。但其代价是平台强相关性:在 x86_64 Linux 下编译出的程序无法直接放到 ARM 架构的 macOS 或 Windows 上运行,必须重新针对目标环境交叉编译。
2. Python的虚拟机解释流水线
Python为了追求开发效率与平台无关性,引入了解释器(最常见的为官方 CPython 实现)。当用户执行 python script.py 时,程序并没有被直接翻译成底层CPU机器码:
- 前端编译(Bytecode Compilation):CPython 首先在内存中对源码进行词法与语法分析,将其翻译为一种更紧凑、专为虚拟机设计的中间指令序列——字节码(Bytecode)。如果在磁盘上发现了
__pycache__目录,解释器会生成或加载.pyc文件以跳过重复解析。 - 虚拟机解释循环(PVM Evaluation Loop):Python虚拟机(Python Virtual Machine)读取字节码序列,通过一个巨大的指令分发循环(即核心 evaluation loop),逐条读取字节码指令(如
LOAD_FAST、BINARY_OP、STORE_NAME),并在宿主机器上调用对应的C函数来模拟执行。
在整个运行周期中,Python代码始终处于虚拟机的“沙盒监督”之下。虚拟机负责内存分配、对象销毁和异常捕获。这种架构赋予了 Python 极高的跨平台能力——同一份源码可以在任何安装了相应 Python 解释器的平台上无缝执行,但由于每一条字节码都需要由虚拟机分发、类型判断和解包,带来了显著的运行时抽象开销。
二、静态类型与动态类型:内存模型与类型绑定的本质
“类型”究竟依附在“变量”上,还是依附在“内存中的对象”上?这是区分静态类型与动态类型的核心基准。
1. C语言的静态类型模型:类型约束内存槽位
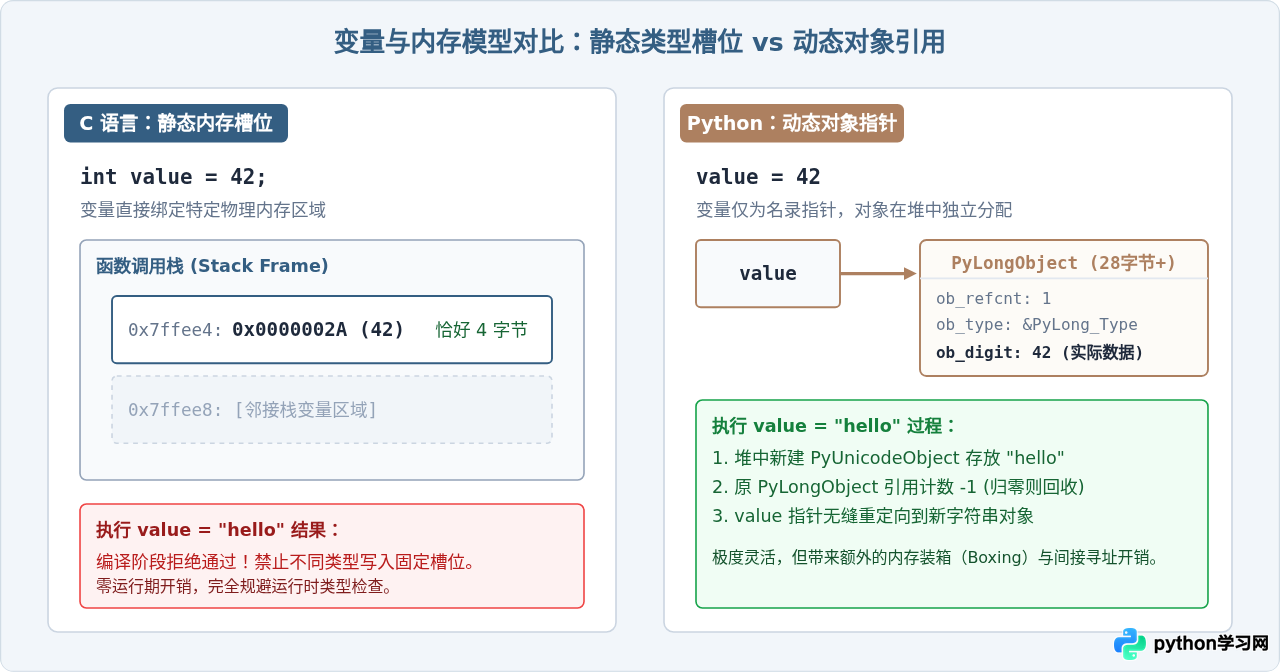
在C语言中,类型是绑定在变量名所对应的内存空间上的。在源码中书写 int count = 100; 时,程序员正在向编译器下达明确指令:在当前栈帧或全局数据区划出正好4个字节的连续内存空间,并将这片空间的地址命名为 count。
// C语言示例:静态类型与编译期限制
#include <stdio.h>

int main(void) {
    int value = 42;       // 明确占用4字节空间
    printf("Value: %d\n", value);

    // 下面这行代码会导致编译错误:
    // value = "Hello World";
    // 错误信息:warning/error: assignment makes integer from pointer without a cast
    return 0;
}
在编译期间,编译器会严格检查对 value 的所有操作。如果试图将一个字符串指针赋值给 int 变量,编译器在构建阶段直接拒绝通过。由于类型信息已经在编译期完成了验证,生成的机器码中根本不需要包含任何“这个数据当前是什么类型”的元数据标签,CPU直接把内存中的4个字节按补码整数进行加减运算。这种机制被称为零运行时开销抽象。
2. Python的动态类型模型:变量只是万能标签
在Python中,变量自身没有任何类型,类型完完全全保存在堆内存的对象内部。在Python中书写 value = 42 时,发生的操作完全不同:
- 解释器在堆内存中动态分配一个完整的整数对象(在CPython底层是一个
PyLongObject结构体)。 - 该结构体除了包含数值
42,还包含头部信息:引用计数(ob_refcnt)和类型指针(ob_type)。 value这个名字仅仅是一个指针,指向了这个堆对象的内存首地址。
# Python示例:动态类型与运行时对象替换
value = 42               # value 指向一个 PyLongObject 对象
print(type(value), value) # 输出: <class 'int'> 42

value = "Hello World"     # value 指针被重新指向一个 PyUnicodeObject 对象
print(type(value), value) # 输出: <class 'str'> Hello World
在随后执行 value = "Hello World" 时,Python无需通知任何编译器。它直接在堆上新建一个字符串对象,把变量 value 重新指向这个新对象,原整数对象的引用计数减1。类型检查被推迟到了具体的运算瞬间——如果此时执行 value + 10,解释器必须在运行时读取 value 指针所指向对象的 ob_type,发现字符串类型没有定义与整数相加的规则,随后立即抛出 TypeError。
三、开发与排查流程:错误暴露时机与生命周期体验
执行模式与类型系统的差异,最终会直接投射在工程师日常编码、排查与调试的具体步骤中。两种语言展现了截然不同的开发闭环。
1. C语言的开发排查步骤
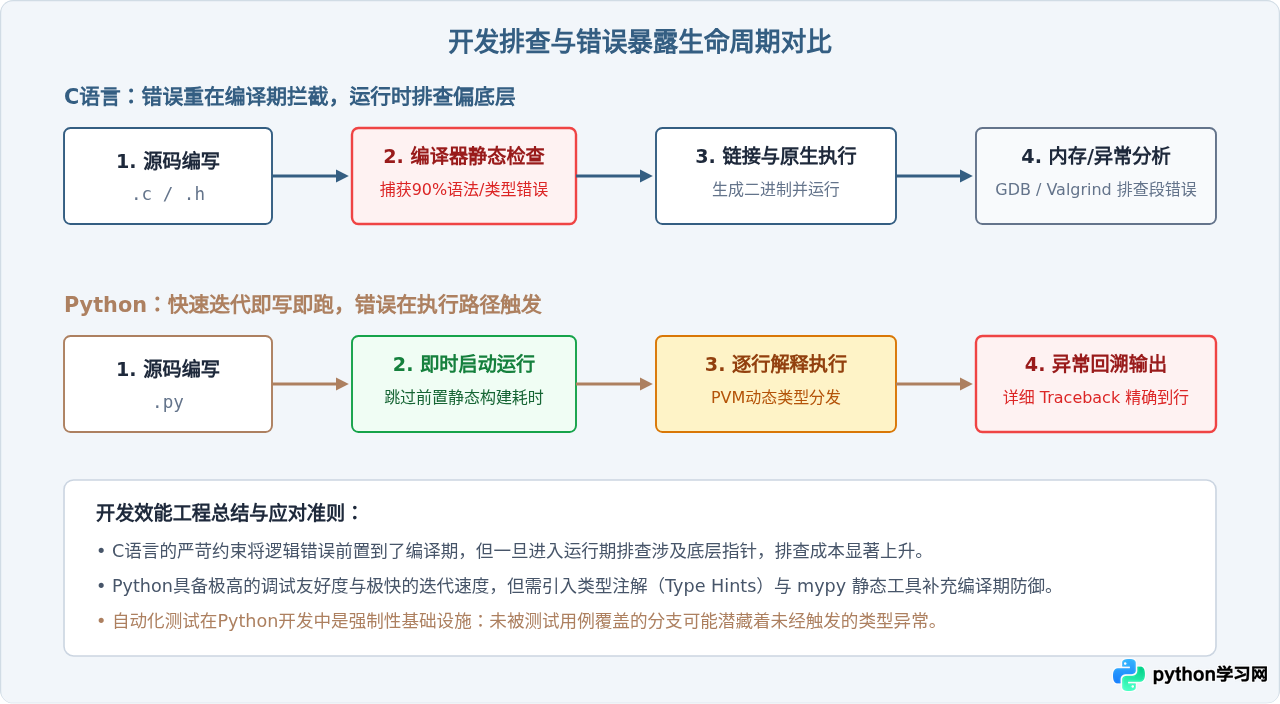
- 编写与编译阶段:通过
gcc -Wall -Wextra main.c -o main进行编译。绝大部分低级拼写错误、类型不兼容、函数参数不匹配都会在这个阶段被编译器捕获并拦截。 - 链接阶段:如果引入了第三方库或多模块开发,链接器会检查未定义的符号(
undefined reference)。 - 运行与内存排查阶段:编译通过后的程序以极高速度运行。然而,一旦出现数组越界访问、野指针解引用或内存泄漏,操作系统会直接发送
SIGSEGV信号,报出令初学者困惑的Segmentation fault (core dumped)。开发者需要依赖外部调试器(如 GDB)或内存检测工具(如 Valgrind、AddressSanitizer)进行堆栈回溯和逆向分析。
2. Python的开发排查步骤
- 编写与即时启动阶段:直接通过终端运行
python main.py。无需等待漫长的工程构建链路,修改脚本后能立即看到更新。 - 运行期动态排查阶段:由于缺乏编译期的静态强制检查,如果代码中存在深层分支内的拼写错误或类型错配,程序在跑进该分支之前不会给出任何警告。当程序走到错误分支时,虚拟机会立即暂停执行,打印出格式清晰且包含完整调用层级的
Traceback,精确标明出错文件、代码行号和异常类型(如AttributeError、TypeError)。 - 内存回收自动化:Python开发者无需手动调用
free(),垃圾回收器(引用计数结合循环分代GC)会在后台自动清理不可达对象,大幅减少了野指针和空悬指针问题。
四、核心指标对比与现代工程协同
在厘清了两者的底层机制之后,我们可以在同一张全景图谱中对它们的核心特性进行系统化对照:
| 对比维度 | C 语言 | Python |
|---|---|---|
| 核心执行范式 | 编译型:静态转换为目标平台机器码 | 解释型:转换为字节码并在虚拟机(PVM)上运行 |
| 类型系统 | 静态显式类型(编译期完成类型校验与绑定) | 动态强类型(运行期在对象内部保存类型信息) |
| 内存管理 | 手动管理(malloc / free、栈帧自动收缩) |
全自动垃圾回收(引用计数 + 分代循环垃圾回收) |
| 执行性能 | 极高(直接执行原生硬件指令,可做激进编译器优化) | 较低(虚拟机解包、对象装箱、动态类型查表开销) |
| 开发迭代效率 | 较慢(需要完整的头文件维护、编译构建与链接) | 极快(即写即测,代码行数通常只有C的 1/5 至 1/10) |
| 并发模型 | 原生操作系统线程,共享内存,需手动互斥锁控制 | CPython 具备全局解释器锁(GIL),计算密集多线程受限 |
| 硬件操作权限 | 可直接操作任意物理内存地址、寄存器与位字段 | 无法直接进行裸指针操作,必须借助外部C扩展接口 |
| 跨平台方式 | 源码跨平台(不同操作系统架构需重新编译目标文件) | 字节码与解释器跨平台(同一份源码随处运行) |
现代工业界的协同架构:以Python为外壳,以C语言为引擎
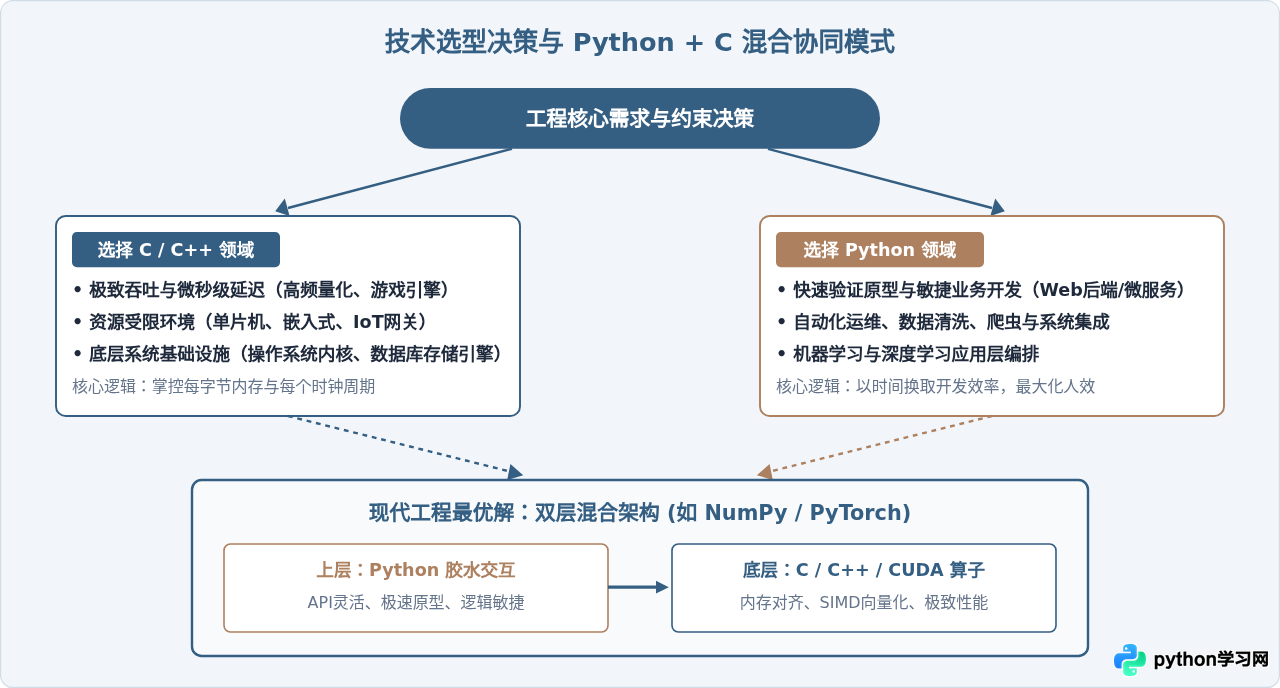
在现代软件工程中,C语言与Python并不是水火不容的替代关系,而是形成了极佳的共生架构。当下主流的数据科学库与人工智能框架,几乎全部采用了“双层架构”:
- 顶层编排(Python层):负责提供优雅灵活的面向对象接口、胶水逻辑、参数解析和快速的原型验证。
- 底层计算核心(C/C++底层):负责高密集度的矩阵运算、图像解码、网络I/O驱动和SIMD向量加速(例如 NumPy、PyTorch 底层由 C/C++/CUDA 编写)。
借助 Python 的 ctypes 模块、CFFI 或直接编写 CPython C-API 扩展,开发者能够用 C 语言处理计算密集型热点代码,再暴露给 Python 调用,从而兼得极致的运行性能与无与伦比的开发效率。
五、总结
C语言与Python并非简单的“快与慢”之争,而是计算机系统层级分工的必然结果。C语言通过编译型和静态类型设计,把控制权与责任毫无保留地交给了开发者,换取的是对底层硬件的极限操纵与零抽象开销;Python则通过解释型和动态类型机制,把类型判断与资源管理的繁重琐事封装到了虚拟机内部,换取的是极低的认知负担与成倍提升的工程产出速度。理解两者在执行路径与内存布局上的本质差异,不仅有助于消除语言选择时的摇摆与偏见,更能帮助开发者在面对高并发、高性能或复杂业务系统时,作出最清晰、最理性的架构决策。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









