

Python列表切片是深拷贝还是浅拷贝?

b = a[:] 或 b = a[1:4])是标准的浅拷贝(Shallow Copy)。切片会创建一个全新的外层列表容器对象,但新列表内部各个索引位置存储的,仅仅是原列表中对应元素的指针引用,并不会递归克隆元素内部的数据。
日常编写 Python 代码时,许多初学者经常会用到类似 new_list = old_list[:] 的语法来“复制”一个列表。在不少简单场景下,修改 new_list 中的元素似乎完全不会影响 old_list,这往往让人产生一种“切片就是完全独立的深拷贝”的错觉。然而,一旦列表中嵌套了子列表、字典等可变容器,或者调用了内部可变对象的方法时,原本预期的相互隔离便会瞬间失效。要彻底搞清楚这一现象,我们需要从 Python 的底层内存引用机制着手分析。
一、为什么切片是浅拷贝:内存引用模型
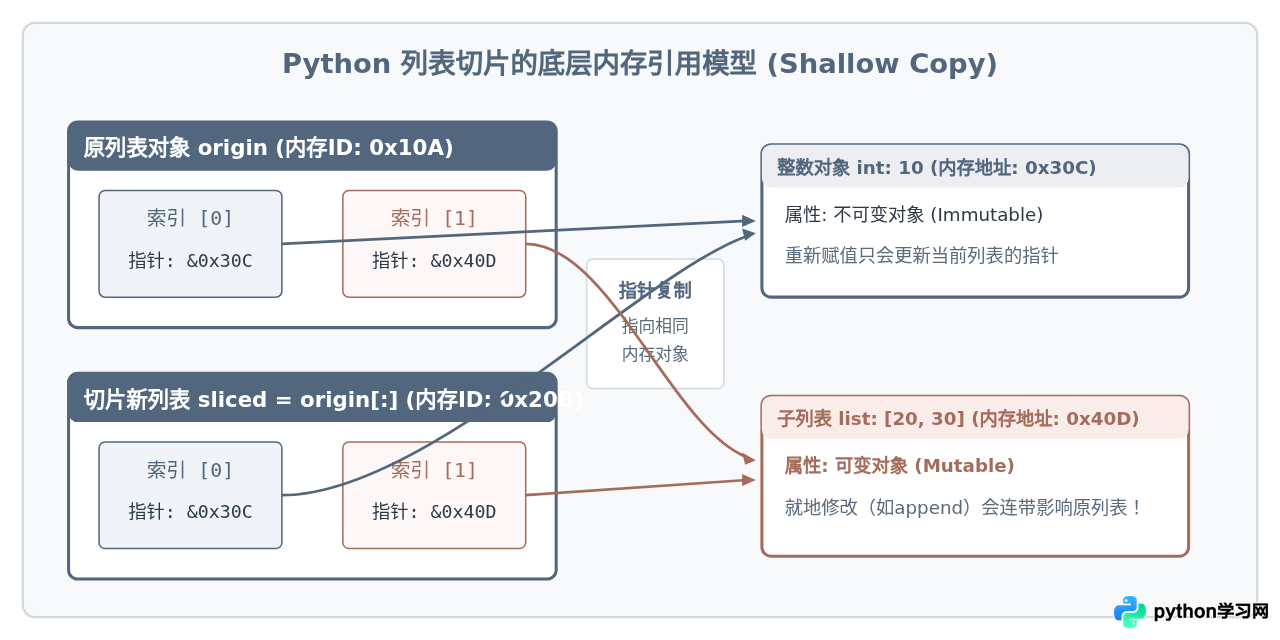
Python 中的变量并不是容纳数值的“格子”,而是贴在内存对象上的“标签”(即指针引用)。列表本身则是一个连续存放指针地址的容器对象。当你对一个列表执行切片操作时,Python 的底层机制可以概括为两件事:
- 在内存中开辟一块新的空间,创建一个全新的列表容器对象,因而切片后列表的
id与原列表必定不同。 - 将切片范围内的每一个元素指针逐一复制到新容器的相应插槽中。换言之,新列表与原列表在对应位置上指向的是内存中的同一个对象实体。
这种“只复制容器外壳、共享底层元素”的行为模式,正是计算机科学中对浅拷贝的标准定义。
二、四步实测验证:揭示切片的真实属性
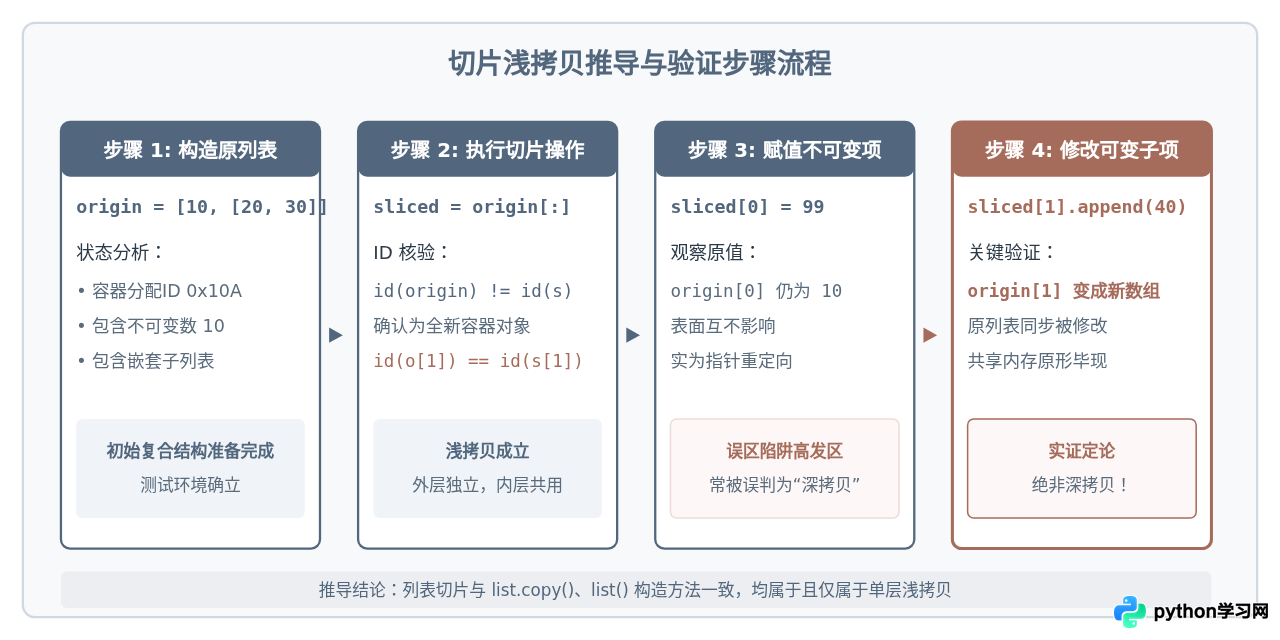
为了直观验证切片到底属于浅拷贝还是深拷贝,我们通过一个完整的四步推导演示。代码中构造一个既包含不可变对象(整数),又包含可变对象(嵌套子列表)的复合列表进行对比:
# 第一步:构建原列表,包含数字与子列表
origin = [10, [20, 30]]

# 第二步:通过切片生成新列表
sliced = origin[:]

# 验证外层容器是否是不同对象
print("容器ID相同吗?", id(origin) == id(sliced))  # 输出: False (生成了新容器)
print("元素ID相同吗?", id(origin[1]) == id(sliced[1]))  # 输出: True (元素引用完全共享)

# 第三步:修改新列表的一阶不可变元素
sliced[0] = 99
print("origin[0]:", origin[0])  # 输出: 10 (原列表不受影响,看似独立)

# 第四步:修改新列表中的嵌套可变对象
sliced[1].append(40)
print("origin[1]:", origin[1])  # 输出: [20, 30, 40] (原列表同步改变,浅拷贝本质暴露!)
通过上述四步,我们可以清晰地理顺逻辑链条:
- 为什么在第 3 步中原列表没变?因为
10是不可变对象。执行sliced[0] = 99时,并没有修改内存中10这个实体,而是将sliced[0]重新绑定到了新创建的整数对象99的地址上。origin[0]的指针未被改动,依然指向10。这绝非“深拷贝”带来的数据独立,而是“不可变对象的重新绑定”造成的表面现象。 - 为什么在第 4 步中原列表被篡改?因为
origin[1]和sliced[1]指向的是同一个可变子列表0x40D。调用append(40)是就地修改(In-place mutation),它直接改写了该内存地址上的内容。无论从origin[1]还是sliced[1]访问,看到的都是更新后的列表。
三、横向对比:直接赋值、切片浅拷贝与深拷贝的区别
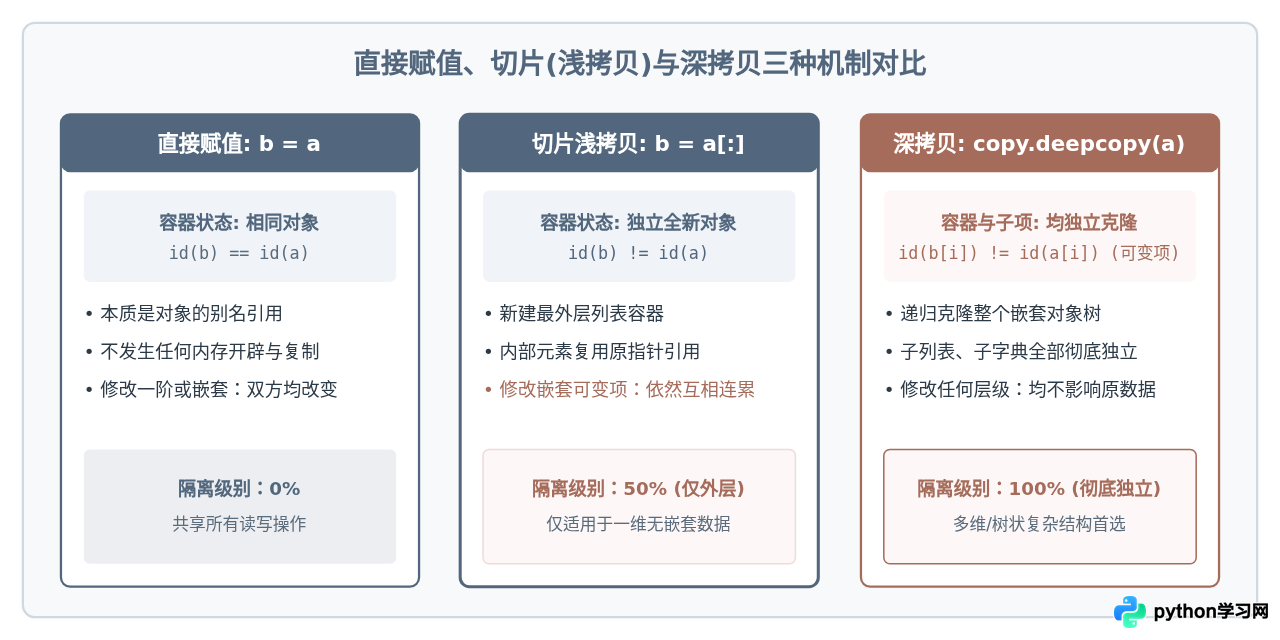
在 Python 中获取一个“新”列表通常有三种常见方式。理解它们在内存维度的区别,是写出健壮代码的基础:
| 复制方式 | 代表语法 | 外层容器对象 | 内部元素对象 | 适用场景与性能特点 |
|---|---|---|---|---|
| 引用赋值(别名) | b = a |
完全相同(共享同一个 ID) | 完全相同 | 无任何拷贝开销,常用于单纯传递参数或重命名别名。任何修改均全局同步。 |
| 切片浅拷贝 | b = a[:] 或 b = a.copy() |
新建独立容器(ID 不同) | 共享原对象引用 | 底层基于 C 语言连续内存指针拷贝,速度极快。适合一维纯标量(数字、字符串)列表。 |
| 深拷贝 | import copy |
新建独立容器(ID 不同) | 递归克隆所有可变层级 | 彻底物理隔离。由于需要递归遍历对象树并维护内部字典记录引用,性能开销最大。 |
四、实际应用与典型避坑指南
1. 二维矩阵与嵌套结构拷贝陷阱
工程中最常踩的一个陷阱莫过于处理二维网格或矩阵:
# 错误示范:试图用切片复制二维网格进行算法探索
grid = [[0, 0], [1, 1]]
grid_copy = grid[:]  # 切片只是浅拷贝!

# 试图在新网格中标记走过的路径
grid_copy[0][0] = 8

# 灾难发生:原网格 grid[0][0] 也变成了 8!
print(grid)  # 输出: [[8, 0], [1, 1]]
在这个场景中,切片拷贝由于没有复制子列表,导致算法回溯或路径探索的现场直接被污染。要安全复制此类嵌套结构,正确的方案是使用 copy.deepcopy():
import copy

grid = [[0, 0], [1, 1]]
grid_safe = copy.deepcopy(grid)
grid_safe[0][0] = 8
print(grid[0][0]) # 输出 0,原数据安全隔离对于固定二维嵌套列表,使用 [row[:] for row in matrix] 可以完成第二层的浅拷贝,能够防范两层结构的修改。但如果嵌套深度达到三层、或内部夹杂了字典、类实例等对象,推导式同样会漏掉深层引用。遇到复杂层级时,应无条件优先使用标准库的 copy.deepcopy()。
2. 选型决策:什么时候该用切片?
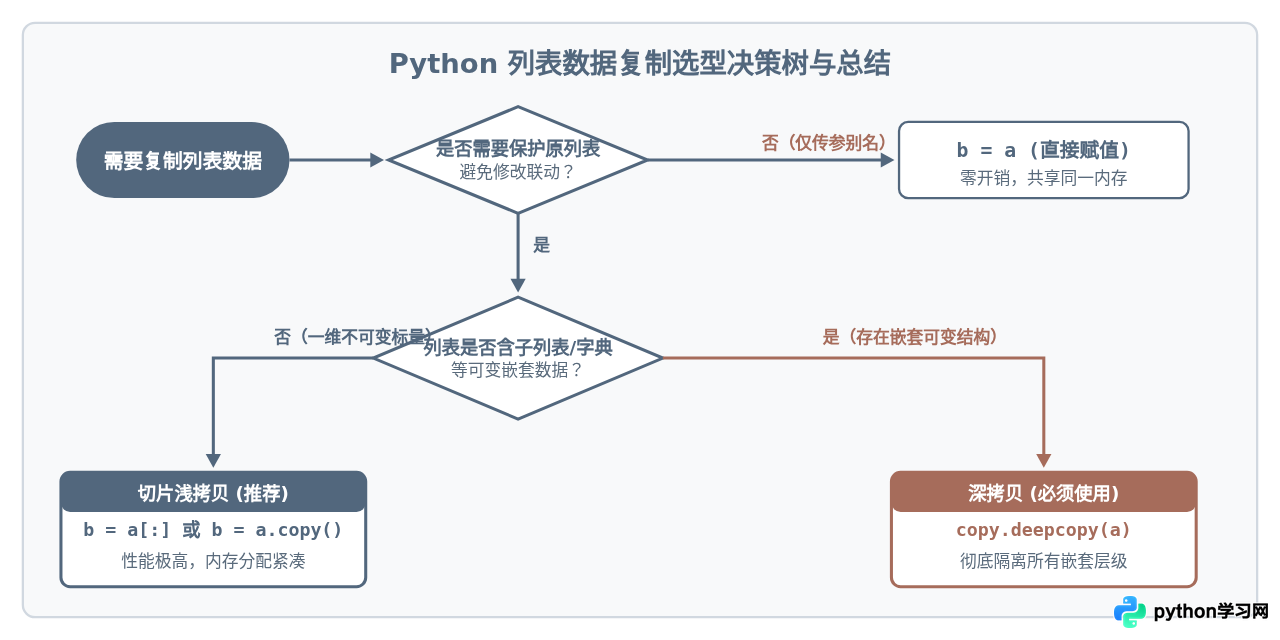
虽然切片不是深拷贝,但并不意味着切片应该被弃用。相反,在绝大多数 Python 生产代码中,列表切片(或 list.copy())的出现频率远高于 deepcopy:
- 适合切片的高频场景:列表只存放不可变标量(纯整数、浮点数、字符串、元组或布尔值);或者明确只需要截取子序列、反转列表(如
a[::-1])、清空容器(a[:] = [])等。此时切片效率最高,极省内存与 CPU。 - 必须深拷贝的场景:数据结构为树、图、二维及以上矩阵,或者列表元素为字典(如后端 API 返回的 JSON 数据列表)、自定义模型对象实例等。
五、全文要点总结
回答“Python列表切片是深拷贝还是浅拷贝”这一问题,可以概括为以下三条准则:
- 性质定论:列表切片毫无疑问是浅拷贝。它创建了外层独立容器,内部元素全部保持原始引用。
- 表象误区:一维标量列表切片后互不影响,是因为整数、浮点数、字符串等属于不可变对象,对切片赋值触发了指针重新绑定,而非真正的数据物理克隆。
- 工程建议:在处理一维扁平数据时,切片
a[:]是最高效简洁的选择;而在面对多维矩阵、树状结构、嵌套字典或对象集合时,必须显式引入copy.deepcopy()来确保逻辑安全。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









