

Python二维数组怎么实现?列表嵌套与NumPy矩阵操作详解
详解Python二维数组的两种核心实现方式:从标准库内置的列表嵌套创建、索引、列提取与浅拷贝引用陷阱,到科学计算库NumPy中ndarray矩阵的高效切片、广播运算与性能对比,提供严谨清晰的避坑指南与选型依据。
一、Python 原生实现:列表嵌套(Nested Lists)
列表嵌套即在一个外层列表中包含多个内层列表。外层的每一个元素代表矩阵的一“行”,内层列表包含该行各列的具体元素。
1. 直接字面量声明
当网格的初始数据已知且规模较小时,可以直接用方括号书写二维列表:
# 定义一个 3 行 3 列的二维列表
matrix = [
    [1, 2, 3],
    [4, 5, 6],
    [7, 8, 9]
]
2. 动态初始化与致命陷阱:乘号复制 vs 列表推导式
在实际开发中,我们常需要预分配指定行数(rows)与列数(cols)的全 0 二维列表。很多初学者会直觉地写出 [[0] * cols] * rows,这种写法隐藏着严重的引用共享 Bug。
* 操作符对列表进行复制时执行的是浅拷贝(Shallow Copy)。使用 [[0] * 3] * 3 时,外层列表只是将同一个内部子列表对象的内存引用复制了 3 次。一旦修改其中某一行的一个元素,其他所有行对应的列都会同时改变。
下面来看具体代码验证:
# 【错误写法】共享内存引用
bad_matrix = [[0] * 3] * 3
bad_matrix[0][0] = 1
print("错误写法输出:", bad_matrix)
# 实际输出: [[1, 0, 0], [1, 0, 0], [1, 0, 0]] —— 所有行都被篡改!

# 【正确写法】列表推导式(独立生成子对象)
rows, cols = 3, 3
good_matrix = [[0 for _ in range(cols)] for _ in range(rows)]
good_matrix[0][0] = 1
print("正确写法输出:", good_matrix)
# 实际输出: [[1, 0, 0], [0, 0, 0], [0, 0, 0]] —— 仅第一行被修改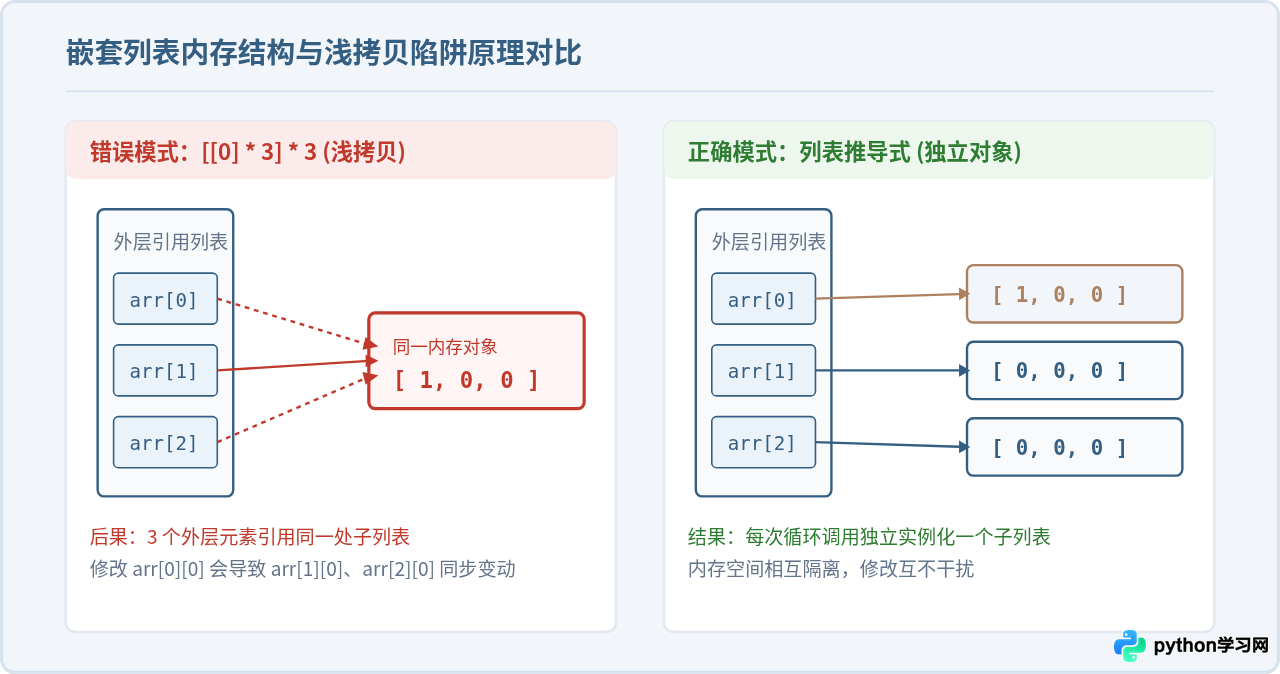
3. 访问与行列遍历
在嵌套列表中定位元素,采用两次方括号索引:第一个方括号指定行索引,第二个方括号指定列索引,形式为 matrix[row][col]。
grid = [
    [10, 20, 30],
    [40, 50, 60]
]

# 访问第 0 行第 2 列
val = grid[0][2]  # 结果: 30

# 修改第 1 行第 1 列
grid[1][1] = 99

# 双重循环按行按列遍历
for r_idx, row in enumerate(grid):
    for c_idx, item in enumerate(row):
        print(f"位置 ({r_idx}, {c_idx}) = {item}")
4. 原生列表提取“整列”的正确方法
很多其他语言使用者常试图使用 grid[:][1] 或 grid[:, 1] 来提取某一列。但在 Python 原生列表中:
grid[:, 1]会直接抛出TypeError: list indices must be integers or slices, not tuple错误;grid[:]只是浅拷贝了整个外层列表,随后的[1]仅取出了第 1 行,并非提取第 1 列。
在原生列表中提取第 col_idx 列,需要借助列表推导式遍历提取每一行该位置的值:
# 提取第 1 列的所有元素形成新列表
col_1 = [row[1] for row in grid]
print("第1列内容:", col_1)  # [20, 99]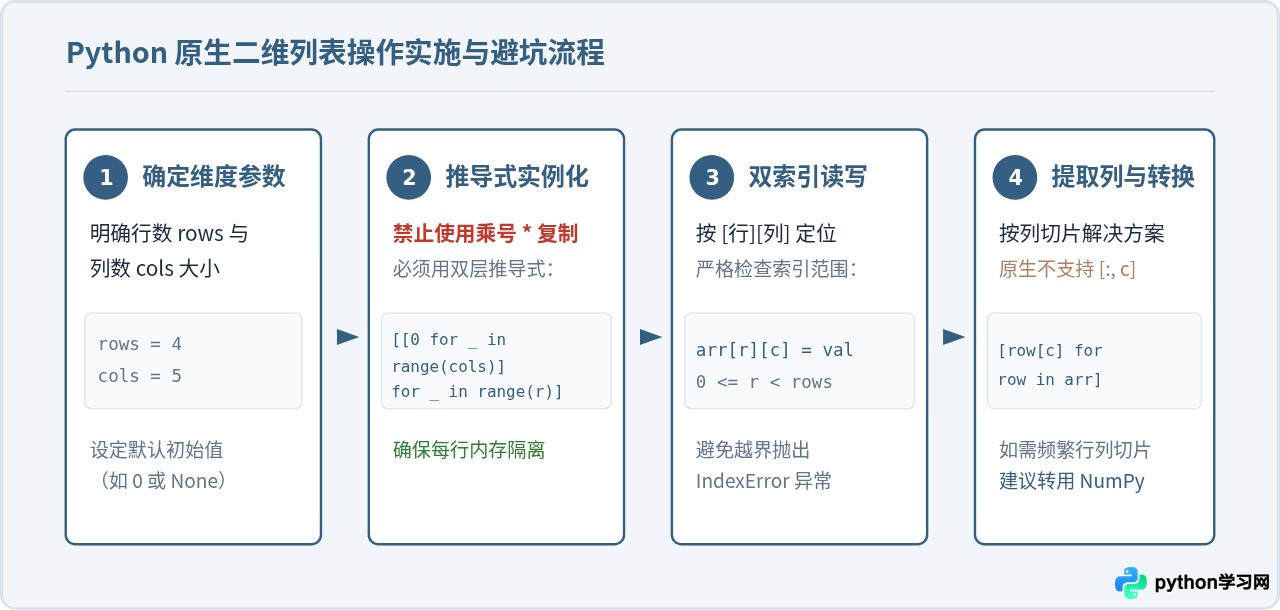
二、专业科学计算:NumPy 矩阵与二维数组
在数据分析、机器学习或密集矩阵计算场景下,Python 原生嵌套列表存在明显的性能瓶颈与语法局限:由于列表存储的是各个对象的指针,内存不连续,无法利用 CPU 缓存加速与 SIMD 指令集;同时缺乏对矩阵切片与线性代数计算的原生支持。此时应当使用专门的科学计算库 numpy。
1. 环境准备与基础创建
首先确保已安装 NumPy(通常执行 pip install numpy),在脚本中导入约定别名 np:
import numpy as np

# 1. 由原生列表直接转化为二维 ndarray
arr_from_list = np.array([
    [1, 2, 3],
    [4, 5, 6]
], dtype=int)

# 2. 快速生成全 0、全 1 或指定常数矩阵
zeros_mat = np.zeros((3, 4), dtype=float)   # 3行4列全0浮点矩阵
ones_mat = np.ones((2, 3), dtype=int)        # 2行3列全1整型矩阵
full_mat = np.full((2, 2), fill_value=7)     # 2行2列全部为7

# 3. 使用 arange 结合 reshape 快速重塑二维形状
grid_seq = np.arange(12).reshape(3, 4)       # 生成 0~11 并排列为 3行4列
2. 二维索引与强大的切片语法
与原生列表的 [row][col] 链式访问不同,NumPy 采用单个方括号并以逗号分隔各维度索引:arr[row_spec, col_spec]。这赋予了其高效切取行、列、子矩阵的能力,且切片产生的是数据视图(View),无额外内存拷贝开销。
mat = np.array([
    [10, 11, 12, 13],
    [20, 21, 22, 23],
    [30, 31, 32, 33],
    [40, 41, 42, 43]
])

# 提取单个元素
print(mat[2, 3])         # 输出: 33 (第2行第3列)

# 提取整行与整列(冒号代表选取该轴全量元素)
print(mat[1, :])         # 输出第 1 行: [20 21 22 23]
print(mat[:, 2])         # 输出第 2 列: [12 22 32 42]

# 提取子矩阵区域:行区间 [1:3],列区间 [1:4]
sub_mat = mat[1:3, 1:4]
# 截取结果:
# [[21, 22, 23],
#  [31, 32, 33]]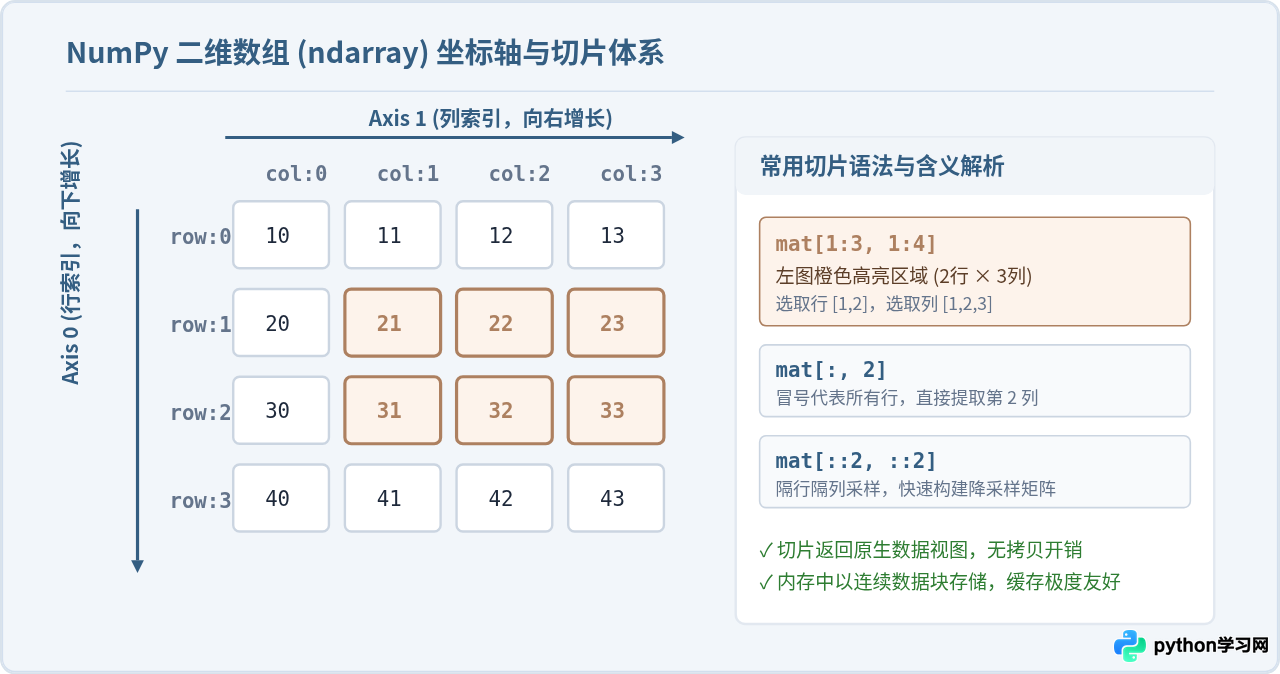
3. 向量化运算与广播机制(Broadcasting)
在原生列表中,若要使二维列表的每个元素都加上 10,必须编写双重 for 循环;而在 NumPy 中,数学运算符会自动应用于数组中的每个元素,这种特性被称为向量化计算(Vectorization)。
a = np.array([[1, 2], [3, 4]])
b = np.array([[10, 20], [30, 40]])

# 元素级对应相加、相乘
add_result = a + b    # [[11, 22], [33, 44]]
mul_result = a * b    # [[10, 40], [90, 160]] —— 注意:这是元素对应乘法

# 广播机制:标量或一维数组与二维矩阵自动匹配扩展
broadcast_res = a + 100
# 结果: [[101, 102], [103, 104]]
4. 线性代数与矩阵乘法
在算法和数学计算中,严格的“矩阵相乘”(行乘列点积求和)不同于上述元素级乘法。Python 3.5 引入了 @ 操作符作为矩阵乘法专有符号:
m1 = np.array([
    [1, 2],
    [3, 4]
])
m2 = np.array([
    [5, 6],
    [7, 8]
])

# 矩阵乘法(点积)
matmul_res = m1 @ m2          # 等价于 np.dot(m1, m2) 或 np.matmul(m1, m2)
# 输出:
# [[19, 22],
#  [43, 50]]

# 矩阵转置(行列互换)
transpose_res = m1.T
# 输出:
# [[1, 3],
#  [2, 4]]
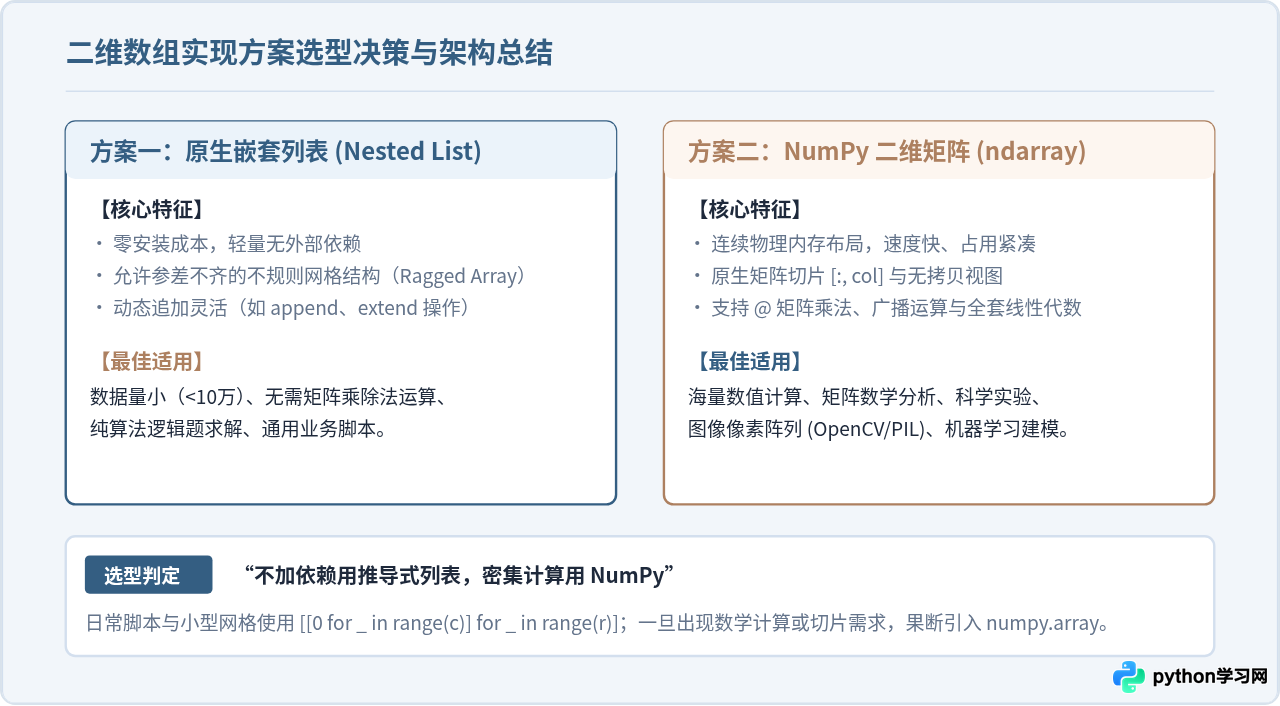
三、方案对比与技术选型指南
在工程实践中,选择使用原生嵌套列表还是 NumPy 矩阵,主要取决于数据特征、运行环境以及对性能的敏感度。
| 对比维度 | 原生嵌套列表 (Nested List) | NumPy 二维数组 (ndarray) |
|---|---|---|
| 外部依赖 | 标准库自带,开箱即用,零第三方依赖 | 需要安装额外依赖包(NumPy) |
| 底层存储结构 | 指针链表/指针数组,内层列表分布在不连续堆内存中 | 底层连续 C 数组存储,紧凑且缓存命中率高 |
| 数据类型支持 | 异构支持:不同行长度可不同,各元素类型可不同 | 同构限制:必须为规则矩形矩阵,所有元素同一类型 |
| 切片与索引 | 仅支持行切片 arr[r];列切片需手动写循环推导 |
原生多维切片语法 arr[:, c]、arr[1:3, 2:5] |
| 计算性能 | Python 字节码解释执行,千万级运算较慢 | 底层 C/Fortran 编译优化,向量化运算快数倍至数十倍 |
| 典型应用场景 | 算法题解 (LeetCode)、轻量配置网格、小型动态树/图 | 图像处理、物理仿真、特征工程、机器学习与数据分析 |
四、常见疑难问题解答
1. 为什么有时候打印原生列表看不出浅拷贝问题,一赋值就出错?
执行 m = [[0] * 3] * 3 后,各个位置的值都是 0,打印结果为 [[0, 0, 0], [0, 0, 0], [0, 0, 0]],从表面上看完全正常。但只要调用内置函数 id() 检查子列表的唯一内存标识,就会发现真相:
m = [[0] * 3] * 3
print(id(m[0]) == id(m[1]))  # 输出: True,说明第0行与第1行实际是同一个对象

good = [[0 for _ in range(3)] for _ in range(3)]
print(id(good[0]) == id(good[1]))  # 输出: False,说明每一行均拥有独立的物理内存
2. 原生嵌套列表如何快速转置?
利用 Python 内置的 zip() 函数与解包操作符 *,可以单行实现二维列表的行与列互换:
matrix = [
    [1, 2, 3],
    [4, 5, 6]
]
transposed = [list(col) for col in zip(*matrix)]
# 输出: [[1, 4], [2, 5], [3, 6]]
3. NumPy 数组和原生嵌套列表之间如何相互转换?
两者可以随时通过无损函数无缝转换:
- 嵌套列表转 NumPy 数组:直接传入构造器
np.array(nested_list)。 - NumPy 数组转回 Python 原生列表:调用
.tolist()方法,例如arr.tolist(),该方法会将内部的 NumPy 标量完全转换为原生 Python 基础类型。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









