

Python利用split和partition方法按分隔符截取字符串
深入解析Python中利用split和partition方法按分隔符截取字符串的实用技巧与底层机制,对比两者在返回值结构、分隔符保留、未匹配处理上的核心差异,帮助开发者准确选择最适合的字符串处理方法。
在 Python 文本处理中,按指定分隔符截取字符串是最基础也是最频繁的操作。无论是解析 URL、提取文件后缀,还是清洗结构化配置行,核心任务都是将文本在特定标识处切开。Python 标准库内置了两个专门用于此场景的字符串方法:split() 与 partition()。简而言之,当需要把一段文本按分隔符完全切碎为变长列表、或者只关注切开后的多个片段时,split() 是最直接的工具;而当需要围绕某一个关键分隔符把字符串拆分为“前缀、分隔符、后缀”三部分,尤其是需要安全进行变量解包时,partition() 具备更高的确定性与表达力。本文将深入阐明这两个方法的技术特性、参数机制与实际选型差异。
一、split() 方法的核心机制与切分控制
str.split(sep=None, maxsplit=-1) 的主要职责是将字符串按指定的分隔符拆分,返回一个由子字符串组成的列表(list)。在默认状态下,匹配到的分隔符本身会被直接丢弃,不保留在返回结果中。
1. 默认空白分割与显式指定字符的区别
许多开发者在刚接触 Python 时容易忽略 sep=None 与 sep=' ' 的显著行为差异:
sep=None(默认行为):Python 会把所有连续的空白字符(包括空格、制表符\t、换行符\n、回车符\r)视作一个单一的分隔符整体,并且会自动剔除字符串首尾的所有空白,返回的列表中绝不会包含空字符串""。sep=' '(显式空格):Python 将严格按照单个空格字符进行物理切分。如果文本中存在连续两个空格,中间就会生成一个空字符串项;如果文本开头或结尾有空格,切分后两端也会产生空字符串。
# 示例 1:默认参数与显式指定空格的区别
text = "  python   split   tutorial  "

print("text.split():", text.split())
# 示例输出: ['python', 'split', 'tutorial']

print("text.split(' '):", text.split(' '))
# 示例输出: ['', '', 'python', '', '', 'split', '', '', 'tutorial', '', '']
2. 使用 maxsplit 控制截取次数
maxsplit 参数用于指定最大切分次数。当传入正整数 N 时,切分操作在完成 N 次后立刻停止,剩余未处理的文本将作为最后一个元素完整保留在列表中。这在解析“前部分结构固定、后部分内容随意”的协议行或日志行时非常高效,无需将整行全部打散后再用 join 重新拼接。
# 示例 2:利用 maxsplit 保留剩余文本
log_entry = "2026-10-15:ERROR:disk capacity is over 90%:action required"

# 仅切分前 2 次,提取日期与日志级别,剩余部分保持完整
parts = log_entry.split(":", maxsplit=2)
print("parts:", parts)
# 示例输出: ['2026-10-15', 'ERROR', 'disk capacity is over 90%:action required']
print("列表长度:", len(parts))
# 示例输出: 3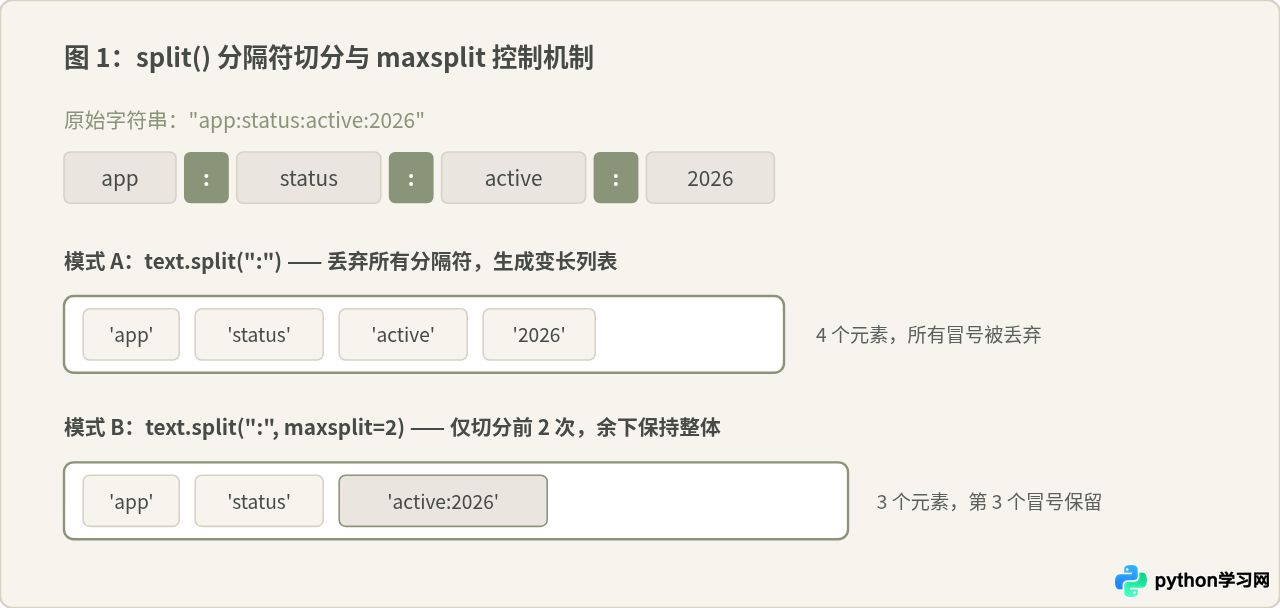
二、partition() 与 rpartition() 的固定三元拆分机制
与 split() 产生变长列表不同,str.partition(sep) 和 str.rpartition(sep) 遵循严格的“三段论”设计。它们永远返回一个长度恰好为 3 的元组(tuple),结构固定为 (head, sep, tail)。
1. partition 的核心工作逻辑
调用 partition(sep) 时,Python 从字符串左侧开始检索 sep:
- 命中分隔符:将第一个匹配项左侧的文本赋给
head,匹配到的分隔符自身赋给sep,右侧全部剩余文本赋给tail。 - 未命中分隔符:将原始字符串完整赋给
head,而sep与tail则均返回空字符串"",即返回(原字符串, "", "")。
2. rpartition 的反向检索逻辑
rpartition(sep) 从字符串右侧(末尾)开始检索第一个 sep。命中时同样返回 (head, sep, tail)。而在未命中分隔符时,它的兜底顺序与正向略有不同:它将 head 与 sep 置为空字符串 "",将原始字符串放在末尾的 tail,即返回 ("", "", 原字符串)。这种对称性确保了调用者无论使用哪种方向,只要判断中间的 sep 是否非空,就能立刻获知是否成功找到了分隔符。
# 示例 3:partition 与 rpartition 的三元元组输出
path = "archive/backup/2026/data.tar.gz"

# 从左向右找到第一个斜杠
print("path.partition('/'):", path.partition('/'))
# 示例输出: ('archive', '/', 'backup/2026/data.tar.gz')

# 从右向左找到最后一个点号
print("path.rpartition('.'):", path.rpartition('.'))
# 示例输出: ('archive/backup/2026/data.tar', '.', 'gz')

# 找不到分隔符时的表现
print("path.partition('@'):", path.partition('@'))
# 示例输出: ('archive/backup/2026/data.tar.gz', '', '')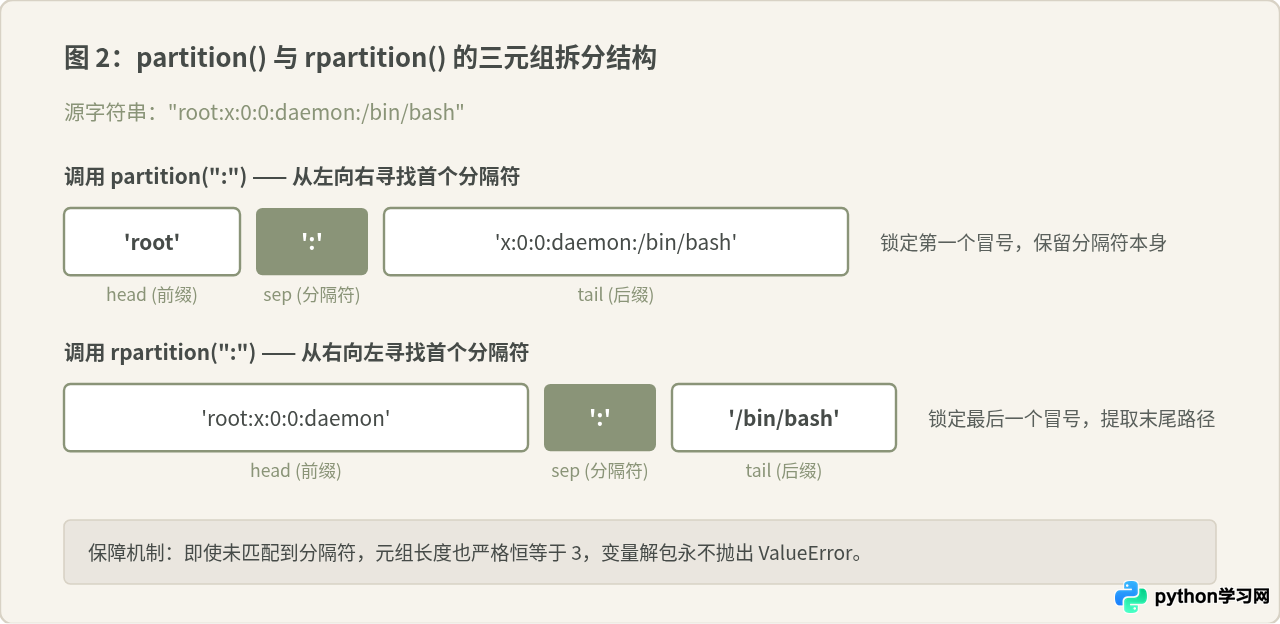
三、按分隔符截取字符串的标准处理流程
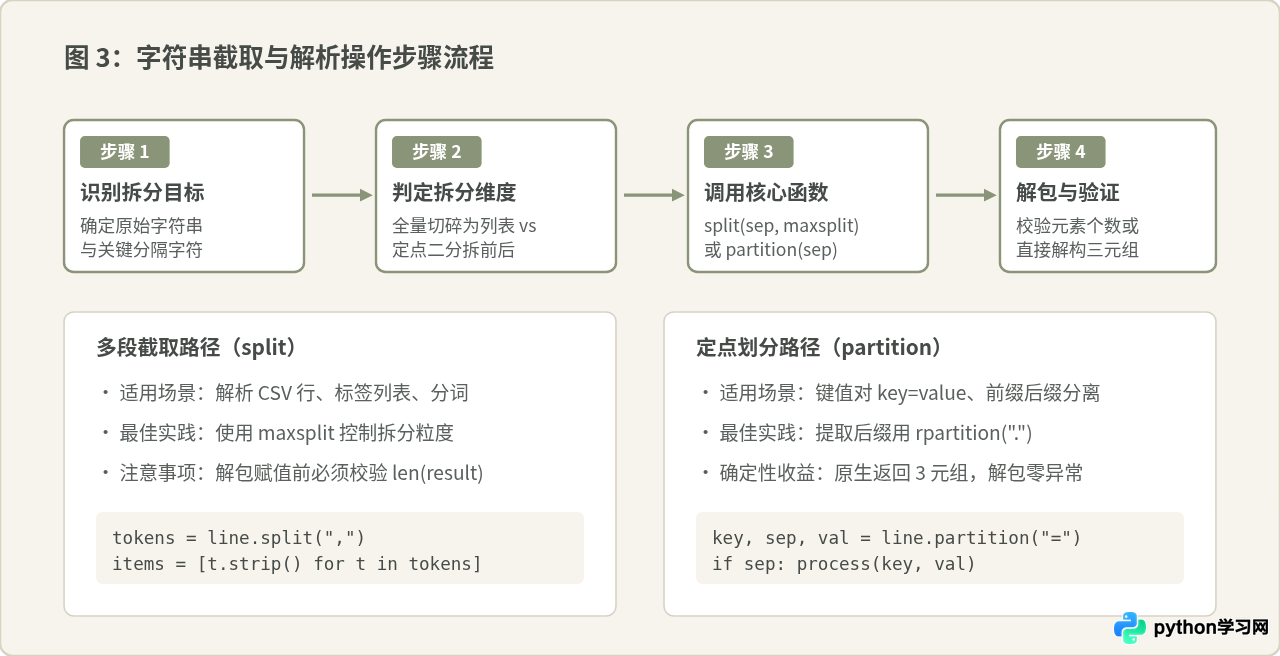
在实际编码过程中,面对一个包含分隔符的字符串,应该按照怎样的步骤进行处理?规范的操作路径通常包含四个环节:
- 明确拆分目的:是需要将所有片段取出(如逗号分隔的值),还是仅仅为了在首个或末尾标记处将字符串“一分为二”(如配置项
key=value或文件名取后缀)。 - 选择合适的方法:全量拆解选
split();定点二分选partition()或rpartition()。 - 设定边界参数:如果使用
split()且只需要前几个字段,务必指定maxsplit避免无谓开销;如果使用partition(),务必保证sep为非空字符串。 - 解包与有效性验证:对于
partition()可以直接解包为三个变量,通过中间的sep是否非空即可安全判断是否存在目标分隔符。
四、常见误区与容易混淆的认知辨析
在日常开发中,有些看似合理的写法实则隐藏着边界崩溃的风险。以下是针对 split 与 partition 的三个核心误区辨析:
误区 1:“解析 key=value 配置时,使用 split('=', 1) 就足够了”
这种说法在每行都严格包含等号的理想输入下确实有效,例如 key, val = "host=localhost".split("=", 1)。但是,一旦输入文本中有一行缺少等号(例如空行、注释行或损坏数据),split 只会返回包含 1 个元素的列表 ["host"]。此时直接进行双变量解包会立刻触发 Python 的致命异常:ValueError: not enough values to unpack (expected 2, got 1)。
相比之下,使用 key, sep, val = line.partition("=") 则永远安全。即便没有等号,它也会返回 ("host", "", "")。程序只需要通过 if sep: 判断是否成功切分,既保证了代码结构整洁,又避免了频繁使用 try...except ValueError 带来的控制流开销。
# 示例 4:配置行解包的安全性对比
line_without_equal = "invalid_config_line"

# 错误/高风险做法:
try:
    key, val = line_without_equal.split("=", 1)
except ValueError as err:
    print("split 解包失败:", err)
    # 示例输出: split 解包失败: not enough values to unpack (expected 2, got 1)

# 稳健做法:
key, sep, val = line_without_equal.partition("=")
if sep:
    print("解析成功:", key, val)
else:
    print("未包含分隔符,安全跳过或执行兜底逻辑:", key)
    # 示例输出: 未包含分隔符,安全跳过或执行兜底逻辑: invalid_config_line
误区 2:“partition 的 sep 可以传空字符串来按字符拆开”
有人误以为 partition('') 会像某些语言的 split 函数那样把第一个字符拆出来。在 Python 中,partition 和 split 一样,禁止传入空字符串作为分隔符。一旦传入 sep="",Python 会立刻抛出 ValueError: empty separator。如果需要提取首个字符,应直接使用切片 text[0] 与 text[1:]。
误区 3:“split 必须遍历全字符串,而 partition 性能一定更高”
这个结论依赖于具体参数。未指定 maxsplit 的 split() 确实必须通篇扫描整个字符串,寻找每一个出现的分隔符并分配新的列表元素;而 partition() 在找到第一个匹配项后就立即终止搜索,因此在长文本中定位单一分隔符时,partition() 确实具有更小的 CPU 与内存开销。但如果给 split() 显式指定了 maxsplit=1,其扫描行为也是在完成首次切分后即刻停止。两者的核心差距仍然在于数据结构的表达意图,而非单纯的微基准性能。
五、split 与 partition 特性对比与选型指南
为了帮助读者在不同业务场景中做出最合适的选择,下表对两组方法的关键属性进行了全面梳理:
| 对比维度 | str.split() / rsplit() | str.partition() / rpartition() |
|---|---|---|
| 返回值类型 | 列表(list[str]) |
三元元组(tuple[str, str, str]) |
| 返回值长度 | 变长(由匹配次数与 maxsplit 共同决定) |
固定恒等于 3 项 |
| 分隔符是否保留 | 默认丢弃,不出现在返回列表中 | 保留,作为元组的中间元素(第 2 项) |
| 未匹配分隔符时 | 返回包含原字符串的单元素列表 [原字符串] |
返回 (原串, "", "") 或 ("", "", 原串) |
| sep 缺省参数 | 允许 sep=None,自动折叠所有空白字符 |
必须显式传入非空字符串 sep |
| 解包安全性 | 变长列表直接解包易抛出 ValueError |
恒定 3 元组,解包绝对安全 |
| 典型适用场景 | 批量词频统计、全量 CSV 切分、日志分段提取 | 键值对提取、文件名与扩展名分离、协议头解析 |
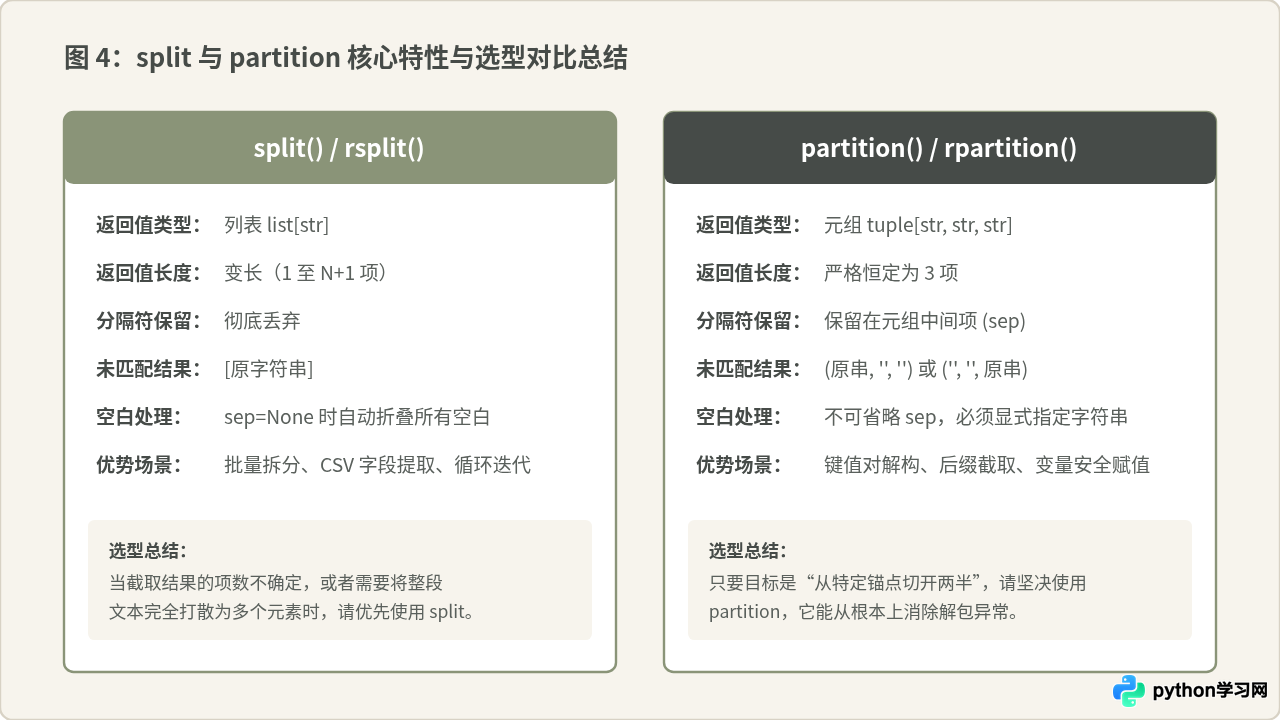
总结:截取字符串不是随意挑选一个名字更顺手的方法,而是取决于你对“返回值结构”与“异常容忍度”的设计预期。牢记两句话:变长打散、全量提取用 split;定点二分、安全解构用 partition。掌握这一原则,能够显著提升字符串清洗代码的健壮性与可读性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









