

Python is运算符底层原理:id()与对象引用
深入解析Python中is运算符的底层运行机制,结合id()内置函数、CPython内存模型与变量引用,厘清身份比较与值相等的本质区别。
在 Python 中,判断两个变量是否相等时,开发者常在 is 与 == 之间抉择。简而言之,== 是内容相等性比较,判定的是两个对象包含的数据是否一致;而 is 则是同一性(Identity)比较,判定两个引用是否指向内存中的同一个对象实体。is 的判定准则等价于比较二者的 id() 内存标识符是否完全相同。
一、Python 的对象引用机制与 id() 内置函数
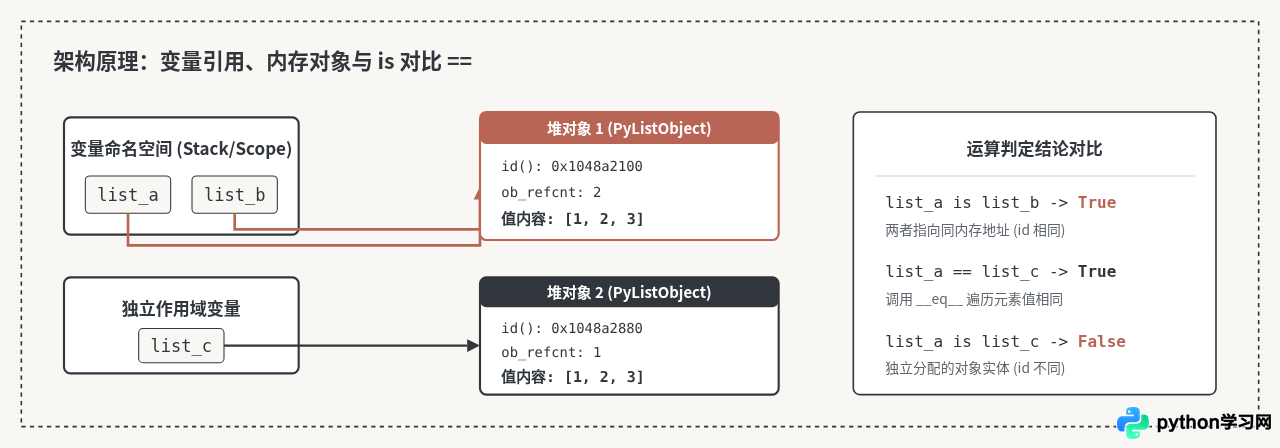
在 Python 中,所有数据(无论是整数、字符串,还是列表、函数、类)都是存放在堆内存中的对象实体。变量名本身并不直接存储数据,而是一个贴在对象上的“标签”或指针。当你编写 b = a 时,并没有在内存中深层复制一份新的数据,而是将名字 b 绑定到了 a 当前所引用的同一个对象实体上。
Python 提供了内置函数 id(obj)。官方文档规定,id() 返回该对象生命周期内唯一的整数标识。在最主流的 CPython 实现中,这一整数标识直接对应于该对象结构体在底层 C 堆内存中的实际虚拟地址(Pointer Address)。
# 示例 1:变量赋值与 id 观察
a = [10, 20, 30]
b = a
c = [10, 20, 30]

print("id(a):", hex(id(a)))
print("id(b):", hex(id(b)))
print("id(c):", hex(id(c)))

# 输出结果:
# id(a): 0x1048a2100
# id(b): 0x1048a2100
# id(c): 0x1048a2880从示例输出可以看到,a 与 b 的地址完全一致,说明两者共享同一个对象;而 c 虽然内部元素完全相同,但通过列表字面量 [] 触发了新的内存分配,获得了一个崭新的内存地址。
二、is 运算符的底层执行推导步骤
在了解了 id() 的本质后,我们可以推导出 is 运算符在解释器层面的底层执行逻辑。Python 解释器在编译代码时,会将 is 编译为专门的字节码指令(在 Python 3.9+ 中通常为 IS_OP)。
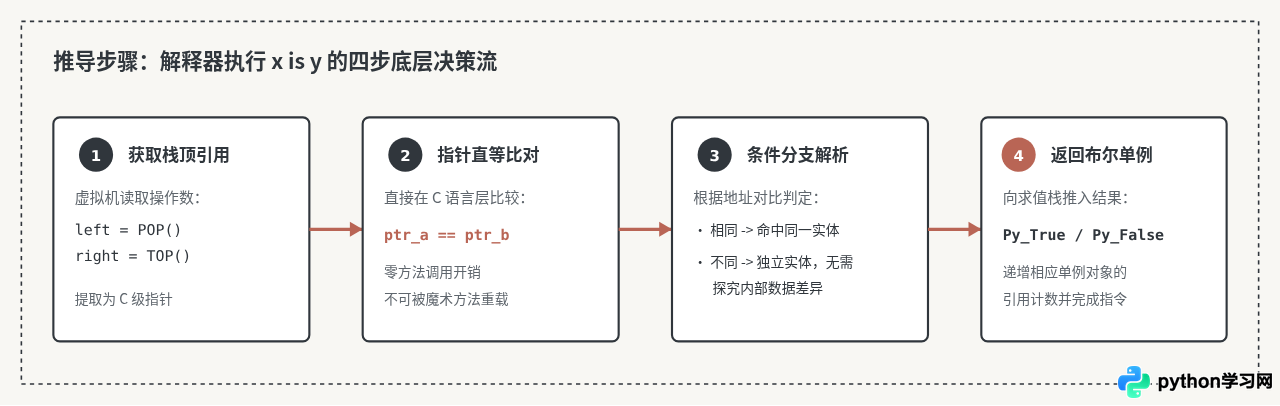
这个流程揭示了 is 运算符性能极高的原因:它只是单条机器指令级别的指针比对,时间复杂度严格为 O(1),无需任何递归解析或协议开销。
三、底层机制差异:is 与 == 的全方位对比
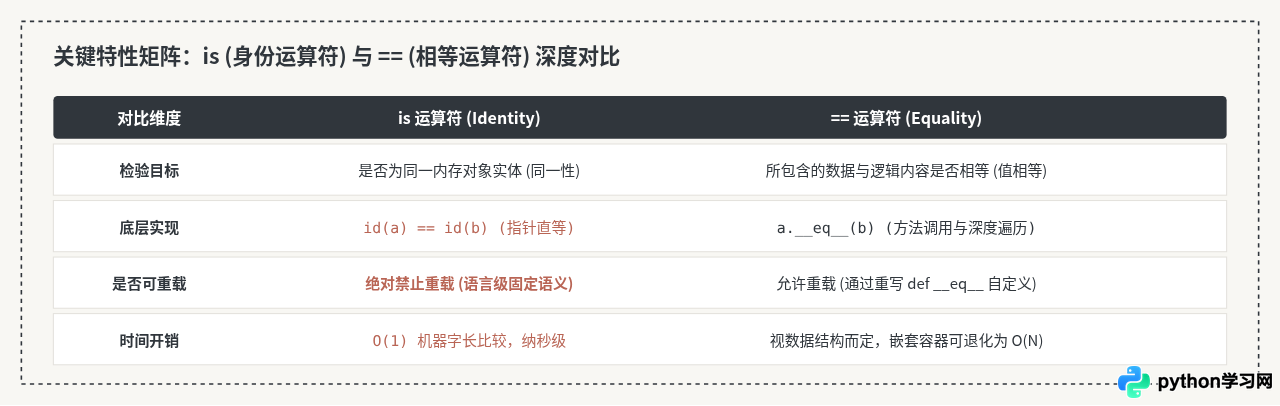
为了让读者更清晰地掌握两者的根本区别,我们将底层关键指标进行深度对照:
四、容易混淆的内存陷阱:小整数池与驻留机制
很多初学者会遇到令人困惑的现象:有时比较两个看起来独立赋值的变量,is 竟然返回 True?例如:
x = 256
y = 256
print(x is y)  # 输出 True

m = 257
n = 257
print(m is n)  # 在交互式 REPL 中常输出 False
这一现象的根本原因在于 CPython 的性能优化策略:
- 小整数对象池(Small Integer Cache):在解释器初始化时,CPython 预先在堆中分配了范围在
[-5, 256]的整数对象。所有在此范围内的整数变量都会被重定向到这组固定地址,不会产生新对象。 - 字符串驻留机制(String Interning):短文本、合法的 Python 标识符(如变量名、函数名)也会被放入解释器的驻留表(interned dict)中共享复用。
==。is 运算符在工程实践中最标准、最安全的用途是与单例对象(如 None、NotImplemented 或 Ellipsis)进行比对:
if val is None:
    # 官方推荐风格 (PEP 8)
    pass
五、知识回顾与最佳实践全景图
为了帮助你在代码评审与工程编写中做出准确判定,我们归纳了如下快速判定路径与核心认知模型:
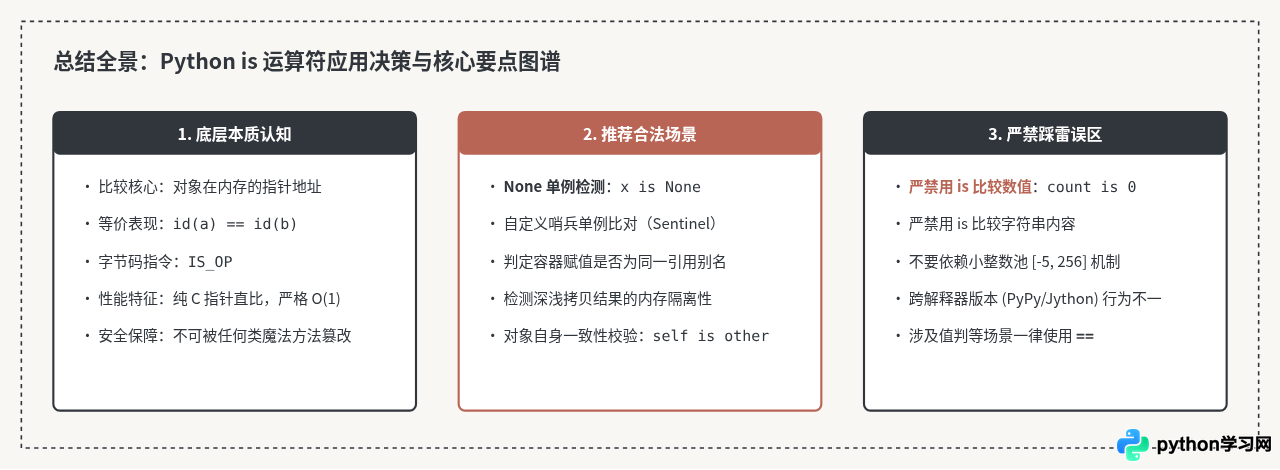
掌握了 is 运算符的底层原理后,你在日常阅读与编写 Python 代码时就能一眼看穿其行为本质:is 是对内存地址与引用的直接审视,而 == 是对数据逻辑内容的求证。在清晰的底层视角下,选择正确的比较工具将水到渠成。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









