

除了内置函数,Python标准库中还有哪些常用函数模块?
深入解析除内置函数外Python标准库中常用的函数模块,包括itertools、functools、operator、math与statistics的职能分工、代码示例、性能对比与选型实践。
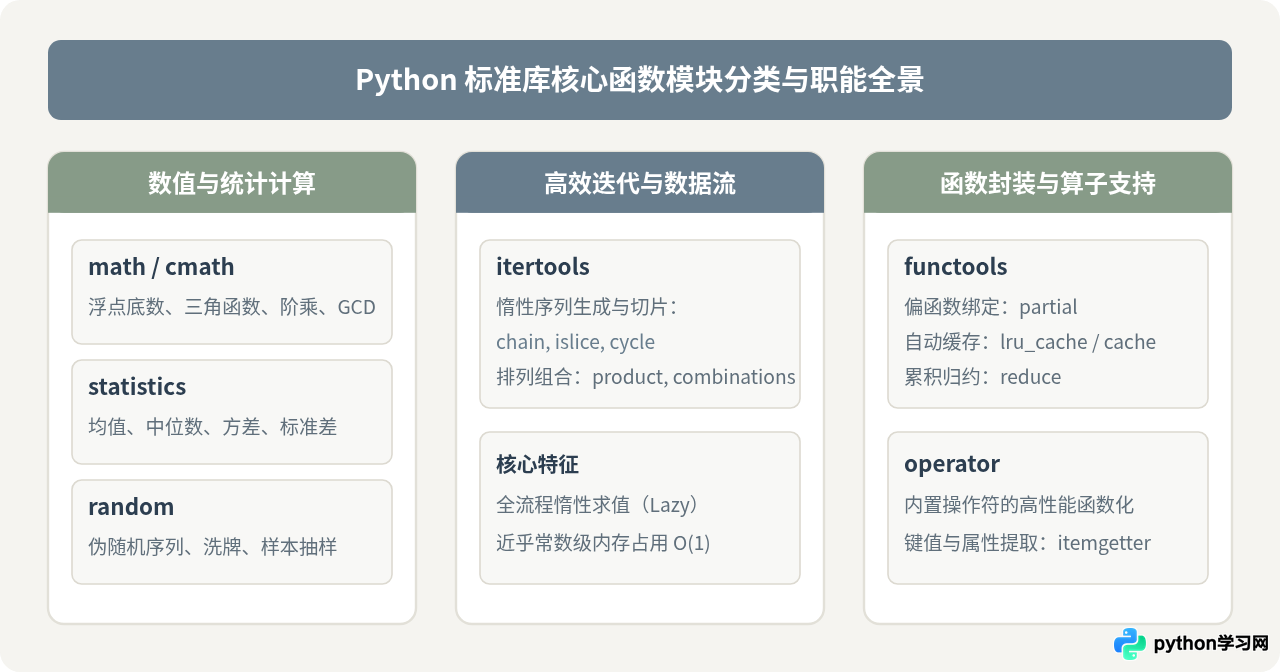
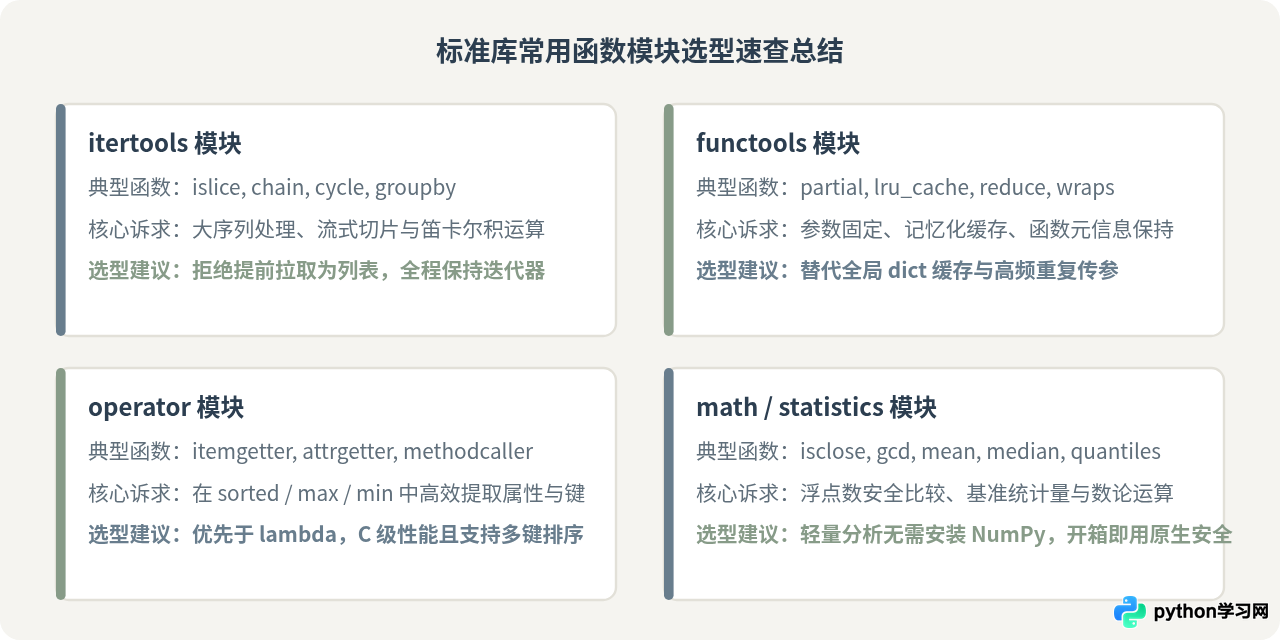
除了 Python 解释器默认提供的 len()、sum()、range()、sorted() 等内置函数外,Python 标准库中还随解释器内置了一组强大的“函数与工具模块”。这些模块无需通过 pip 额外安装,开箱即用,主要承担数据流处理、高阶封装、算子抽象以及精确数学统计等职责。最核心且最常用的五个函数模块分别是:用于惰性流式迭代的 itertools、用于高阶函数与缓存包装的 functools、提供运算符号函数接口的 operator,以及专注数值与指标统计的 math 和 statistics。
一、标准库常用函数模块的职能分工
在编写实际程序时,面对复杂的数据转换和计算任务,过度依赖原生 for 循环或手写辅助逻辑容易导致代码冗长且性能欠佳。Python 标准库在语言内置函数的基础上,按照领域场景进行了模块化分工:
- 流式迭代类(
itertools):提供一系列生成器函数,以极低的内存开销完成切片、无限循环、分组以及排列组合等序列处理。 - 函数封装类(
functools):提供作用于其他函数的高阶函数,负责偏函数参数固定、递归记忆化缓存以及函数元信息维护。 - 算子接口类(
operator):将加减乘除、属性访问和索引取值等内建语法操作导出为纯函数,与内置高阶函数无缝配合。 - 计算统计类(
math/statistics):提供浮点精度的数论计算、三角函数,以及开箱即用的均值、方差和分位数等统计学指标计算。
二、高效流式迭代与序列构建:itertools
itertools 模块被称为 Python 的“迭代神器”。其核心设计理念是惰性求值(Lazy Evaluation):它产出的不是保存在内存中的大列表,而是产生元素的生成器对象。当处理海量日志、大文件或无限序列时,itertools 能将内存占用严格控制在常数级。
1. 常用核心函数
itertools.islice(iterable, stop)或islice(iterable, start, stop[, step]):允许直接对生成器或不可切片的数据流进行切片,无需将数据转为列表。itertools.chain(*iterables):将多个可迭代对象平滑串联起来,依次遍历,避免使用list_a + list_b带来的内存复制开销。itertools.groupby(iterable, key=None):对已排序的数据流按指定的 key 函数进行连续分组。
2. 代码示例:惰性切片与多源串联
import itertools

# 模拟一个无限递增的生成器
def infinite_stream():
    n = 1
    while True:
        yield n
        n += 1

# 使用 islice 提取前 5 个元素,无需全量物化
stream = infinite_stream()
first_five = list(itertools.islice(stream, 5))
print("islice 提取结果:", first_five)

# 使用 chain 平滑连接多个不同集合
batch_a = [10, 20]
batch_b = (30, 40)
combined = list(itertools.chain(batch_a, batch_b))
print("chain 串联结果:", combined)islice 提取结果: [1, 2, 3, 4, 5]chain 串联结果: [10, 20, 30, 40]
3. 机制对比:列表推导式 vs itertools 惰性流
在同等过滤和提取需求下,列表推导式与 itertools 的执行方式存在本质差异:
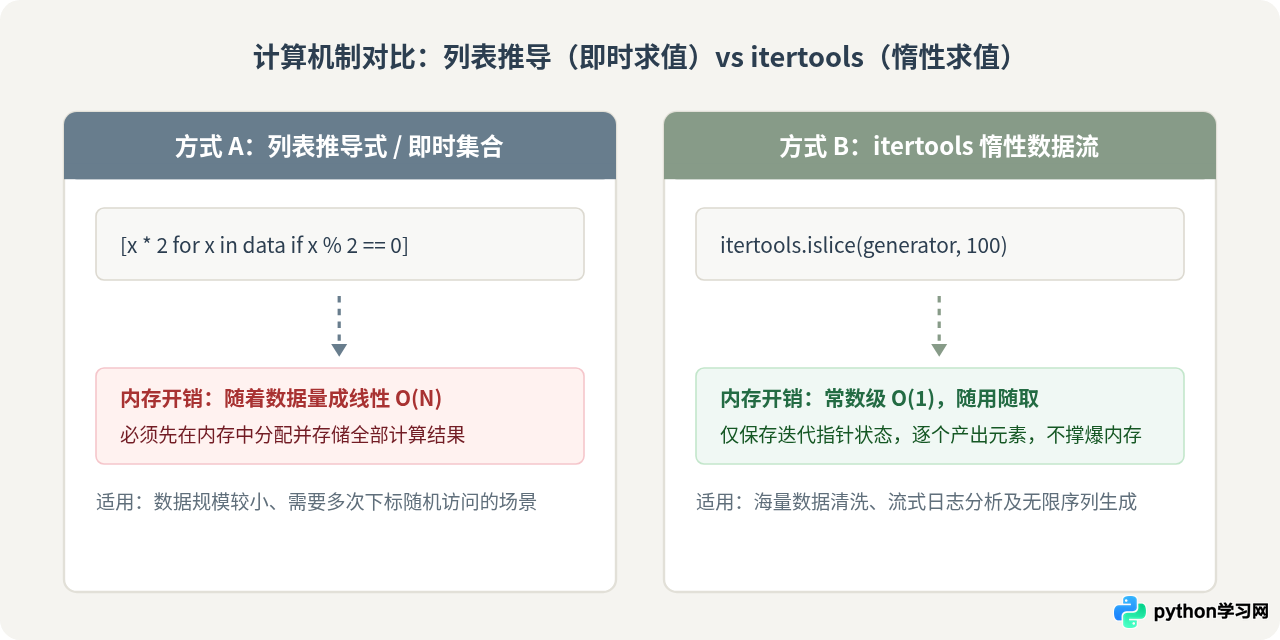
- 列表推导式(即时求值):在执行完成的一瞬间,必须向操作系统申请容纳所有符合条件元素的连续内存空间。面对千兆级别的大数据或行数未知的网络流,容易触发内存耗尽(OOM)。
- itertools(惰性求值):每次仅在外部迭代器调用
next()时计算并输出当前项,内存消耗几乎始终保持为 O(1)。
三、高阶函数与高效算子:functools 与 operator
如果说 itertools 强化了可迭代对象,那么 functools 和 operator 则直接增强了 Python 函数本身的调用与组合能力。
1. functools:高阶函数与缓存优化
functools 专为处理高阶函数而生,日常开发中最常用的函数包括:
functools.partial(func, *args, **keywords):冻结已有函数的某些参数,生成一个入参更少的新可调用对象。相比lambda,它更利于 pickle 序列化,且在打印和调试时能清晰保留原函数名。functools.lru_cache(maxsize=128):为耗时计算函数添加基于“最近最少使用”原则的内存缓存。在重复输入参数时,直接返回缓存结果。functools.wraps(wrapped):在自定义装饰器中保留原始被修饰函数的__name__、__doc__等元数据。
2. operator:原生算子的函数化实现
在调用 sorted()、max() 或 map() 时,很多开发者习惯使用 lambda x: x['score'] 来提取字段。然而,lambda 表达式每次调用都要经历 Python 虚拟机的帧栈开销。
operator 模块提供了由 C 语言底层实现的算子函数:
operator.itemgetter(key):用于字典键取值或列表切片索引,性能明显优于lambda,且支持一次性提取多个键(如itemgetter('city', 'score'))。operator.attrgetter(attr):用于对象属性访问,支持深层嵌套属性查找(如attrgetter('user.profile.age'))。operator.add/operator.mul:对应的纯算术函数,常用作reduce的累加或累乘操作。
import functools
import operator

students = [
    {"name": "Alice", "score": 92},
    {"name": "Bob", "score": 85},
    {"name": "Charlie", "score": 96}
]

# 1. 使用 operator.itemgetter 作为 sorted 的排序键
sorted_students = sorted(students, key=operator.itemgetter("score"), reverse=True)
print("按成绩降序排序:", sorted_students)

# 2. 使用 functools.partial 预设 base 进制转换
int_from_hex = functools.partial(int, base=16)
decimal_val = int_from_hex("FF")
print("16 进制 FF 转 10 进制:", decimal_val)按成绩降序排序: [{'name': 'Charlie', 'score': 96}, {'name': 'Alice', 'score': 92}, {'name': 'Bob', 'score': 85}]16 进制 FF 转 10 进制: 255
四、多模块协同操作流水线
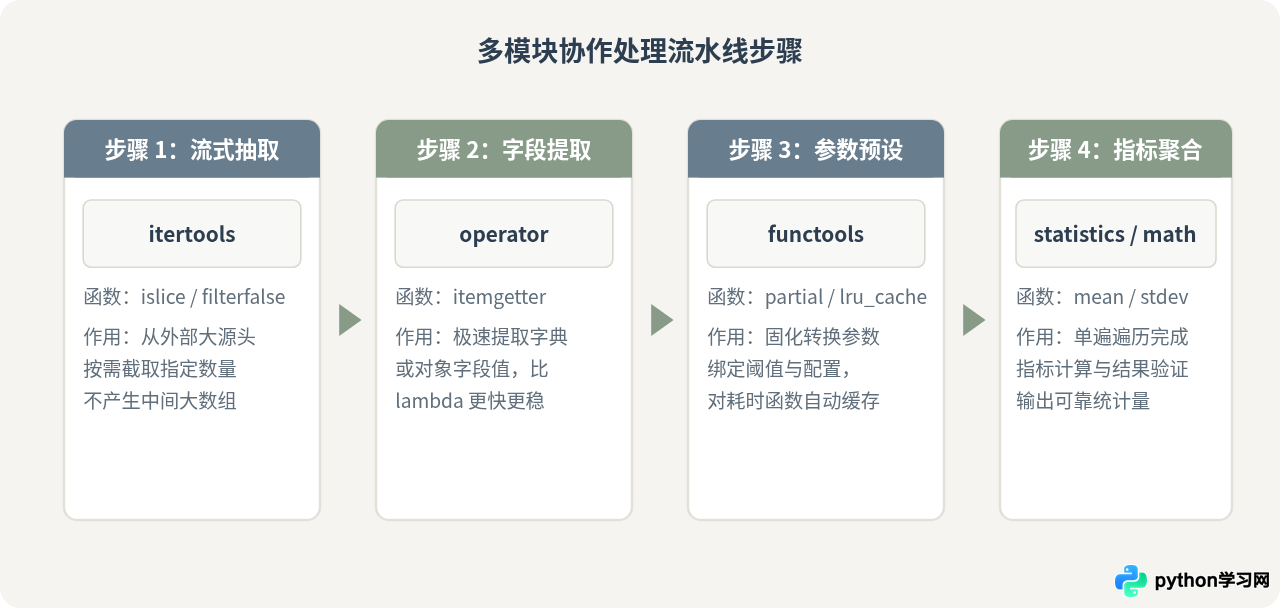
在工程实践中,这些模块通常不会单独作战,而是协同构成一条清晰的数据清洗与统计管道。以下流程展示了一个典型的数据批处理操作链路:从流式过滤,到键值提取,再到参数预设与指标聚合。
五、精准计算与统计分析:math 与 statistics
在处理数值计算时,内置的 abs()、round() 仅能满足最简单的需求,而 math 和 statistics 提供了更完整的底层数学与统计支持。
1. math 模块的关键实用函数
math.isclose(a, b, *, rel_tol=1e-09, abs_tol=0.0):安全比较两个浮点数是否相等。由于 IEEE 754 浮点精度限制,直接使用0.1 + 0.2 == 0.3会返回False,工程中必须使用math.isclose(0.1 + 0.2, 0.3)进行等值判断。math.ceil(x)/math.floor(x):向上取整与向下取整。math.gcd(*integers):直接计算多个整数的最大公约数。
2. statistics 模块的原生统计分析
对于中轻量级的数据分析,不需要引入庞大的第三方科学计算库(如 NumPy),直接使用 statistics 模块即可满足基础指标统计:
statistics.mean(data):计算算术平均值。statistics.median(data):计算中位数,对异常值更具鲁棒性。statistics.stdev(data):计算样本标准差。statistics.quantiles(data, n=4):将数据切分为四分位数区间。
import math
import statistics

# 浮点数安全比较
val_sum = 0.1 + 0.2
print("原生直接对比 (== 0.3):", val_sum == 0.3)
print("math.isclose 对比:", math.isclose(val_sum, 0.3))

# 统计分析
raw_scores = [78, 85, 92, 88, 96, 64, 88]
avg_score = statistics.mean(raw_scores)
mid_score = statistics.median(raw_scores)
dev_score = statistics.stdev(raw_scores)

print(f"平均分: {avg_score:.2f}, 中位数: {mid_score}, 样本标准差: {dev_score:.2f}")原生直接对比 (== 0.3): Falsemath.isclose 对比: True平均分: 84.43, 中位数: 88, 样本标准差: 10.53
六、选型指南与开发建议
在实际开发中,掌握不同函数模块的适用边界是写出优雅、高效 Python 代码的关键:
- 优先选用标准库函数,避免过早引入重量级依赖:对于基础的流式过滤和指标统计,标准库的
itertools和statistics足够轻量且零外部依赖,非常适合微服务和命令行工具。 - 用 operator 替换不必要的 lambda:在
sort、min、max和高频调用的场景下,operator.itemgetter和operator.attrgetter在可读性、执行性能和序列化上都明显优于临时构造的匿名函数。 - 海量流式处理保持全流程惰性:使用
itertools.islice、生成器表达式而非列表推导式,确保处理链条中不会意外物化大数组,守护内存底线。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









