

python必背源代码requests发送HTTP请求代码
深入解析Python开发中必背的requests发送HTTP请求核心源代码。涵盖GET与POST请求装配、data与json载荷深度对比、Session会话保持与连接池复用、以及生产级超时与全链路异常捕获的最佳实践。
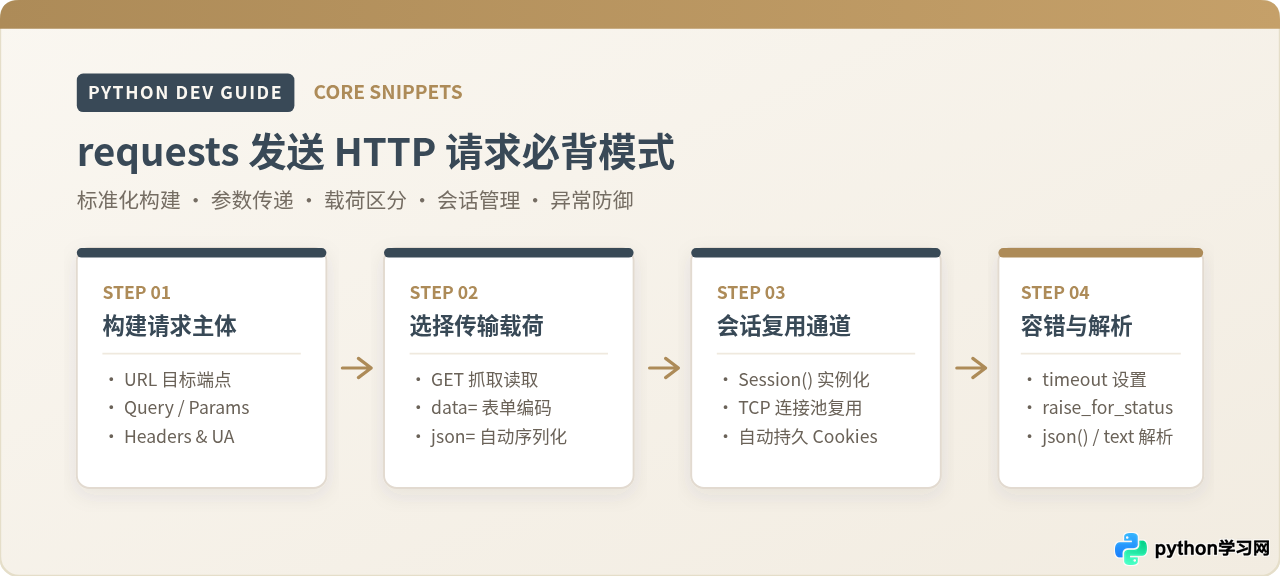
requests 是发起 HTTP 通信的事实标准。掌握其核心源代码并非机械记忆零碎的函数名,而是掌握从参数装配、载荷辨析、连接复用到异常防御的工业级规范代码模版。本文直接提炼出实际工程中必背的五套标准源代码,并解析每一处关键参数背后的运转逻辑与避坑依据。
一、标准 GET 请求与动态查询参数组装
GET 请求用于从服务端获取数据。最常见的错误是将查询参数直接通过字符串拼接在 URL 中,这不仅容易引发未转义字符解析失败(例如空格或中文),还会降低代码的可读性与扩展性。标准的写法是使用 params 参数传入 Python 字典,由 requests 自动完成安全编码与拼接。
import requests

# 1. 目标地址(仅保留基础路由)
url = "https://httpbin.org/get"

# 2. 查询参数字典(自动进行 URL 编码)
params = {
    "query": "python 教程",
    "page": 1,
    "limit": 20
}

# 3. 规范请求头(覆盖默认的 python-requests UA,防反爬拦截)
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36",
    "Accept": "application/json"
}

# 4. 执行请求:必须显式传入 timeout=(连接超时, 读取超时)
response = requests.get(url, params=params, headers=headers, timeout=(3.05, 10))

# 5. 状态熔断:若响应为 4xx 或 5xx,直接触发 HTTPError 异常
response.raise_for_status()

# 6. 数据解析:针对 JSON 响应直接解析为字典
result_data = response.json()
print("实际请求完整 URL:", response.url)
print("响应状态码:", response.status_code)
print("解析到的查询参数:", result_data["args"])响应状态码: 200
解析到的查询参数: {'limit': '20', 'page': '1', 'query': 'python 教程'}
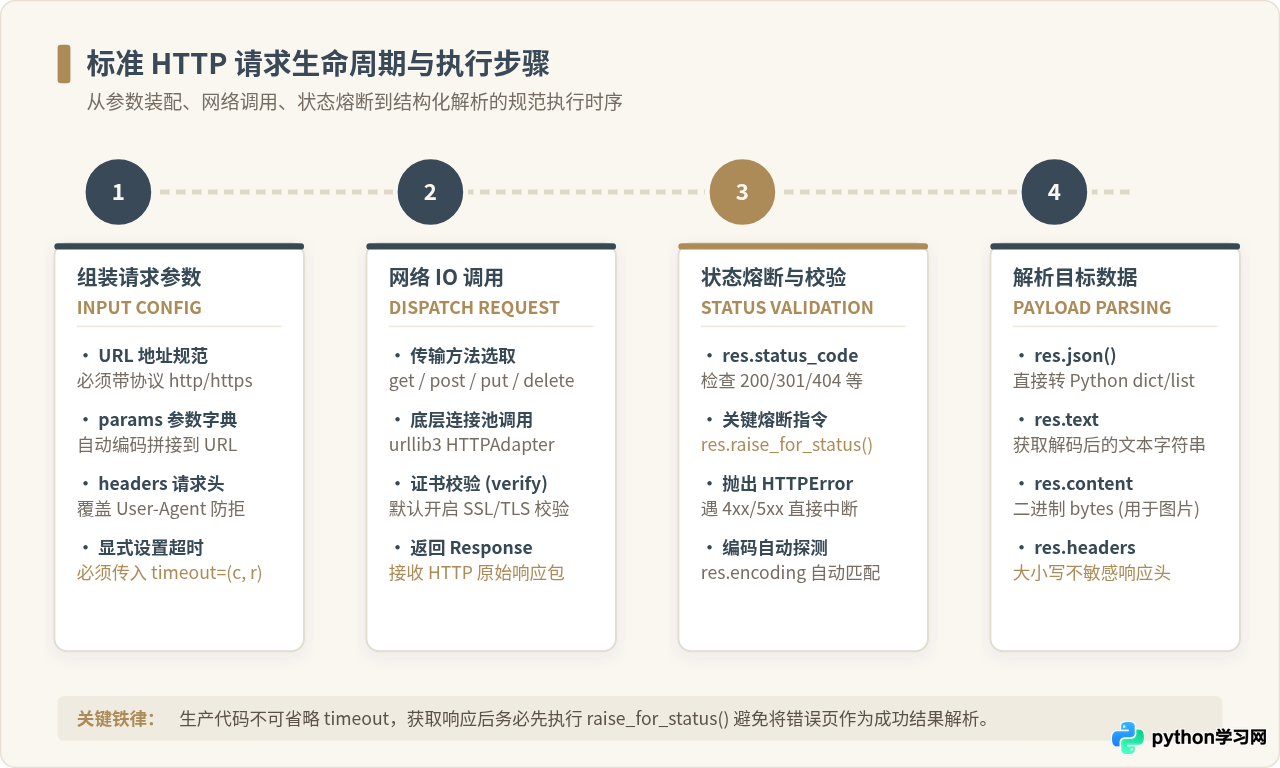
timeout=10,则两个阶段共享同一个阈值。
二、POST 请求数据载荷选择:data 与 json 的底层区别
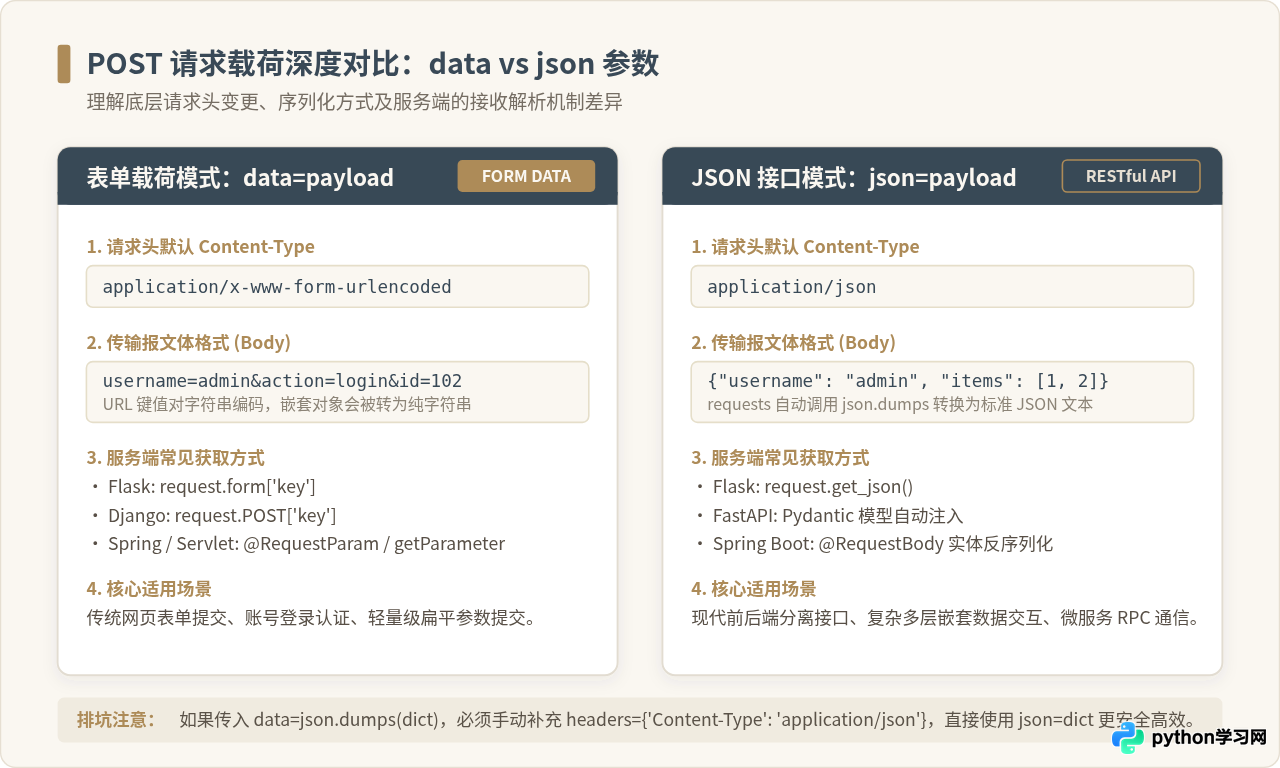
POST 请求用于向服务端提交数据或调用操作接口。初学者最容易混淆的是 data= 和 json= 两个参数。选择错误会导致服务端报 400 Bad Request 或无法正确反序列化请求体。
- 使用 data= 提交表单:当目标是传统登录表单、文件上传或接口要求
application/x-www-form-urlencoded时使用。字典会被序列化为形如key1=value1&key2=value2的键值对字符串。 - 使用 json= 提交 RESTful 负载:当调用现代化 JSON API 时使用。
requests会自动调用内置的json.dumps()进行序列化,并将请求头的Content-Type自动标记为application/json。
import requests

api_url = "https://httpbin.org/post"

# 场景 A:JSON 接口调用(微服务、现代 API 必背)
json_payload = {
    "user_id": 1001,
    "action": "checkout",
    "items": ["apple", "banana"]
}
# 使用 json= 参数,requests 自动封装 Content-Type: application/json
res_json = requests.post(api_url, json=json_payload, timeout=5)
res_json.raise_for_status()

# 场景 B:传统表单提交(普通网页登录、键值对提交)
form_payload = {
    "username": "admin",
    "password": "SecretPass123"
}
# 使用 data= 参数,requests 自动封装 Content-Type: application/x-www-form-urlencoded
res_form = requests.post(api_url, data=form_payload, timeout=5)
res_form.raise_for_status()

print("JSON 接口请求头 Content-Type:", res_json.request.headers["Content-Type"])
print("表单请求头 Content-Type:", res_form.request.headers["Content-Type"])表单请求头 Content-Type: application/x-www-form-urlencoded
三、会话保持与连接池复用:requests.Session
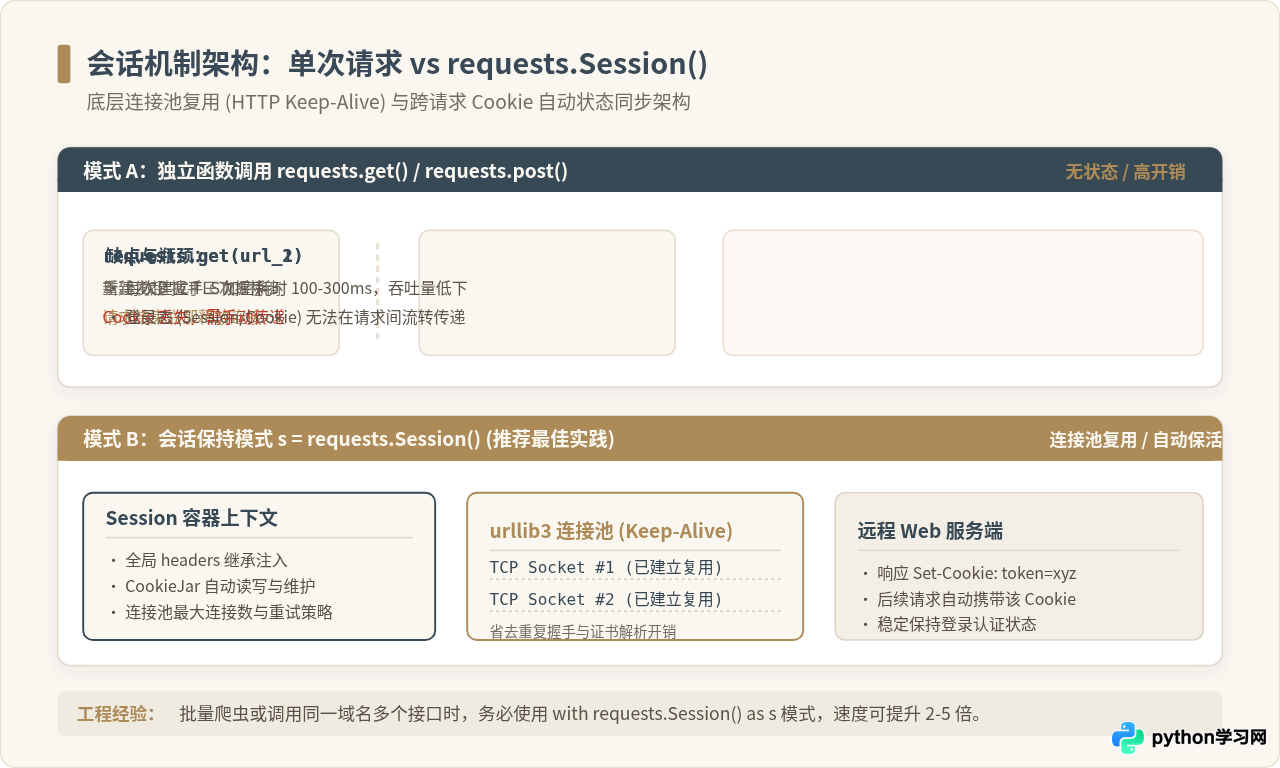
如果程序需要向同一域名发起多次连续请求(例如登录后抓取个人中心、分页遍历数据),直接多次调用 requests.get() 会造成严重的性能浪费和状态丢失。因为每次独立的函数调用都会重新进行完整的 DNS 解析、TCP 三次握手和 TLS 握手,且每次调用的 Cookies 彼此隔离。
必背的标准解法是使用 requests.Session(),它提供两大关键特性:
- 自动 Cookie 保持:服务端通过响应头
Set-Cookie颁发的会话状态,会被 Session 自动存储,并在后续请求同一作用域时自动附带。 - TCP 连接池复用:基于底层
urllib3连接池管理,对同一服务器的多次请求复用已有的 TCP/TLS 链路,极大减少延迟并降低 CPU 开销。
import requests

# 推荐使用上下文管理器 with 语句,确保网络连接池在退出作用域后自动安全释放
with requests.Session() as session:
    # 1. 统一设置会话全局请求头(所有后续请求自动继承)
    session.headers.update({
        "User-Agent": "SessionClient/1.0",
        "Accept": "application/json"
    })

    # 2. 发起首次请求:模拟服务端种植 Cookie
    set_cookie_url = "https://httpbin.org/cookies/set?auth_token=K89s7xZa"
    res1 = session.get(set_cookie_url, timeout=5)
    res1.raise_for_status()

    # 3. 发起第二次请求:验证 Cookie 是否自动流转
    check_cookie_url = "https://httpbin.org/cookies"
    res2 = session.get(check_cookie_url, timeout=5)
    res2.raise_for_status()

    # 查看 Session 内部维护的 CookieJar 与返回数据
    print("当前 Session 持久化的 Cookies:", session.cookies.get_dict())
print("服务端读取到的 Cookies:", res2.json())服务端读取到的 Cookies: {'cookies': {'auth_token': 'K89s7xZa'}}
四、生产级异常防御与容错重试机制
网络请求天生存在不确定性。DNS 解析失败、路由器断网、服务器偶发 502 网关超时、或者网络拥塞导致客户端读取超时,都是常见故障。在脚本中裸奔 requests.get() 会让突发异常直接中断整个程序。
标准代码中必须严格遵循 requests.exceptions 的继承结构,按照“从细粒度到大粒度”的顺序逐层捕获,切忌直接用通配的 except Exception: 吞掉异常。
import time
import requests
from requests.exceptions import (
    RequestException,
    Timeout,
    ConnectionError,
    HTTPError
)

def safe_fetch_with_retry(url, max_retries=3, timeout=(3.05, 5)):
    headers = {"User-Agent": "ReliableWorker/2.0"}

    for attempt in range(1, max_retries + 1):
        try:
            # 发起请求并注入超时控制
            res = requests.get(url, headers=headers, timeout=timeout)

            # 触发 4xx/5xx 校验,抛出 HTTPError 进入异常处理流
            res.raise_for_status()

            # 校验通过,返回成功解析的数据
            return res.json()

        except Timeout as e:
            # 超时通常为瞬时网络抖动,适合重试
            print(f"[第 {attempt} 次重试] 连接或读取超时: {e}")
            if attempt == max_retries:
                print("达到最大重试上限,宣告失败")
                raise
            time.sleep(2 ** attempt)  # 指数退避:2s, 4s, 8s...

        except HTTPError as e:
            # 针对 4xx (客户端错误) 与 5xx (服务端内部故障) 分流判断
            status = e.response.status_code
            if 400 <= status < 500:
                print(f"客户端参数或权限错误 (HTTP {status}),无需重试: {e}")
                raise
            print(f"服务端内部故障 (HTTP {status}),准备重试...")
            time.sleep(2)

        except ConnectionError as e:
            # 域名解析失败或物理断网
            print(f"网络连接无法建立: {e}")
            raise

        except RequestException as e:
            # 其它所有 requests 未预期的基类异常兜底
            print(f"未知网络异常兜底: {e}")
            raise

# 运行示例
if __name__ == "__main__":
    data = safe_fetch_with_retry("https://httpbin.org/delay/1")
    print("请求成功,数据字节数:", len(str(data)))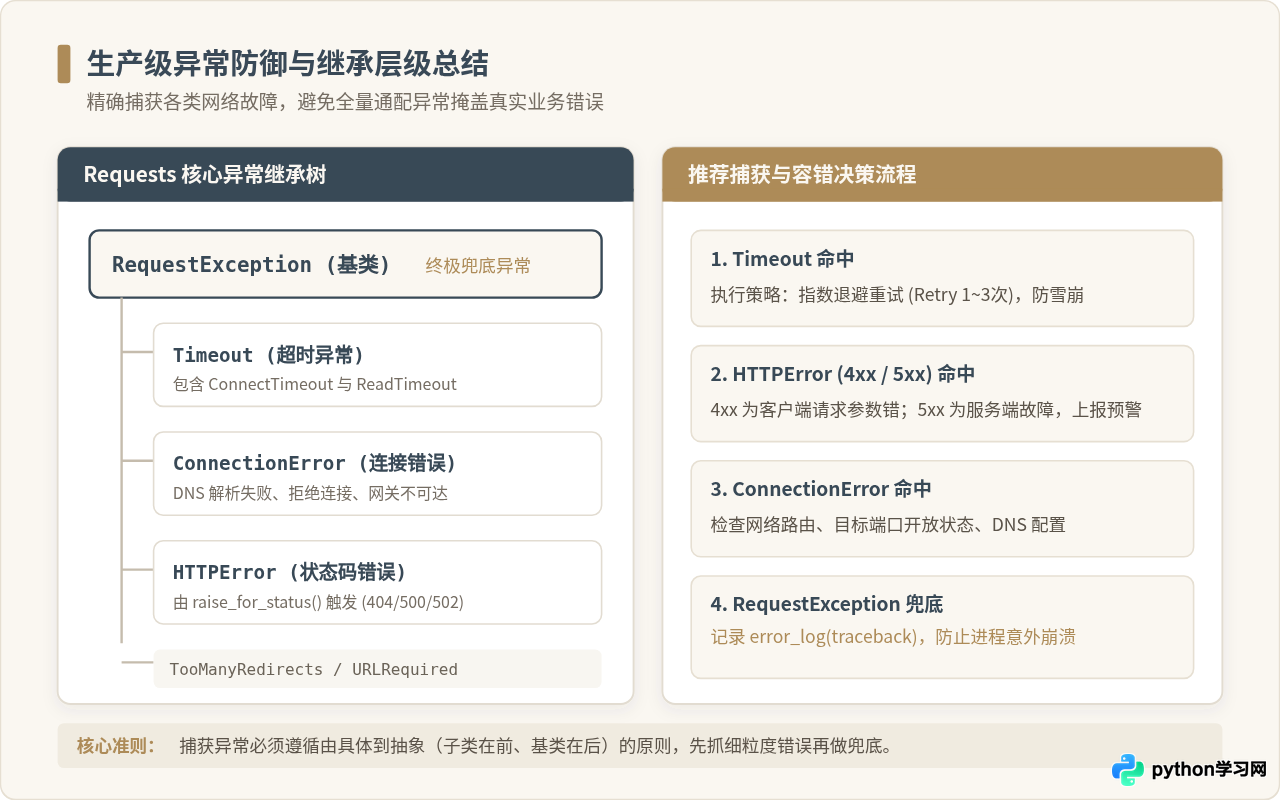
五、工程化必背完整模板速查
为了在日常开发中随时调用,将上述所有规范(Headers 定制、显式 Timeout、Session 复用、参数载荷分流、raise_for_status 熔断、细粒度异常兜底)封装为一套高内聚的客户端类:
import requests
from requests.exceptions import RequestException

class HTTPClient:
    def __init__(self, base_url="", timeout=(3.05, 10)):
        self.base_url = base_url.rstrip("/")
        self.timeout = timeout
        self.session = requests.Session()
        self.session.headers.update({
            "User-Agent": "EnterpriseClient/1.0",
            "Accept": "application/json"
        })

    def request(self, method, endpoint, **kwargs):
        url = f"{self.base_url}/{endpoint.lstrip('/')}" if self.base_url else endpoint
        kwargs.setdefault("timeout", self.timeout)
        try:
            res = self.session.request(method, url, **kwargs)
            res.raise_for_status()
            return res.json()
        except requests.exceptions.HTTPError as err:
            print(f"[HTTP Error {res.status_code}] {url}: {err}")
            raise
        except requests.exceptions.Timeout:
            print(f"[Timeout Error] 请求超时: {url}")
            raise
        except RequestException as err:
            print(f"[Network Error] 请求中断: {err}")
            raise

    def close(self):
        self.session.close()

# 使用示例:
# client = HTTPClient(base_url="https://httpbin.org")
# resp = client.request("GET", "/get", params={"k": "v"})
# client.close()params,自动拼装最周详;2. 交数看协议:表单传
data,API 接口认准 json;3. 提速与登录:优先
requests.Session(),底层池化自动带 Cookie;4. 高可用铁律:显式指定
timeout,先调 raise_for_status(),再抓 RequestException。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









