

Python嵌套列表怎么展平后求和

sum():sum(x for sub in nested for x in sub)。这种方式边展平边累加,不会在内存中创建多余的中间列表。若处理百万级规整二维数据,推荐使用标准库 itertools.chain.from_iterable() 获得更优的迭代效率;若面对深度未知的不规则多层嵌套,则应使用递归生成器进行流式解包。
一、规则二维嵌套列表的高效展平与求和
在实际开发中,最普遍的情况是双层规整嵌套列表,例如二维矩阵、分组采集的数据块等。这类结构的外层与内层均为 list,每个子列表内部包含具体的数值。
方法 1:生成器表达式结合 sum()(推荐首选)
很多初学者会先通过列表推导式生成一个扁平化的大列表,再用 sum() 求和。实际上,去掉两端的外层方括号,将其转化为生成器表达式,是性能与内存占用双优的做法:
nested = [[1, 2, 3], [4, 5], [6, 7, 8, 9]]

# 生成器表达式求和:内存占用 O(1)
total = sum(x for sub in nested for x in sub)

print("求和结果:", total)  # 示例输出:求和结果: 45
这里双重 for 循环的顺序与普通的嵌套循环完全一致:先遍历外层的每个子列表 sub in nested,再遍历子列表中的每个元素 x in sub。因为使用了圆括号上下文(传入 sum() 函数),Python 不会预先分配一个长度为 9 的临时列表,而是由 sum() 逐个拉取元素并在寄存器中累加,空间复杂度维持在常数级。
方法 2:itertools.chain.from_iterable(极致速度优选)
如果数据量达到数十万甚至数百万级别,Python 解释器在字节码层面的循环开销会逐渐显现。此时使用内置的 itertools.chain.from_iterable 可以直接在底层的 C 扩展模块中完成流式解包,运行速度比纯 Python 生成器更快:
import itertools

nested = [[10, 20], [30, 40, 50], [60]]

# chain.from_iterable 接收一个可迭代的子容器序列,返回一个扁平迭代器
total = sum(itertools.chain.from_iterable(nested))

print("求和结果:", total)  # 示例输出:求和结果: 210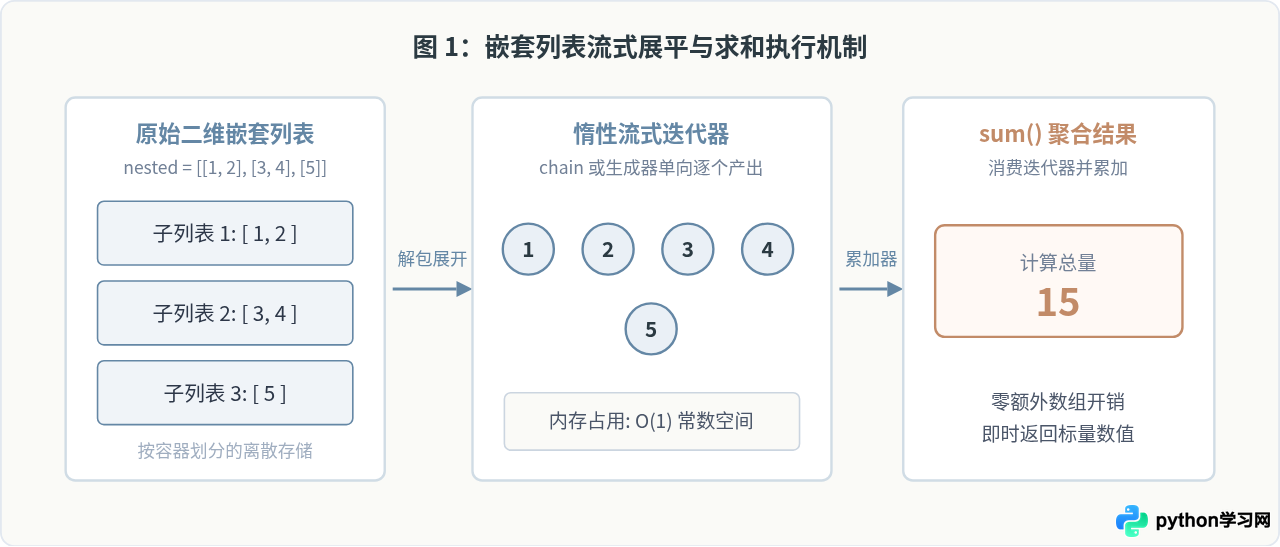
二、防坑辨析:为什么严禁使用 sum(nested, []) 展平?
部分教程或代码片段中常常出现 sum(nested, []) 这样看似巧妙的单行展平技巧。虽然它的代码极其精简,但这在 Python 中属于严重的反模式。
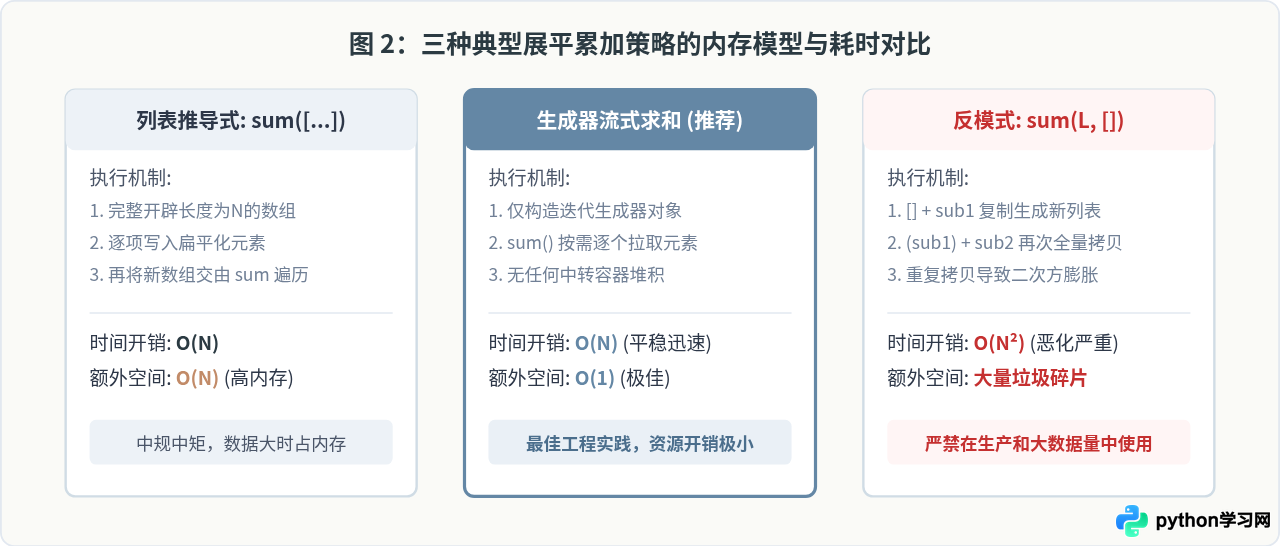
sum(iterable, start) 的实现逻辑是基于 start += item。如果 start 传入空列表 [],每次累加实际上都在执行两个列表的拼接操作(即 list + list)。每次拼接都会在内存中重新申请一块连续空间,并将已有元素全部复制一遍。
当嵌套列表包含 $K$ 个子列表、总计 $N$ 个元素时,sum(nested, []) 的总复制次数高达 $O(N^2)$。当数据量从 1000 递增到 50,000 时,程序耗时会呈现指数级恶化,并且给 Python 垃圾回收机制带来极高负担。
三、任意深层与不规则嵌套列表的递归展平求和
当嵌套层级不是规则的二维矩阵,而是多层、深浅不一的不规则树状结构时(例如 [1, [2, [3, 4]], 5, [6]]),双重固定循环就无法触达所有深层元素了。这时需要借助“递归”机制向下探测。
1. 递归生成器函数(简洁而通用)
利用 Python 3.3 引入的 yield from 语法,可以写出一个极其精炼且通用的惰性展平生成器:
from collections.abc import Iterable

def flatten_generator(items):
    """递归展开任意深度的可迭代对象(排除字符串与字节)"""
    for item in items:
        # 如果是可迭代容器且不是字符串/字节类型,向下递归展开
        if isinstance(item, Iterable) and not isinstance(item, (str, bytes)):
            yield from flatten_generator(item)
        else:
            yield item

# 测试不规则多层嵌套数据
nested_irregular = [1, [2, 3], [[4, [5, 6]], 7], 8]

# 配合 sum 同样享受流式消费,不额外保存展平后的一维大列表
total = sum(flatten_generator(nested_irregular))
print("任意深层嵌套求和:", total)  # 示例输出:任意深层嵌套求和: 36
2. 显式栈迭代解法(避免极深层递归溢出)
Python 默认存在最大递归深度限制(通常为 1000)。当嵌套层数异常极端,或者希望完全规避函数调用栈的消耗时,可以维护一个普通的 Python 列表作为“显式工作栈”来进行广度/深度遍历:
from collections.abc import Iterable

def sum_deep_nested_stack(nested_list):
    total = 0
    # 将顶层列表复制进待处理栈中
    stack = [nested_list]

    while stack:
        curr = stack.pop()
        if isinstance(curr, Iterable) and not isinstance(curr, (str, bytes)):
            # 扩展压入栈中,继续在下一轮循环中展开
            stack.extend(curr)
        else:
            # 叶子节点数值直接累加
            total += curr
    return total

nested_data = [10, [20, [30, [40]]], 50]
print("显式栈累加结果:", sum_deep_nested_stack(nested_data))  # 示例输出:显式栈累加结果: 150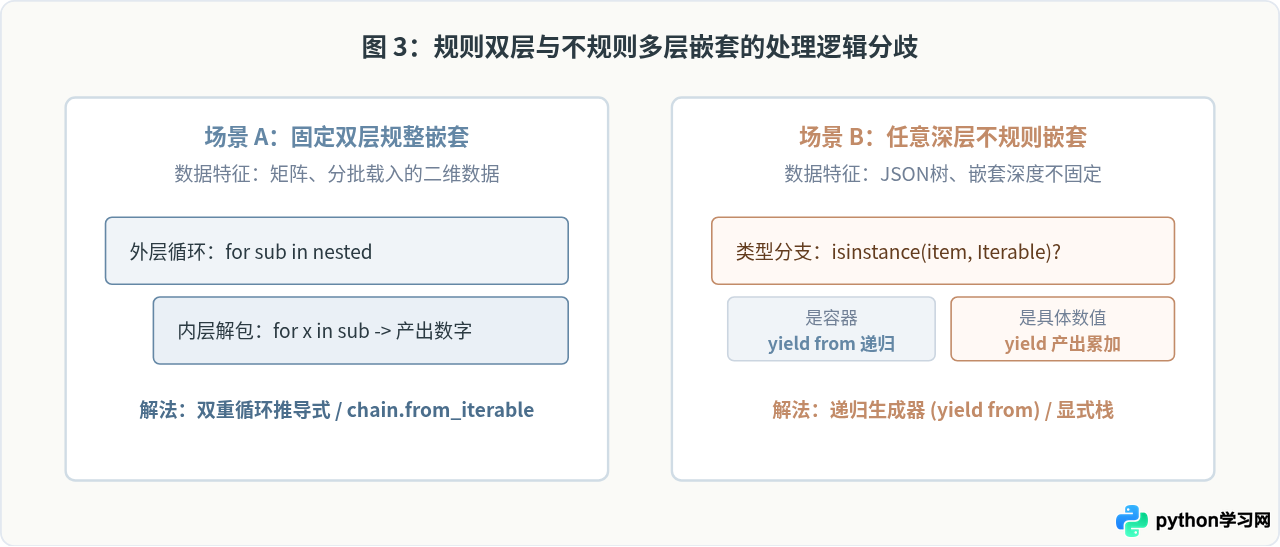
四、实际工程中的注意事项与边界情况
在真实业务场景中,列表往往夹杂脏数据或存在精度问题。在执行展平求和前,需注意以下三项核心边界条件:
1. 过滤非数值元素或 None 值
如果嵌套列表中可能混杂着 None、字符串或空子列表,直接调用 sum() 会触发 TypeError: unsupported operand type(s) for +。此时可以在生成器表达式中嵌入类型保护过滤器:
dirty_nested = [[1, 2, "非法", None], [3, []], [4.5]]

# 增加 isinstance 过滤保护,只保留整数与浮点数
clean_sum = sum(
    x for sub in dirty_nested
    if isinstance(sub, Iterable) and not isinstance(sub, (str, bytes))
    for x in sub
    if isinstance(x, (int, float)) and not isinstance(x, bool)
)

print("清洗后求和:", clean_sum)  # 示例输出:清洗后求和: 10.5
注:在 Python 中,bool 是 int 的子类(True == 1),如果数据源中可能存在布尔标志且不希望其被当做 1 累加,务必加上 and not isinstance(x, bool) 排除。
2. 浮点数累加的高精度需求
内置的 sum() 采用的是连续简单累加。在处理大量浮点小数求和时,二进制舍入误差会被逐步放大。如果对计算精度有严苛要求(如财务结算或科学计算),应将外层的 sum() 替换为标准库 math.fsum(),它基于跟踪多个中间和的精确浮点累加算法:
import math

float_nested = [[0.1] * 10, [0.1] * 10]

# 使用内置 sum() 可能会产生微小偏差(如 1.9999999999999998)
print("标准 sum:", sum(x for sub in float_nested for x in sub))

# 使用 math.fsum 消除累积误差,严格保持精度
print("math.fsum:", math.fsum(x for sub in float_nested for x in sub))  # 输出: 2.0
五、各方案选型总结与决策指南
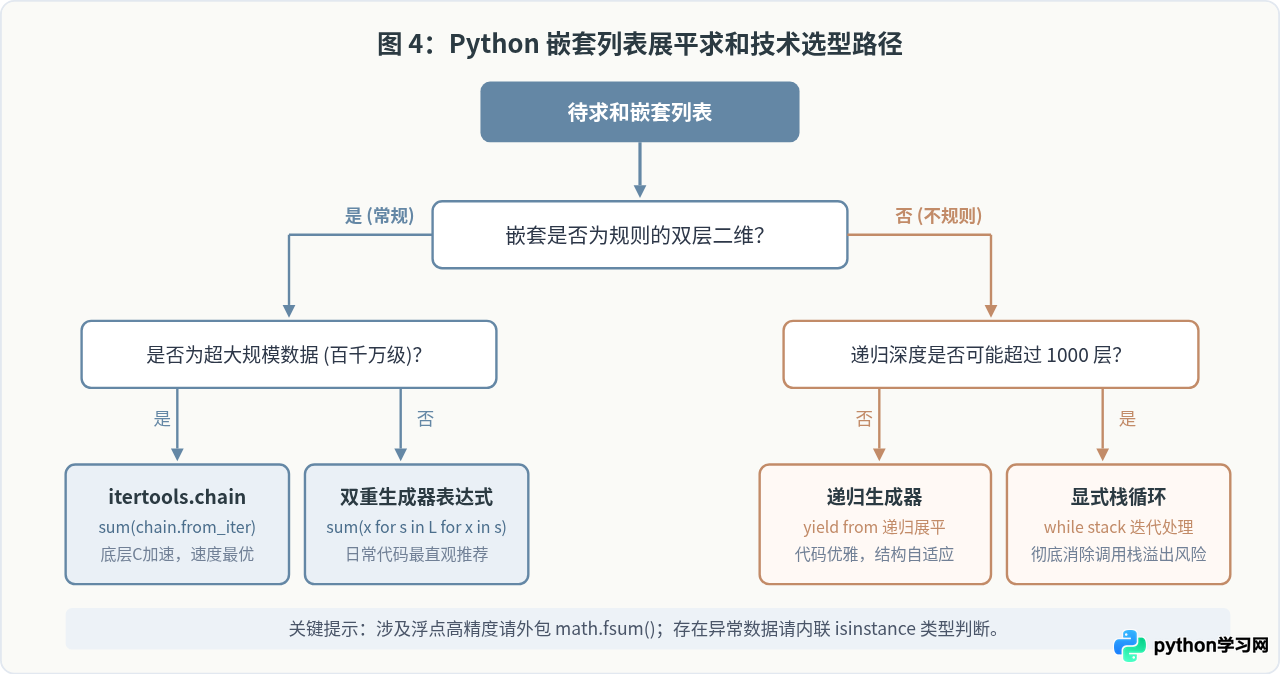
为了在实际开发中快速挑选出最匹配业务场景的展平求和方案,可参考下方的特性对比矩阵:
| 实现方案 | 适用数据结构 | 时间复杂度 | 额外空间复杂度 | 开发推荐建议 |
|---|---|---|---|---|
| 生成器表达式 + sum() | 规则双层嵌套 | O(N) | O(1) | ★★★★★ 最推荐,零外部依赖,语法清晰 |
| itertools.chain + sum() | 规则双层嵌套 | O(N) | O(1) | ★★★★★ 大规模二维数据性能优选 |
| 递归生成器 (yield from) | 任意多层不规则嵌套 | O(N) | O(D) 递归深度 | ★★★★☆ 复杂树状嵌套最佳平衡 |
| 显式循环工作栈 | 超深未知层级嵌套 | O(N) | O(D) 栈空间 | ★★★☆☆ 防范递归层数越界的硬核保底 |
| 列表相加 sum(L, []) | 双层嵌套 | O(N²) | O(N) | ★☆☆☆☆ 严禁使用,存在二次方效率陷阱 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









