

python必背源代码读写JSON文件代码
提供Python读写JSON文件必背的标准源代码与规范写法,系统辨析json.dump、json.load、json.dumps与json.loads的核心机制差异,详解UTF-8编码防乱码、排版缩进、类型映射及生产环境避坑指南。
json.dump(),读取文件使用 json.load()。借助标准库内置的 json 模块与 with open 自动上下文管理,不仅代码精炼,而且能确保文件句柄安全释放。掌握以下两套必背源代码及关键参数配置,即可直接解决日常开发中 95% 以上的数据持久化与配置读取需求。
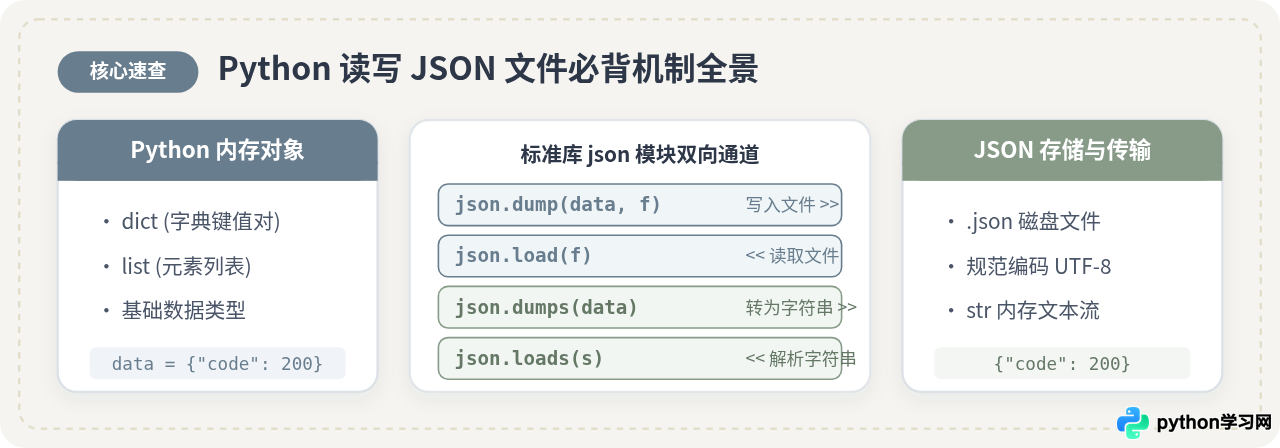
一、最简必背模板:写入与读取两套完整代码
日常编写脚本、爬虫落盘或管理本地配置文件时,推荐直接套用以下两段标准源代码。代码中包含中文字符支持、层级缩进与 UTF-8 编码设置,完全符合生产代码的规范要求。
1. 写入 JSON 文件的完整源代码
向磁盘写入 JSON 数据时,核心函数是 json.dump()。必须以写模式("w")打开目标文件,并显式指定 encoding="utf-8" 规避字符集兼容问题。
import json

# 1. 准备待保存的数据(支持字典嵌套、列表、布尔值及中文)
config_data = {
    "app_name": "自动化监控平台",
    "version": "1.2.0",
    "is_active": True,
    "max_connections": 100,
    "notify_emails": ["admin@example.com", "ops@example.com"],
    "settings": {
        "timeout": 30,
        "retry": 3
    }
}

# 2. 写入 JSON 文件(必背关键模板)
with open("config.json", mode="w", encoding="utf-8") as f:
    json.dump(config_data, f, ensure_ascii=False, indent=4)

print("JSON 文件写入成功!"){
"app_name": "自动化监控平台",
"version": "1.2.0",
"is_active": true,
"max_connections": 100,
"notify_emails": [
"admin@example.com",
"ops@example.com"
],
"settings": {
"timeout": 30,
"retry": 3
}
}2. 读取 JSON 文件的完整源代码
从磁盘加载已存在的 JSON 文件时,使用 json.load()。以读模式("r")打开文件后直接传入文件句柄,模块会自动将其解析为 Python 原生字典或列表。
import json

# 读取并解析 JSON 文件(必背关键模板)
with open("config.json", mode="r", encoding="utf-8") as f:
    loaded_data = json.load(f)

# 输出读取后的数据及其类型
print("读取成功,数据类型:", type(loaded_data))
print("系统名称:", loaded_data["app_name"])
print("重试次数:", loaded_data["settings"]["retry"])读取成功,数据类型: <class 'dict'>
系统名称: 自动化监控平台
重试次数: 3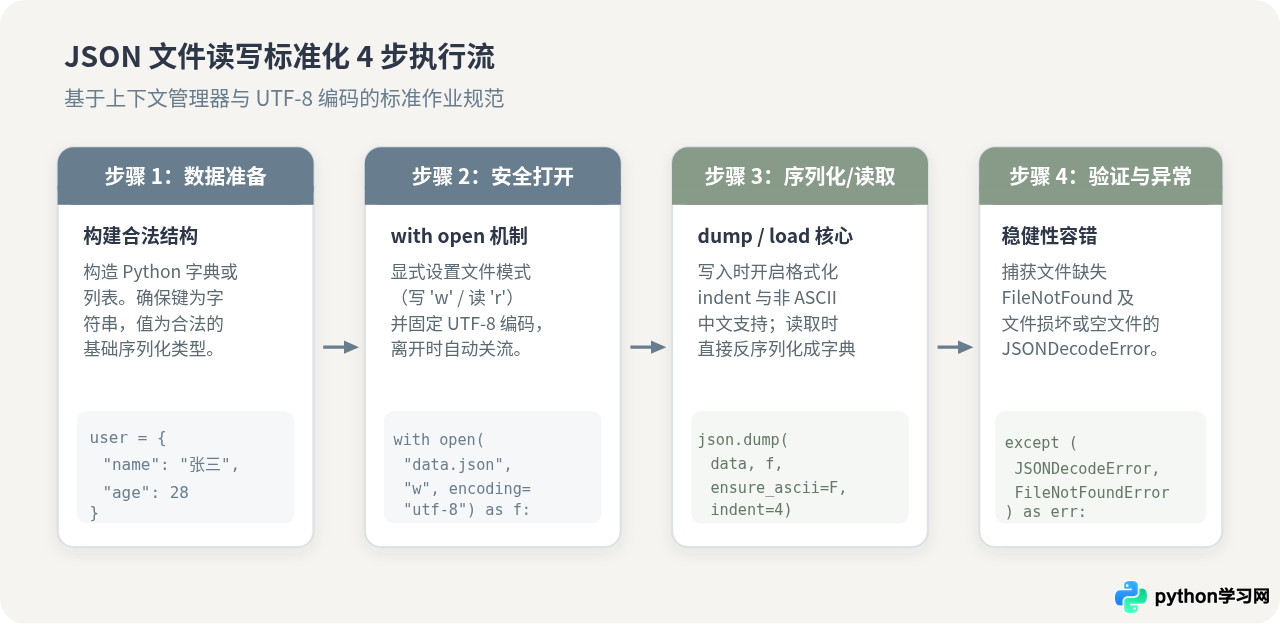
二、核心方法辨析:dump/load 与 dumps/loads 关键差异
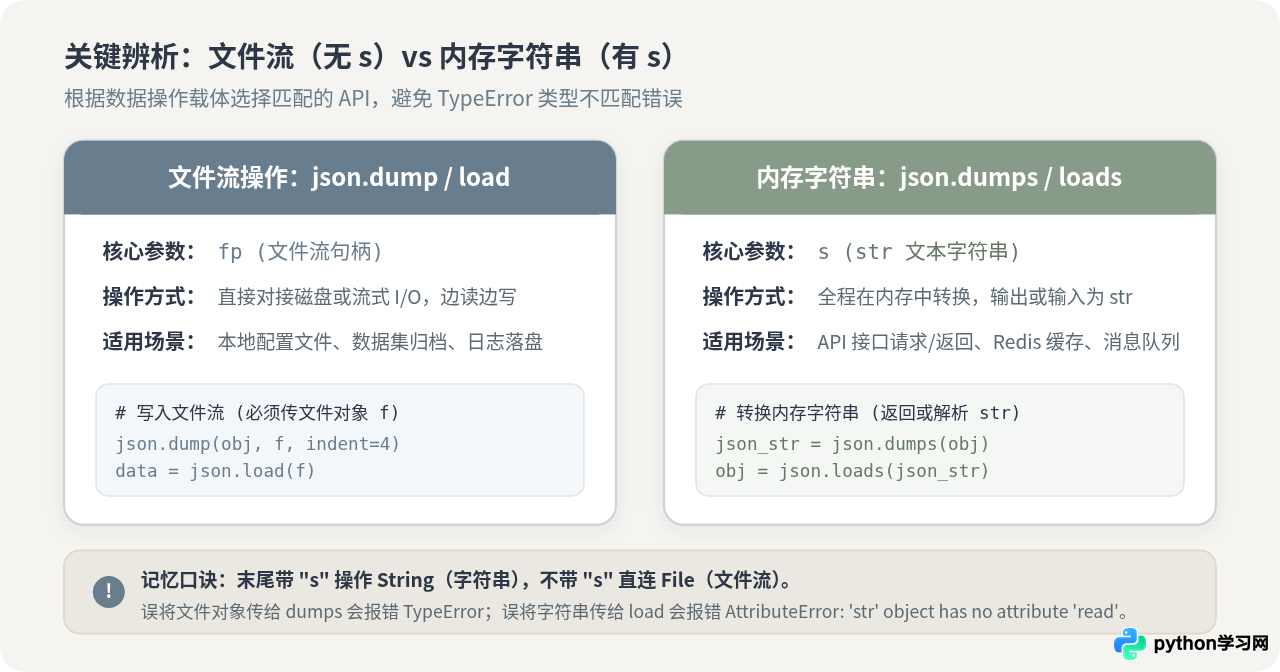
很多初学者容易混淆 dump/load 与 dumps/loads。两者的核心差异在于操作的数据载体不同:一个是针对文件流(File-like Object),另一个是针对内存中的字符串(String)。
| 函数名 | 末尾含义 | 接受/返回的核心对象 | 主要适用场景 |
|---|---|---|---|
json.dump(obj, fp) |
无 s | 接受 Python 对象与文件句柄 fp | 将数据直接序列化并写入磁盘文件 |
json.load(fp) |
无 s | 接受文件句柄 fp,返回 Python 对象 | 直接从磁盘文件中反序列化读取数据 |
json.dumps(obj) |
带 s (String) | 接受 Python 对象,返回 str 字符串 | 内存数据转字符串,用于 API 返回或网络传输 |
json.loads(s) |
带 s (String) | 接受 str 字符串,返回 Python 对象 | 解析网络请求体、Redis 缓存或日志文本 |
若将内存字符串误传给 json.load("..."),程序会立即崩溃并抛出 AttributeError: 'str' object has no attribute 'read',因为 load 内部要求参数必须具备 .read() 方法的文件对象;反之,若把文件对象传给 json.dumps(f),则会报错 TypeError: Object of type TextIOWrapper is not JSON serializable。记住规律:操作文件用不带 s 的,操作字符串用带 s 的。
三、类型转换规则:Python 数据结构与 JSON 标准映射
JSON 是一种跨语言的数据交换规范,并非所有 Python 原生类型都能无缝映射。理解双向转换过程中的类型对齐规则,能有效预防字段取值异常与序列化报错。
- 字典与对象:Python 的
dict严格转换为 JSON 的object。需要特别注意:JSON 规范要求对象的键(Key)必须是双引号字符串;如果 Python 字典的键是整数或浮点数,在执行dump后键会被强制转换为字符串。 - 元组与列表的单向性:Python 中的
list与tuple都会被序列化为 JSON 的array(方括号[])。但是在反序列化(json.load)时,JSON 数组会统一恢复为 Python 列表(list),原本的元组不可变特性不会保留。 - 布尔值与空值转换:Python 的
True/False映射为 JSON 的小写true/false;Python 的None对应 JSON 的null。
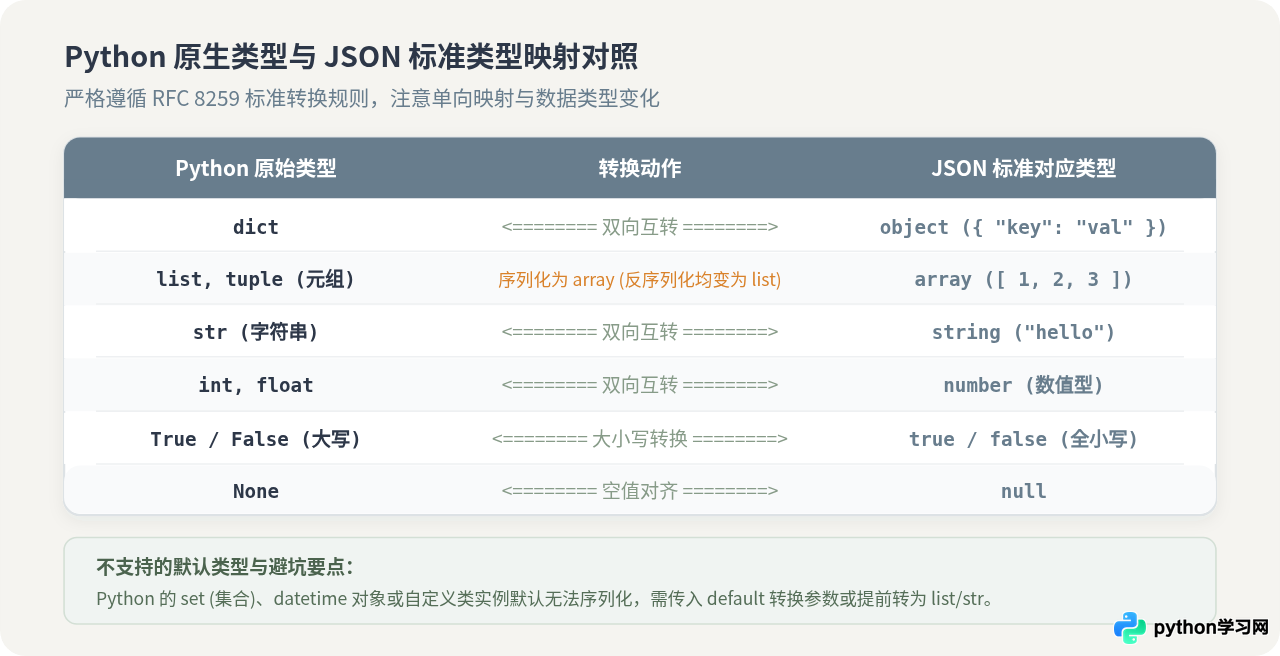
对于 Python 标准库中常见的特殊类型(如 datetime 日期时间对象、set 集合或自定义类的实例),标准 json 模块默认无法识别,会抛出 TypeError: Object of type ... is not JSON serializable。应对方案通常是在写入前手动转为字符串/列表,或在 dump 中传入 default=str 自定义转换函数:
from datetime import datetime
import json

log_entry = {
    "timestamp": datetime.now(),
    "unique_tags": {"python", "json", "backend"}  # set 集合
}

# 使用 default=str 将无法识别的对象自动转为字符串格式
with open("log.json", "w", encoding="utf-8") as f:
    json.dump(log_entry, f, ensure_ascii=False, indent=2, default=str)
四、生产环境必背参数与三大避坑要点
在实际工程代码中,仅仅调用 json.dump(data, f) 往往无法达到生产级健壮要求。以下四大参数与防坑要点是编写高质量代码的关键。
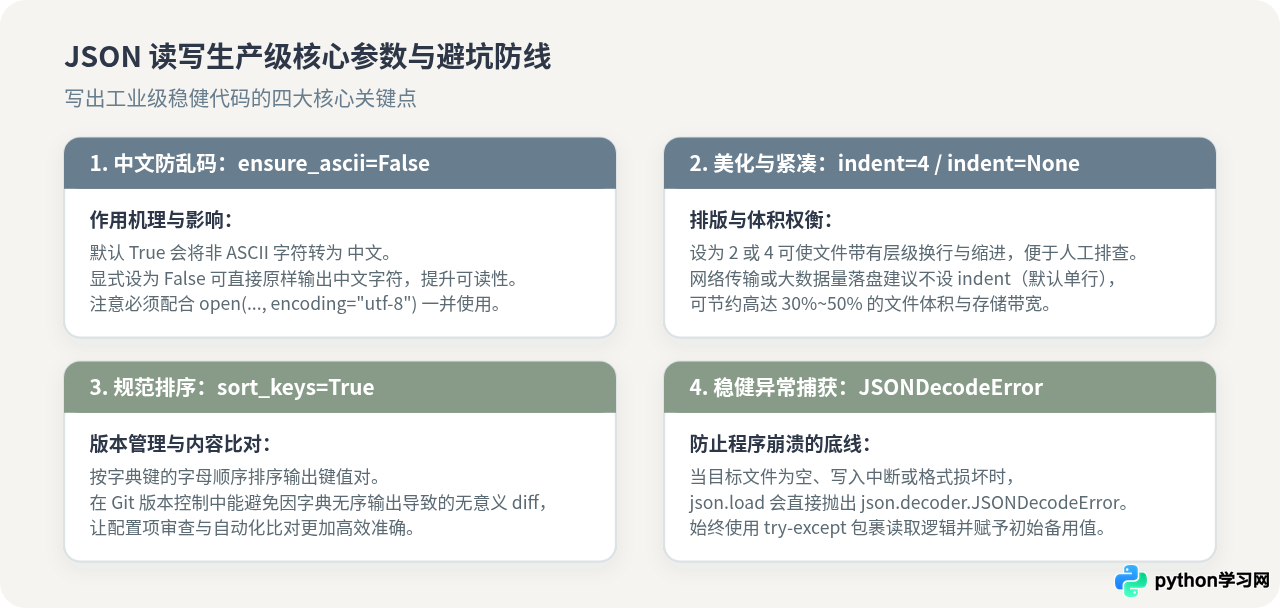
1. 避开中文乱码陷阱:ensure_ascii=False 与 encoding="utf-8" 双保险
json.dump() 的参数 ensure_ascii 默认值为 True。如果保持默认设置,所有非 ASCII 字符(包括中文字符)都会被自动转义为 Unicode 编码形式(如 中文)。虽然反序列化时能正常解析,但直接查看文件时人类无法阅读,且增加了存储体积。
标准做法:必须同时满足两个条件——open() 时指定 encoding="utf-8",且 dump() 时指定 ensure_ascii=False,两者缺一不可。只设置 ensure_ascii=False 而未指定 UTF-8 编码,在 Windows 系统下可能按系统默认的 GBK 编码写入,进而引发乱码或崩溃。
2. 美化排版与存储体积的平衡:indent 参数的合理选择
indent 控制 JSON 输出时的缩进空格数:
- 本地调试与配置文件(
indent=4或indent=2):自动换行并缩进,极大方便运维与开发人员查阅、修改配置。 - 网络传输与海量日志(不传
indent或indent=None):输出紧凑的单行压缩 JSON,没有多余的空格与换行符,能减少 30% 到 50% 的文件体积,节约磁盘 I/O 与传输带宽。
3. 异常容错机制:捕获 FileNotFoundError 与 JSONDecodeError
读取外部文件属于高危 I/O 操作。若文件不存在会引发 FileNotFoundError;若文件内容为空(0 字节)或被意外修改破坏了结构(例如缺少闭合大括号),json.load() 会抛出 json.decoder.JSONDecodeError。生产代码中应当使用 try-except 结构妥善包裹:
import json
from json.decoder import JSONDecodeError

def safe_load_config(file_path, default_config=None):
    """安全读取 JSON 配置,带完备的容错降级机制"""
    if default_config is None:
        default_config = {}

    try:
        with open(file_path, "r", encoding="utf-8") as f:
            return json.load(f)
    except FileNotFoundError:
        print(f"提示:文件 {file_path} 不存在,返回默认配置。")
        return default_config
    except JSONDecodeError as err:
        print(f"警告:文件 {file_path} 格式损坏({err}),返回默认配置。")
        return default_config
五、实战范式:配置文件的“读取-修改-回写”完整代码
在实际业务中,最频繁的组合需求是先读取旧文件,对其中的部分配置项进行更新,然后重新写回磁盘。这里给出可以直接套用的工业级实战脚本:
import json
import os

CONFIG_FILE = "user_settings.json"

# 1. 初始化或安全读取现有数据
if os.path.exists(CONFIG_FILE):
    with open(CONFIG_FILE, "r", encoding="utf-8") as f:
        try:
            settings = json.load(f)
        except json.JSONDecodeError:
            settings = {}
else:
    settings = {}

# 2. 修改业务字段(若字段不存在则自动创建,存在则覆盖更新)
settings["last_login"] = "2026-11-11 18:00:00"
settings["login_count"] = settings.get("login_count", 0) + 1
settings["theme"] = "dark"

# 3. 规范写回文件
with open(CONFIG_FILE, "w", encoding="utf-8") as f:
    json.dump(settings, f, ensure_ascii=False, indent=4)

print(f"配置更新完成!当前登录次数: {settings['login_count']}"){
"last_login": "2026-11-11 18:00:00",
"login_count": 1,
"theme": "dark"
}- 写文件:
with open(..., "w", encoding="utf-8") as f: json.dump(data, f, ensure_ascii=False, indent=4) - 读文件:
with open(..., "r", encoding="utf-8") as f: data = json.load(f) - 牢记口诀:文件直连无
s,内存转串必带s;中文防乱码,utf-8配ensure_ascii=False。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









