

面试被问seaborn0.13为什么适配pandas新版本怎么答?
针对技术面试中关于 seaborn 0.13 为何适配 pandas 新版本的考察,系统拆解 pandas 2.0 破坏性升级背后的 API 移除、PyArrow 类型系统、时间戳精度与 observed 分组机制,并给出结构化的三层递进作答推演模板与排障指南。
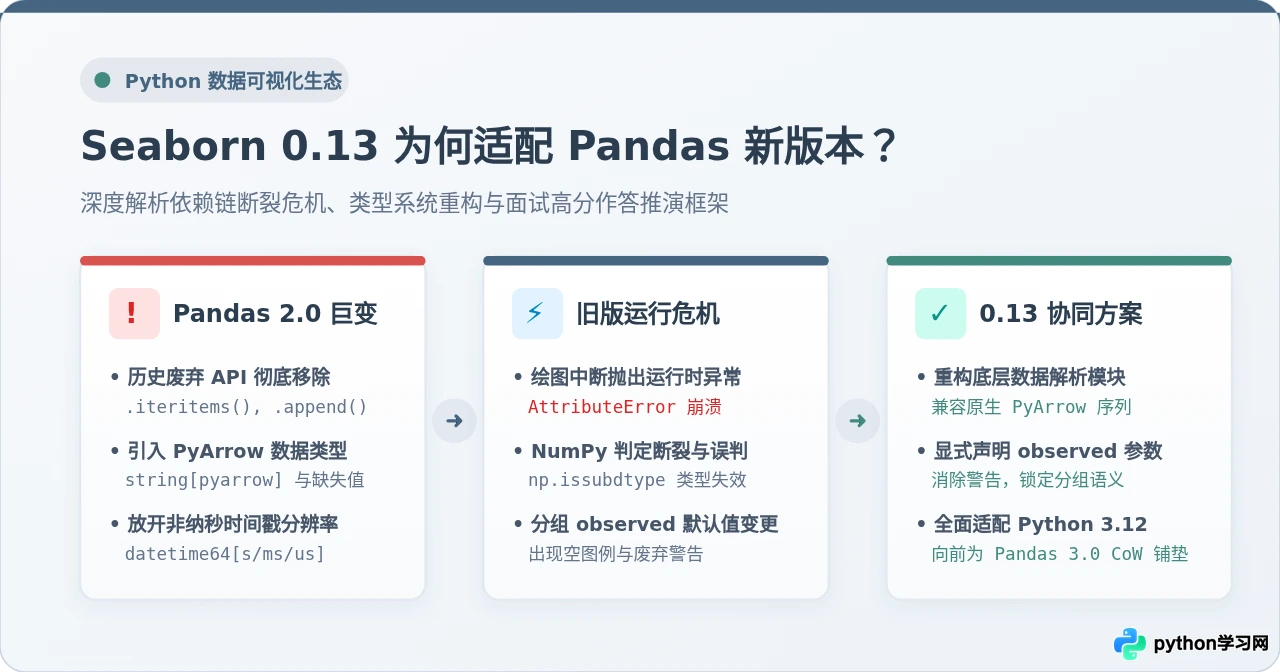
面试中被问到“seaborn 0.13 为什么适配 pandas 新版本”,核心在于考察你是否理解 Python 数据分析生态的基础设施演进,以及是否具备定位底层库破坏性升级(Breaking Changes)导致生产崩溃的排障能力。回答的核心结论应当直接干脆:pandas 2.0 引入了以 Apache PyArrow 原生后端、非纳秒时间戳放开、历史废弃接口物理移除(如 Series.iteritems() 与 DataFrame.append())以及分类分组 observed 参数语义变更为代表的破坏性重大重构;旧版 seaborn(如 0.12 及更早版本)由于强依赖废弃方法和纯 NumPy 数据类型假设,在连接 pandas 2.x 时会直接触发 AttributeError 崩溃或产生错误的分面统计。因此,seaborn 0.13 的发布是一次为了保障整个统计绘图管道不发生雪崩式断裂的关键技术适配。
一、为什么面试官喜欢考察这个看似冷门的问题?
表面上看,这只是一个 Python 库小版本号(0.12 到 0.13)的升级说明,但技术面试官提出此题通常带有三个层次的评估目的:
- 评估依赖链认知:你是否清楚
pandas、seaborn、matplotlib和numpy之间的层级调用拓扑,还是仅仅停留在调用sns.scatterplot()的表层 API 搬运阶段; - 评估源码排障深度:当团队升级基础镜像或依赖环境遇到
AttributeError: 'Series' object has no attribute 'iteritems'时,你是否能立刻定位到底层依赖冲突并给出优雅解法; - 评估前瞻架构视野:你是否关注到 pandas 从纯 NumPy 数组走向 PyArrow 列式存储和 Copy-on-Write(写时复制)机制的技术趋势。
二、Pandas 2.0+ 的四大破坏性变更与致错机理
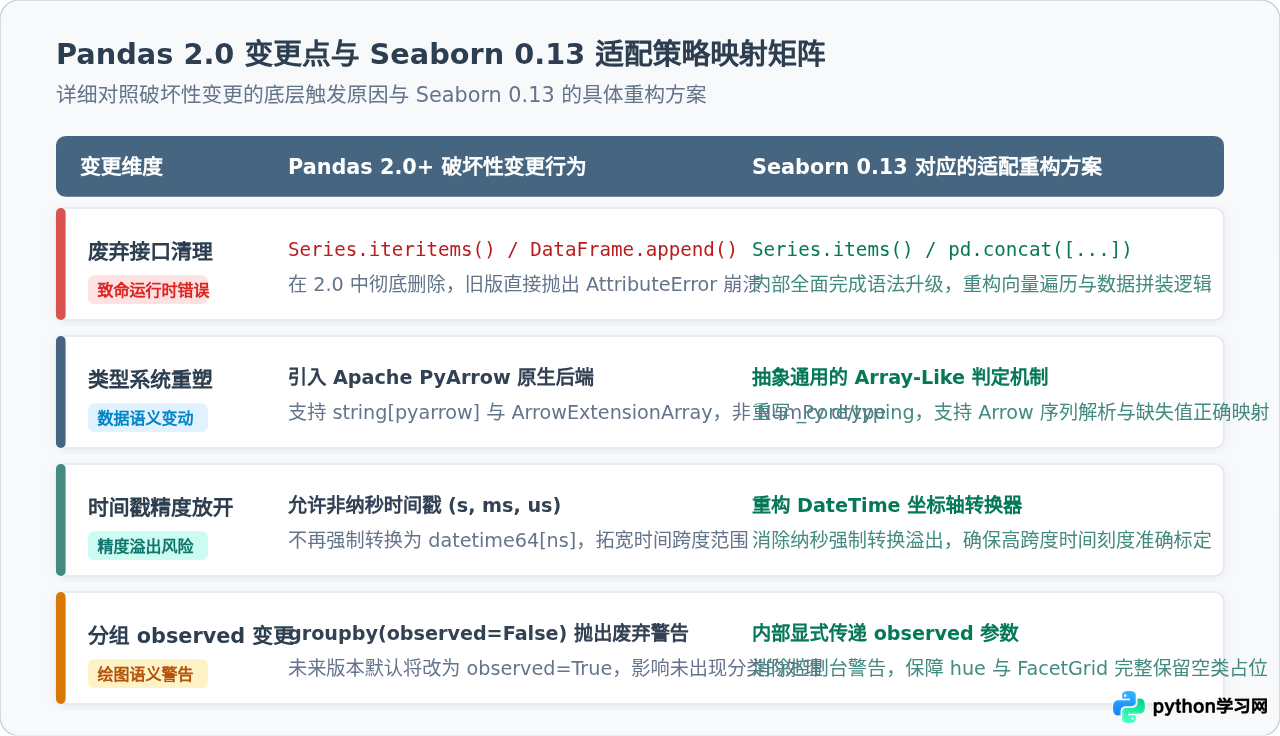
要完整答好该题,必须精准列举 pandas 2.0 版本到底做了哪些打破向下兼容(Backward Compatibility)的重构。这些改动正是旧版 seaborn 无法正常工作的原因:
1. 历史长期废弃 API 的彻底移除(Physical Removal)
在 pandas 1.x 时代,许多方法已被标记为废弃(Deprecation),但为了兼容性仍保留在代码库中。而在 pandas 2.0.0 中,核心开发团队清理了大量冗余 API:
Series.iteritems()彻底删除:官方将其统一为符合 Python 迭代规范的Series.items()。seaborn 0.12 内部许多解析序列和配对标签的底层函数大量调用了.iteritems(),直接导致 Python 抛出不可捕获的AttributeError。DataFrame.append()彻底删除:旧版本中通过append逐行或合并拼接数据帧的代码全部失效,必须迁移至pd.concat([...])。
在安装了 pandas>=2.0.0 却依然使用 seaborn==0.12.2 的环境中,执行简单的统计绘图便会立即中断:
# 报错示例:旧版 seaborn 在 pandas 2.x 环境下运行
import pandas as pd
import seaborn as sns

df = pd.DataFrame({"group": ["A", "B", "A"], "value": [10, 20, 15]})
# 当底层内部循环遍历 Series 键值对时
sns.barplot(data=df, x="group", y="value")

# 终端输出调用栈最后一行:
# AttributeError: 'Series' object has no attribute 'iteritems'
2. 引入 Apache PyArrow 原生后端与 Nullable 类型扩展
pandas 2.0 最关键的技术跃迁是正式支持 PyArrow 作为数据引擎。用户可以通过 dtype_backend="pyarrow" 或创建 pd.ArrowDtype 来利用高效的列式内存布局与更完善的原生缺失值(Null/NA)处理机制。
旧版 seaborn 的类型推断系统(_core/typing.py 及相关工具函数)假设所有数值列或分类列都是标准的 NumPy ndarray,并频繁调用 np.issubdtype(s.dtype, np.number) 进行类型分支判断。当传入 PyArrow 支持的字符串(string[pyarrow])或数值类型时,传统的 NumPy 函数会抛出类型无法识别的异常,甚至将有效数据误判为不受支持的 Object 类型。
3. 时间戳非纳秒分辨率(Non-nanosecond Timestamps)
在 pandas 2.0 之前,所有的日期时间类型 datetime64 均被强制约束为纳秒精度(datetime64[ns])。这导致 pandas 无法表达早于公元 1677 年或晚于 2262 年的时间戳。pandas 2.0 解除了该限制,支持秒(s)、毫秒(ms)与微秒(us)分辨率。
seaborn 内置的时间序列转换器(DateTime Converter)曾硬编码依赖纳秒时间刻度的数学运算。如果用户传入秒级或微秒级的时间序列,旧版转换逻辑会出现刻度单位错位甚至整型溢出错误。
4. groupby(observed=...) 默认值变更与分类变量空类表现
在对 Categorical(分类类型)数据执行 groupby 时,observed 参数控制是否计算在数据集中没有出现过的类别。pandas 2.0 针对 observed=False 发出 Future/Deprecation 告警,并将在未来版本默认改为 observed=True。
seaborn 高度依赖分类变量进行 hue(颜色分类)、style(标记形态)以及 FacetGrid 分面映射。若未明确设置 observed 参数,绘图时控制台会充斥大量红色告警信息;更严重的是,可能导致分类轴上的空占位符突然消失,破坏多子图对比的轴对齐效果。
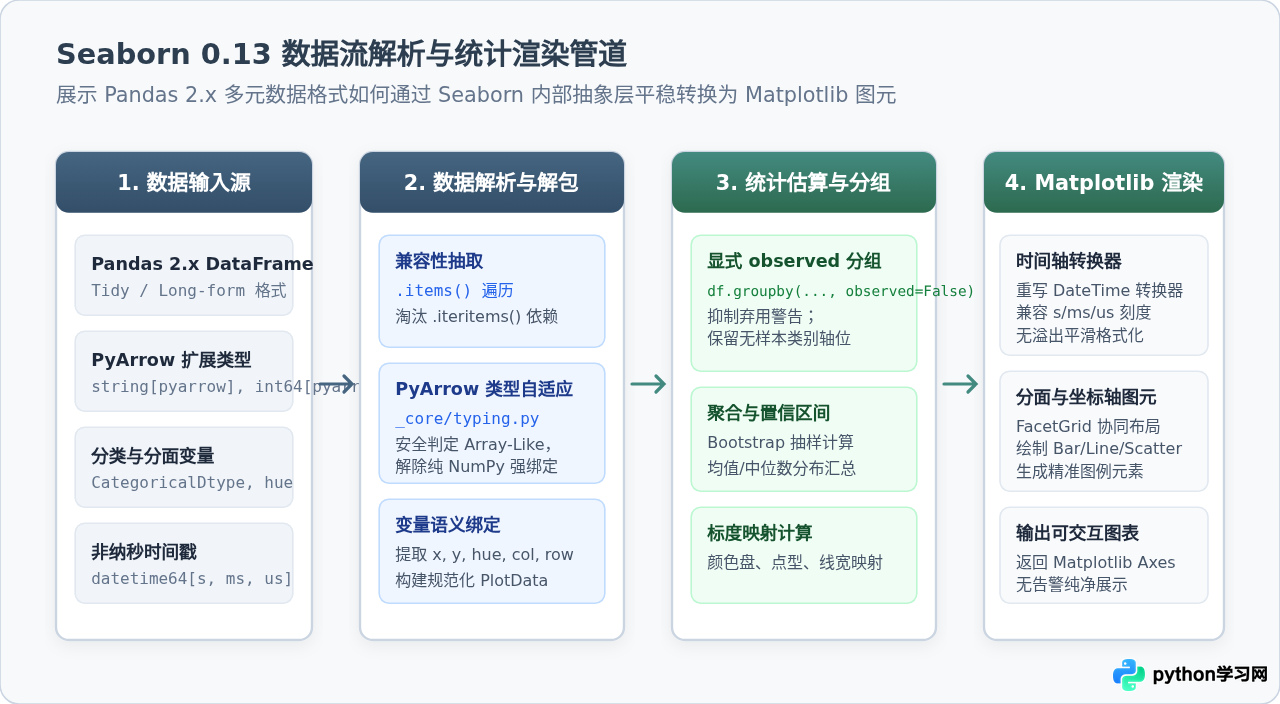
三、Seaborn 0.13 内部做了哪些工程适配?
在阐述完原因后,向面试官展示你对 seaborn 0.13 官方解决思路的理解,能够充分展现你的工程功底:
| 适配模块 | 内部改动细节 | 解决的问题与技术收益 |
|---|---|---|
| 数据提取管道 | 全面替换弃用 API,采用 Series.items() 替代 .iteritems(),清理所有 DataFrame.append。 |
消除 AttributeError,实现全生命周期零语法崩溃。 |
| 通用序列抽象 | 重构 _core/typing.py,解耦对原生 NumPy dtype 的直接断言,支持 Arrow 序列协议。 |
原生支持 PyArrow 存储引擎,保证复杂混合类型正常映射为图表通道。 |
| 分组与统计估算 | 在所有内部统计调用(如 _stats/ 及聚合函数)中显式显式传递 observed=False 或自适应传参。 |
消除控制台大批告警,确保分面网格(FacetGrid)坐标刻度对齐稳定。 |
| 日期轴渲染器 | 升级与 Matplotlib 的坐标格式化交互,自适应 s/ms/us/ns 单位。 |
支持超大跨度(历史或超远未来)时间序列的可视化呈现。 |
四、标准面试应答模板:三层推进法
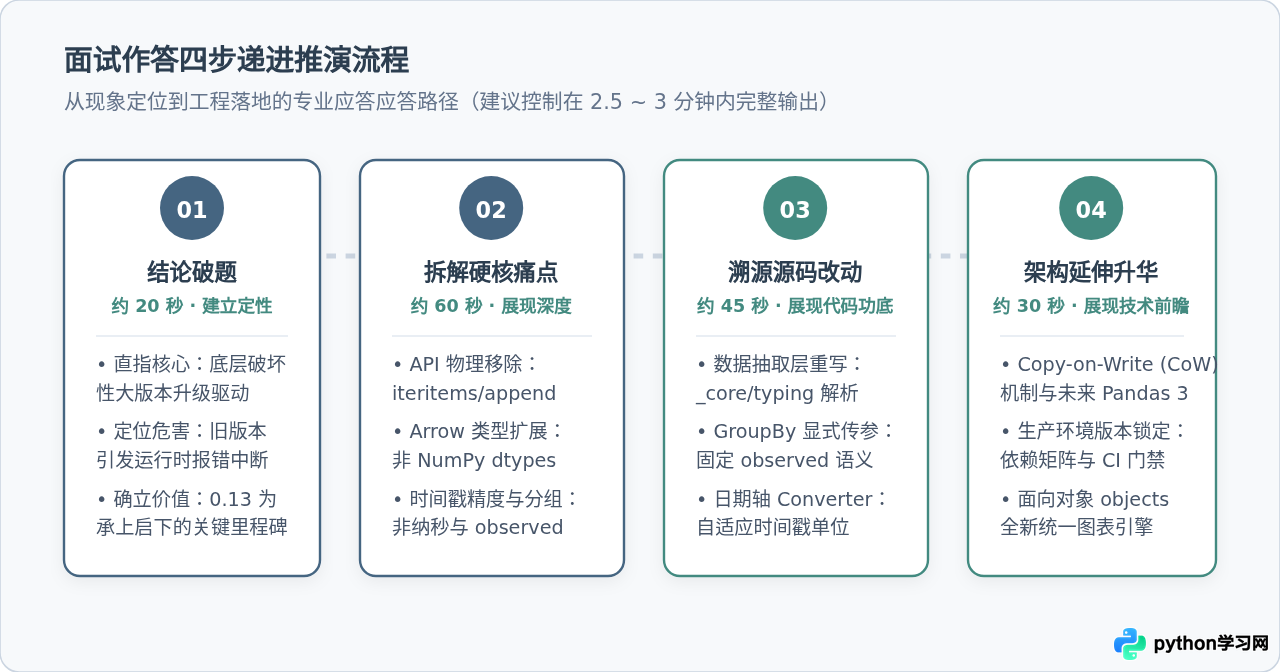
在实际面试过程中,切忌毫无条理地东拼西凑。推荐使用“三层推进法”,在 2 到 3 分钟内层层深入,从宏观到微观再到前瞻:
第一层:宏观定性(30秒结论先行)
“面试官您好,seaborn 0.13 适配 pandas 新版本(特别是 pandas 2.0+),主要是因为底层的破坏性重大重构(Breaking Changes)。pandas 2.0 彻底移除了长期废弃的历史 API(如 Series.iteritems()),同时引入了以 Apache PyArrow 原生后端、非纳秒时间戳分辨率、以及 groupby 中 observed 参数默认值变更为代表的新特性。如果不进行深度适配,旧版 seaborn 在运行时会直接抛出 AttributeError 崩溃,或者产生类型解析断裂。因此 seaborn 0.13 是一次至关重要的依赖协同升级。”
第二层:微观技术拆解(90秒讲透机理)
“具体体现在三个关键的技术冲突点:
- 首先是 API 物理层面的移除:旧版 seaborn 在遍历 Series 标签时使用了
.iteritems(),而在 pandas 2.0 中该方法被直接剔除,导致基础图表在实例化时直接报错中断。seaborn 0.13 全面重构为.items()。 - 其次是类型推断系统的革新:pandas 2.0 支持 PyArrow 后端与 Nullable 扩展类型,旧版 seaborn 强依赖
np.issubdtype等 NumPy 原生类型推导,面对 Arrow 字符串或布尔列时无法正确解析。0.13 升级了内部数据解析抽象,兼容了符合通用序列协议的数据结构。 - 最后是分组与时间尺度的鲁棒性:针对分类变量分组的
observed参数发出废弃告警的问题,0.13 在内部统计管道显式指定了参数,保障缺失类别占位不变;同时重新调整了对非纳秒时间戳(如微秒、秒级)的刻度映射,避免了纳秒强制转换造成的范围溢出。”
第三层:工程落地与未来视野(30秒升华技术高度)
“从工程实践角度来看,这次升级还为 Python 3.12 的支持以及未来即将到来的 pandas 3.0 全面默认 Copy-on-Write(写时复制)机制做好了准备,规避了由于链式赋值或内部视图修改导致的隐蔽内存副作用。在实际生产和微服务数据管道中,这也提示我们在构建 Docker 镜像或 CI/CD 构建矩阵时,必须建立严格的依赖版本锁(如 Poetry/Pipenv),防止因为上游主版本号跳升而引发运行故障。”
五、工程验证与环境排障注意事项
如果你在维护老项目或者排查线上数据分析服务,遇到此类依赖报错,建议按以下步骤进行环境治理:
1. 查看当前环境的版本依赖配比
# 检查当前运行环境的依赖版本
python -c "import pandas, seaborn; print('pandas:', pandas.__version__); print('seaborn:', seaborn.__version__)"如果项目中使用了 pandas >= 2.0.0,请务必保证 seaborn >= 0.13.0。在 pyproject.toml 或 requirements.txt 中配置合理的依赖约束范围:
# 推荐的生产依赖约束范式
pandas>=2.0.0,<3.0.0
seaborn>=0.13.0,<0.14.0
2. 验证 PyArrow 后端是否能够正常渲染图表
升级到 seaborn 0.13 之后,可以运行以下测试脚本,验证 Arrow 后端列是否可以正确流入绘图流水线:
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

# 使用 PyArrow 字符串与整数列
df = pd.DataFrame({
    "category": pd.Series(["Alpha", "Beta", "Gamma"], dtype="string[pyarrow]"),
    "count": pd.Series([120, 240, 180], dtype="int64[pyarrow]")
})

# 在 seaborn 0.13 中能够平稳识别并完成标度映射
ax = sns.barplot(data=df, x="category", y="count")
ax.set_title("PyArrow Backend Compatibility Test")
plt.close()
print("测试通过:Seaborn 0.13 成功渲染 PyArrow 类型数据!")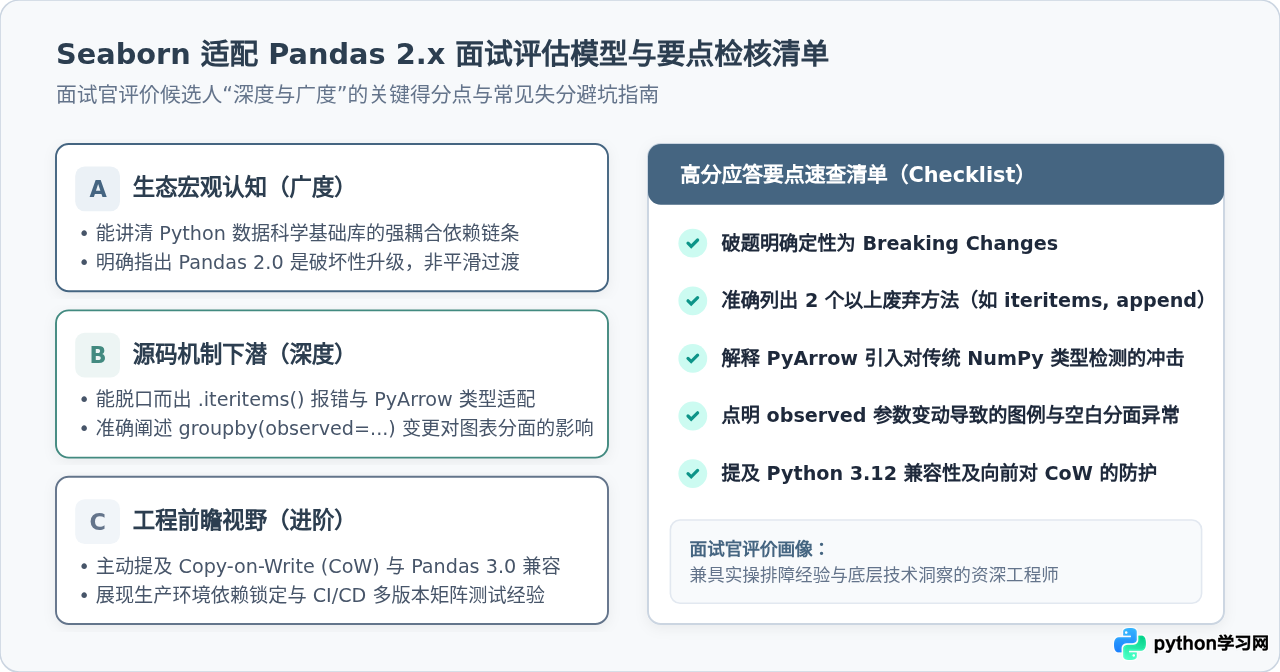
六、全文总结与要点速记
回答“seaborn 0.13 为什么适配 pandas 新版本”时,切忌仅回答“因为版本过旧会有 bug”。优秀的技术回答应当包含三个清晰的层次:
- 定性直接:说明核心原因在于 pandas 2.0 打破向下兼容的破坏性演进(Breaking Changes)。
- 细节精准:点出
Series.iteritems()移除、PyArrow 类型集成、时间戳精度放开以及observed参数这四个关键技术痛点。 - 视野完整:结合开源生态的演化历程,阐述 Copy-on-Write 机制与工程依赖锁定的最佳实践。
掌握这套结构化的知识体系与答题框架,不仅能完美通过面试中的底层机制考核,更能在日常工程实践中帮助团队规避偶发性生产事故。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









