

Python读取文件中文乱码怎么办?encoding参数设置详解
深入详解Python读取文本文件出现中文乱码或UnicodeDecodeError的根本原因与排查步骤,系统解析open()函数中encoding与errors参数的正确设置方法与跨平台工程实践。
核心结论速览:在 Python 中读取文本文件遭遇中文乱码或 UnicodeDecodeError 崩溃,根本原因在于“文件保存时所用的编码方式”与“Python 读取解码时采用的编码方式”不一致。彻底解决该问题的方法,是在调用 open() 函数时显式指定 encoding 参数(最常用为 encoding='utf-8' 或针对 Windows 历史文件的 encoding='gb18030'),消除对操作系统隐式区域设置(Locale)的依赖。
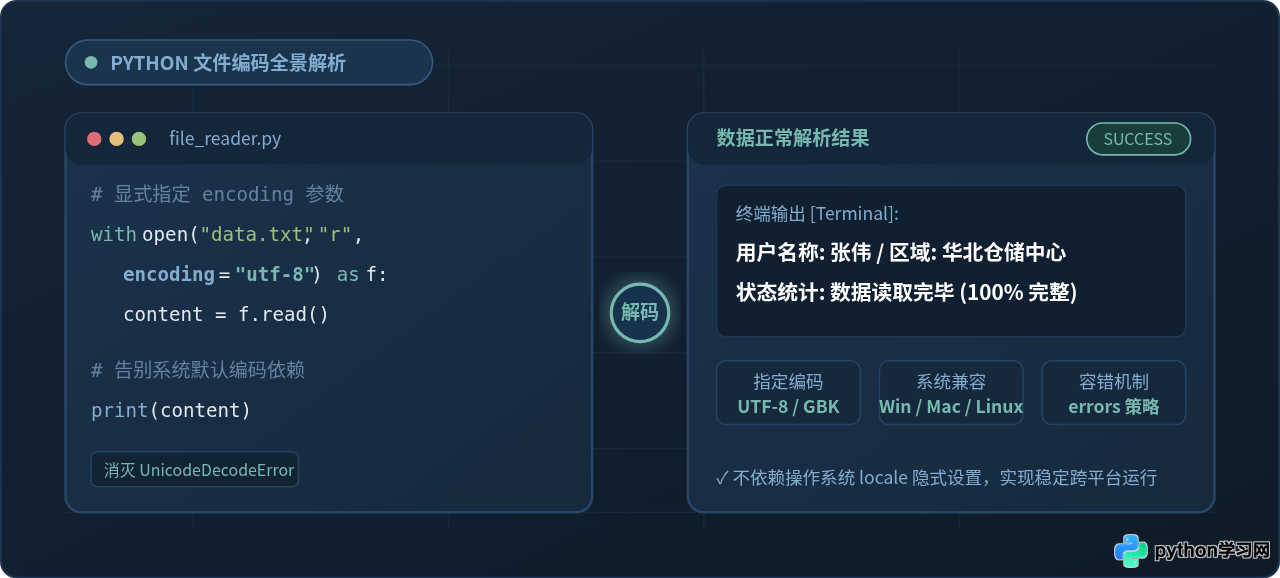
一、情境复现:你是否也被这个经典报错困扰?
假设你在日常工作中需要处理一份由数据系统导出的中文文本报表 sales_data.txt,内容包含用户姓名与发货城市。按照常见习惯,你写下了如下几行简洁的 Python 代码:
# 未指定 encoding 参数的简写读取
with open("sales_data.txt", "r") as f:
    content = f.read()
print(content)
如果这段代码运行在 macOS 或大多数 Linux 操作系统中,可能一切顺利;但一旦将脚本放到中文版 Windows 系统上运行,控制台往往会立刻抛出如下异常并中断程序:
File "read_example.py", line 2, in <module>
content = f.read()
UnicodeDecodeError: 'gbk' codec can't decode byte 0xaa in position 14: illegal multibyte sequence
还有另一种更具迷惑性的隐蔽现象:程序并没有崩溃报错,但终端打印出的中文全部变成了乱七八糟的符号,例如 å¼ ä¼ 或一长串不可读的问号。这两种现象的本质完全相同——编码规则在解码阶段发生了错位。
二、根源解析:为什么会乱码?字符、字节与 encoding 的底层关系
要真正解决乱码,首先需要理解计算机存储文本的基本事实:
- 物理世界只有字节:磁盘、固态硬盘、网络传输中存储和流转的全部都是二进制字节流(bytes,即形如
0xE4, 0xB8, 0xAD的原始数值)。 - 人类眼中才是字符:人类能够理解并阅读的汉字、英文字母、标点符号称为字符(str,例如汉字“中”)。
- 编码(Encode)与解码(Decode):将人类可读的“字符”按照特定规则转换成二进制“字节”的过程称为编码;反之,将二进制“字节”按照规则翻译还原为人类字符的过程称为解码。
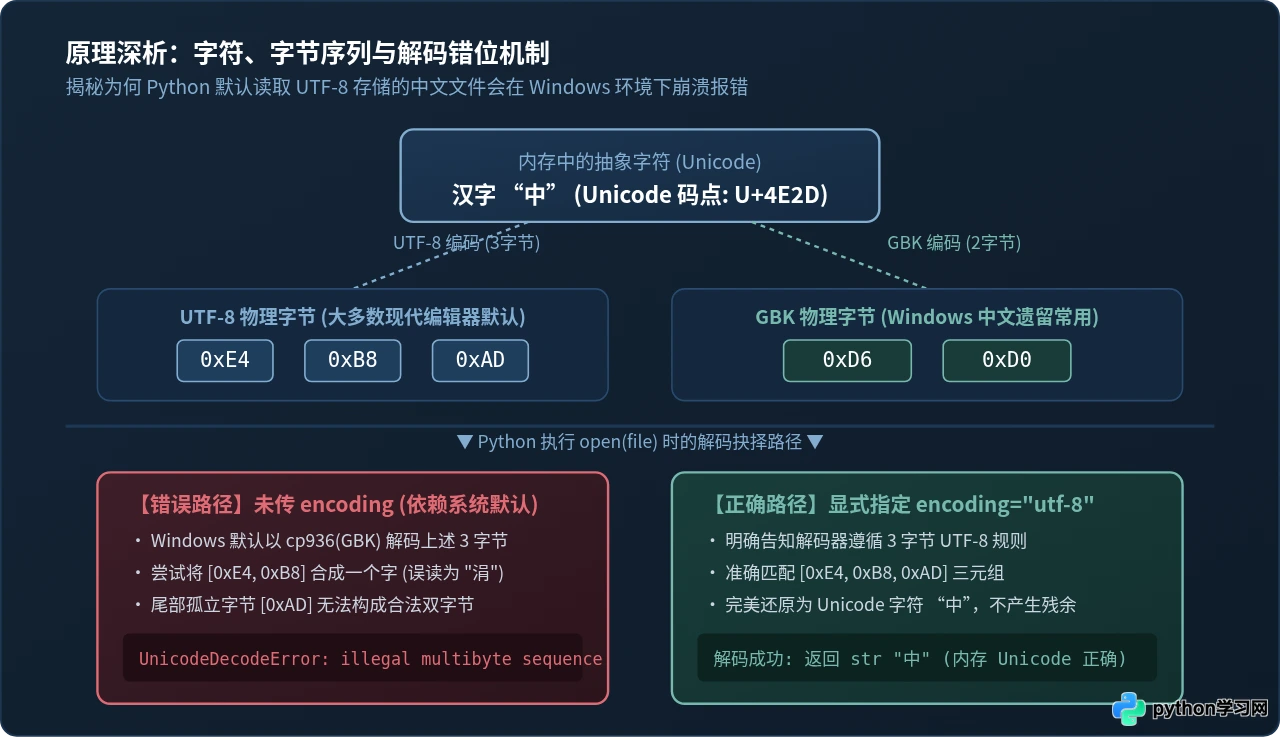
在中文文本处理中,最常出现的两套编码规则是 UTF-8 和 GBK 系列(含 GB2312、GB18030)。它们为同一个汉字分配的字节长度和具体数值截然不同:
| 字符对象 | Unicode 标量码点 | UTF-8 编码后的物理字节 | GBK 编码后的物理字节 |
|---|---|---|---|
| 中 | U+4E2D |
3 字节: 0xE4 0xB8 0xAD |
2 字节: 0xD6 0xD0 |
| 文 | U+6587 |
3 字节: 0xE6 0x96 0x87 |
2 字节: 0xCE 0xC4 |
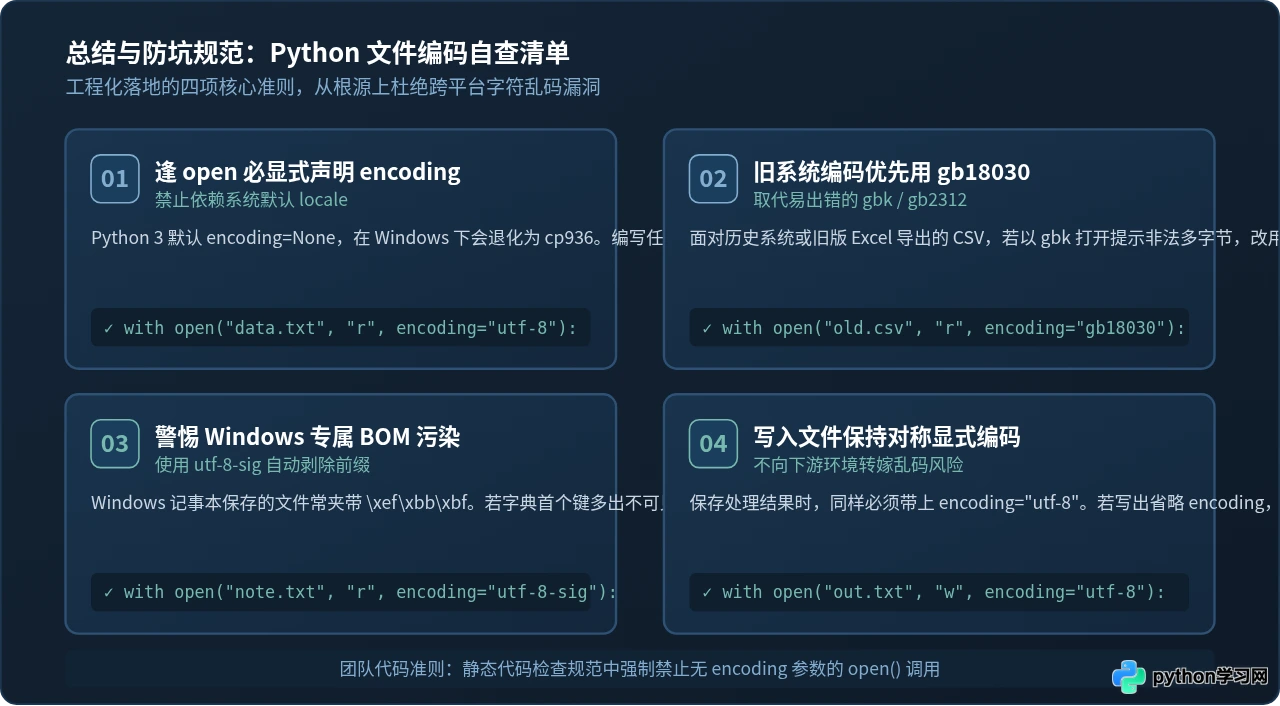
在 Python 3 中,当你调用 open(filename, 'r') 而没有传递 encoding 参数时,Python 的底层默认行为并非假定为 UTF-8,而是自动调用操作系统当前的本地化区域编码(Locale Preferred Encoding):
- 在中文版 Windows 下,系统的默认编码通常是代码页 936(
cp936,即 GBK)。 - 在 Linux 和 macOS 下,现代系统的默认编码通常是 UTF-8。
因此,当一个在 VS Code 或 Linux 环境下保存为 UTF-8 编码的文件被拷贝到 Windows 下,Python 默认用 GBK 解码器去逐个读取 3 字节的 UTF-8 序列。GBK 解码器习惯每次抓取 2 个字节来拼装汉字,抓完前两个字节后,第三个多余字节便无法匹配任何合法的 GBK 汉字规则,系统便毫不留情地抛出了 UnicodeDecodeError: 'gbk' codec can't decode byte... 异常。
三、排查与解决:标准五步故障处理流程
遇到中文乱码或解码异常时,切勿盲目尝试在代码里胡乱替换编码名称。遵循以下标准操作步骤,能够在几分钟内彻底定位并排除故障:
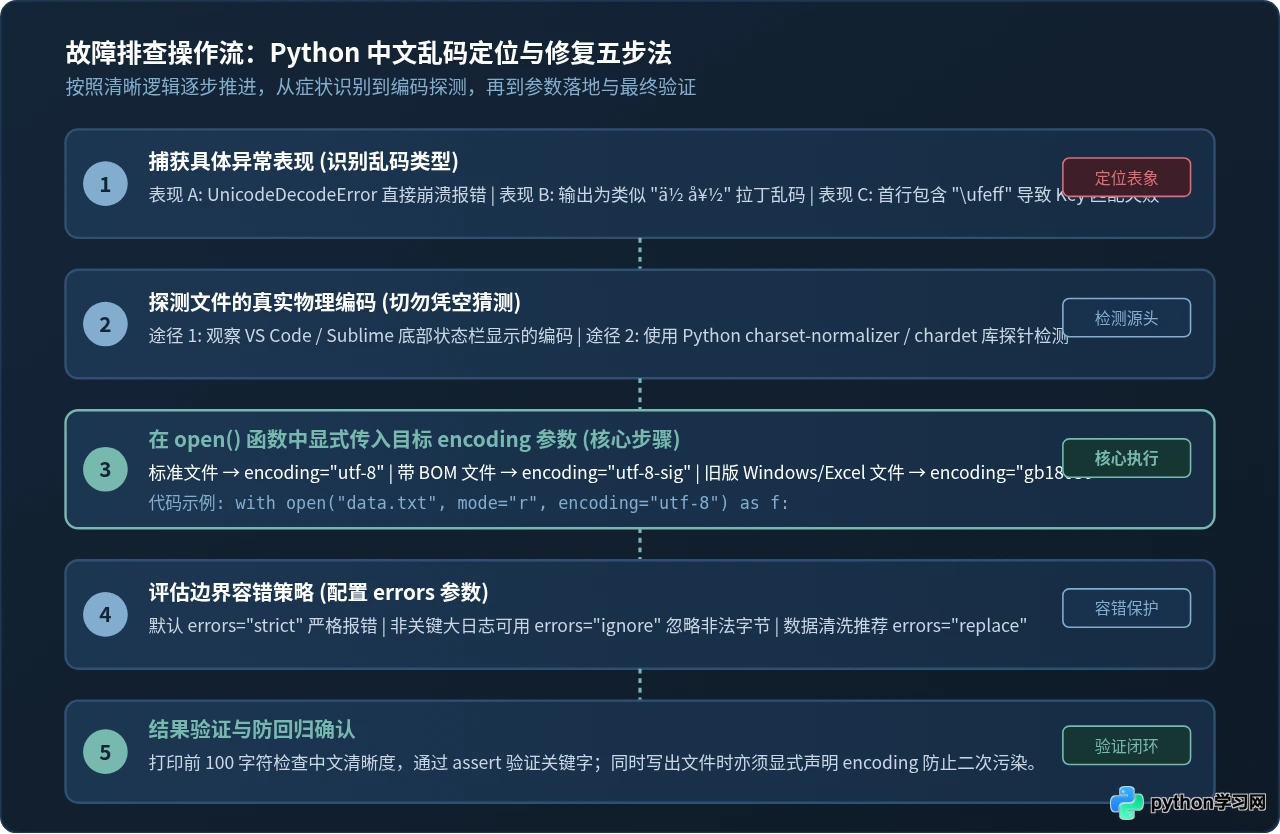
第 1 步:准确识别报错或异常表现
观察控制台的完整输出,通常可以分为以下三种情形:
- 直接抛出 UnicodeDecodeError:明确指出了是哪个 codec(如 'gbk' 或 'utf-8')在哪个位置无法解码,说明解码器与文件编码完全不对路。
- 输出显示为拉丁重音符号(如 å¼ ):说明源文件本身是 UTF-8 编码,但被错误地按照单字节的 Latin-1 / ISO-8859-1 解码。
- 打印内容正常,但字典 Key 或表头首项匹配失败:例如用 CSV 读取器处理首列时,打印出来看着像
id,实际比较却返回False。通过repr(first_line)查看会发现开头隐藏着一个零宽空格'',这是 Windows 记事本等工具特有的 BOM(Byte Order Mark)标记。
第 2 步:探测目标文件的实际保存编码
千万不要凭“感觉”猜测文件是什么编码。最稳妥的排查方式包括:
- 通过现代文本编辑器查看:用 VS Code 打开该文件,观察右下角状态栏。状态栏会直接显示当前文件的编码(例如 UTF-8、UTF-8 with BOM 或 GBK)。
- 在 Python 中通过探针库检测:如果面对的是自动化流程中的动态文件,可以使用标准第三方库
charset-normalizer或chardet读取前几个 KB 的原始二进制,推测其编码置信度。
第 3 步:在 open() 中显式写入 encoding 参数
确定源文件的真实编码后,在 Python 的 open() 函数中直接加入 encoding 参数,强制指定解码规则,消除环境差异。
四、encoding 参数设置详解与编码格式选型
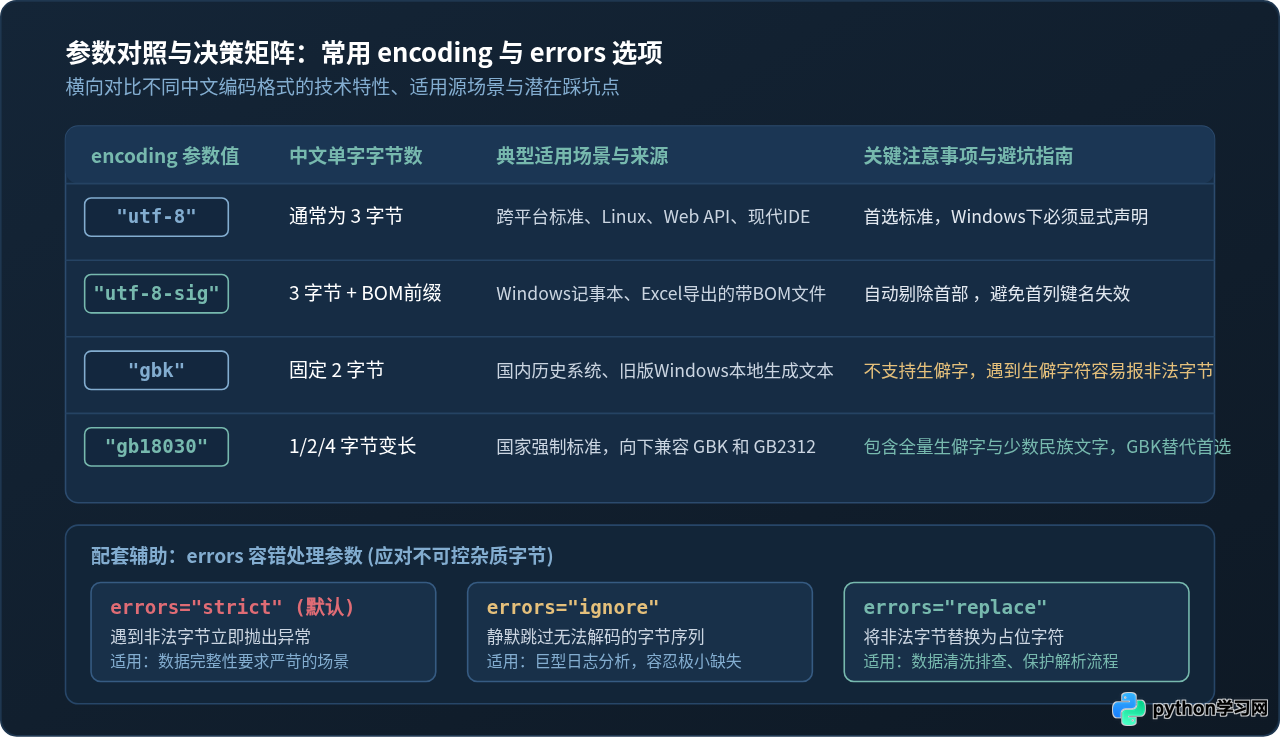
在 Python 的 open(file, mode='r', buffering=-1, encoding=None, errors=None, ...) 函数中,encoding 和 errors 是控制文本解码行为最重要的两个参数。下面详细拆解各选项的具体配置方法与选型依据:
1. encoding='utf-8':全球通用标准
这是现代软件工程的黄金标准。适用于几乎所有由 VS Code、PyCharm、现代 Web 框架、Linux 服务器输出的日志与数据文件。
# 读取标准 UTF-8 文件
with open("sales_data.txt", mode="r", encoding="utf-8") as f:
    text = f.read()
2. encoding='utf-8-sig':BOM 标记克星
在 Windows 环境下使用“记事本”新建并保存为 UTF-8,或者从某些历史版本 Excel 导出 CSV 时,系统会在文件开头悄悄写入 3 个隐藏字节:0xEF, 0xBB, 0xBF(即 UTF-8 BOM)。如果用常规的 encoding='utf-8' 读取,这 3 个字节会被解码成不可见的 Unicode 字符 ,附着在文本最开始。
解决方案:改用 encoding='utf-8-sig'。Python 会在读取时自动识别并剥除开头的 BOM 标记,若无 BOM 则正常按 UTF-8 读取,兼容性极高。
3. encoding='gb18030':强于 GBK 的终极后备
很多人在遇到 Windows 导出文件乱码时习惯填写 encoding='gbk'。然而在实际工程中,常有用户姓名包含生僻字(例如“镕”、“𫖮”、“赟”),或者包含了特殊标点,GBK 字符集收录不全,依然会报错。
最佳推荐:凡是判定为国内历史 Windows 系统、旧版 Excel CSV 导出的文件,直接优先配置 encoding='gb18030'。GB18030 是我国强制执行的国家标准,完美向下兼容 GBK 和 GB2312 的同时,收录了数万个生僻汉字与少数民族字符,能够彻底解决因个别特殊汉字导致的任务中断。
4. 进阶协同:errors 容错参数的配置技巧
当外部数据来源复杂(例如爬虫抓取的多来源网页、混杂了网络传输断包杂质的日志文件)时,个别异常字节可能无法被任何标准编码完整解析。此时可通过 errors 参数指定策略:
errors='strict'(默认):遇到任何不合规字节立即报错崩溃,适合严格财务、关键业务数据。errors='ignore':直接丢弃无法解码的非法字节,保证程序顺畅走完。适合解析 TB 级纯文本日志且不影响大局的场景。errors='replace':将无法识别的字节自动替换为 Unicode 替代符号�(即黑色菱形问号字符)。既保护了主流程不崩溃,又在输出中保留了错误发生位置的线索,是数据清洗的最佳选择。
# 宽容模式:使用 gb18030 配合 replace 策略,确保万无一失不崩溃
with open("untrusted_data.txt", mode="r", encoding="gb18030", errors="replace") as f:
    clean_content = f.read()
五、工程级代码示例与跨平台最佳实践
为了让大家在实际开发中有章可循,下面给出一套在工业级项目中经过验证的健壮文件读写范例。
完整示例:支持回退探测与防乱码安全读取
import os

def safe_read_text_file(filepath):
    """
    健壮的中文文件读取函数:
    依次尝试 utf-8-sig (涵盖标准 UTF-8 及带 BOM 文本) 与 gb18030,
    若均失败则降级为容错替换模式,杜绝崩溃。
    """
    if not os.path.exists(filepath):
        raise FileNotFoundError(f"文件未找到: {filepath}")

    # 优先尝试现代标准 UTF-8 (自动兼容 BOM)
    try:
        with open(filepath, mode="r", encoding="utf-8-sig") as f:
            return f.read(), "utf-8-sig"
    except UnicodeDecodeError:
        pass

    # 次选尝试国内历史全兼容标准 GB18030
    try:
        with open(filepath, mode="r", encoding="gb18030") as f:
            return f.read(), "gb18030"
    except UnicodeDecodeError:
        pass

    # 终极兜底策略:强制按 UTF-8 读取并替换异常字节
    with open(filepath, mode="r", encoding="utf-8", errors="replace") as f:
        return f.read(), "utf-8 (replace 模式)"

# 执行读取测试
if __name__ == "__main__":
    text, used_enc = safe_read_text_file("sales_data.txt")
    print(f"成功读取,所用编码: {used_enc}")
    print(f"前 50 字内容预览: {text[:50]}")
前 50 字内容预览: 订单编号,客户姓名,收货地址,支付状态
20261001,张伟,北京市海淀区中关村南大街1号,已结算
很多开发者在读取文件时记住了加上
encoding='utf-8',但在处理完数据使用 open(..., 'w') 保存时,又漏掉了该参数。在 Windows 机器上,这会导致写出的文件又被默认保存成 GBK 格式,给下游的同事或服务器埋下新的乱码炸弹。务必牢记:读写双向对称,均须显式指定。
六、高频常见问题与边界解答(FAQ)
Pandas 底层同样封装了文件读取逻辑,其 read_csv() 默认采用 UTF-8 编码。当遇到中文 CSV 报错时,请直接在函数中添加参数:df = pd.read_csv('data.csv', encoding='gb18030') 或针对 BOM 文件设置 encoding='utf-8-sig' 即可顺利解析。
因为“编码/解码”是将人类字符和二进制字节互相转换的桥梁。以 'rb'(Binary Read)模式打开文件时,Python 直接原封不动地返回磁盘上的原始 bytes 对象,不介入任何解码逻辑,因此无需指定也不支持 encoding 参数。如果后续需要转换为字符串,再手动调用 bytes.decode('utf-8') 即可。
这是因为旧版 Microsoft Excel 在 Windows 上打开 CSV 时,默认会用系统的本地编码(ANSI/GBK)去解析。若 CSV 保存为纯 UTF-8(无 BOM),Excel 识别不出其字符集便会乱码。此时应在保存 CSV 时指定 encoding='utf-8-sig',Excel 识别到文件开头的 BOM 标记就会自动以 UTF-8 规则正确渲染中文。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









