

Python怎么逐行读取文件内容
本文介绍在 Python 3 中逐行读取文本文件的三种核心方法:使用 for 循环迭代、结合 enumerate 处理行号与换行符、以及使用 readline 手动控制读取流程。同时解析 FileNotFoundError 和 UnicodeDecodeError 的成因与排查思路,帮助开发者在节省内存的同时准确处理文本数据。
直接遍历文件对象是 Python 处理大文本最高效的方式之一。它不需要一次性将所有内容加载到内存列表中,而是通过迭代器按需获取每一行。这种机制在处理日志文件或大型数据集时,能显著降低内存峰值,但前提是代码逻辑不要隐式地将所有行缓存起来。
1. 使用 for 循环逐行读取
最直观的逐行读取方式是直接对文件对象进行 for 循环迭代。假设当前工作目录下有一个名为 data.txt 的文件,内容包含“苹果”“香蕉”和“橙子”,每项占一行。
with open("data.txt", "r", encoding="utf-8") as file:
    for line in file:
        print(line, end="")
在 Windows 终端中,切换到文件所在目录后运行 py read_lines.py 或 python read_lines.py。open() 函数以文本模式打开文件,for line in file 利用文件对象的迭代协议逐行获取数据。每次循环中的 line 变量包含当前行的字符串内容,包括末尾的换行符。
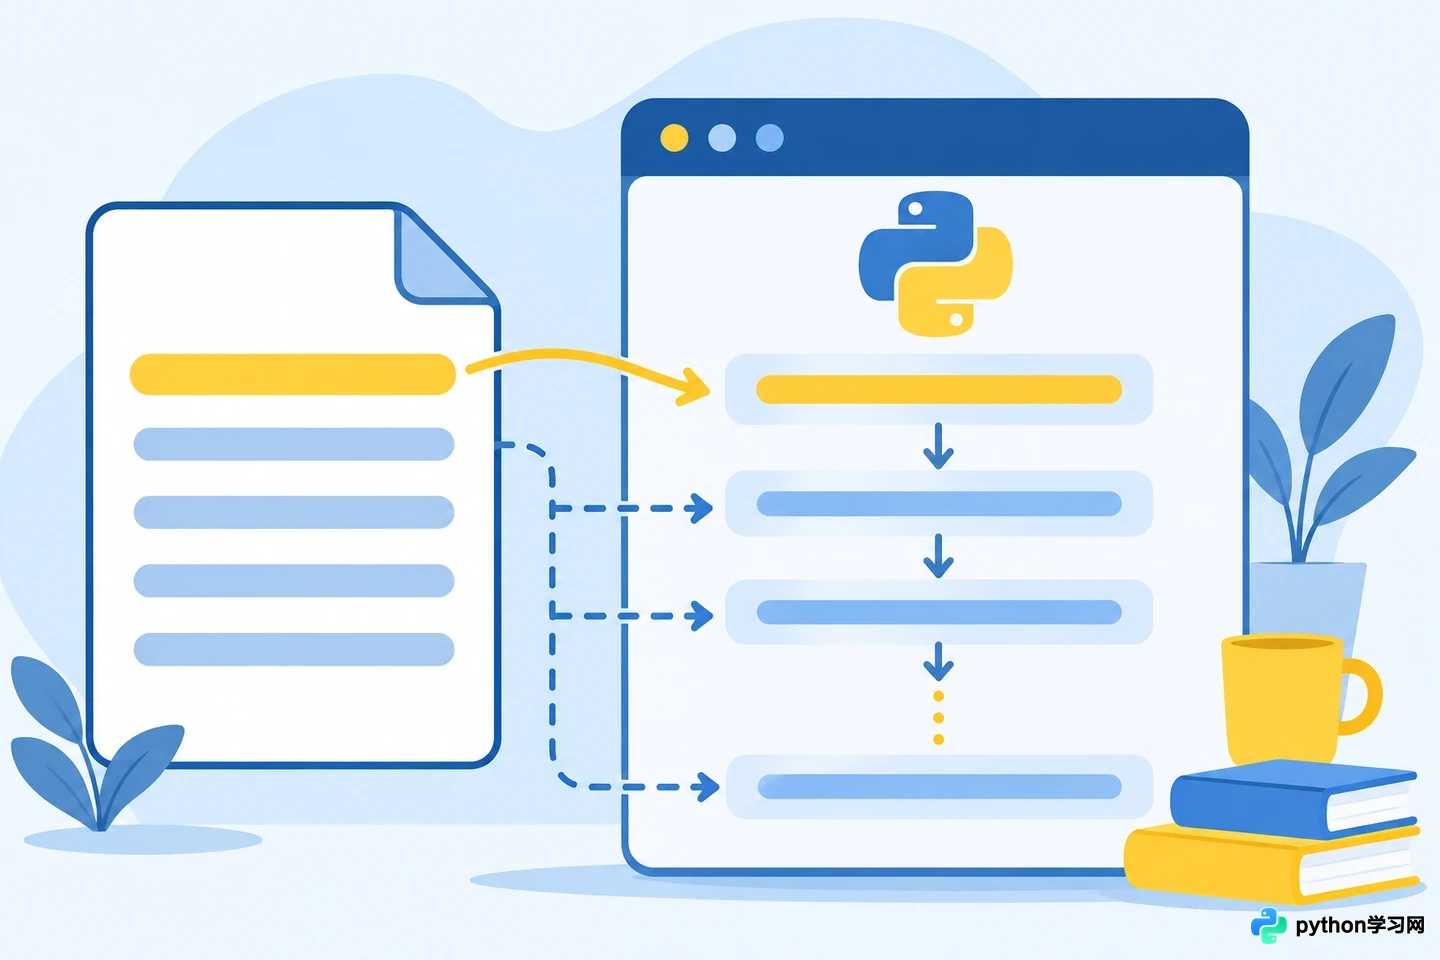
逐行迭代读取流程示意图
with 语句确保无论处理过程是否发生异常,文件都会在块结束后自动关闭。对于大文件,这种方式比 file.readlines() 更节省内存,因为后者会立即构建一个包含所有行的列表。如果业务逻辑只是逐行打印或简单过滤,直接迭代是首选。
2. 处理换行符和行号
文件中的每一行通常以换行符结尾。在 Windows 上可能是 \r\n,在 Linux/macOS 上是 \n。Python 在文本模式下会自动将各种换行符统一转换为 \n。因此,直接 print(line) 会导致输出中出现额外的空行,因为 print 默认也会添加一个换行符。
前例中使用 end="" 抑制了 print 的默认换行,从而保持原始格式。若需要对每行内容进行清洗或添加行号,可以使用 rstrip() 去除末尾换行符:
with open("data.txt", "r", encoding="utf-8") as file:
    for number, line in enumerate(file, start=1):
        content = line.rstrip("\n")
        print(f"{number}: {content}")
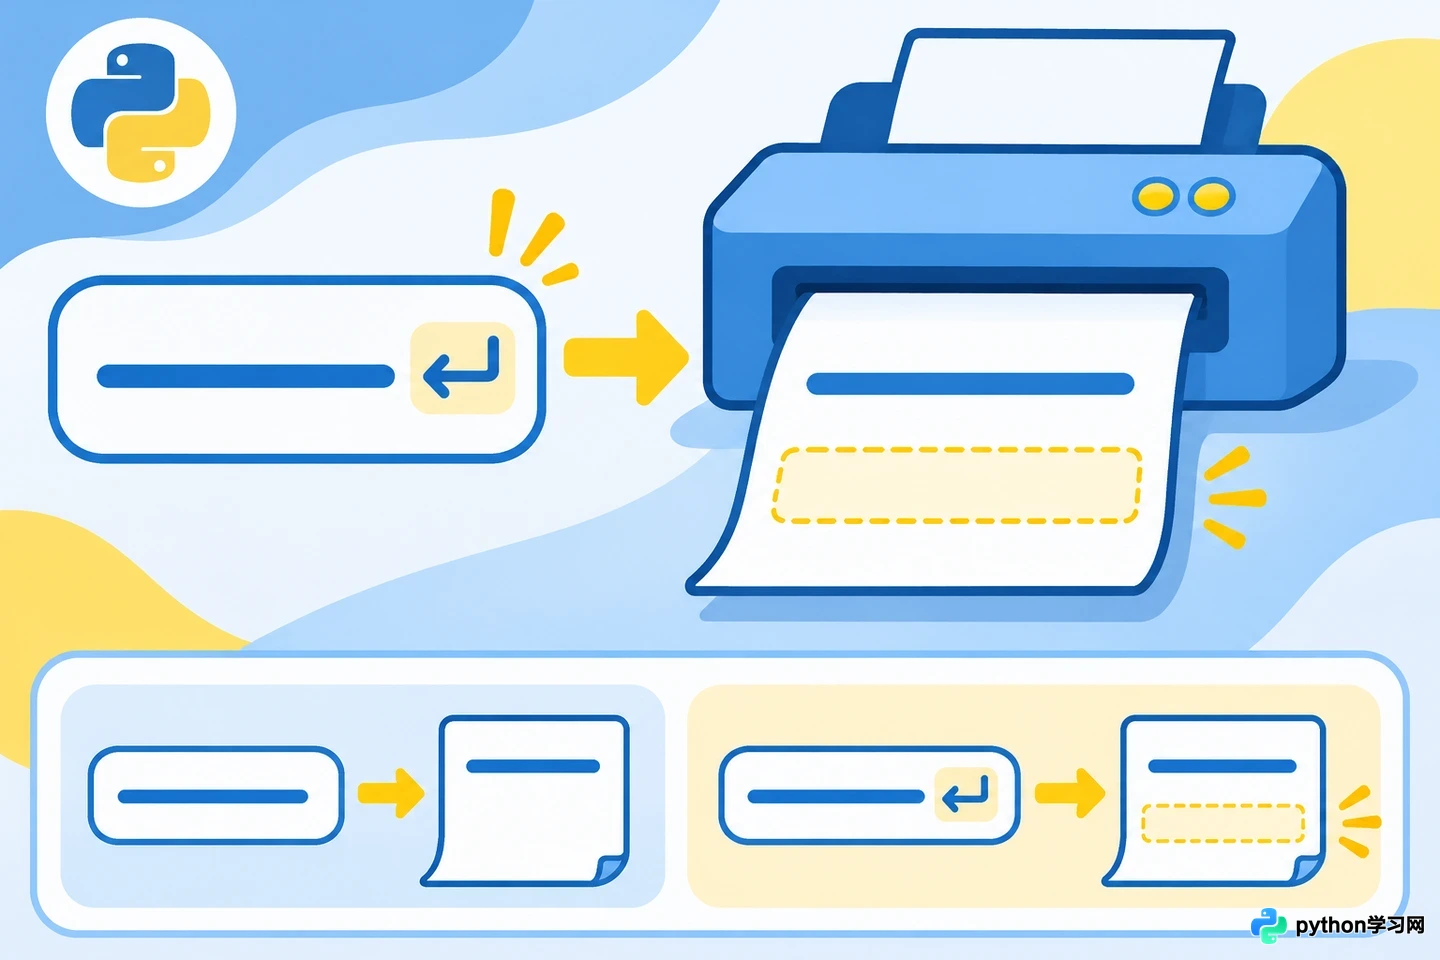
行尾换行与输出效果示意图
enumerate 函数为迭代过程提供索引,start=1 让行号从 1 开始。line.rstrip("\n") 仅删除末尾的换行符,保留行首和行尾的空格。如果数据本身不包含有意义的空白字符,也可以使用 strip(),但这会同时移除两端的空格,需根据数据规范谨慎选择。
3. 需要手动控制时使用 readline
某些场景下,读取下一行的决策依赖于当前行的内容,例如解析特定格式的配置文件或跳过标题行。此时可以使用 readline() 方法手动控制读取节奏:
with open("data.txt", "r", encoding="utf-8") as file:
    while True:
        line = file.readline()
        if line == "":
            break
        print(line, end="")
当到达文件末尾时,readline() 返回空字符串 ""。注意区分空行和文件结束:空行读取结果是 "\n",而文件结束才是 ""。因此判断条件必须是 line == "",而非 if not line(虽然在此语境下效果相同,但显式比较更清晰)。
相比之下,readlines() 会一次性读取剩余所有行并返回列表。除非确实需要随机访问某一行或文件大小可控,否则不建议在逐行处理场景中使用它,以免丧失内存优势。
4. 排查路径与编码问题
初学者常遇到两类错误:找不到文件和解码失败。
出现 FileNotFoundError 时,核心原因是程序运行时的工作目录与预期不符。相对路径 data.txt 是相对于当前工作目录解析的,而非脚本所在目录。在 IDE 中运行时,工作目录可能被设置为项目根目录或其他位置。解决方法包括:在终端中 cd 到数据文件所在目录再运行脚本,或使用绝对路径。Windows 下可使用原始字符串避免转义问题,如 r"C:\data\data.txt"。
文件路径与编码排查示意图
出现 UnicodeDecodeError 则意味着文件编码与 encoding 参数不匹配。示例中假设文件为 UTF-8 编码,这是现代文本文件的通用标准。但如果文件由旧版 Windows 记事本保存,可能是 GBK 编码。此时应将 encoding 改为 'gbk' 或 'gb2312'。不要随意使用 errors='ignore' 忽略解码错误,这会导致数据静默丢失,掩盖真正的编码问题。应先通过编辑器确认文件实际编码,再指定对应的解码方式。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









