

Python源码含中文报错SyntaxError?详解coding utf-8声明规范
详解Python源码中包含中文注释或字符串时触发SyntaxError的原因,深入剖析PEP 263编码声明规范、正确书写位置、排查步骤及Python 2与Python 3的差异。
SyntaxError,根本原因在于 Python 解释器在语法分词阶段采用了与源码文件实际存储格式不匹配的默认编码(Python 2 默认是 7 位 ASCII;Python 3 默认是 UTF-8 但若文件被外部编辑器保存为 GBK/ANSI 则会导致解码冲突)。最通用、标准的解决方案是在脚本的第一行或第二行显式添加 PEP 263 编码声明:# -*- coding: utf-8 -*-,并确保编辑器实际以 UTF-8(无 BOM)格式保存文件。
一、问题根源:为什么源码含中文会触发语法错误?
许多初学者或从 Python 3 回看旧脚本的开发者经常遇到类似报错:代码在没有中文前运行正常,一旦写了一句中文注释或打印了中文,终端立即抛出中断:
# 示例终端报错信息(Python 2 典型表现)
SyntaxError: Non-ASCII character '\xe4' in file demo.py on line 1, but no encoding declared; see http://python.org/dev/peps/pep-0263/ for details
或者在 Python 3 环境下处理非 UTF-8 保存的源码文件时抛出:
# 示例终端报错信息(Python 3 典型表现)
SyntaxError: (unicode error) 'utf-8' codec can't decode byte 0xd6 in position 0: invalid continuation byte
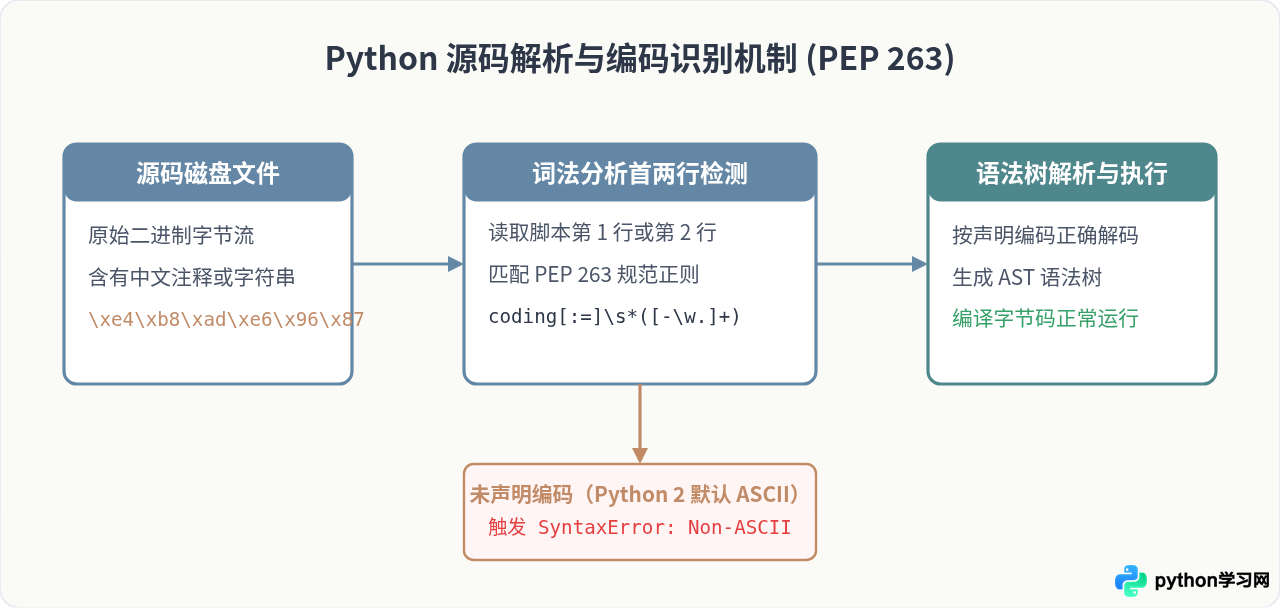
要理解该错误,需要理清 Python 解释器读取代码的执行流程。Python 在运行任何业务逻辑之前,必须先将磁盘上的原始字节序列读取并分词(Tokenize)为抽象语法树(AST)。如果源码文件中出现了大于 127 的字节(例如中文字符在 UTF-8 编码下占用 3 个字节,在 GBK 下占用 2 个字节),解释器就必须知道按照何种字符集去解释这些字节:
- Python 2 的机制:源码默认编码被硬编码为纯 ASCII。ASCII 字符集只支持编号 0 至 127 的英文字符与控制字符。只要词法分析器遇到任何超出此范围的字节,便会立刻终止解析,抛出
Non-ASCII character语法错误。 - Python 3 的机制(PEP 3120):源码默认编码升级为 UTF-8。绝大多数现代编辑器默认保存为 UTF-8,因此 Python 3 中通常可以直接书写中文而无需声明。然而,若文件在 Windows 下被记事本以 ANSI(即 GBK/CP936)格式保存,解释器用默认的 UTF-8 规则解码 GBK 字节时,就会因字节不合法而触发解码层面的
SyntaxError。
二、PEP 263 规范详解:声明语法与严苛的位置要求
为了解决多语言源码中的编码识别问题,Python 官方早早就确立了 PEP 263(Defining Python Source Code Encodings) 标准。该标准规定了 Python 解析器识别编码声明的具体方式。
1. 正则匹配规则与常用写法
Python 解释器在读取脚本前部时,通过内置的正则表达式进行模式扫描:
^[ \t\f]*#.*?coding[:=][ \t]*([-_.a-zA-Z0-9]+)只要满足该正则的单行注释,即可被识别为有效的编码声明。在日常开发中,常见的合规书写格式有以下几种:
- Emacs 风格(推荐):
# -*- coding: utf-8 -*-(前后配有-*-标记,兼顾主流编辑器的语法高亮与语法分析)。 - Vim 风格:
# vim: set fileencoding=utf-8 :(包含coding=utf-8,亦符合 PEP 263 正则)。 - 最简风格:
# coding: utf-8或# coding=utf-8(直接紧凑,完全有效)。
2. 致命细节:声明必须位于第 1 行或第 2 行
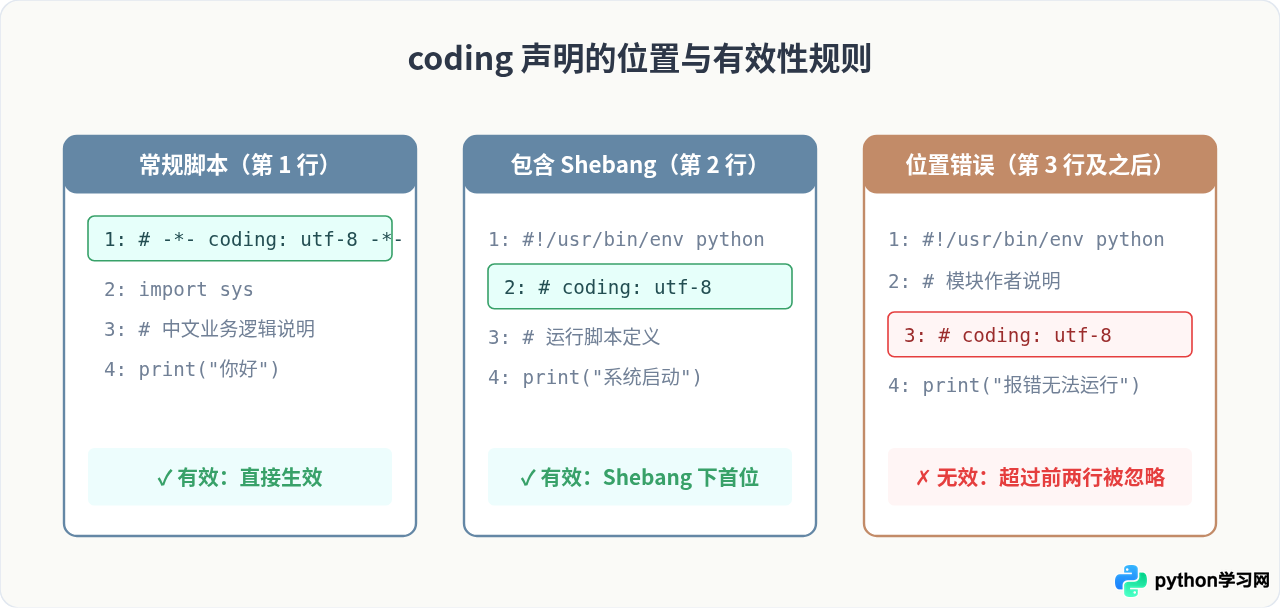
PEP 263 对编码声明的位置有绝对强制的限制:编码声明必须位于文件的第一行或第二行。如果放置在第三行及之后,解释器将完全跳过检测,错误依然会发生:
- 若脚本无 Shebang 头部:必须写在文件的第 1 行。
- 若脚本包含 Shebang 头部(如
#!/usr/bin/env python):Shebang 占第 1 行,编码声明写在第 2 行。 - 错误典型:在文件开头写了多行普通注释、空行或者导入语句,再把
# coding: utf-8放在下方,此时声明完全失效。
三、逐步排查与修复实战指南:四步彻底根治编码报错
遇到源码中文报错时,请按照以下标准化排查路径依序检查,避免在不相关的逻辑代码上浪费时间:
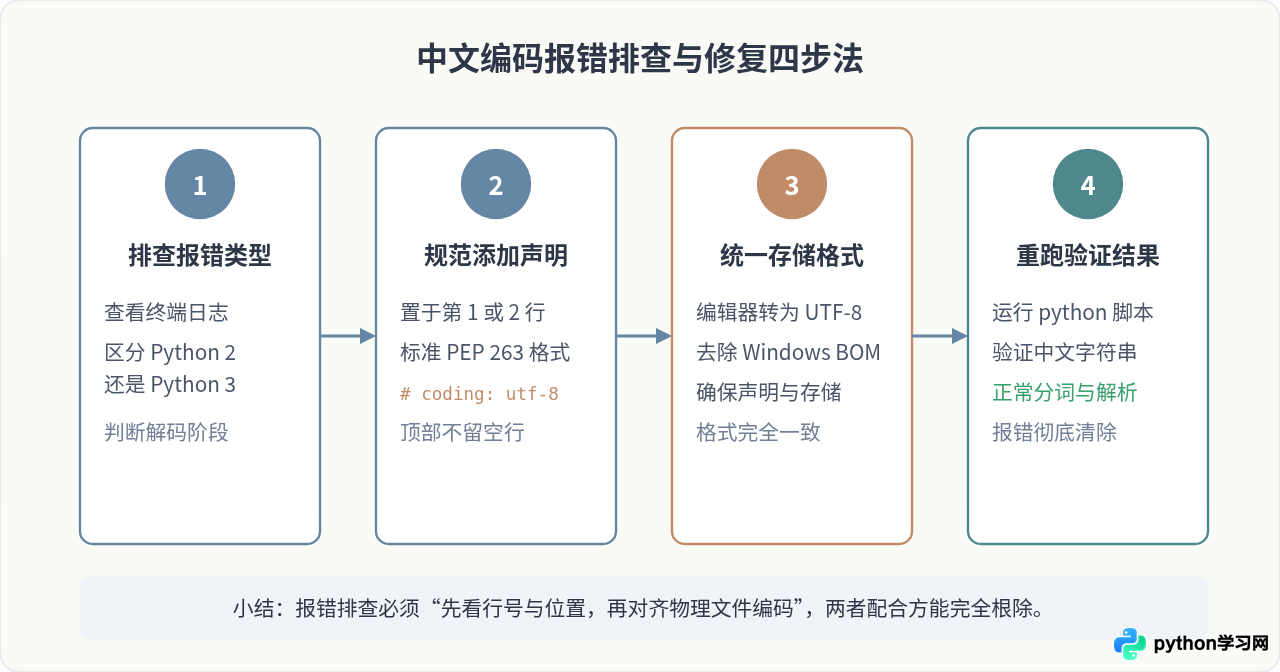
第 1 步:定位报错性质与运行环境
首先查看控制台报错的完整回溯信息:
- 如果提示
Non-ASCII character ... but no encoding declared,说明当前执行环境使用的是 Python 2,或者执行器被指定为 Python 2 解析器。 - 如果提示
'utf-8' codec can't decode byte ...,说明当前环境是 Python 3,但文件物理编码与 UTF-8 冲突。
第 2 步:规范头部声明并检查行号
打开源文件,在最开头第一行直接添加:
# -*- coding: utf-8 -*-注意不要在此行上方留出空行。如果存在 #!/usr/bin/env python 这类系统解析指令,必须将其作为第 1 行,紧接着第 2 行写入编码声明,确保其稳固处于前两行内。
第 3 步:统一物理存储编码(核对 BOM 标记)
声明了 coding: utf-8 只是告诉 Python 解释器“请按 UTF-8 规则读取”,如果文件在磁盘上实际上是用 Windows ANSI(GBK)保存的,就会出现“声明与事实不符”的新报错。此时必须在编辑器(如 VS Code、PyCharm、Sublime)的右下角查看并修改文件编码:
- VS Code:点击右下角的“GBK”或“UTF-8”,选择“通过编码保存(Save with Encoding)”,选择
UTF-8。 - 警惕 UTF-8 with BOM:Windows 早期记事本保存 UTF-8 时会在文件头部插入
\xef\xbb\xbf(Byte Order Mark)。Python 2 会将 BOM 视为非 ASCII 字符而报错,虽然 Python 3 容忍 BOM,但现代工程标准一律要求保存为 UTF-8 without BOM(UTF-8 无签名)。
第 4 步:重新执行与验证
完成修改并保存后,在终端中重新运行原命令:
python demo.py若屏幕正常打印出中文字符且无任何警告,即证明词法分析阶段的解码已顺利完成。
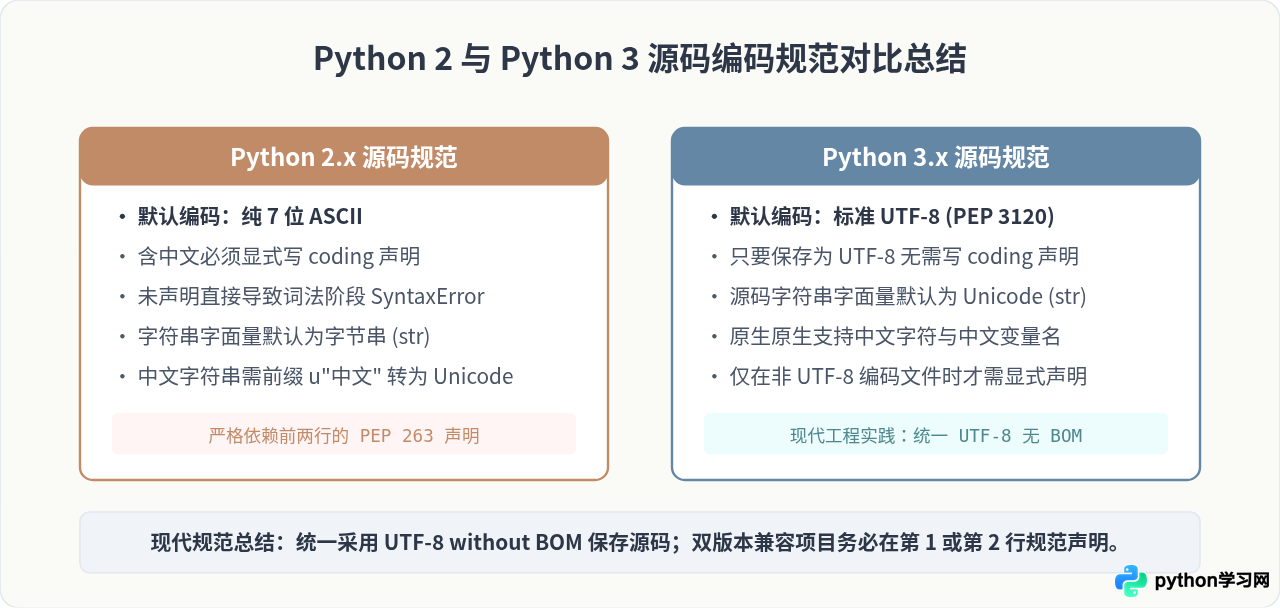
四、Python 2 与 Python 3 的编码差异与现代开发规范
在实际开发过程中,许多人对 coding: utf-8 是否必须存在感到困惑。之所以有这种模糊认识,核心在于 Python 版本的演变以及源文件编码与字符串对象类型的区别。
| 对比维度 | Python 2 (历史版本) | Python 3 (现代版本) |
|---|---|---|
| 默认源码编码 | 严格为 ASCII(见 PEP 263) | 默认为 UTF-8(见 PEP 3120) |
| 含中文时是否必填声明 | 必须声明,否则直接抛 SyntaxError | 非必须。只要文件本身为 UTF-8 即可不写 |
| 源码字符串默认类型 | str 为字节串(Byte string) |
str 统一为 Unicode 文本字符 |
| 何时仍需在 Py3 中声明 | 任何含非 ASCII 字符的文件 | 仅当源码被迫使用 GBK/CP936 保存时 |
# -*- coding: utf-8 -*- 依然是一种良好的兼容习惯与防御性编码风格。
五、总结
遇到 Python 源码含中文报错 SyntaxError 时,不要盲目删除中文注释。归纳起来只需记住三点:
- 声明规范:优先使用
# -*- coding: utf-8 -*-,确保声明严格处于脚本的第 1 行(或紧随 Shebang 的第 2 行)。 - 存储一致:检查编辑器底部的编码配置,统一以
UTF-8(无 BOM)格式保存。 - 机制理解:理解 Python 2(默认 ASCII)与 Python 3(默认 UTF-8)的本质区别,在跨版本库开发时自觉坚持规范的编码声明习惯。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









