

洛谷Python解题怎么避免KeyError:get()与defaultdict实战技巧
针对洛谷OJ使用Python解题时频发的KeyError与Runtime Error,深度解析键缺失报错根源,实战讲解dict.get()与collections.defaultdict的机制、应用场景、隐式副作用及题型选型策略。
在洛谷等在线评测系统中,Python 提交出现 Runtime Error (RE) 的高频原因之一正是 KeyError。解决这个问题的核心路径非常明确:针对只读查询或带兜底提取的场景,优先采用标准字典的 dict.get() 方法;针对高频建图、频次累加及多值归类的场景,直接引入 collections.defaultdict。理解这两者的运行机制与边界陷阱,可以从源头上消除未定义键引发的异常中断,让代码在严苛的极端评测点下稳定运行。
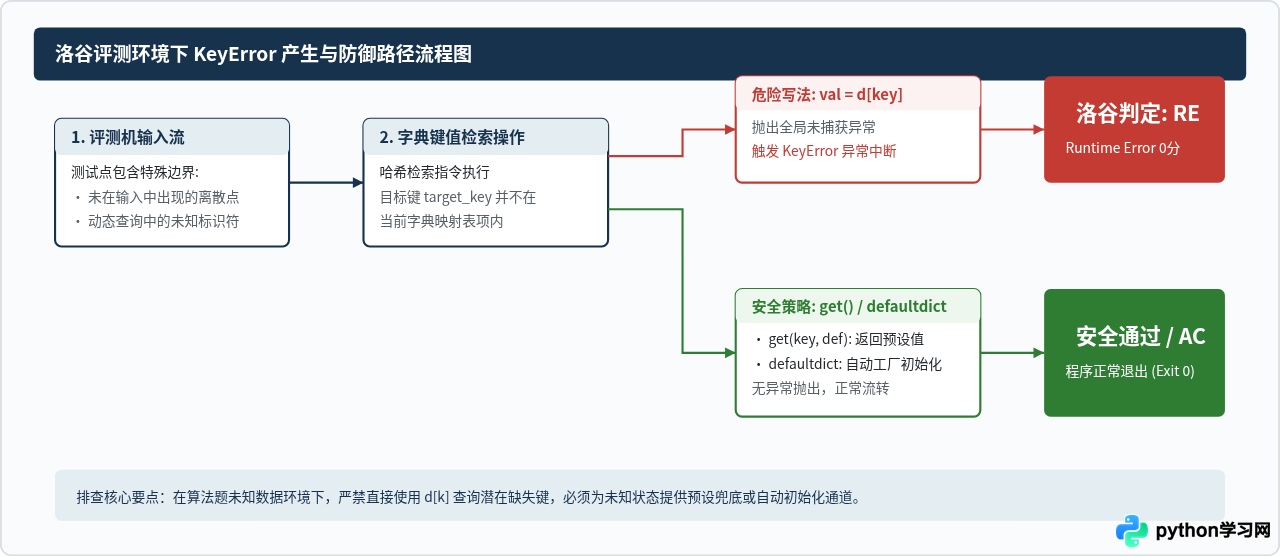
一、洛谷评测中 KeyError 的触发机理与 RE 根源
在线评测系统针对算法题目会设置多组高强度测试点,涵盖边界值、孤立节点、未在样例中出现的未知键等极端数据。在原生 Python 字典中,通过下标方括号 d[key] 取值时,Python 解释器会在哈希表底层执行键匹配。一旦哈希桶中不存在目标键,解释器便会抛出内置异常 KeyError。
如果算法未对该异常进行捕获,未处理的异常会导致 Python 脚本非正常退出。洛谷评测机捕获到进程返回值非零,便会直接判定该测试点为 RE (Runtime Error,运行时错误)。典型场景包括:图论题目中某些编号为孤立点(无任何出边/入边),使用普通字典建立邻接表时未初始化孤立点,遍历时直接发生下标访问越界;字符串统计中,查询某个不在词表中的查询指令等。
二、轻量安全的只读防护:dict.get() 机制与实操技巧
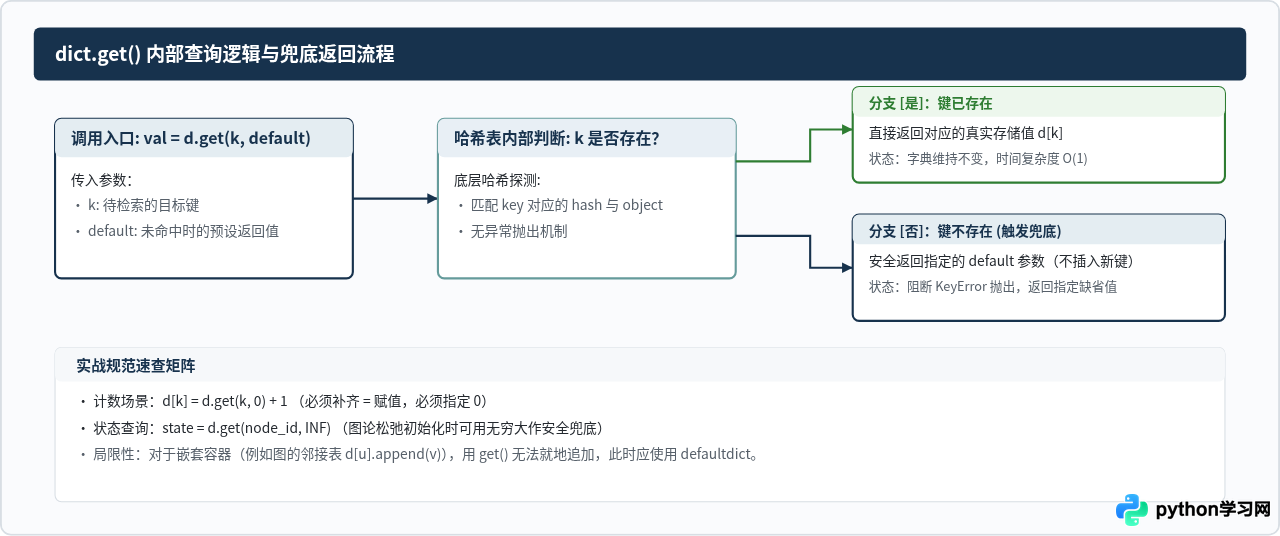
dict.get(key, default=None) 是 Python 字典提供的原生访问方法。其执行逻辑为:当 key 存在于字典中时,返回对应的 value;当 key 不存在时,返回指定的 default 参数值,而不是抛出异常。
1. 经典应用:动态频次统计与计数更新
在洛谷的字符串统计、离散数频次统计等题目中,最简练的计数写法之一是结合 get() 的默认值参数进行就地更新:
import sys

def solve():
    # 洛谷快速读取示例
    input_data = sys.stdin.read().split()
    if not input_data:
        return

    count_dict = {}
    for item in input_data:
        # 当 item 不存在时返回 0,加 1 后显式赋值回字典
        count_dict[item] = count_dict.get(item, 0) + 1

    print(count_dict)
2. 避坑指南:get() 的常见误区与致命陷阱
- get() 不会自动向字典中写入键值对:
d.get(k, 0)仅仅是一个只读表达式。如果不写d[k] = ...,字典本身的长度和内容完全不变。在需要记录键集合的场景下切勿漏掉显式赋值。 - 默认值遗漏引发的 TypeError:若省略第二个参数,默认返回
None。如果紧接着执行d.get(k) + 1,在键不存在时会计算None + 1,直接引发TypeError: unsupported operand type(s) for +: 'NoneType' and 'int',导致同等后果的 RE。因此,用于数值计算时必须显式传入0。 - 布尔判断的假值陷阱:当字典中存储的键值恰好是布尔值
False、整数0或空列表[]时,使用if d.get(k):判断键是否存在会得出错误结论,因为默认值与存储值可能在布尔上下文中同为假。正确的做法是使用k in d或检查d.get(k) is not None。
三、自动初始化与就地更新:collections.defaultdict 深度应用
在算法题目中,许多数据结构需要维护列表容器,例如图论题目中的邻接表、桶排序中的元素归类、拓扑排序中的入度表。如果使用普通字典,每次遇到新节点都必须编写 if u not in graph: graph[u] = [],不仅增加了冗余代码,还会因为疏漏未初始化的点而导致 RE。
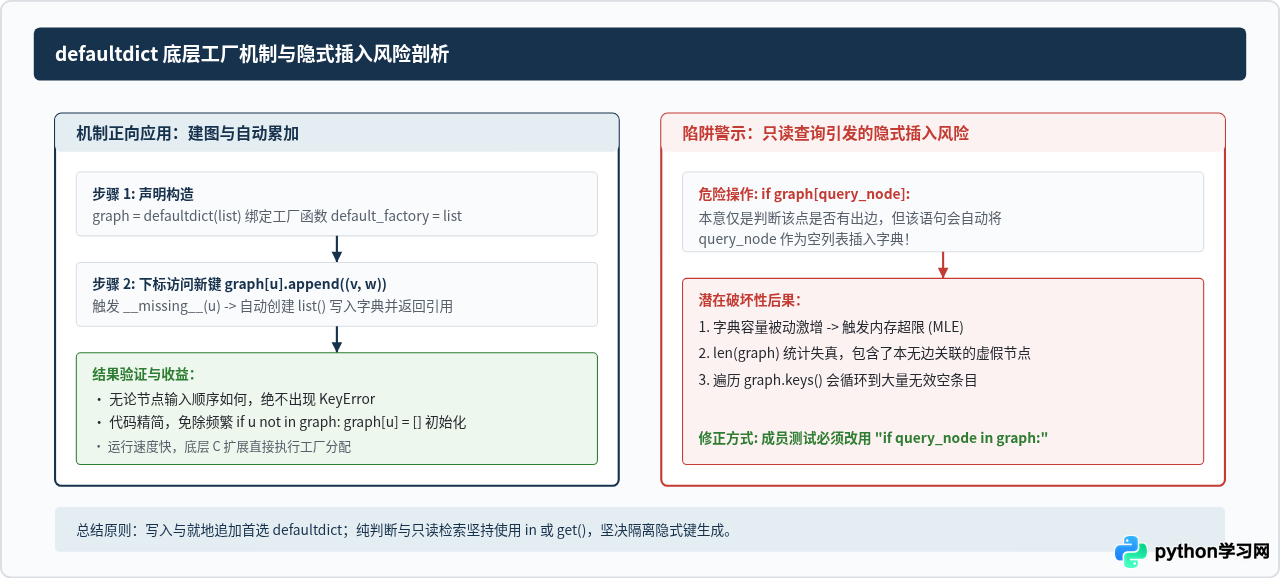
Python 标准库 collections 模块提供了 defaultdict 类。它是 dict 的子类,重写了内部的 __missing__(key) 方法。当通过下标访问一个不存在的键时,defaultdict 会自动调用初始化时传入的工厂函数(例如 list、int、set),创建一个全新的默认对象写入字典,并将其作为当前键的值返回。
1. 核心实战:图论邻接表建图零越界
以洛谷图论题目的有向图/无向图建图为例,使用 defaultdict(list) 可以彻底消除建图过程中的 KeyError:
import sys
from collections import defaultdict

def build_graph():
    # 读入所有数据
    input_lines = sys.stdin.read().splitlines()
    if not input_lines:
        return

    # 假设首行包含节点数 n 与边数 m
    n, m = map(int, input_lines[0].split())

    # 构造邻接表:工厂函数为 list
    adj = defaultdict(list)

    for line in input_lines[1:m+1]:
        u, v, w = map(int, line.split())
        adj[u].append((v, w))

    # 查询孤立节点时直接访问 adj[isolated_node],返回空列表 [],无需额外判断
    for node in range(1, n + 1):
        for next_node, weight in adj[node]:
            # 正常执行边遍历
            pass
2. 致命隐式副作用:只读查询引发的“内存膨胀”
defaultdict 虽好,但在洛谷解题中有一个极其隐蔽的陷阱:只读访问会导致隐式自动插入。当执行 if adj[target]: 或仅仅通过下标读取 val = d[unknown_key] 时,只要该键不存在,defaultdict 就会立刻生成默认值并插入到底层哈希表中。
这一副作用可能带来两类恶果:
- 内存超限 (MLE):在离散化或大范围坐标查询中,海量不存在的键被盲目查询,导致字典内部膨胀出成千上万个无意义的空条目,最终耗尽洛谷限制的 128MB 或 256MB 内存。
- 影响后续遍历与大小判断:如果在遍历前进行了只读测试,
len(d)会将自动插入的键计入长度,后续的for k in d:也会遍历到这些空条目,从而破坏逻辑正确性。
defaultdict 执行“纯判断”时,必须使用 if key in d: 进行成员检查,切勿直接使用 if d[key]:!成员检查 in 仅判断哈希表中是否存在该键,不会触发 __missing__,因而不会引入多余条目。
四、洛谷解题场景选型矩阵与核心决策
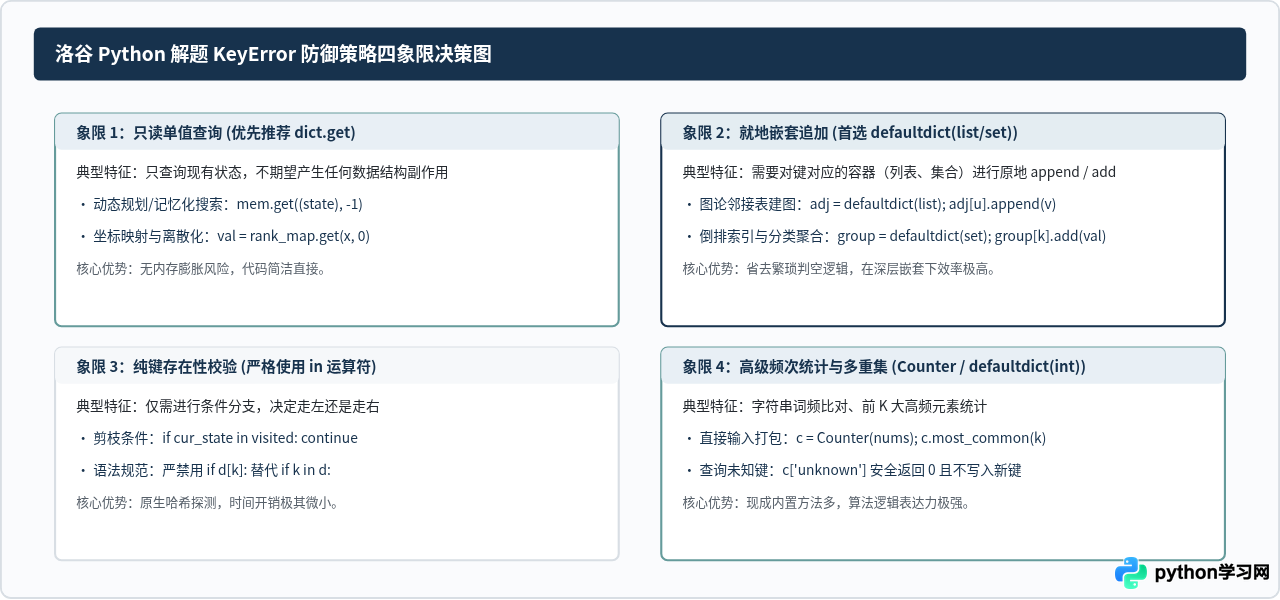
在面对具体的算法与数据结构题目时,不同方案在时间常数、空间占用以及逻辑语义上存在差异。盲目使用某一种方案可能导致超时 (TLE) 或超内存 (MLE)。为了帮助读者在洛谷解题时快速决策,我们将常见的几种键值处理策略进行横向对比:
| 方案 | 底层机制 | 时间常数 | 是否写入新键 | 洛谷推荐适用场景 |
|---|---|---|---|---|
| in 关键字检查 | 哈希桶查找测试 | 极快(低开销) | 否 | 逻辑分支判断、确定键是否在词典中 |
| dict.get() | 带缺省值返回的哈希检索 | 快(单次调用) | 否 | 状态转移默认值、孤立离散坐标查询、只读计算 |
| defaultdict | C层实现,缺失时触发工厂调用 | 极快(就地追加最佳) | 是(下标查询即写入) | 图论邻接表、多值桶排序归类、频繁累加计数 |
| collections.Counter | 专用计数容器,继承自 dict | 中等(有额外开销) | 否(查询缺失返回 0) | 多重集运算、交并集、纯频次前 K 大统计 |
五、洛谷提交前的代码自查清单
在将 Python 解题代码提交至洛谷评测机前,建议对照以下三点完成快速静态检查:
- 检索所有裸方括号下标
d[key]:检查每一个用于读取字典的方括号表达式,确认是否能保证key百分之百已在之前被赋值。只要存在任何边界或孤立可能,立即重构成d.get(key, default)或defaultdict。 - 核对
get()的默认参数:如果读取结果要参与后续加减乘除、位运算或列表连接,必须确认是否传入了匹配类型的默认参数(例如数字传0,列表传[]),杜绝NoneType引起的二次异常崩溃。 - 隔离
defaultdict的只读查询与成员检查:如果在代码中使用了defaultdict,全面复查所有条件判断语句,将形如if d[k]:的判断统一规范替换为if k in d:,避免内存超限 (MLE) 和无意义的条目膨胀。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









