

怎么处理Python re.search返回None避免AttributeError
深入剖析Python中re.search返回None导致AttributeError的根本原因,提供条件守卫、海象运算符、安全工具函数与异常捕获等完整解决方案及排查流程。
在 Python 中使用 re.search() 提取文本时,最常见的崩溃是 AttributeError: 'NoneType' object has no attribute 'group'。这是因为未匹配时函数会返回 None,直接链式调用方法必然引发异常。解决这一问题的核心原则是在提取分组之前完成存在性校验。最直接的做法是使用 if match: 守卫;在 Python 3.8 及以上版本中,使用海象运算符 if (match := re.search(...)): 能够兼顾整洁与安全;而面对批量清洗场景,则可以封装带有默认回退值的提取工具函数。
一、为什么 re.search 会返回 None?报错本质剖析
编写正则表达式逻辑时,很多开发者习惯在调用 re.search() 后立即连写 .group(1) 或 .group(0)。在测试用例格式规整时,程序能够正常运行;但一旦遇到不符合预期的文本,程序就会瞬间中断并抛出如下异常:
AttributeError: 'NoneType' object has no attribute 'group'这是 Python 语言设计上的确定性行为:re.search(pattern, string) 会扫描整个字符串并寻找第一个成功匹配的位置。如果匹配成功,它会返回一个 re.Match 实例对象,该对象拥有 group()、groups()、start()、end() 等属性和方法;但如果整个字符串中均未找到符合模式的片段,它会返回内置的单例对象 None。None 属于 NoneType 类型,并不具备任何正则相关的方法,尝试调用 None.group() 自然会触发 AttributeError。
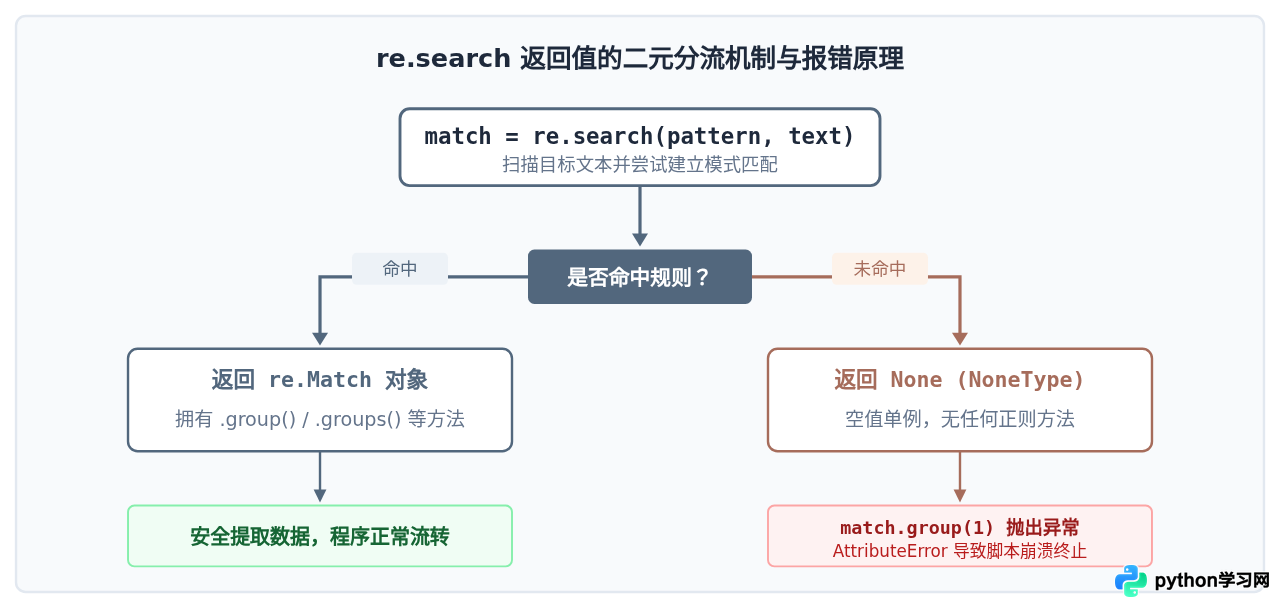
二、引发错误的典型场景与隐蔽诱因
很多时候,开发者在本地调试时一切正常,部署到生产环境后却偶发崩溃。造成 re.search 返回 None 的典型诱因通常有以下几类:
- 输入源数据缺失或格式脏乱:例如网络爬虫抓取的网页缺失特定标签、上游接口返回了
null或空字符串、用户未填写可选字段等。 - 空白字符差异:原始文本中夹杂了全角空格、制表符
\t或非换行空格( 对应的\xa0),导致严格匹配普通空格的模式失效。 - 跨行与换行符问题:默认情况下,点号
.不匹配换行符\n。如果目标文本跨越多行且未指定re.DOTALL标志,匹配就会直接终止并返回None。 - 锚点过严:使用了行首
^或行尾$,但文本首尾存在未清理的空白或换行,导致整个表达式失配。
re.search() 与后续取值解耦是防御式编程的硬性要求。
三、排查与防范的标准操作流程
为了在工程实践中彻底杜绝此类崩溃,建议统一遵循结构化的四步处理流水线:执行检索、存在性校验、安全提取与回退、以及后续业务流转。
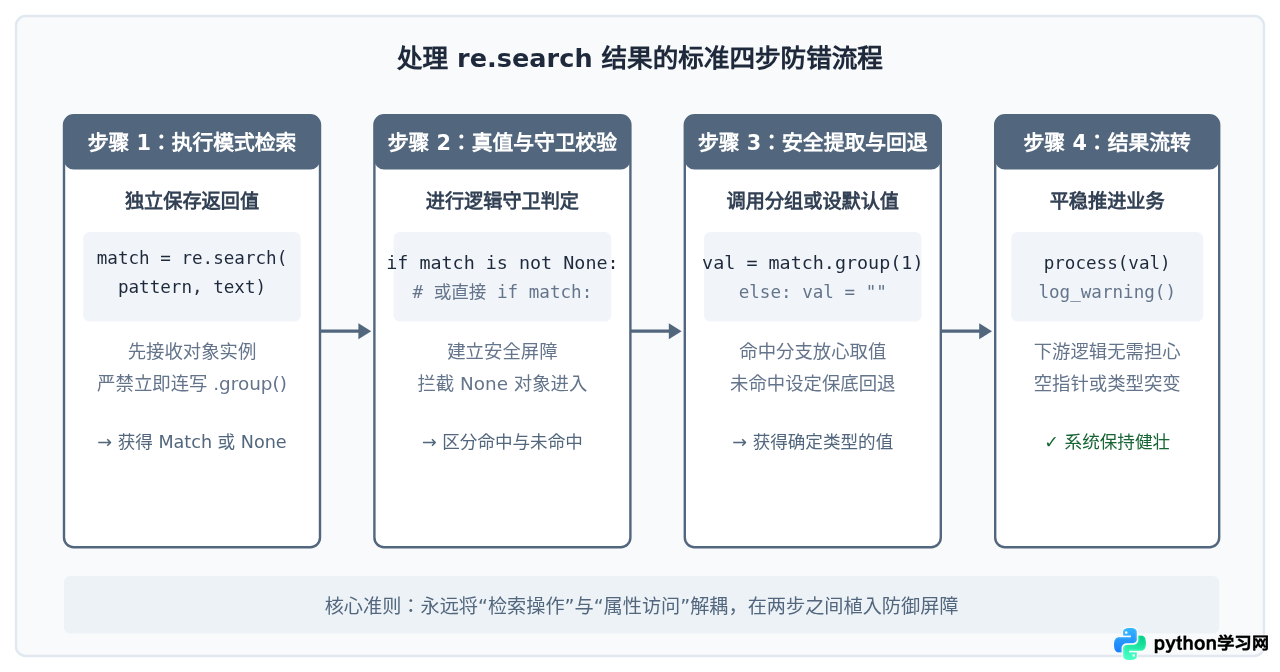
四、避免 AttributeError 的 4 种最佳实践与代码实现
1. 经典显式条件守卫(if match)
这是最符合直觉、也是在所有 Python 版本中均完全通用的经典模式。在 Python 的布尔上下文中,re.Match 对象始终评估为 True,而 None 评估为 False。
import re

text = "订单编号: 20261023-9988"
pattern = r"订单编号:\s*(\d{8}-\d{4})"

match = re.search(pattern, text)
if match:
    order_id = match.group(1)
    print(f"成功提取订单号: {order_id}")
else:
    order_id = None
    print("未匹配到合规的订单编号,已转入兜底分支")
2. Python 3.8+ 海象运算符(:=)
如果觉得先定义 match 变量再写 if 略显啰嗦,在 Python 3.8 及更新版本中,推荐使用赋值表达式(海象运算符 :=)。它允许在条件判断语句内部同时完成变量赋值与真值检查,大幅精简代码:
import re

text = "用户邮箱: service@example.com"

# 在 if 判断中同时完成检索与赋值
if match := re.search(r"用户邮箱:\s*([\w\.-]+@[\w\.-]+\.\w+)", text):
    email = match.group(1)
    print(f"捕获邮箱: {email}")
else:
    print("文本中未包含有效邮箱地址")
这种写法不仅代码行数少,而且清晰地表达了“只有检索成功才执行该作用域代码”的意图,是目前现代 Python 开发中最受推崇的写法。
3. 封装带默认回退值的安全工具函数
在数据清洗、日志分析或批量解析字典等场景下,如果每次都写 if-else 会产生大量模版代码。此时最佳做法是封装一个通用的安全检索辅助函数:
import re

def safe_search(pattern, text, group=1, default=None, flags=0):
    """
    安全执行 re.search,未匹配时返回 default 指定的兜底值,避免 AttributeError
    """
    match = re.search(pattern, text, flags=flags)
    if not match:
        return default
    try:
        return match.group(group)
    except IndexError:
        # 正则未定义对应捕获组时的防御
        return default

# 使用示例
log_line = "IP: 192.168.1.100 - Status: 200"

ip = safe_search(r"IP:\s*([\d\.]+)", log_line, default="0.0.0.0")
user_agent = safe_search(r"UA:\s*(.+)", log_line, default="Unknown")

print(f"IP: {ip}, UA: {user_agent}")
# 即使 UA 未匹配,也会安全返回 "Unknown",绝不会崩溃
4. 异常捕获策略(try-except AttributeError)
Python 倡导“请求原谅比许可更容易”(EAFP)的理念。如果在特定场景中绝大多数文本都能匹配,或者需要兼容旧代码,可以使用 try-except 显式捕获该异常:
import re

text = "临时数据行"

try:
    # 假设此处直接链式调用
    code = re.search(r"Code:\s*(\w+)", text).group(1)
except AttributeError:
    # 捕获因 re.search 返回 None 引发的异常
    code = "DEFAULT_CODE"

print(f"最终结果: {code}")
需要注意:捕获 AttributeError 时应尽量缩小编码范围,避免掩盖代码中其他地方由于拼写错误引起的真实属性报错。
五、进阶场景:命名捕获组与多模式匹配的防错处理
1. 命名捕获组与 .groupdict() 的安全结合
当正则表达式中包含多个捕获字段时,使用数字索引(如 group(1), group(2))极易因为索引错位引发 IndexError。更健壮的方式是使用命名捕获组 (?P<name>...):
import re

text = "Host: 10.0.0.1, Port: 8080"
pattern = r"Host:\s*(?P<host>[\d\.]+),\s*Port:\s*(?P<port>\d+)"

match = re.search(pattern, text)
if match:
    data = match.groupdict()
    host = data.get("host")
    port = data.get("port")
    print(f"解析成功 -> Host: {host}, Port: {port}")
else:
    # 统一兜底字典
    data = {"host": "127.0.0.1", "port": "80"}
通过 match.groupdict() 获取字典后,再配合字典的 .get() 方法,既防止了 None.group() 的 AttributeError,又杜绝了提取不存在键时的 KeyError。
2. 澄清 re.findall 与 re.search 的行为差异
有些开发者认为用 re.findall() 可以避免 None。确实,re.findall() 在未匹配到内容时会返回空列表 [] 而不是 None:
results = re.findall(r"\d+", "no digits here")
# results 为 [],不会返回 None
但这并不意味着万事大吉。如果直接写 re.findall(r"\d+", text)[0],当列表为空时会直接引发 IndexError: list index out of range。虽然报错类型从 AttributeError 变成了 IndexError,但本质上依然是没有做存在性验证导致的崩溃。因此,无论使用哪个正则方法,结果校验都是不可省略的防线。
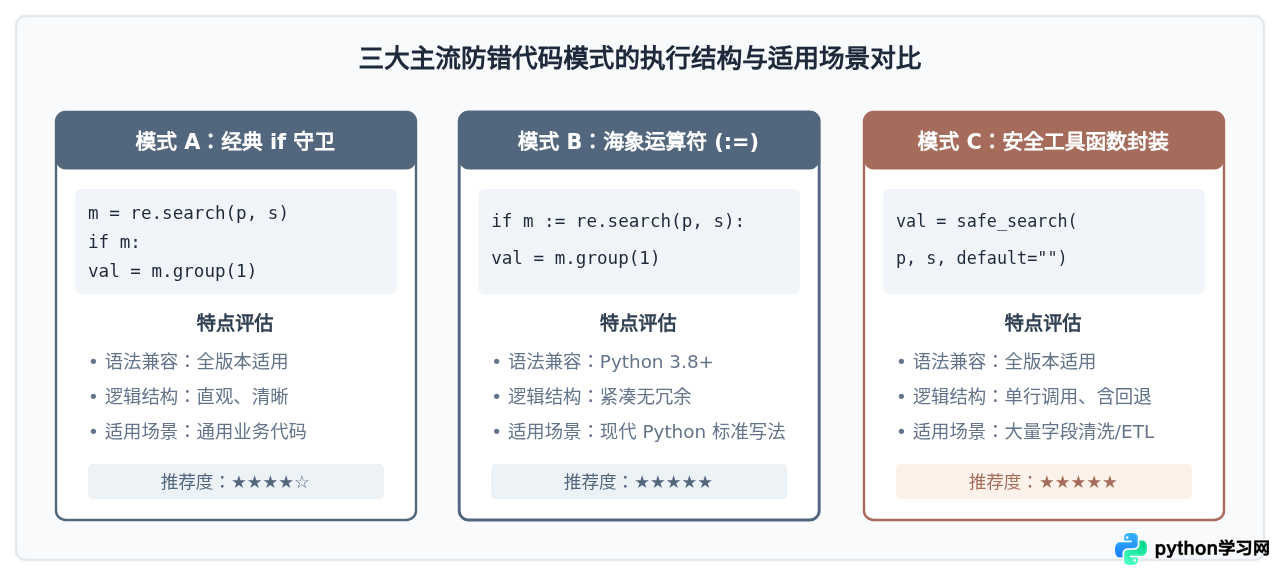
六、方案选型决策与关键排查清单
在面对不同工程场景时,可以参考以下决策树来挑选最契合的防范模式:
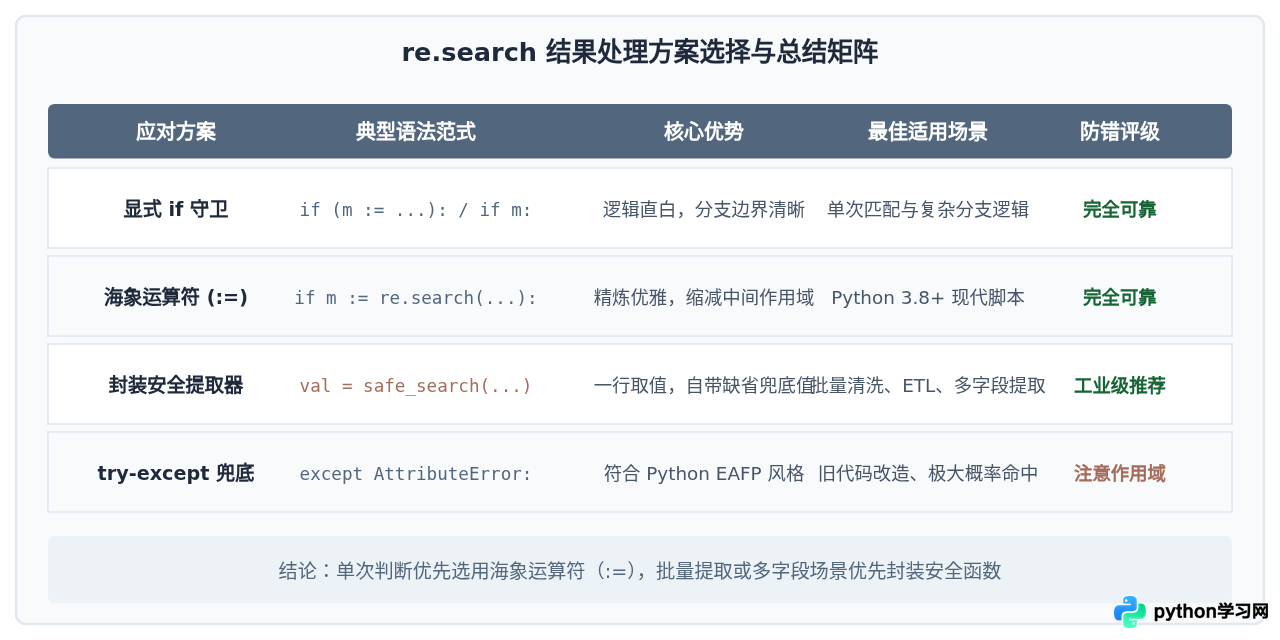
日常编码自查清单(CheckList)
- 拒绝链式调用:在检索代码中全局搜索
re.search(...).group,只要发现立即拆分为“先赋变量、再作校验”。 - 防御首尾不可见字符:在传入目标文本前,优先执行
text.strip()消除首尾空白干扰。 - 注意标志位:如果输入内容包含跨行文本,确认是否需要显式配置
flags=re.DOTALL。 - 完善单测用例:在编写正则表达式相关的单元测试时,必须专门构造一组“预期必然无法匹配”的反向测试用例,验证系统在返回
None时能否平稳降级而非直接崩溃报错。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









