

Python正则匹配返回None怎么办?常见陷阱与调试技巧
深入解析Python中re模块匹配返回None的根本原因,剖析re.match与re.search混淆、转义字符缺失、跨行匹配等常见陷阱,并提供系统化的调试排查步骤与防御性编程实践。
re 模块时,匹配返回 None 并不是程序抛出语法异常,而是正则引擎在目标字符串中按指定规则未找到匹配项的正常信号。排查该问题的关键在于两点:一是理清目标文本的实际字符与正则规则为何未对齐,二是在业务代码中建立健壮的防御机制,避免直接调用 .group() 引发 AttributeError 崩溃。
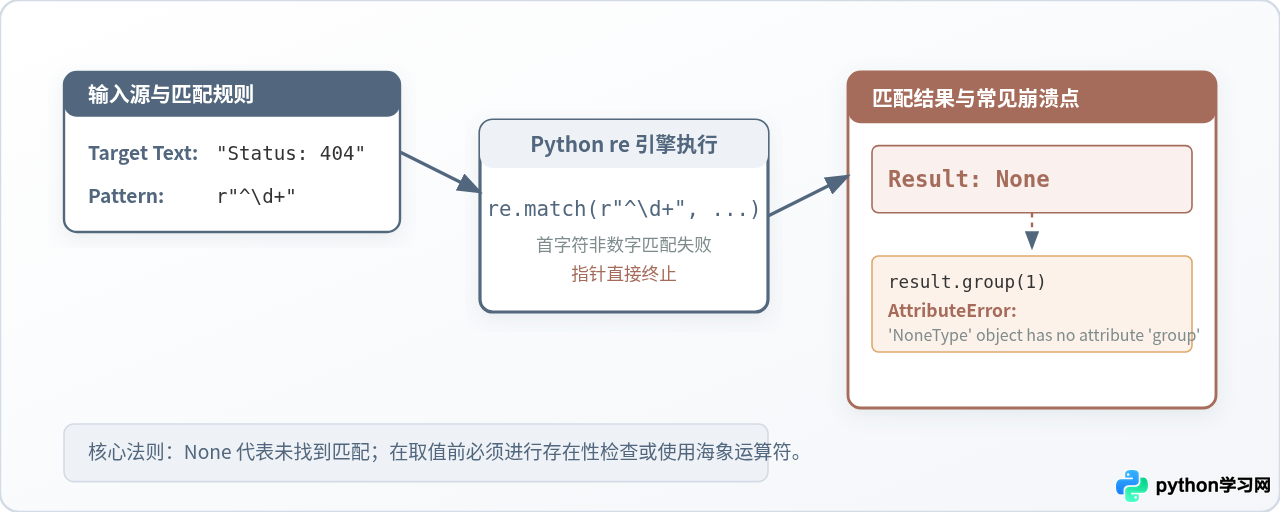
一、认识 None:为什么直接调用 .group() 会报错?
初学者在调试正则时,往往并非直接看到 None,而是遭遇了著名的运行时崩溃:
import re

text = "User status: offline"
pattern = r"\d+"
result = re.search(pattern, text)

# 直接调用 group()
print(result.group(0))File "demo.py", line 8, in <module>
print(result.group(0))
AttributeError: 'NoneType' object has no attribute 'group'
Python 的 re.match()、re.search() 与 re.fullmatch() 在检索成功时会返回一个 re.Match 对象,而在未命中任何符合规则的子串时统一返回内置单例 None。由于 None 本身没有任何匹配方法,盲目链式调用 .group() 或 .groups() 必然导致程序中断。因此,解决“返回 None”的第一原则,是先确认是模式未命中,还是文本格式脱离预期。
二、API 作用域陷阱:re.match 与 re.search 的本质差异
在所有导致返回 None 的原因中,最隐蔽也最普遍的错误就是误将 re.match() 当作全文搜索函数来使用。
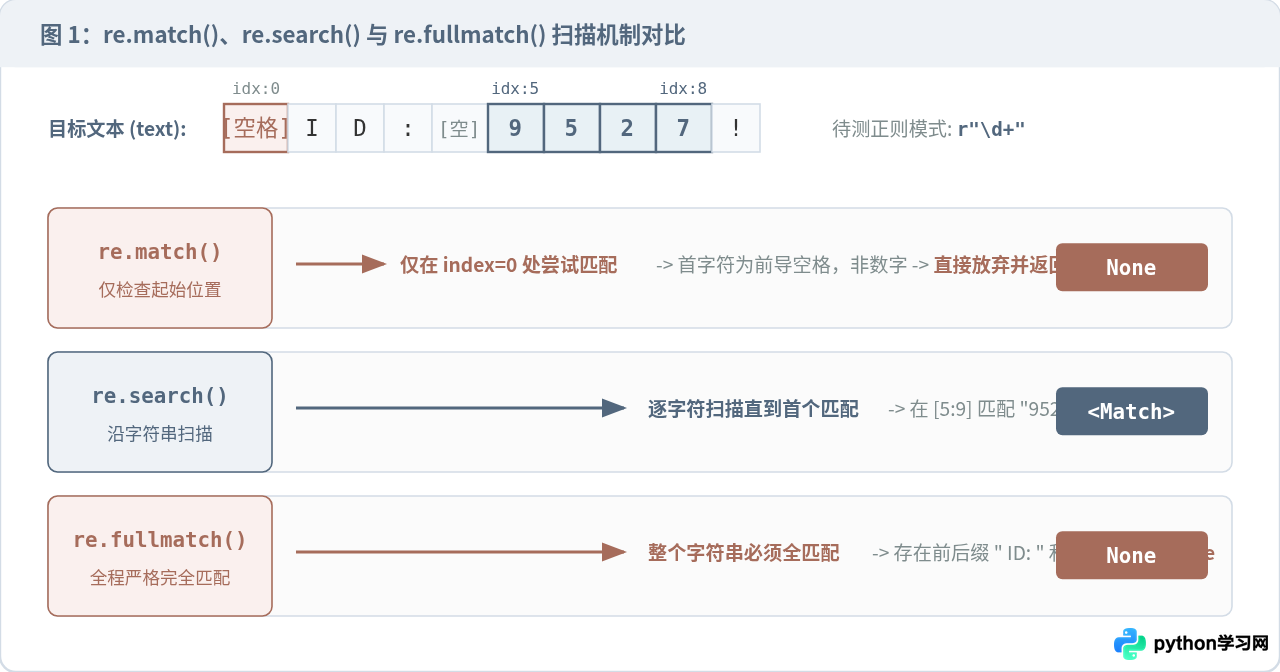
re.match() 严格限制从字符串的第 0 个索引字符开始匹配(相当于隐式包含了行首锚点 ^)。一旦目标字符串最前方存在任何非匹配字符(包括空格、BOM 头、标点符号),re.match() 就会立即放弃并返回 None。相比之下,re.search() 会沿字符串从左向右逐字符移动扫描窗口,直到找到首个匹配项。
import re

raw_line = " ID: 9527!"

# 陷阱:re.match 仅从开头匹配,因为 index=0 是空格,导致返回 None
m_match = re.match(r"\d+", raw_line)
print("re.match 结果:", m_match)

# 正确:re.search 沿途扫描字符串,成功捕获数字
m_search = re.search(r"\d+", raw_line)
print("re.search 结果:", m_search.group() if m_search else None)

# 对比:re.fullmatch 必须整体完全一致,否则同样返回 None
m_full = re.fullmatch(r"\d+", raw_line)
print("re.fullmatch 结果:", m_full)re.search 结果: 9527
re.fullmatch 结果: None
re.search();只有当业务明确要求严格校验字符串起始格式时,才使用 re.match()。
三、转义陷阱:普通字符串与正则引擎的双重解析
正则表达式中的元字符(如 \d、\s、)依赖反斜杠 \ 作为转义标记。但在 Python 中,普通的字符串字面量(如 "\d")在代码被解释执行时,会先经过 Python 自身的字符串转义解析,随后才传递给底层的 re 引擎。
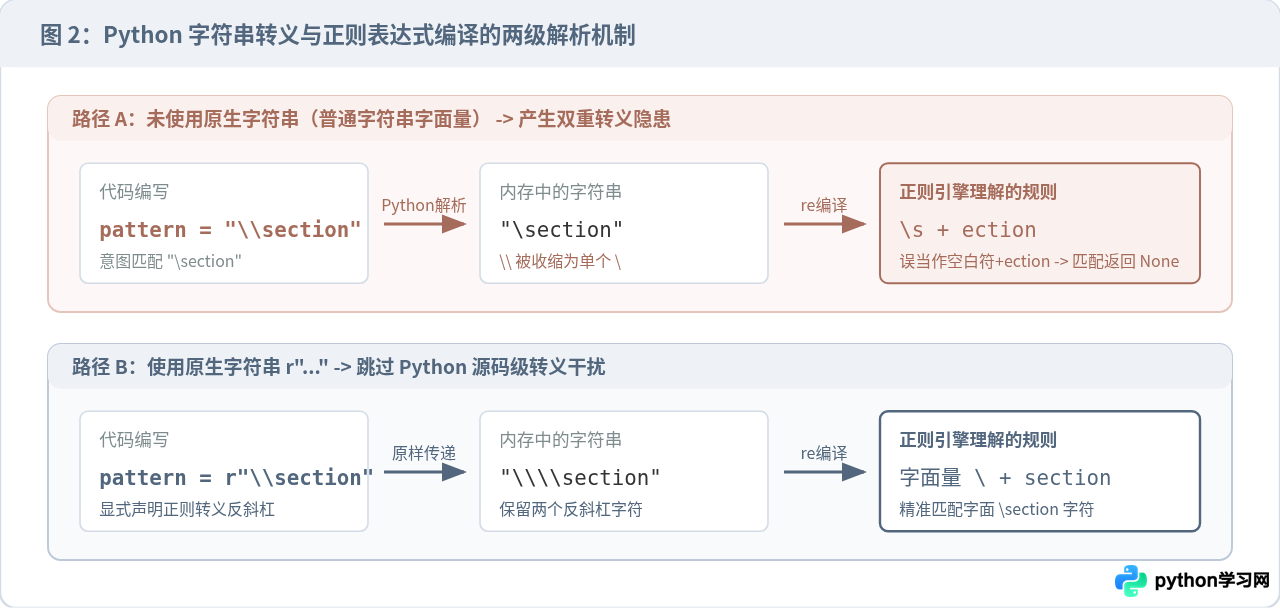
若未使用原生字符串前缀 r,Python 解释器会将某些反斜杠序列提前转义或收缩。例如,ASCII 中的 在普通 Python 字符串中代表“退格符”(ASCII 0x08),而在正则表达式中则代表“单词边界”。如果不写 r"word" 而是写成 "word",正则引擎实际接收到的将是一个退格控制符,自然永远无法匹配常规英文单词,返回 None。
import re

text = "apple pie"

# 错误写法:"apple" 中的  被 Python 转义为退格符 ASCII 8
bad_pattern = "apple"
print("普通字符串匹配:", re.search(bad_pattern, text))

# 正确写法:使用原生字符串 r"",完整保留正则单词边界元字符
good_pattern = r"apple"
m = re.search(good_pattern, text)
print("原生字符串匹配:", m.group() if m else None)原生字符串匹配: apple
同样地,若目标文本中包含正则表达式的特殊符号(例如 .、*、+、?、[、(、$、^),必须进行反斜杠转义。当需要匹配未知或动态传入的字面量文本时,应使用 re.escape() 自动完成安全转义:
import re

user_query = "price ($10.5)?"
text = "The price ($10.5)? is final."

# 未转义直接搜索,括号和问号会被当成捕获组和量词,导致匹配失败
print("未转义模式:", re.search(user_query, text))

# 使用 re.escape() 对字面量字符全量转义
safe_pattern = re.escape(user_query)
print("安全转义模式:", re.search(safe_pattern, text).group())安全转义模式: price ($10.5)?
四、隐形字符与跨行陷阱:多行与点号全通模式
现代网络通信或文件读取中,文本常伴有换行符和不可见空白。这会导致两类高频的 None 现象:
- 换行符阻断点号:在正则表达式中,元字符
.默认匹配除换行符.*将在首个换行符前截断,导致整体结构无法闭合而返回None。 - Windows 与 Unix 回车符差异:Windows 文本使用
$锚点或者显式的
import re

html_data = "<div class='box'>
  Welcome
</div>"

# 陷阱:点号 . 默认不匹配换行符,跨行结构返回 None
print("默认点号匹配:", re.search(r"<div class='box'>.*</div>", html_data))

# 解决方案 1:传入 re.DOTALL (或简写 re.S) 开启点号全通
match_dotall = re.search(r"<div class='box'>.*?</div>", html_data, re.DOTALL)
print("re.DOTALL 匹配成功:", bool(match_dotall))

# 解决方案 2:使用字符集 [\s\S]*? 代替 .*
match_any = re.search(r"<div class='box'>[\s\S]*?</div>", html_data)
print("[\s\S]*? 匹配成功:", bool(match_any))re.DOTALL 匹配成功: True
[\s\S]*? 匹配成功: True
五、五步系统化排查与调试工作流
当遇到正则持续返回 None 时,不要盲目凭感觉修改复杂正则。建议按照由外至内、先排查数据源再排查规则的五步诊断法:
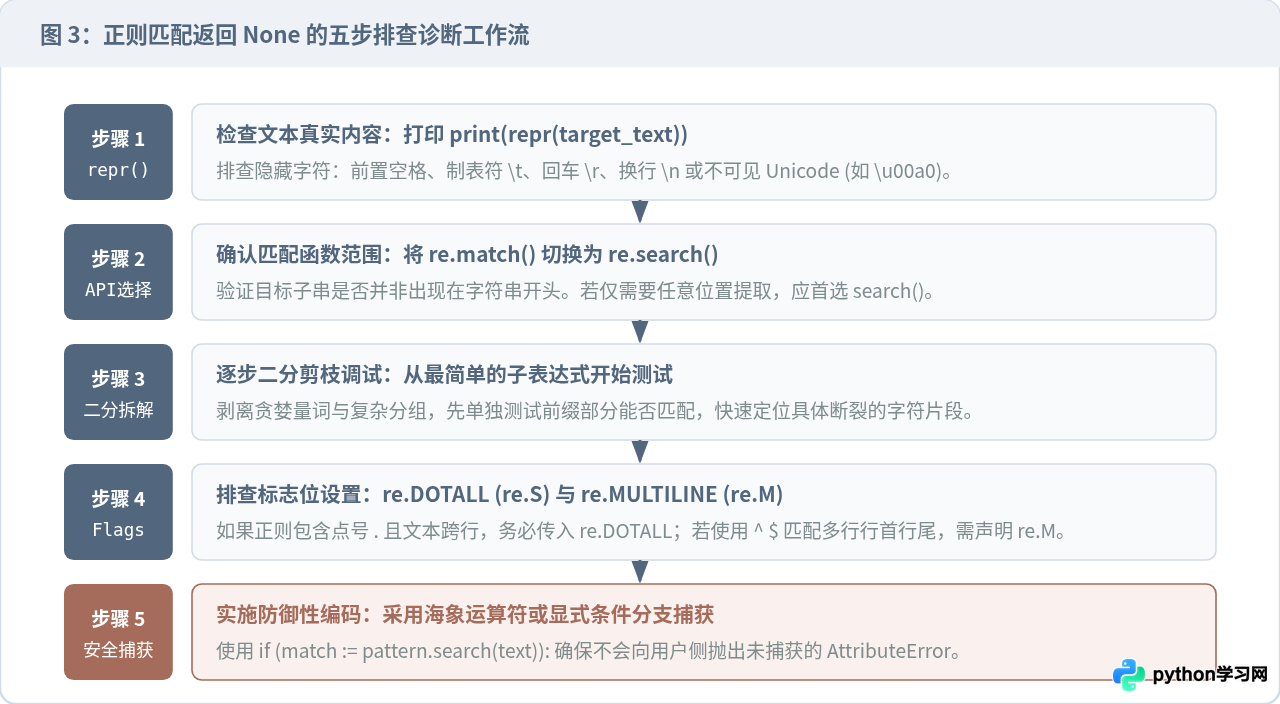
-
第一步:用
repr()检查真实字符。 普通print(text)会将制表符、回车符和无间断空格渲染为空白。直接执行print(repr(text)),检查字符串首尾是否隐藏有(UTF-8 BOM)、 -
第二步:检查 API 调用。
检查是否误用了
re.match()或re.fullmatch()。若期望提取子串,切换为re.search()测试。 -
第三步:二分剪枝调试。
将复杂的长正则表达式拆分为若干段。先测试最前面的 3~5 个字符,确认能匹配后,逐步追加后续规则,直到某一部分追加后返回
None,该部分即为断裂根源。 -
第四步:确认修饰标志(Flags)。
若存在大小写差异,检查是否漏加
re.IGNORECASE(re.I);若包含跨行内容,检查是否缺少re.DOTALL(re.S);若利用^和$锚定每行首尾,需确认是否指定了re.MULTILINE(re.M)。 -
第五步:验证量词与贪婪边界。
排查贪婪量词(如
.*)是否过度吞噬了后续定位符,导致后续元字符无字符可匹;在需要适时停下的位置改用非贪婪量词.*?。
六、防御性编码:优雅处理 None 避免系统崩溃
在真实业务工程中,输入文本来自不可控的网络请求或外部文件,不能假设任何文本都一定符合预期。因此,代码中必须始终贯彻针对 None 的防御性处理机制。
1. 使用海象运算符(Python 3.8+)
海象运算符 := 可以在 if 语句中完成赋值与真值判断,是最为简洁标准的写法:
import re

pattern = re.compile(r"Order-(\d+)")
raw_input_list = ["Order-9001", "Invalid-String", "Order-9002"]

for item in raw_input_list:
    if (m := pattern.search(item)):
        print(f"成功提取订单号: {m.group(1)}")
    else:
print(f"警告: 数据格式不符合预期,跳过处理 -> {item!r}")警告: 数据格式不符合预期,跳过处理 -> 'Invalid-String'
成功提取订单号: 9002
2. 封装带默认值的安全提取函数
对于需要批量提取字段的场景,编写一个短小的辅助函数可以彻底消除由于 None 导致的崩溃:
import re

def safe_extract(pattern: str, text: str, group: int = 1, default: str = "") -> str:
    # 安全提取正则分组,未命中时平稳返回 default 值
    match = re.search(pattern, text)
    return match.group(group) if match else default

log_entry = "CPU_LOAD: 88.5%"
empty_entry = "MEMORY_INFO: N/A"

cpu = safe_extract(r"CPU_LOAD:\s*([\d\.]+)%", log_entry, default="0.0")
mem = safe_extract(r"CPU_LOAD:\s*([\d\.]+)%", empty_entry, default="0.0")

print(f"CPU使用率: {cpu}")
print(f"缺省情况返回值: {mem}")缺省情况返回值: 0.0
七、排查与对策速查指南
下表总结了导致 Python 正则匹配返回 None 的典型特征与标准修复对策,可在日常排错中对照自检:
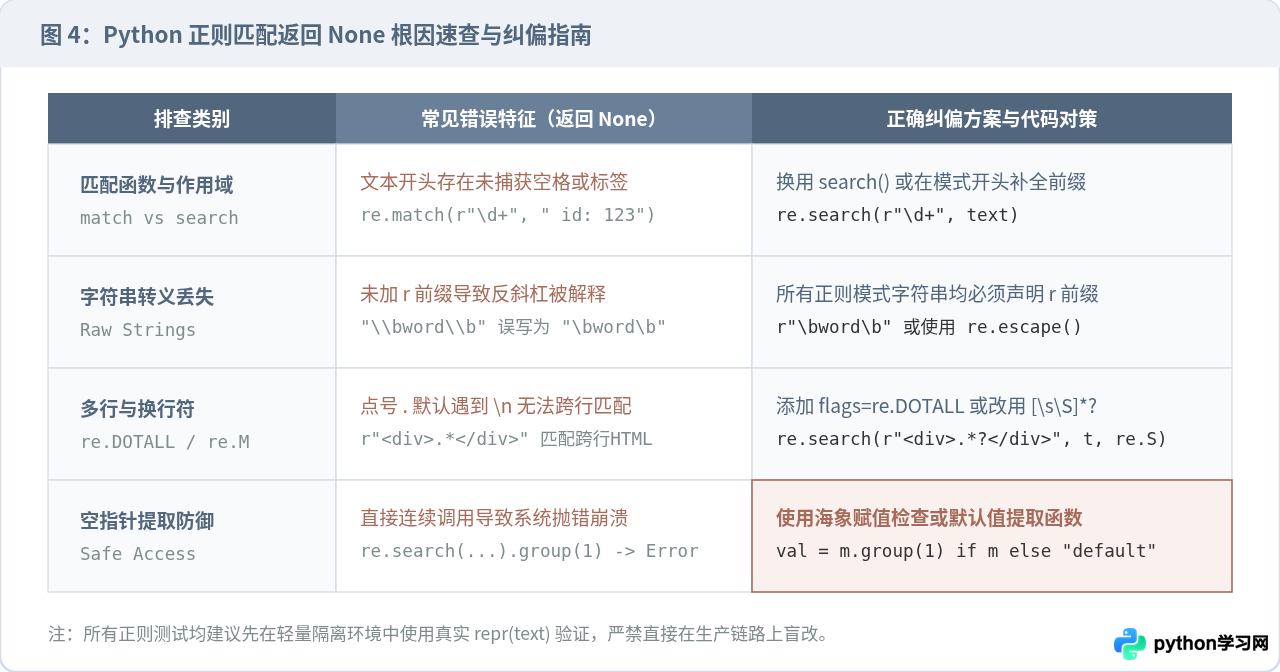
归纳而言,在 Python 中处理正则匹配时,把“返回 None”视为常态而非异常,是编写高可用脚本的基础认知。通过严格使用 r"" 原生字符串、准确选择 re.search 与 re.match、配合 repr() 打印真实输入,再在代码中结合海象运算符实现空值防护,即可从容解决正则不匹配问题,彻底杜绝 AttributeError 崩溃。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









