

Python正则表达式提取子串与替换文本的实战示例
系统讲解Python中re模块提取子串与替换文本的核心方法,涵盖捕获组机制、命名分组、re.findall与re.finditer对比,以及re.sub反向引用与回调函数替换实战示例。
re 模块无需额外安装第三方依赖,即可原生支持这两项操作。子串提取的核心在于利用圆括号划分“捕获组”,并结合 re.search() 或 re.finditer() 读取匹配对象;文本替换则依托 re.sub(),既能通过模板反向引用重构字符串,也能接入 Python 回调函数完成动态复杂计算。本文通过完整的代码范例与结构化图示,剖析这两项操作的实现步骤、内部机理与选型依据。
一、提取子串的核心步骤:捕获组与 Match 对象
许多初学者在使用正则表达式提取子串时,往往直接使用全局匹配,得到的是整段包含修饰符的无关字符串。要精准拿到特定位置的字符,关键在于捕获组(Capturing Groups)。在正则表达式中,任何被英文圆括号 () 包裹的子模式都会被正则引擎记录为一个捕获组。
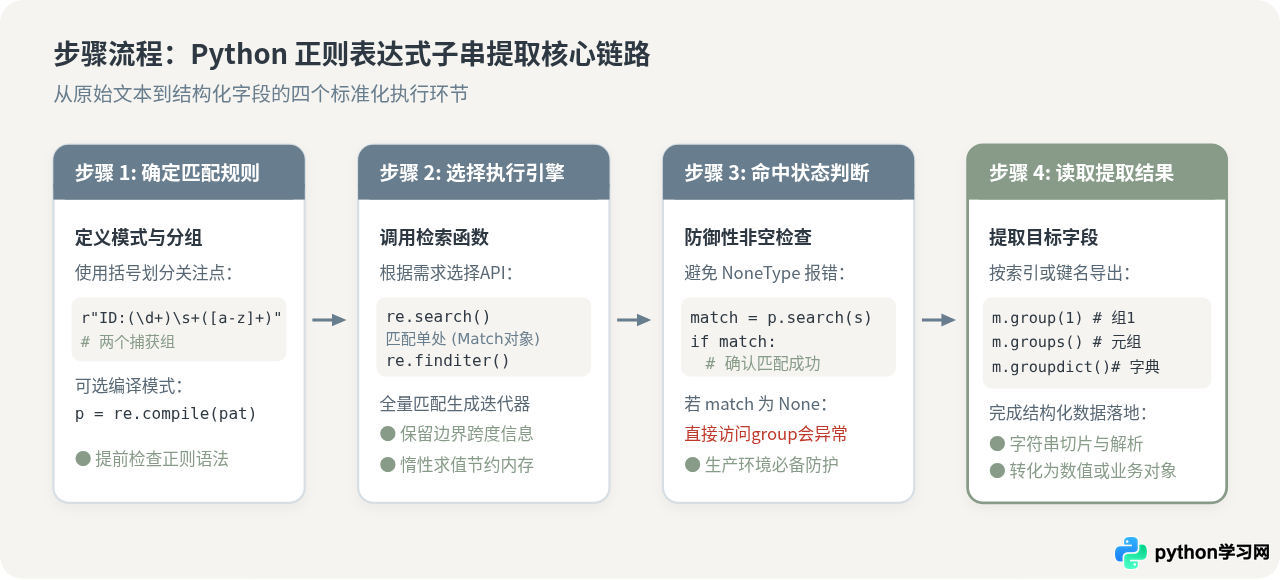
提取操作的基本步骤由四个环节构成:定义带有捕获组的模式串、调用检索函数、对返回值进行非空判断以避免程序崩溃、最后通过索引或名称获取目标字段。
1. 基础编号捕获组示例
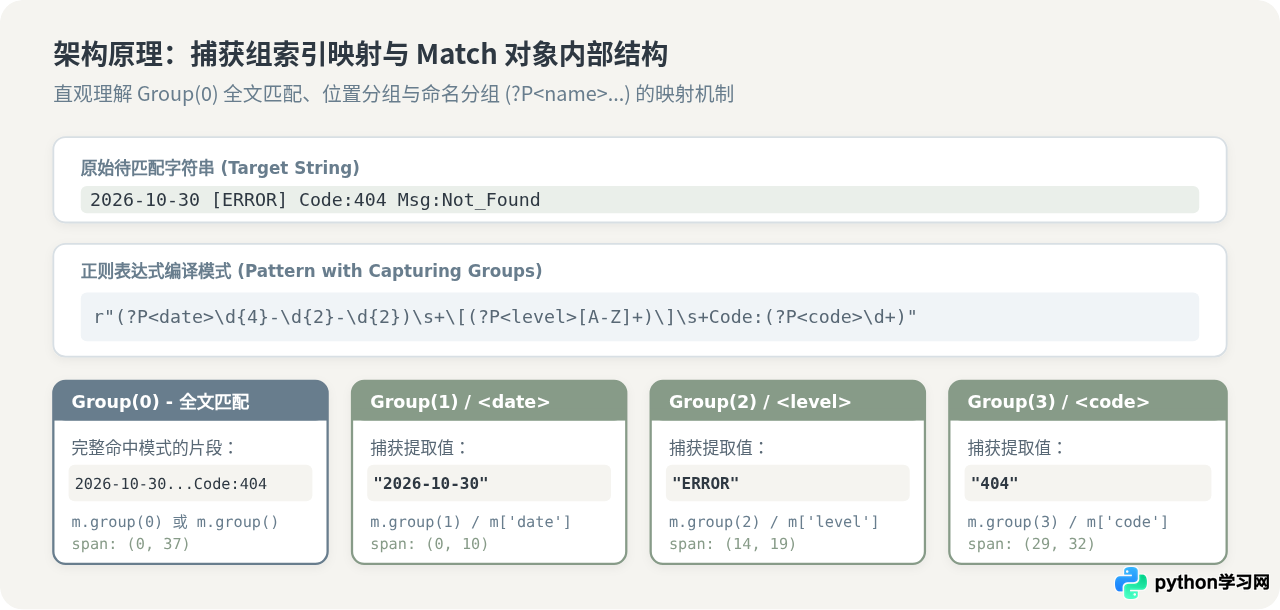
假设我们需要从一条标准的服务器访问日志中提取客户端 IP 地址、HTTP 状态码和响应耗时。模式中的每个圆括号对应一个组号,从左往右按括号出现的顺序依次从 1 开始编号,而编号 0 则恒定代表完整命中的字符串。
# 执行环境:Python 3.8+ 交互式终端或脚本
import re

log_line = '192.168.1.105 - - [2026-10-30 20:15:22] "GET /api/v1/user HTTP/1.1" 200 128ms'

# 模式包含三个圆括号捕获组:IP、状态码、毫秒数
pattern = r'(\d+\.\d+\.\d+\.\d+).*?"\s+(\d{3})\s+(\d+)ms'

match = re.search(pattern, log_line)

if match:
    # group(0) 为完整匹配内容
    full_str = match.group(0)
    # 按照括号顺序读取提取的子串
    client_ip = match.group(1)
    status_code = match.group(2)
    latency = int(match.group(3))

    print(f"提取结果 -> 客户端IP: {client_ip}, 状态码: {status_code}, 响应耗时: {latency}毫秒")
else:
    print("未匹配到符合格式的日志")
2. 命名捕获组与字典提取
当表达式较长、包含多个提取项时,数字索引(如 group(1)、group(2))极易因后续增加括号而产生序号错位,降低代码可维护性。Python 支持命名捕获组语法 (?P<name>pattern),使提取代码能够直观地通过字段名访问,或通过 groupdict() 直接导出字典。
import re

log_entry = "2026-10-30   [ERROR]   Code:404   Msg:Not_Found"

named_pattern = (
    r"(?P\d{4}-\d{2}-\d{2})\s+"
    r"\[(?P[A-Z]+)\]\s+"
    r"Code:(?P\d+)"
)

m = re.search(named_pattern, log_entry)
if m:
    # 方式一:按字段名读取单个子串
    print("日志级别:", m.group('level'))
    print("错误码:", m.group('code'))

    # 方式二:直接导出全部字段为标准字典
    data = m.groupdict()
    print("完整结构化字典:", data)
    print("时间跨度索引范围:", m.span('date'))
二、全量提取对比:re.findall 与 re.finditer 的关键差异
在提取包含多条目标子串的文本时,Python 提供了两个高频函数:re.findall() 与 re.finditer()。在相同输入数据条件下,两者的执行机制与返回对象存在本质差异,理解这一差异对性能敏感和需位置元数据的场景至关重要。
一致条件下的对比验证
下面使用同一段订单清单文本,分别使用 findall 和 finditer 完成解析并观察差异:
import re

raw_orders = """
ORD-A101: Amount=$450.00, Status=PAID
ORD-B202: Amount=$12.50, Status=PENDING
ORD-C303: Amount=$8900.00, Status=CANCELLED
"""

order_pattern = r'ORD-(?P[A-Z0-9]+):\s+Amount=\$(?P[\d\.]+)'

# --- 做法 1:re.findall ---
list_results = re.findall(order_pattern, raw_orders)
print("re.findall 返回类型:", type(list_results))
print("re.findall 返回内容:", list_results)

# --- 做法 2:re.finditer ---
iter_results = re.finditer(order_pattern, raw_orders)
print("re.finditer 返回类型:", type(iter_results))
for match in iter_results:
    print(f"匹配片段: {match.group(0)} | 起止跨度: {match.span()} | 提取金额: {match.group('amount')}")
关键差异为什么重要
| 对比维度 | re.findall() | re.finditer() | 实际影响与选型建议 |
|---|---|---|---|
| 返回类型 | 纯字符串或元组构成的 list |
生成器迭代器,产生 Match 实例 |
findall 丢失了命名组名称和元数据,仅返回纯字面量;finditer 保留完整对象。 |
| 内存开销 | 即时求值,一次性在内存中构建完整列表 | 惰性求值,随循环按需消耗单条匹配 | 分析数百兆的大型日志文件时,findall 易造成内存骤增,而 finditer 仅维持极低常数级内存。 |
| 位置信息 | 无,无法得知命中内容在源文本中的索引 | 提供 .start()、.end()、.span() |
若后续需要定位上下文、进行语法高亮或原位标记,必须使用 finditer。 |
三、文本替换实战:静态反向引用与模板重构
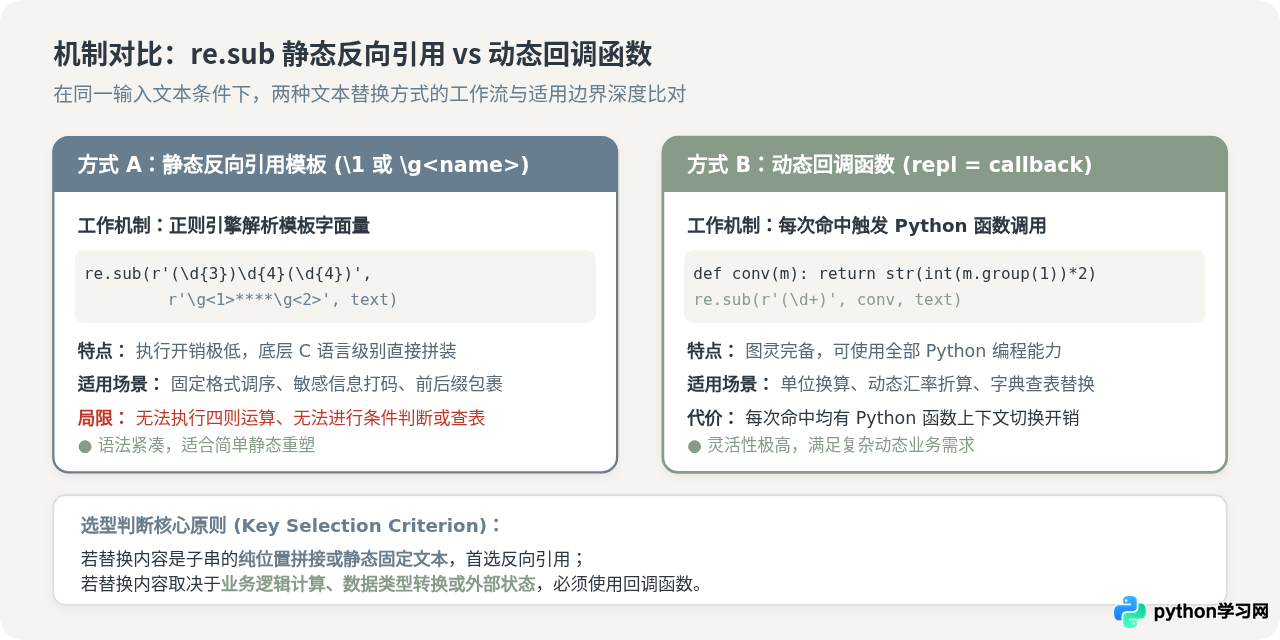
文本替换通过 re.sub(pattern, repl, string, count=0) 完成。参数 pattern 是匹配规则,repl 是替换内容,string 是源文本,可选的 count 用于限制最大替换次数。
当替换后的内容由原文本中的某些子片段重新组合而成时,无需手动截取拼接,可以直接在 repl 字符串中使用反向引用(Backreference)。
1. 格式重排与反向引用规范
常见需求例如将“年-月-日”格式的日期统一重组为“日/月/年”。反向引用支持序号语法(如 )与转义组名语法(如 \g<name> 或 \g<1>)。
import re

dates_text = "重要发版时间:2026-05-18,归档时间:2026-12-31"

# 模式:四个数字的年份、两位月份、两位日期
date_pattern = r'(\d{4})-(\d{2})-(\d{2})'

# 推荐写法:使用 \g<组号> 明确边界,避免后续紧邻数字引起解析歧义
formatted_text = re.sub(date_pattern, r'\g<3>/\g<2>/\g<1>', dates_text)

print("原始文本:", dates_text)
print("重排结果:", formatted_text)
组1 + '0'),若写成 r'',正则引擎会尝试寻找编号为 10 的捕获组,从而导致意想不到的错误或越界。而采用 r'\g<1>0' 或命名引用 r'\g<ver>0',界限清晰,彻底规避此类歧义。
2. 敏感信息批量脱敏掩码
在用户数据安全处理中,经常需要对手机号中间四位或身份证部分数字打上星号。利用捕获组分别保留前缀与后缀,中间插入固定掩码即可实现脱敏:
import re

contact_data = "客服电话:13812345678,主管专线:18698765432,备用座机:010-88889999"

# 匹配并分别捕获手机号的前3位和后4位,丢弃中间4位
phone_pattern = r'(1[3-9]\d)\d{4}(\d{4})'

masked_data = re.sub(phone_pattern, r'\g<1>****\g<2>', contact_data)

print("脱敏后数据:", masked_data)
四、动态文本替换:re.sub 配合回调函数
当替换目标不能仅靠静态模板拼装,而是需要进行四则运算、单位换算、数据库或字典查表、条件分支判断时,静态字符串模板便无法胜任。此时,可将 re.sub() 的第二个参数传入一个自定义函数(Callable)。
每次正则引擎在文本中命中目标时,会自动将当前的 Match 实例作为参数传递给该函数,函数的返回值(必须为字符串)即作为该处命中的替换内容。
实战场景 1:单位动态换算与数值四舍五入
将英文技术文档中的英里(miles)数值批量提取出来,自动按换算比率(1 mile = 1.60934 km)计算并替换为公里:
import re

travel_doc = "航程清单:航段A长 120.5 miles,航段B长 45 miles,航段C仅 8.2 miles。"

def convert_miles_to_km(match: re.Match) -> str:
    # 从捕获组中获取数值并转为浮点数
    miles = float(match.group('val'))
    km = miles * 1.60934
    # 格式化为保留一位小数的公制字符串
    return f"{km:.1f} 公里"

# 匹配数值后紧跟 miles 的子串
pattern = r'(?P\d+(\.\d+)?)\s*miles'

converted_doc = re.sub(pattern, convert_miles_to_km, travel_doc)

print("转换前:", travel_doc)
print("转换后:", converted_doc)
实战场景 2:字典查表与词汇多国语言国际化
当需要一次性替换多个不同的预设标签时,若多次调用 replace(),每次都会全量扫描文本。使用正则回调配合字典查表,仅需单次正则扫描即可全部替换完毕:
import re

template_text = "系统提示:[status_ok],用户操作已成功;如有疑问请联系 [support_email] 或提交工单 [status_pending]。"

# 映射字典
i18n_dict = {
    "status_ok": "【执行成功】",
    "status_pending": "【待审核】",
    "support_email": "helpdesk@company.com"
}

# 匹配所有方括号标签
tag_pattern = r'\[(?P[a-z_]+)\]'

def tag_replacer(m: re.Match) -> str:
    tag_name = m.group('tag')
    # 查表返回,若字典未收录则保留原标签
    return i18n_dict.get(tag_name, m.group(0))

result_text = re.sub(tag_pattern, tag_replacer, template_text)
print("查表替换结果:
", result_text)
五、工程实践要点与常见问题防范
-
原始字符串前缀(Raw String):所有用于正则的字符串必须以
r开头(如r"\d+")。在普通字符串中,反斜杠会被 Python 解释器首先转义,例如写匹配换行符可能需要写四个反斜杠,而 raw string 则直接将原生字符完整送达正则引擎。 -
贪婪与非贪婪修饰符:默认情况下正则的量词(如
*、+)属于贪婪匹配,会尽可能吞噬更长字符。提取双引号内的内容时,若写r'".*"'会直接从第一处双引号匹配到整行最后一处;必须改用非贪婪模式r'".*?"'才能逐段正确截断。 -
预编译提升高频吞吐:在循环处理几万行文本时,应先在循环外调用
compiled_p = re.compile(pattern),避免每次循环重复编译正则表达式字节码。 -
统计替换次数:若想知道总共替换了多少处文本,可使用
re.subn(),它返回一个二元元组(new_string, number_of_subs_made)。
六、总结与方法选型路线
提取子串与文本替换是 Python 处理文本的两把手术刀。面对不同规模的源文本与业务复杂度,可根据以下决策路径确定最佳 API 与实现方式:
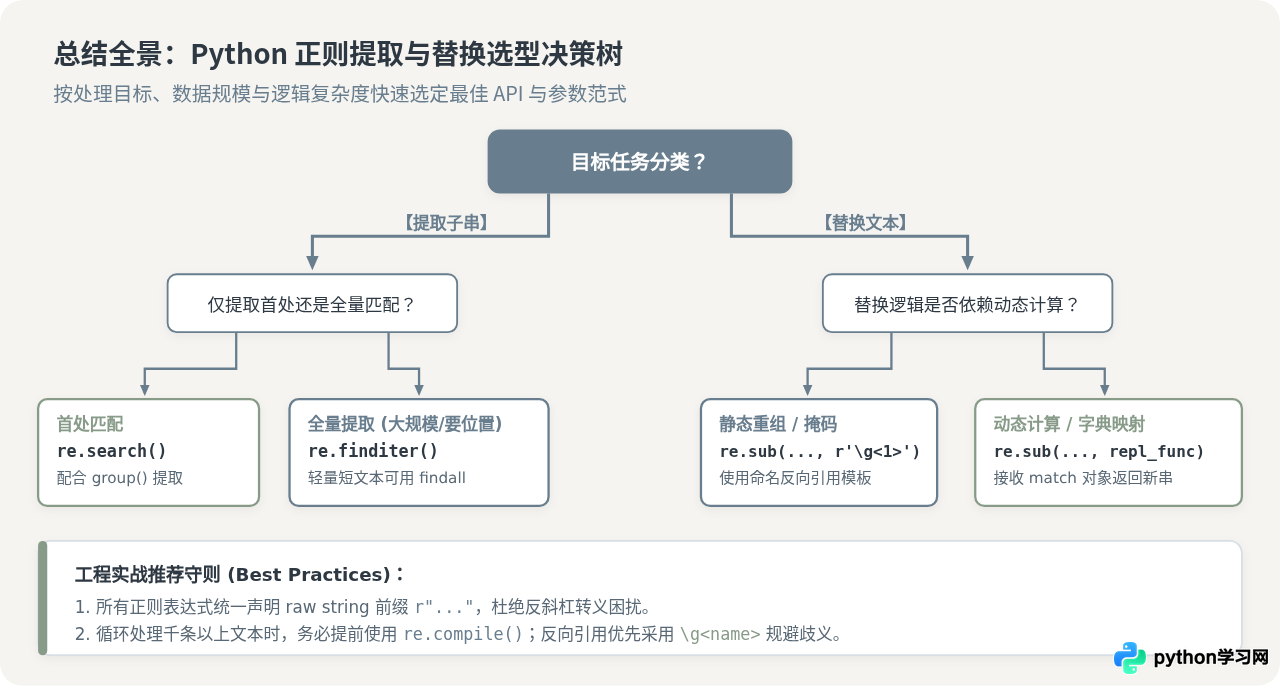
| 任务类型 | 推荐方法 | 核心依托机制 | 适用场景特征 |
|---|---|---|---|
| 单次子串提取 | re.search().group() |
编号或命名分组 (?P<name>) |
只关心全文第一处出现的目标,提取结构化字段。 |
| 小规模批量提取 | re.findall() |
直接返回元组/字符列表 | 短字符串、简单收集所有符合条件的项目,不需要索引。 |
| 大规模批量提取 | re.finditer() |
惰性迭代器生成 Match 对象 |
日志流式处理、超大文件扫描,需要获取字符跨度与命名组。 |
| 静态文本重排 | re.sub(..., r'\g<name>') |
反向引用模板 | 固定规则调序、电话脱敏、标签包裹等无状态重构。 |
| 动态复杂替换 | re.sub(..., callback) |
Python 回调函数接收 Match |
单位换算、字典查表、多分支逻辑处理。 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









