

Python中过滤纯数字字符串的几种实现方式

在Python开发中,经常需要处理包含数字和文本混合的列表,并从中筛选出非纯数字的字符串。本文对比了正则表达式、异常捕获机制以及字符串内置方法三种实现路径,重点解析利用 strip 和 isdigit 等内置特性的高效处理方式。
使用正则表达式过滤
正则表达式是处理字符串匹配的经典工具。若目标是滤除仅包含数字的字符,可以通过匹配非数字开头的单词来实现。以下代码展示了如何遍历列表,利用 re.findall 提取符合特定模式的字符串:
import re

L = [u'小明', 'xiaohong', '12', 'adf12', '14']

for i in range(len(L)):
    if re.findall(r'^[^\d]\w+', L[i]):
        print(re.findall(r'^\w+$', L[i])[0])
    elif isinstance(L[i], unicode):
        print(L[i])
虽然正则表达式功能强大,但在处理简单的数字过滤时,编写和调试正则模式可能显得较为繁琐。
利用异常处理机制
另一种直观的思路是尝试将字符串转换为整数。如果转换成功,说明该字符串仅由数字组成;如果抛出异常,则保留该字符串。这种方法逻辑简单,无需引入正则模块:
L = ['xiaohong', '12', 'adf12', '14', u'晓明']

for x in L:
    try:
        int(x)
    except:
        print(x)
此方法在 Python 2 和 Python 3 中均适用,通过 try-except 块捕获 ValueError 异常,从而筛选出非纯数字内容。
使用字符串内置方法
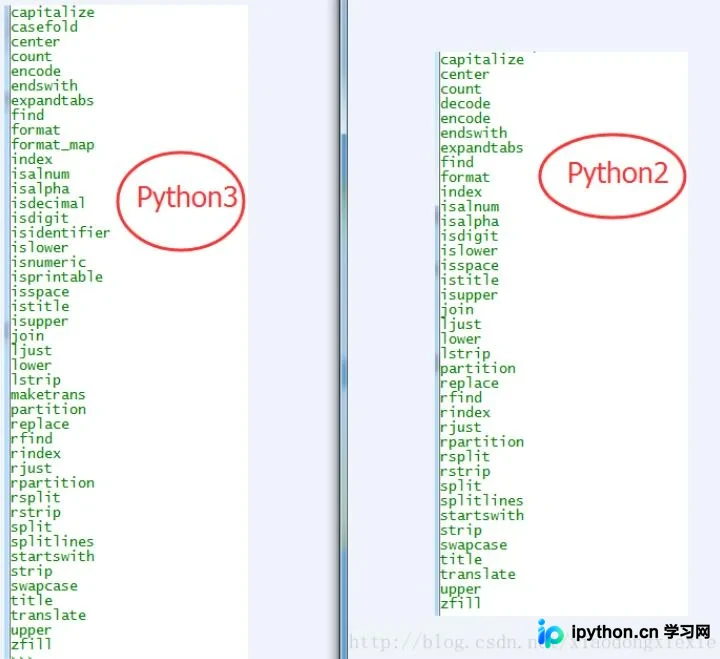
Python 的字符串对象提供了丰富的内置方法,可以更简洁地实现过滤。在 Python 3 中,isdigit() 方法可直接判断字符串是否仅包含数字:
L = ['xiaohong', '12', 'adf12', '14', u'晓明']

# 对于python3来说同样还可以使用string.isnumeric()方法
for x in L:
    if not x.isdigit():
        print(x)
利用 strip 方法去除两端数字
除了判断,还可以利用 strip()、lstrip() 和 rstrip() 方法去除字符串两端的数字字符。这些方法接受一个字符集参数,移除该集合中出现在字符串首尾的所有字符:
import string

astring = '12313213215just for 32 test 1306436'

# 去除两端数字
print(astring.strip(string.digits))
# 输出: 'just for 32 test '

# 仅去除右端数字
print(astring.rstrip(string.digits))
# 输出: '12313213215just for 32 test '

# 仅去除左端数字
print(astring.lstrip(string.digits))
# 输出: 'just for 32 test 1306436'需要注意的是,strip 方法不会移除字符串中间的数字。此外,传递给 strip 的参数不需要按顺序排列,例如 strip('0123456') 同样有效:
# 注意
print(astring.strip('0123456'))
# 输出: 'just for 32 test '
通过上述几种方法,开发者可以根据具体需求选择最合适的字符串过滤策略。正则表达式适合复杂模式匹配,异常处理适合类型转换场景,而内置字符串方法则在处理简单数字过滤时最为高效。
 以上就是基于Python代码实现简易滤除数字方法的详细内容,更多关于Python字符串处理技巧的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









