

带详细解析的Python练习题资源推荐:不仅给答案更讲思路
精选不仅提供参考答案更注重解题思路与推导逻辑的Python练习平台,深入分析Exercism、Python Morsels、CheckiO等资源的解析特色与吸收方法。
许多学习者在刷Python练习题时常遇到一种困境:题目做不出来时翻看解答,直接映入眼帘的往往是只有三五行极简却抽象的代码;即使照着敲一遍通过了测试,遇到新场景依然无法自主构建解法。要突破这种瓶颈,关键在于寻找那些详细展示“思考起点、逻辑分支与演进过程”的练习资源。本文将推荐几个真正深耕解题思路的练习平台,并剖析如何高效消化题解中的分析链条。
一、“看代码答案”与“看解题思路”的认知差异
一段优秀的题解,价值不在于最终写出来的 return 语句,而在于从问题描述提炼为算法模型的过程。单纯看答案只能让人获知某种固定语法组合,而思路解析则会交代为什么放弃某种显而易见的暴力循环、为何选择特定数据结构,以及代码在各种边界条件下的状态转移。
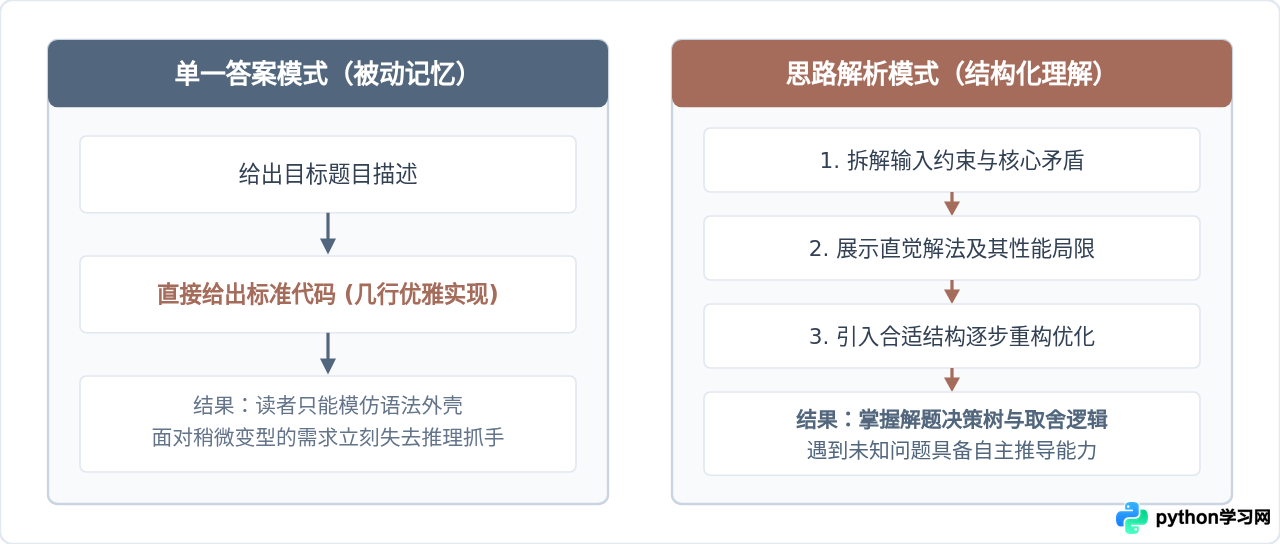
这种差异在日常练习中尤为明显。如果一道题目的答案直接使用了高级推导式配合内置函数,初学者很难明白:最初面对未格式化数据时,脑海中应先建立怎样的流程模型,再经过何种精炼才收敛为最终的实现。
二、重点带解析题库资源推荐
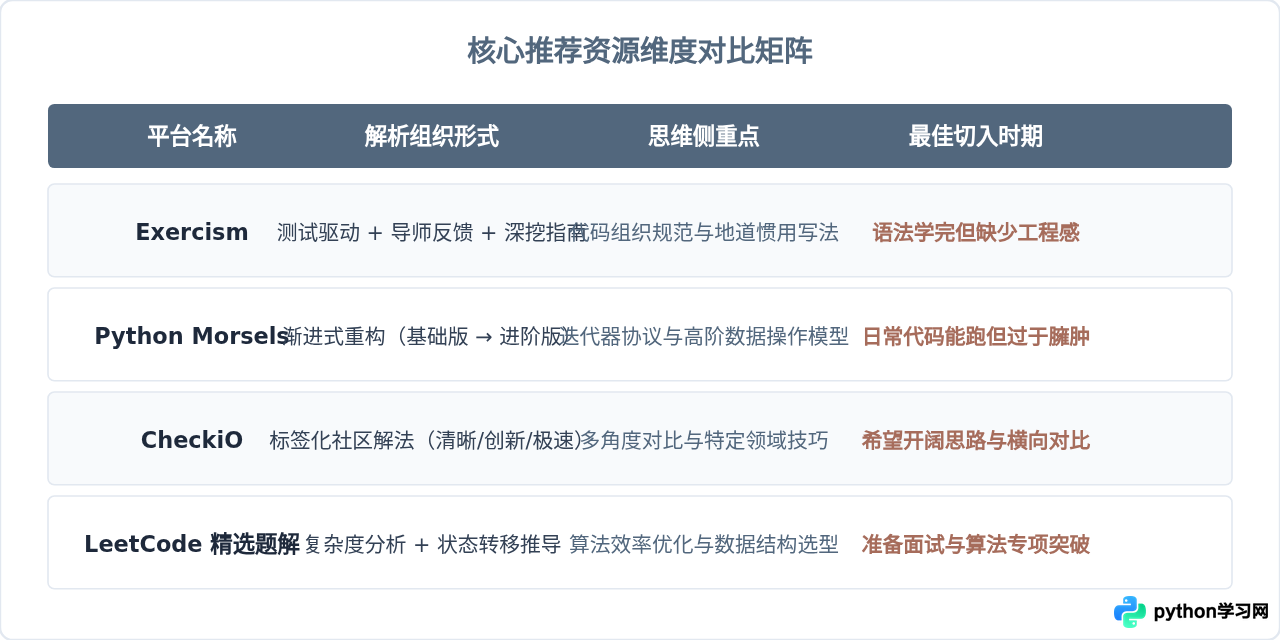
并非所有在线平台都专注于思路传授。筛选优质资源的核心标准是:题解中是否包含对思考误区的剖析、对多种实现方案的渐进式推演,以及对Python底层特性的阐释。
1. Exercism (Python Track)
Exercism 是以“代码质感(Code Mentoring)”著称的开源平台。它最大的特点是不单设运行器,而是为每道题准备了严密的单元测试套件和详尽的设计指南。
- 解析特色:每道题完成后,可以解锁社区中数千名资深工程师的解法。平台提供了“Dig Deeper”解析栏目,专门解释为什么某种看似简洁的列表解析在内存消耗上不合算,或者如何利用生成器延迟求值。
- 辅导机制:支持免费申请真人导师审查。导师不仅会指正语法,还会详细留言讨论你的抽象边界是否合理,提出思路演进建议。
- 适用人群:已掌握基础语法、希望写出地道(Pythonic)代码并理解架构细节的学习者。
2. Python Morsels (by Trey Hunner)
由Python资深讲师 Trey Hunner 创建的专项练习站。与其他平台海量刷题不同,该平台每周只精讲一到两道典型问题,但每道题的解析篇幅长达数千字。
- 解析特色:采用“Base Problem(基础版)+ Bonus 1/2/3(进阶要求)”的结构。解析会从最原始的
for循环开始写起,逐步展示何时应该引入zip(),何时该构造自定义生成器,并逐行分析不同写法在时间复杂度和可读性上的权衡。 - 适用人群:对基本语法熟练,但在面对复杂数据处理需求时容易写出冗长、难以维护代码的中级进阶者。
3. CheckiO
CheckiO 将编程任务封装在岛屿探险的场景中。它的独特价值在于解题后的“Solutions”讨论区对思路进行了严密分类。
- 分类透视:用户的解答会被系统和社区标记为
Clear(可读性优先)、Creative(独创思路)、Speedy(极致性能)或Third-party(依赖扩展库)。 - 对比启发:你可以横向对比同一道题在“注重工程可维护性”和“注重计算效率”下的不同构思流程。
4. LeetCode 官方题解与高赞解析(精选思维链标签)
虽然 LeetCode 侧重算法与数据结构,但其中标有“官方题解(Editorial)”或由活跃作者撰写的高赞题解具备极高的思维参考价值。
- 思维链呈现:优质题解通常遵循“方法一:暴力枚举(分析缺陷)→ 方法二:哈希优化(空间换时间)→ 方法三:双指针/滑动窗口(消除冗余状态)”的推导逻辑,并在附录中配有状态迁移图。
- 筛选建议:避开仅有一两行代码展示的打卡式回答,优先阅读带有“复杂度分析”和“状态转移说明”的长文解析。
三、高质量解析应呈现的四个推导阶梯
学习者在阅读优质解析时,应该按照固定的认知阶梯去拆解对方的思路。一段完整的解题思维过程通常包含以下四个递进环节:
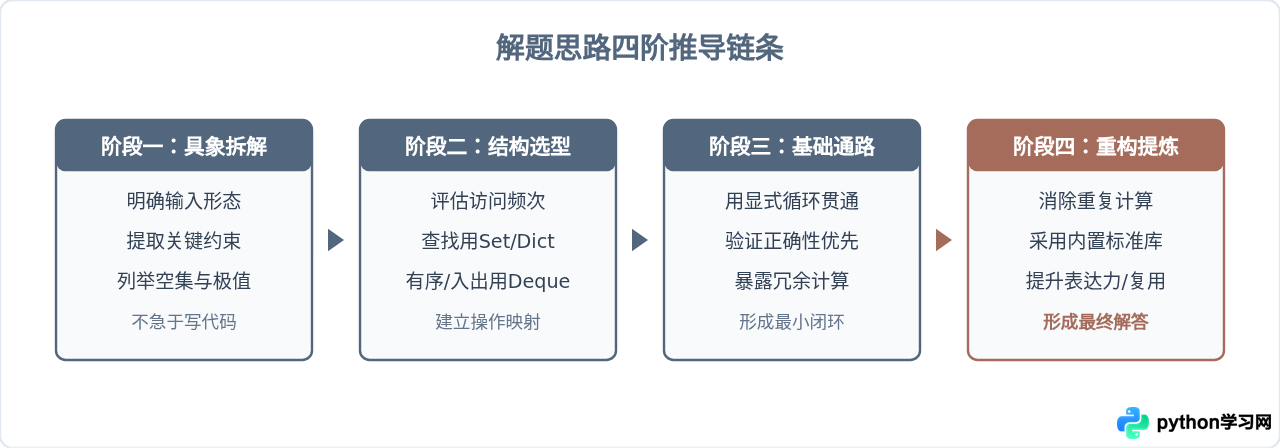
举一个具体例子:统计一段文本中出现频率前三的词汇。如果题解只直接给出一行 collections.Counter(words).most_common(3),读者学到的是一个孤立的 API 名字。但如果题解先用字典实现手动累加,再解释为何纯字典在排序时需要将键值翻转,接着讨论当词汇量达到数百万时为何堆排序(Heap)比全局快排更加高效,最后顺理成章引入 Counter 的底层实现——读者获得的就是一整套应对频次统计场景的系统化思维。
# 示例:从朴素思路到高阶封装的演进过程

# 阶段一与阶段二:基础计数与手动排序(展示核心逻辑)
word_counts = {}
for word in words:
    word_counts[word] = word_counts.get(word, 0) + 1

# 阶段三:瓶颈在于全局全量排序 sorted() 时间复杂度为 O(N log N)
# 阶段四:引入标准库 Counter,内部对小规模 Top-K 采用 heapq 优化至 O(N log K)
from collections import Counter
top_three = Counter(words).most_common(3)
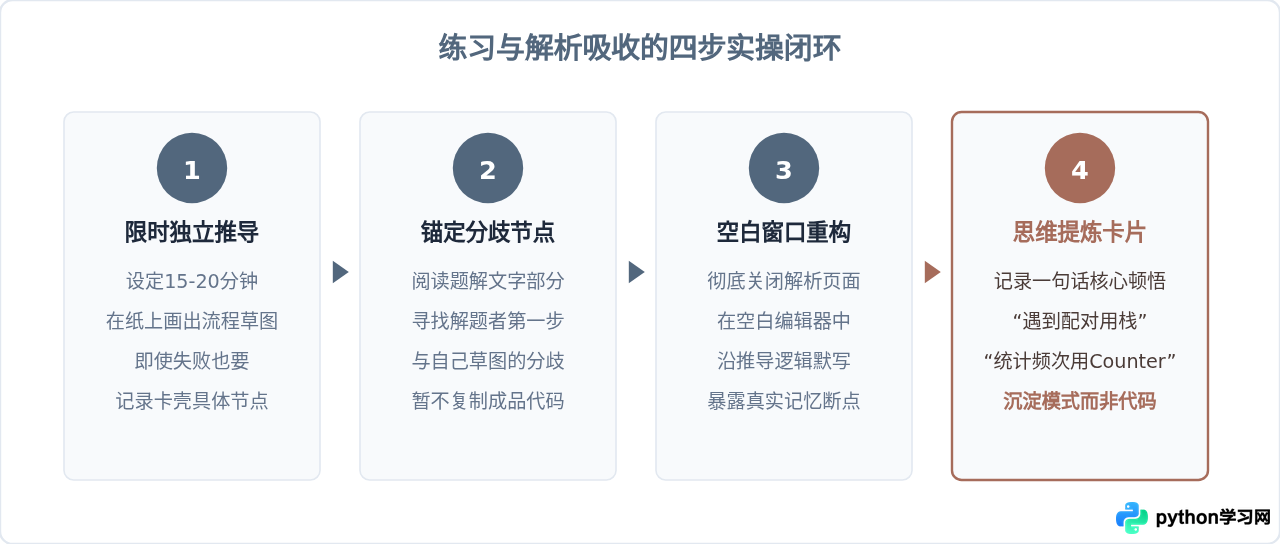
四、消化解析的四步操作闭环
即使找到了拥有详尽解析的资源,如果阅读方法不当,也很容易产生“看的时候全懂,动手写依然卡壳”的假性掌握。推荐在练习中严格执行以下四步工作流:
五、常见避坑事项
在利用解析资源进行练习时,还需要避免以下两个常见的学习陷阱:
- 误区一:过度迷信“一行流代码”(One-liner)。部分社区用户喜欢利用复杂的列表推导与嵌套匿名函数将解法压缩至单行。这种写法具有观赏性,但违背了Python清晰直观(Readability counts)的设计哲学。优质的思路解析绝不会鼓励无意义的代码压缩,而是优先保证语义清晰。
- 误区二:跳过复杂度分析。只看代码能否通过样例输入,而不关心在极端数据量下的表现。如果题解没有解释空间复杂度与时间复杂度,建议使用本地的
timeit模块自行测试输入规模从 100 到 100,000 时的耗时曲线,形成直观感受。
六、总结与落地建议
选择练习资源的核心,是看它能否在你和真实工程挑战之间架设一座思维桥梁。建议初学者先在 Exercism 上通过测试套件和导师反馈建立规范的代码组织习惯;当需要攻关进阶语法和复杂迭代模式时,精读 Python Morsels 的重构过程;需要拓展思路广度时,浏览 CheckiO 的分类解答。最重要的是:每次翻看解析前,都要逼迫自己留下清晰的思考草稿,让解析成为修正你思维偏差的镜子,而不是被动抄写的模板。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









