

Python标准库csv模块怎么读取文件?reader与DictReader示例
详细介绍如何使用Python标准库csv模块读取CSV文件,重点讲解csv.reader列表解析与csv.DictReader字典映射的核心区别、代码示例、常用参数与注意事项。
Python内置的 csv 模块提供了开箱即用的CSV文件读写支持,开发者无需额外安装第三方依赖库即可高效处理表格数据。读取CSV文件通常有两种核心途径:使用 csv.reader 将每一行数据解析为基础的字符串列表,或者使用 csv.DictReader 将每一行映射为以列标题为键的字典对象。本文将详细演示这两种解析方式的标准用法、代码示例、关键参数以及实战中常见问题的排查方法。
一、标准读取流程与文件打开规范
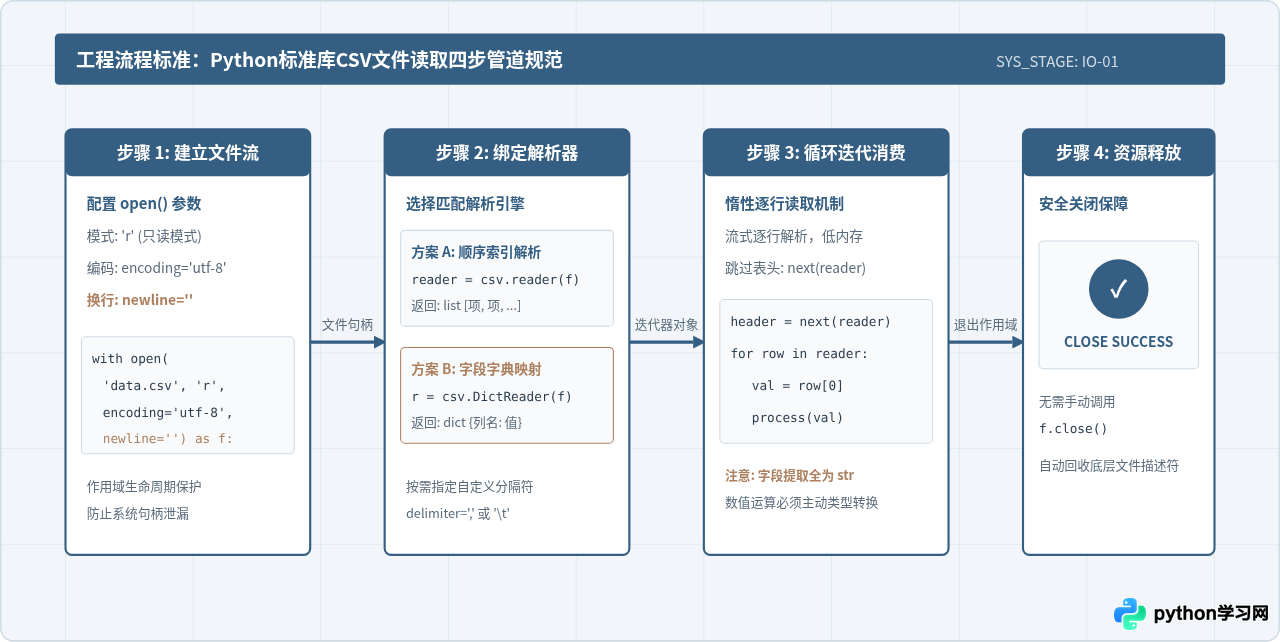
使用 csv 模块读取数据时,首先需要通过 Python 原生的 open() 函数建立文件流对象,再将其传递给相应的 CSV 读取器。为了保障跨平台兼容性和编码一致性,必须在调用 open() 时指定正确的字符编码与换行符处理参数。
在打开文件时,推荐使用 with 上下文管理器,这样无论读取过程是否发生异常,文件资源都能在离开作用域后得到可靠释放。特别需要注意的是参数 newline='':Python 官方文档明确要求,在向 csv 模块传递文件对象时,应将 open() 的 newline 参数设置为空字符串,由 csv 模块自行解析换行符,避免不同操作系统在换行处理上产生空行或数据错位。
二、使用 csv.reader 进行基于行索引的基础读取
csv.reader 是最基础也是执行效率最高的读取工具。它接受一个已经打开的可迭代文件对象,返回一个读取器迭代器。在循环遍历该读取器时,每一行文本都会被解析为一个包含各个字段字符串的 Python 原生列表(list)。
1. 基础读取与逐行打印
假设我们有一个名为 employees.csv 的员工数据文件,其内容包含表头以及数行由逗号分隔的信息:
id,name,department,salary
1001,Zhang San,Engineering,15000
1002,Li Si,Marketing,12000
1003,Wang Wu,Operations,11000
使用 csv.reader 读取该文件的最简标准代码如下:
import csv

file_path = 'employees.csv'

with open(file_path, mode='r', encoding='utf-8', newline='') as f:
    reader = csv.reader(f)
    for row in reader:
        print(row)
运行上述代码后,终端将输出以下示例内容:
# 示例输出:
['id', 'name', 'department', 'salary']
['1001', 'Zhang San', 'Engineering', '15000']
['1002', 'Li Si', 'Marketing', '12000']
['1003', 'Wang Wu', 'Operations', '11000']
2. 跳过表头与提取特定列
在实际业务处理中,表头往往包含列名而非数据实体。由于 csv.reader 返回的是常规迭代器,我们可以通过 Python 内置函数 next(reader) 先行读取并消费掉第一行表头,随后在 for 循环中仅处理具体的数据行。各列数据通过列表下标进行访问,如下所示:
import csv

file_path = 'employees.csv'

with open(file_path, mode='r', encoding='utf-8', newline='') as f:
    reader = csv.reader(f)
    # 读取并保存表头,迭代器游标自动移至下一行
    header = next(reader)
    print(f"表头字段: {header}")

    # 遍历纯数据行,通过数值索引提取数据
    for row in reader:
        emp_id = row[0]
        emp_name = row[1]
        dept = row[2]
        # 注意:CSV解析得到的值全部为str类型,计算时需手动转换
        salary = float(row[3])
        print(f"员工编号: {emp_id}, 姓名: {emp_name}, 部门: {dept}, 薪资: {salary:.2f}")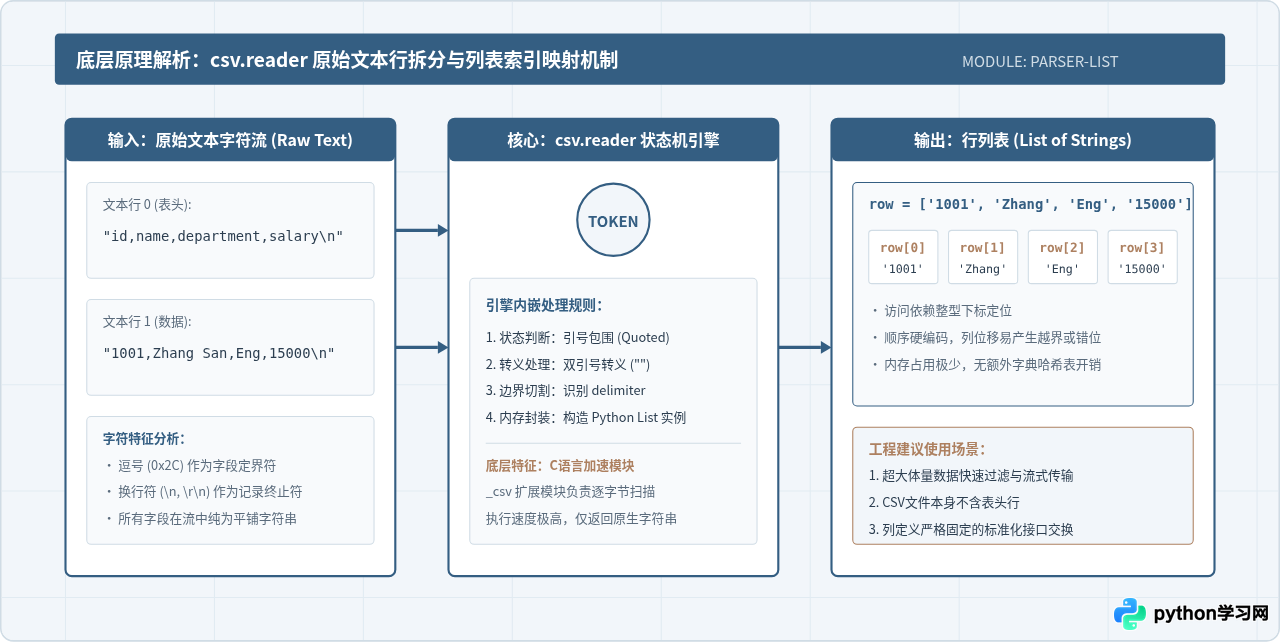
三、使用 csv.DictReader 进行基于列名映射的字典化读取
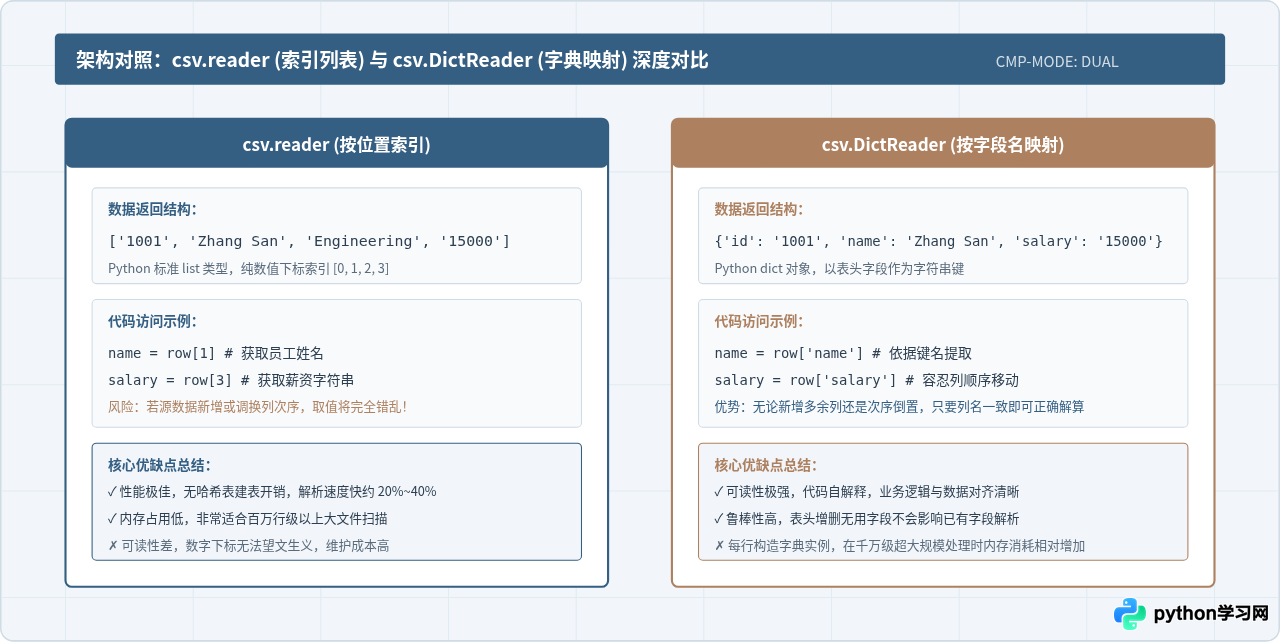
虽然 csv.reader 运行速度极快且占用内存少,但在大型工程或复杂业务中,若 CSV 文件的列顺序发生调整,硬编码的数字下标(例如 row[2])就会出现取错字段或越界错误。csv.DictReader 解决了这一痛点。
csv.DictReader 会在实例化时自动将文件的第一行作为键集合(fieldnames),在后续每次迭代时,将每行数据封装为一个字典。开发者可以直接使用列名称来读取对应数据,无需关心该列处于第几列。
1. 基础用法与键名访问
同样以之前的 employees.csv 为例,使用 csv.DictReader 进行读取的代码如下:
import csv

file_path = 'employees.csv'

with open(file_path, mode='r', encoding='utf-8', newline='') as f:
    dict_reader = csv.DictReader(f)

    # 打印自动解析出的表头字段名列表
    print(f"检测到的字段名: {dict_reader.fieldnames}")

    for row in dict_reader:
        # row 是一个字典对象,直接通过列名访问对应值
        emp_id = row['id']
        emp_name = row['name']
        dept = row['department']
        salary = float(row['salary'])
        print(f"[{emp_id}] {emp_name} - {dept} (月薪: {salary})")
运行结果将展示基于键值的解析输出:
# 示例输出:
检测到的字段名: ['id', 'name', 'department', 'salary']
[1001] Zhang San - Engineering (月薪: 15000.0)
[1002] Li Si - Marketing (月薪: 12000.0)
[1003] Wang Wu - Operations (月薪: 11000.0)
2. 无表头文件或自定义列名读取
如果读取的 CSV 文件本身没有包含表头行,或者希望重命名文件中的列名,可以在构造 csv.DictReader 时显式传递 fieldnames 参数列表:
import csv

# 假设该文件第一行就是数据,没有表头
raw_data_file = 'raw_log.csv'
custom_headers = ['log_time', 'level', 'message']

with open(raw_data_file, mode='r', encoding='utf-8', newline='') as f:
    reader = csv.DictReader(f, fieldnames=custom_headers)
    for row in reader:
print(f"时间: {row['log_time']} | 级别: {row['level']} | 内容: {row['message']}")注意:如果显式传递了 fieldnames,DictReader 不会把文件的第一行当作表头消耗掉,而是直接从第一行开始作为常规数据匹配你提供的 fieldnames。如果原始文件已有表头,且你传入了自定义 fieldnames,通常需要在进入循环前先执行一次 next(reader) 丢弃原文件的表头行。
四、进阶参数:应对非常规格式的 CSV 数据
现实中的 CSV 文件形态多样,可能使用制表符(Tab)或分号作为分隔符,也可能在字段中包含换行或特殊引号。csv.reader 与 csv.DictReader 均支持通过格式化参数(Dialect)自定义解析规则。
1. 修改分隔符(delimiter)
如果读取的文件是 TSV(Tab-separated values)或者由分号 ; 分隔的数据,可以在初始化时传入 delimiter:
import csv

# 读取制表符分隔的 TSV 文件
with open('data.tsv', mode='r', encoding='utf-8', newline='') as f:
    tsv_reader = csv.reader(f, delimiter='\t')
    for row in tsv_reader:
        print(row)
2. 忽略分隔符后的多余空格(skipinitialspace)
部分数据源在分隔符后会多出一个空格(例如 id, name, department),如果不加处理,解析出来的字段可能带有前导空格(如 " name")。启用 skipinitialspace=True 可以自动去除紧跟在分隔符后的空白字符:
import csv

with open('spaced_data.csv', mode='r', encoding='utf-8', newline='') as f:
    # 自动丢弃分隔符后的前导空格
    reader = csv.reader(f, skipinitialspace=True)
    for row in reader:
        print(row)
3. 自定义引号字符(quotechar)
当字段内部含有逗号或特殊符号时,CSV 规范通常使用双引号 " 包裹该字段。如果你的文件使用了其他特殊引号(例如单引号 '),可以通过 quotechar 指定:
import csv

with open('single_quoted.csv', mode='r', encoding='utf-8', newline='') as f:
    reader = csv.reader(f, quotechar="'")
    for row in reader:
        print(row)
五、常见问题排查与工程实践指南
在日常使用 csv 模块时,开发者常常会遇到中文乱码、多余空行、类型计算错误等典型故障。以下是定位与解决这些问题的具体排查清单。
| 常见问题表现 | 根本原因 | 标准解决方案 |
|---|---|---|
读取结果每隔一行就出现一个空列表 [] |
在 Windows 环境下 open() 未配置 newline='',导致回车换行符 \r\n 被系统解释与 csv 内部解析重叠。 |
在 open() 中必须显式传递参数 newline=''。 |
中文字符乱码,报 UnicodeDecodeError |
文件实际编码为 GBK / GB2312(常见于中文版 Excel 导出的 CSV),而代码指定了 encoding='utf-8'。 |
将 encoding 参数调整为 'gbk' 或 'gb18030'。 |
第一个字段名变成 \ufeffid |
文件为 Windows 平台带有 BOM(Byte Order Mark)签名的 UTF-8 格式。 | 在 open() 中将编码指定为 encoding='utf-8-sig',系统会自动剔除开头的 BOM 标记。 |
进行加减乘除时报错 TypeError |
csv.reader 和 csv.DictReader 提取的所有字段默认全部是字符串类型 str。 |
在参与数学运算或存入数据库前,手动调用 int(val) 或 float(val) 进行转型。 |
DictReader 某行数据部分列为 None |
该数据行实际包含的逗号数量少于表头字段数,导致末尾字段缺失。 | 可通过 restval='' 参数指定缺省默认值,或在处理逻辑中增加 if val is not None 校验。 |
六、总结
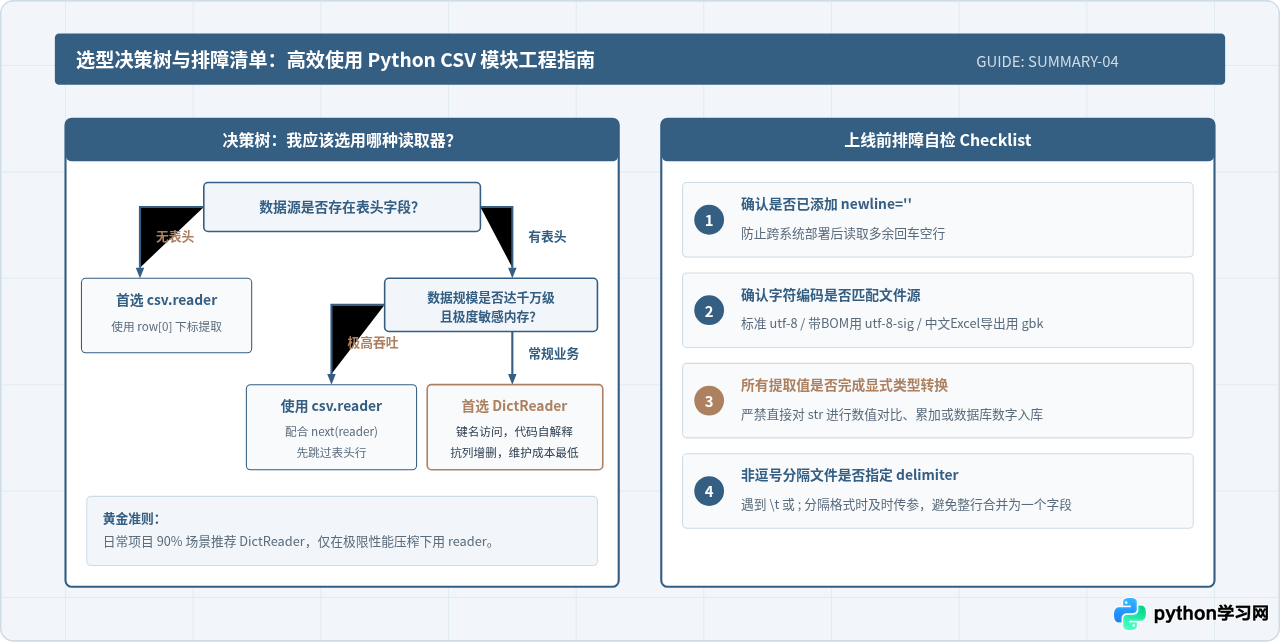
Python 标准库的 csv 模块无需第三方依赖即可高效支撑绝大多数表格文本的数据导入工作。在工程开发中,推荐的标准做法总结如下:
- 常规业务首选
csv.DictReader:通过列名进行键值映射访问,大幅提升代码的可读性与健壮性,即便是数据源调整了列次序,系统依然能正常解算。 - 大体量或无表头数据使用
csv.reader:基于列表索引逐行读取,具有更高的解析速度和极低的内存消耗,若数据有表头行,搭配next(reader)即可轻松过滤。 - 规范使用
open(..., newline='', encoding=...):这是杜绝跨平台空行异常与中文乱码的核心防御动作。同时牢记,解析出的所有字段均默认为字符串,计算前必须显式进行类型转换。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









