

Python爬虫常用库有哪些?Requests、BeautifulSoup与Selenium功能区别
深入梳理Python爬虫核心库生态,详细解析Requests、BeautifulSoup与Selenium的功能定位、运行机制、性能差异以及在实际抓取任务中的组合协作与选型依据。
编写 Python 爬虫的核心目标,是从目标网络服务中获取数据并提取出结构化信息。实际开发中并非由某一个库包揽全部任务,而是依据“网络请求、文档解析、动态渲染、任务调度”等环节分工协作。其中,Requests、BeautifulSoup 与 Selenium 是使用频率最高且经常被初学者混淆的三款工具。本文将系统梳理 Python 爬虫的常用库生态,并深入剖析这三个核心库的定位、运行机制、性能差异以及在实际工程中的协作与选型方式。
一、Python 爬虫常用工具库生态全景
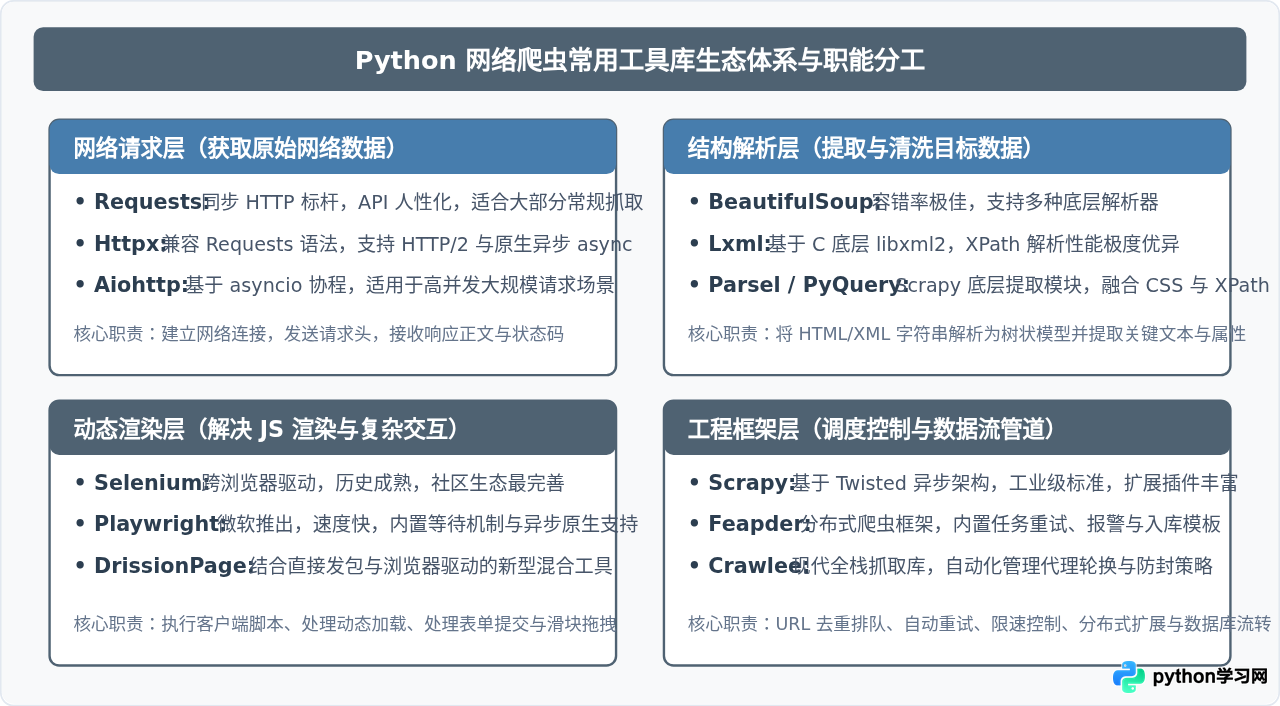
一个完整的网络爬虫通常包含“发送请求获取原始数据”、“从文本中提取目标字段”以及“面对复杂交互或渲染时的仿真执行”三个关键步骤。依据职责不同,Python 爬虫常用库主要划分为以下四大类别:
- 网络请求库:负责建立 TCP/TLS 连接并按照 HTTP/HTTPS 协议收发报文。除最经典的
requests之外,还有原生支持 HTTP/2 及异步请求的httpx,以及基于 asyncio 的高并发异步请求库aiohttp。 - 数据解析与提取库:负责对下载到本地的 HTML、XML 或 JSON 文本进行语法树构建与查询。代表工具有支持 CSS 选择器与标签导航的
beautifulsoup4、底层基于 C 语言速度极快的lxml(支持 XPath 与 XSLT),以及整合 CSS/XPath 的parsel。 - 浏览器自动化与动态渲染库:用于驱动真实浏览器引擎执行 JavaScript 代码、处理复杂的单页应用(SPA)渲染或模拟人工点击输入。代表工具包括历史悠久的
selenium、微软推出的现代化自动化库playwright,以及轻量无头驱动pyppeteer。 - 集成式爬虫框架:提供从调度队列、并发控制、下载中间件到管道存储(Pipeline)全生命周期管理的工程化框架,最具代表性的是工业级框架
scrapy和分布式框架feapder。
二、Requests、BeautifulSoup 与 Selenium 功能定位解析
在实际讨论中,许多开发者容易将 Requests、BeautifulSoup 与 Selenium 放在一起对比,但它们三者在设计目标与运行层级上有着根本性的界限:
1. Requests:专注网络传输的“快递员”
Requests 的核心定位是 HTTP 客户端。它的工作是在网络协议层面上与远程 Web 服务器进行握手与通信:构建并发送 GET、POST、PUT 等 HTTP 请求,携带请求头(User-Agent、Cookie、Referer)、查询参数与请求体,并接收服务器返回的状态码、响应头与正文字符串或字节流。
需要明确的是,Requests 完全不负责解析文档内部结构,也 完全不执行任何 JavaScript 脚本。如果目标服务器返回了一段 HTML 源码,Requests 只能将其原样保存在 response.text 中;如果网页上的内容是通过前端 Ajax 异步请求由 JavaScript 动态插入到页面上的,那么 Requests 抓取到的初始 HTML 源码中绝不会包含这部分动态生成的数据。
2. BeautifulSoup:专注文档解析的“翻译官”
BeautifulSoup 的定位是 HTML/XML 语法分析与数据抽取工具。它接收一段字符串格式的 HTML 或 XML 源码,通过底层的解析引擎(如 Python 自带的 html.parser 或第三方的 lxml)将其转换为具有层级关系的 Python 对象树(DOM 树)。
BeautifulSoup 的最大优势在于容错性强、API 友好,开发者可以使用简单的标签名导航(如 soup.title)、属性过滤(如 soup.find('div', class_='content'))或 CSS 选择器(如 soup.select('ul.nav > li a'))迅速定位并提取所需内容。但是,BeautifulSoup 本身完全没有发送网络请求的能力,也无法执行网页中的脚本代码。它处理的所有数据,都必须预先由网络请求库或本地文件读入。
3. Selenium:驱动真实浏览器的“仿真机器人”
Selenium 原本是用于 Web 应用程序端到端(E2E)自动化测试的框架。其工作原理是通过特定的浏览器驱动程序(如 ChromeDriver、GeckoDriver)直接启动并控制一个真实的浏览器实例(如 Google Chrome 或 Firefox)。
正因为控制的是完整浏览器,Selenium 拥有完整的渲染引擎和 V8 JavaScript 执行引擎。它能够加载外部 CSS、执行所有前端异步脚本、响应用户事件、计算最终页面布局,并展示真实呈现给用户的最终 DOM 树。在爬虫场景下,Selenium 能够解决“所见即所得”的抓取难题,但随之而来的是高昂的系统资源开销与较低的抓取吞吐率。
三、核心维度差异对照
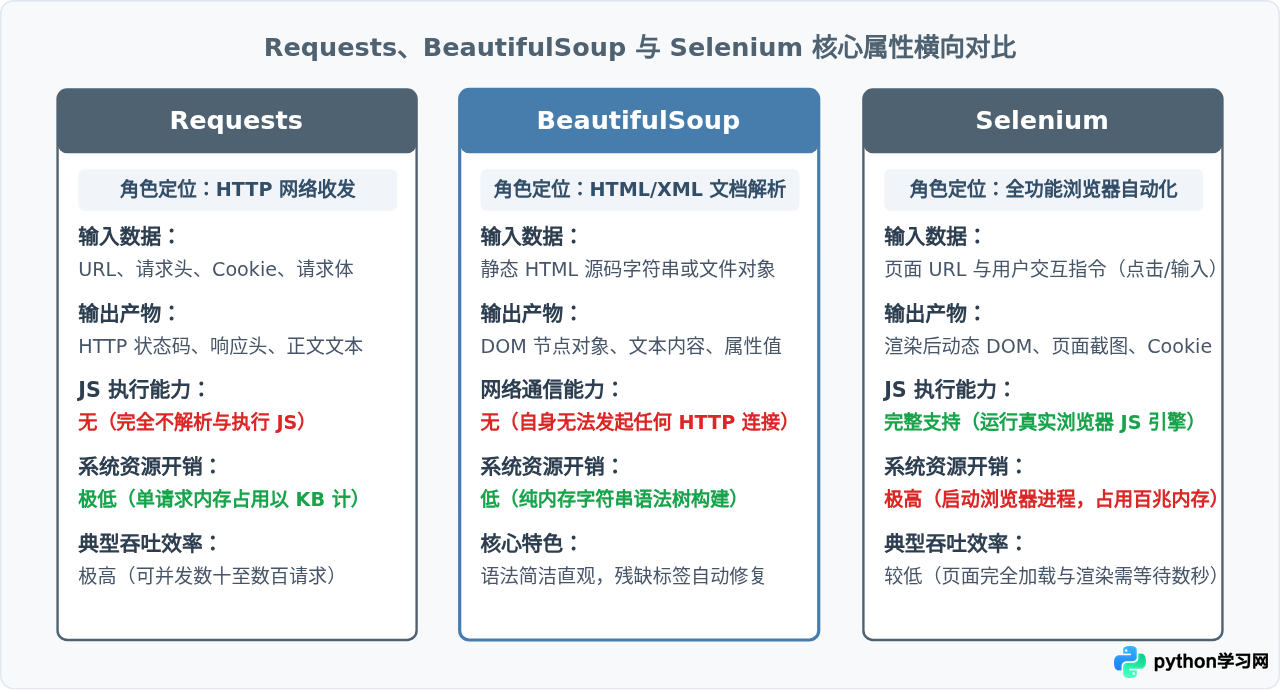
为了在项目设计初期准确选型,开发者需要从工作原理、环境依赖、抓取效率及反爬应对等关键维度对三者进行深入比较:
| 对比维度 | Requests | BeautifulSoup | Selenium |
|---|---|---|---|
| 工作本质 | HTTP 协议网络客户端 | HTML/XML 文本解析器 | 浏览器自动化测试驱动 |
| 数据来源 | 直接通过网络连接获取远程响应 | 由外部传入 HTML 字符串 | 由底层浏览器加载并渲染网页 |
| 前端 JS 渲染 | 不支持,只能拿到初始静态 HTML | 不支持,仅解析现有节点文本 | 完全支持,等待 JS 执行并构建最终 DOM |
| 用户行为交互 | 不支持(只能通过发包模拟) | 不支持 | 支持鼠标点击、键盘输入、滚动、拖拽等 |
| 环境依赖 | 纯 Python 库(pip install requests) |
纯 Python 库(可选配合 lxml) | 需安装浏览器内核及对应版本的 Driver 驱动 |
| 运行吞吐与耗时 | 单次请求通常仅几十到几百毫秒 | 解析中小型网页仅数毫秒至数十毫秒 | 启动与完整渲染单页面通常需 2 至 6 秒以上 |
| 内存与 CPU 占用 | 极低,支持高并发异步或多线程 | 低,受限于文档树尺寸 | 极高,并发开辟多窗口极易耗尽系统内存 |
| 典型应用场景 | 服务端渲染网页、公开 RESTful API 抓取 | 复杂 HTML 节点的过滤、提取与清洗 | 重度依赖 JS 渲染的 SPA、滑块及登录认证 |
四、典型场景中的分工与协同实践
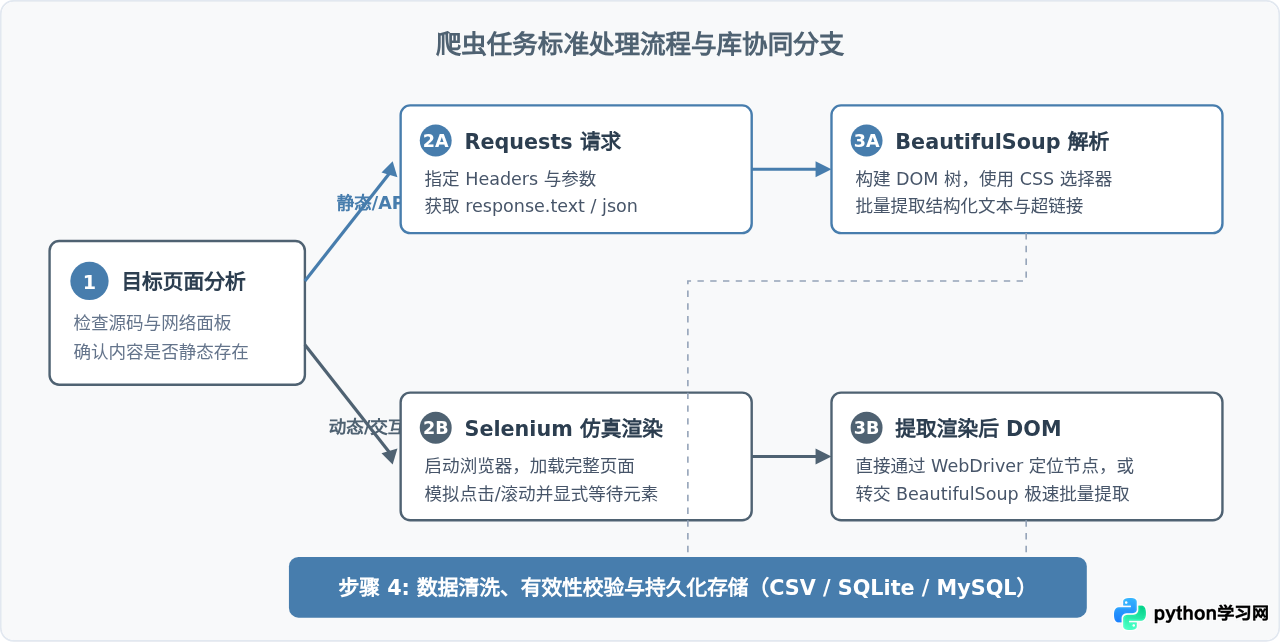
在实际爬虫任务中,这三个库并非互相排斥的单选项,而是常常组合使用。最经典的模式包括“Requests 负责下载 + BeautifulSoup 负责解析”的轻量组合,以及面对动态页面时“Selenium 获取渲染后源码 + BeautifulSoup 加速节点过滤”的高效配合。
示例 1:Requests + BeautifulSoup 经典配合
对于服务端渲染(SSR)或静态发布的页面,这是资源消耗最低、响应最快的方式。以下示例展示了从目标页面获取数据并解析标题与链接的完整代码:
import requests
from bs4 import BeautifulSoup

url = "https://example.com/news"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}

# 1. 使用 Requests 获取原始网页内容
try:
    response = requests.get(url, headers=headers, timeout=10)
    response.raise_for_status()
    # 显式指定编码,防止中文乱码
    response.encoding = response.apparent_encoding
except requests.exceptions.RequestException as e:
    print(f"请求失败: {e}")
    response = None

# 2. 将网页字符串传入 BeautifulSoup 进行树形解析
if response:
    soup = BeautifulSoup(response.text, "html.parser")
    # 使用 CSS 选择器精准定位包含标题的超链接
    articles = soup.select("article.post-item")

    for item in articles:
        title_tag = item.select_one("h2.post-title > a")
        date_tag = item.select_one("span.post-date")

        if title_tag:
            title = title_tag.get_text(strip=True)
            link = title_tag.get("href")
            date = date_tag.get_text(strip=True) if date_tag else "未知日期"
            print(f"[{date}] {title} -> {link}")
示例 2:Selenium 动态渲染与 BeautifulSoup 二次加速配合
当目标页面的主要列表是由前端 Ajax 请求并动态渲染时,Requests 直接抓取的 HTML 通常只包含空标签 <div id="app"></div>。此时可通过 Selenium 启动无头浏览器,配合显式等待(Explicit Wait)确保数据完全呈现后,再将 driver.page_source 移交给 BeautifulSoup 解析。这种方式既解决了动态渲染问题,又避免了频繁调用 WebDriver 查找元素带来的低效网络通信开销:
from selenium import webdriver
from selenium.webdriver.chrome.options import Options
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC
from bs4 import BeautifulSoup

chrome_options = Options()
chrome_options.add_argument("--headless")  # 启用无头模式,不弹出界面
chrome_options.add_argument("--disable-gpu")
chrome_options.add_argument("--no-sandbox")
chrome_options.add_argument("user-agent=Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36")

driver = webdriver.Chrome(options=chrome_options)

try:
    driver.get("https://example.com/dynamic-goods")

    # 显式等待:等待商品卡片节点在 DOM 中成功加载(最多等待 10 秒)
    wait = WebDriverWait(driver, 10)
    wait.until(EC.presence_of_element_located((By.CLASS_NAME, "goods-card")))

    # 获取渲染完成后的完整 HTML 源码
    rendered_html = driver.page_source

    # 将渲染后的 HTML 交由 BeautifulSoup 进行高效内存提取
    soup = BeautifulSoup(rendered_html, "html.parser")
    goods_items = soup.select("div.goods-card")
    for item in goods_items:
        name_tag = item.select_one(".goods-title")
        price_tag = item.select_one(".goods-price")
        if name_tag and price_tag:
            print(f"商品: {name_tag.text.strip()} | 价格: {price_tag.text.strip()}")
finally:
    # 确保进程退出并释放内存
    driver.quit()
五、常见问题与工程避坑指南
避坑核心建议:面对动态页面时,不要立即无脑切换为 Selenium。现代前端应用(Vue/React)在绝大多数情况下都需要向后端 API 发送请求获取 JSON。在浏览器开发者工具(F12)的 Network 面板中过滤 Fetch/XHR,往往能直接发现纯净的 JSON 接口。直接用 Requests 请求接口,效率通常是 Selenium 的数十倍至上百倍。
在开发爬虫时,以下几个高频细节问题直接影响爬虫的可用性与稳定性:
- 文本编码导致的中文乱码:使用 Requests 时,如果直接读取
response.text,Requests 会尝试通过 HTTP 响应头部的 Content-Type 推测编码,容易误判为 ISO-8859-1 导致乱码。应在获取内容前显式配置response.encoding = response.apparent_encoding,或者直接使用response.content.decode('utf-8')。 - BeautifulSoup 底层解析器选择:默认的
html.parser虽内置但速度偏慢;若对速度要求高且处理大型页面,推荐安装并指定lxml作为解析器(如BeautifulSoup(html, "lxml"))。若处理极其不规范、嵌套混乱的旧页面,则推荐使用容错能力更佳的html5lib。 - Selenium 进程泄漏:使用 Selenium 编写自动化脚本时,必须将
driver.quit()置于finally块中。若仅使用driver.close(),后台的 ChromeDriver 二进制进程可能不会彻底退出,长期运行极易导致服务器内存溢出崩溃。 - 无头浏览器特征暴露:现代网站的反爬体系(如 Cloudflare 或指纹检测)会自动检测
navigator.webdriver属性。默认的 Selenium 会将此标识标记为true,导致直接遭遇 403 封锁或滑块验证。在此类场景中,更建议使用经过隐身加固的undetected-chromedriver或现代化工具Playwright。
六、不同业务场景下的技术选型指南
为了在实际项目开发中做出合理决策,可以依据目标网站的静态/动态特征、是否需要交互验证以及任务数据量,按照以下选型逻辑进行判断:
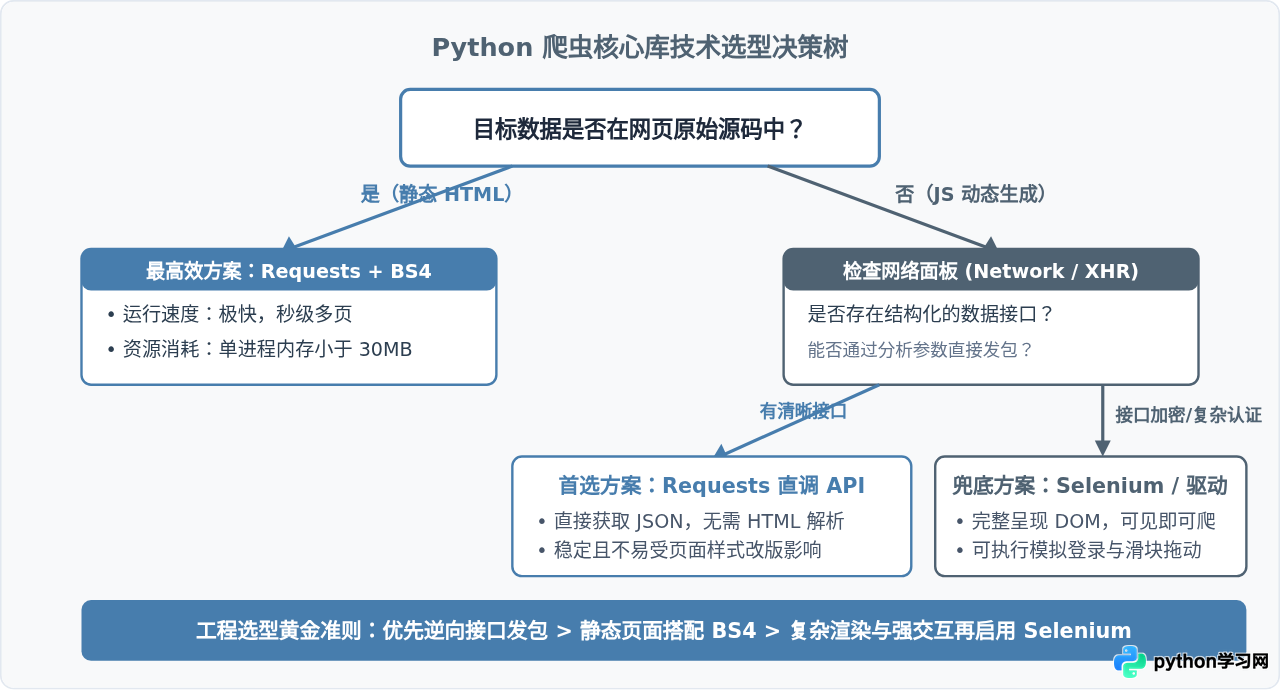
综上所述,Python 爬虫的常用库并非彼此替代,而是构成了从底层网络协议、数据解析抽取到浏览器渲染的完整工具链:
- 当面对标准的公开页面或 RESTful API 时,Requests 是最轻量、高效的网络请求利器;
- 当拿到了 HTML 文档字符串并需要快速定位、清洗与抽取特定字段时,BeautifulSoup 提供了最简单易用的树形导航与 CSS 提取语法;
- 当目标网页充斥着复杂的单页 JavaScript 异步渲染、需要模拟真实用户的点击滚动交互或规避严格的前端加密时,Selenium(或 Playwright)则是必不可少的仿真兜底方案。
在实际开发中,先通过开发者工具分析网络链路,再依据“协议优先、解析降本、驱动兜底”的原则组合搭配,才能写出既稳定高效又具备良好维护性的爬虫程序。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









