

Python用原生列表实现矩阵创建与遍历
详细讲解在不依赖第三方库的前提下,使用Python原生嵌套列表创建矩阵的标准方法、浅拷贝陷阱的底层原理,以及行优先、列优先与对角线等多种遍历方式与性能考量。
在不引入 NumPy 等第三方科学计算库的环境下,Python 原生列表(List)是表达二维矩阵最轻量、最通用的数据结构。在原生语法中,矩阵本质上是由“外层列表包含多个内层列表”构成的嵌套结构,外层列表的每个元素代表一行,内层列表的每个元素代表该行对应列的具体数值。掌握原生矩阵的独立内存初始化与标准遍历模式,是编写可靠算法代码与避免引用污染的基础。
一、矩阵的基本表示与索引逻辑
一个具有 R 行 C 列的二维矩阵,在 Python 中写作 matrix = [[...], [...], ...]。访问具体元素时,遵循标准的主下标寻址规则:第一个索引指定行号,第二个索引指定列号,即 matrix[row_index][col_index],两者均为从 0 开始的非负整数。
# 定义一个 2 行 3 列的矩阵
matrix = [
    [1, 2, 3],
    [4, 5, 6]
]

# 读取第 0 行第 2 列的元素(值为 3)
val = matrix[0][2]
print(f"matrix[0][2] = {val}")

# 获取矩阵维度
row_count = len(matrix)
col_count = len(matrix[0]) if matrix else 0
print(f"维度: {row_count} 行 × {col_count} 列")
这种通过两次连续方括号索引的方式,底层是先取出外层列表的第 row_index 个子列表引用,再从该子列表中提取第 col_index 个元素。
二、矩阵创建的核心方法与浅拷贝陷阱
许多初学者在快速构建指定大小的矩阵时,常会借用一维列表的乘法运算写出形如 [[0] * 3] * 3 的代码。这种写法虽然看似生成了 3×3 的零矩阵,但包含严重的浅拷贝引用共享陷阱。
避坑提示:一维列表乘法 [0] * 3 生成的是拥有 3 个独立整数的新列表;但外层使用乘法 [...] * 3 时,Python 并没有复制 3 个不同的子列表,而是将同一个子列表的内存引用重复复制了 3 次。这导致修改任意一行的某个位置,其余所有行的同列元素都会被连带修改。
# 错误示例:乘法浅拷贝陷阱
bad_matrix = [[0] * 3] * 3
print("修改前:", bad_matrix)

# 仅修改第 0 行第 0 列
bad_matrix[0][0] = 99
print("修改后:", bad_matrix)
# 输出: [[99, 0, 0], [99, 0, 0], [99, 0, 0]] —— 整列都被更改!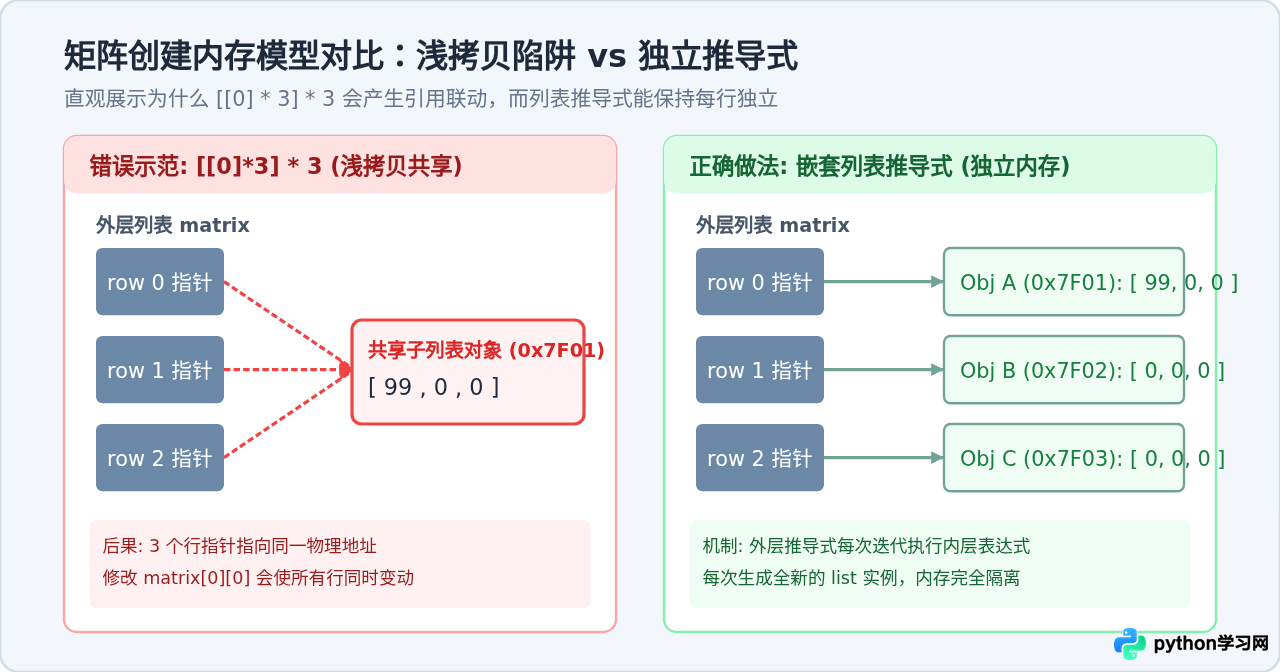
1. 标准方案:列表推导式(List Comprehension)
创建具有独立内存行的矩阵,最地道且高效的做法是使用列表推导式。外层循环负责按行数创建列表容器,内层循环在每次迭代时独立构建对应列数的子列表。
rows, cols = 3, 4
init_val = 0

# 推荐规范:嵌套列表推导式
matrix = [[init_val for _ in range(cols)] for _ in range(rows)]

# 验证内存隔离性
matrix[0][0] = 7
print("第 0 行:", matrix[0])  # [7, 0, 0, 0]
print("第 1 行:", matrix[1])  # [0, 0, 0, 0] —— 其余行不受任何影响
也可以使用简化形式 [[init_val] * cols for _ in range(rows)]。此处内层的 [init_val] * cols 复制的是不可变的数字或字符串,而外层循环 for _ in range(rows) 保证了每一行列表实例都是单独创建的。
2. 显式循环构建(常规循环追加)
当初始化逻辑较为复杂,例如需要根据动态计算值填充每个单元格时,可以使用显式的双层 for 循环配合 append() 构建:
rows, cols = 3, 3
dynamic_matrix = []

for r in range(rows):
    current_row = []
    for c in range(cols):
        # 填充行列坐标乘积
        current_row.append(r * cols + c + 1)
    dynamic_matrix.append(current_row)

print("动态构建的矩阵:")
for row in dynamic_matrix:
    print(row)
# 输出:
# [1, 2, 3]
# [4, 5, 6]
# [7, 8, 9]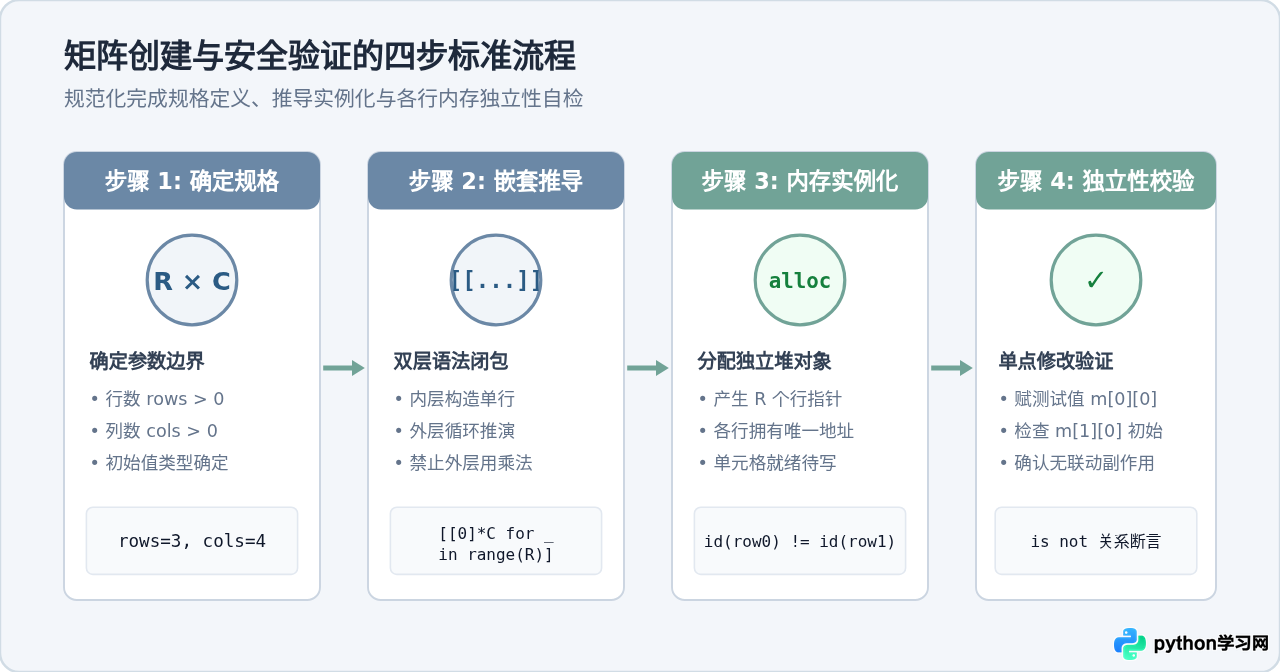
三、矩阵遍历的典型场景与实现代码
遍历是矩阵数据处理中最常见的操作。根据访问次序的不同,主要分为行优先遍历、列优先遍历、带索引遍历以及特定几何路径(如对角线)遍历。
1. 行优先遍历(Row-Major Traversal)
行优先是 Python 嵌套列表最自然、性能最好的遍历方式,因为外层列表内部本身就是按行组织的。先扫描第 0 行的所有列,再扫描第 1 行的所有列,依此类推。
grid = [
    [10, 20, 30],
    [40, 50, 60],
    [70, 80, 90]
]

# 方式 A:直接迭代元素(无需坐标索引时首选)
print("直接遍历元素:")
for row in grid:
    for val in row:
        print(val, end=" ")
    print()

# 方式 B:双重 range 索引(需要获取行号 r 与列号 c 时)
rows, cols = len(grid), len(grid[0])
print("\n按行列索引遍历:")
for r in range(rows):
    for c in range(cols):
        print(f"[{r}][{c}]={grid[r][c]}", end="  ")
    print()

# 方式 C:使用 enumerate 兼顾性能与索引
print("\nenumerate 方式:")
for r, row in enumerate(grid):
    for c, val in enumerate(row):
        # 既能拿到坐标 (r, c),又省去重复方括号寻址开销
        pass
2. 列优先遍历(Column-Major Traversal)
列优先指外层循环枚举列号 c,内层循环枚举行号 r,实现自上而下逐列纵向扫描。常用于统计每一列的总和、极值或进行特征提取。
rows, cols = len(grid), len(grid[0])

print("列优先扫描输出:")
for c in range(cols):
    col_values = []
    for r in range(rows):
        col_values.append(grid[r][c])
    print(f"第 {c} 列元素: {col_values}")

# 技巧:使用 zip(*matrix) 原生解包转置实现列遍历
print("\n利用 zip(*) 进行列迭代:")
for c_idx, col_tuple in enumerate(zip(*grid)):
    print(f"列 {c_idx}: {col_tuple}")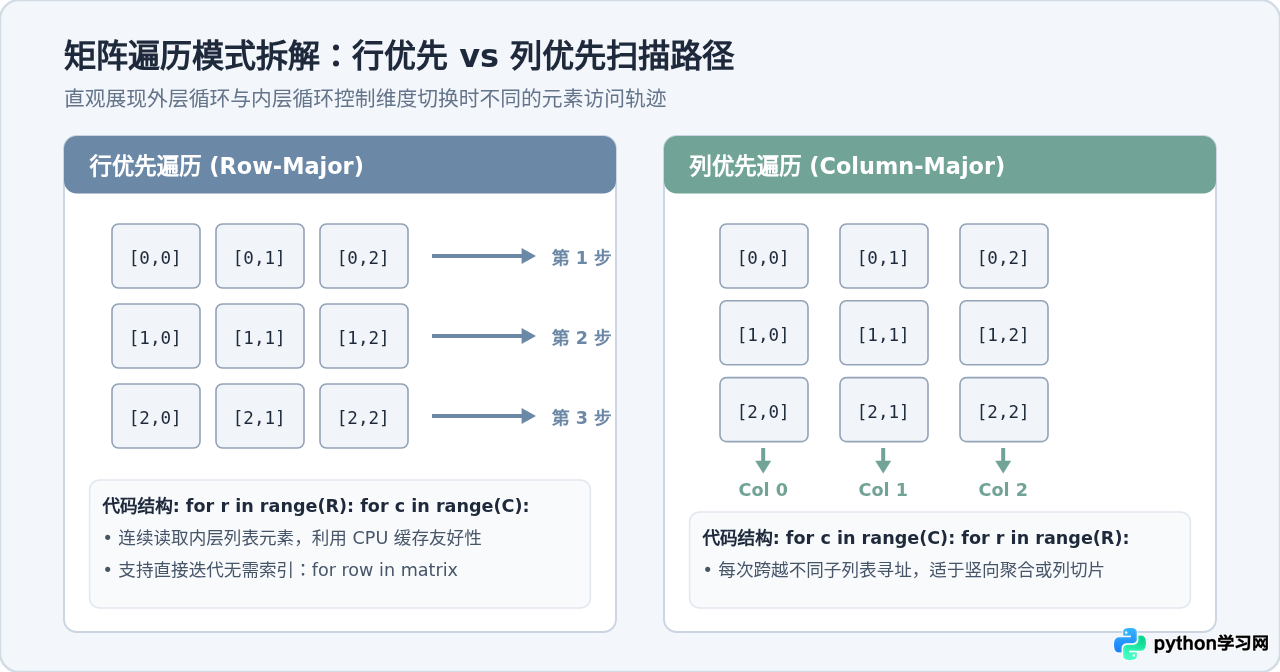
3. 对角线遍历(主对角线与副对角线)
在方阵(rows == cols)运算中,主对角线与副对角线的遍历非常频繁,具有固定的索引数学关系:
- 主对角线(Main Diagonal):行坐标与列坐标相等,即
r == c。单层循环即可在 $O(N)$ 时间内完成。 - 副对角线(Anti-Diagonal):满足
r + c == N - 1,即列索引为N - 1 - r。
square = [
    [1, 2, 3],
    [4, 5, 6],
    [7, 8, 9]
]
n = len(square)

main_diag = [square[i][i] for i in range(n)]
anti_diag = [square[i][n - 1 - i] for i in range(n)]

print(f"主对角线元素: {main_diag}")  # [1, 5, 9]
print(f"副对角线元素: {anti_diag}")  # [3, 5, 7]
四、越界防范与常见操作实践
在使用原生列表进行矩阵处理时,由于缺少 NumPy 那样的矢量化广播和严格矩阵形状约束,开发者需要特别注意以下工程细节:
1. 空矩阵与不规则行宽防范
原生列表不强制要求每个子列表长度相同(允许存在“锯齿状列表”)。在读取列宽前,应优先校验外层列表是否为空,避免抛出 IndexError:
def safe_get_shape(m):
    """安全获取矩阵行列规格"""
    if not m or not isinstance(m, list):
        return 0, 0
    if not isinstance(m[0], list):
        return len(m), 1
    return len(m), len(m[0])

# 边界安全访问辅助函数
def safe_read(matrix, r, c, default=None):
    if 0 <= r < len(matrix) and 0 <= c < len(matrix[r]):
        return matrix[r][c]
    return default
2. 原生列表矩阵的转置(Transpose)
在不修改原矩阵的前提下,生成行列互换的新矩阵,使用内置函数 zip 配合参数解包是极其优雅的做法:
origin = [
    [1, 2, 3],
    [4, 5, 6]
]

# 经典转置一行代码:zip(*)
transposed = [list(col) for col in zip(*origin)]
print("转置结果 (3行2列):", transposed)
# 输出: [[1, 4], [2, 5], [3, 6]]
五、总结与原生列表适用边界
Python 原生嵌套列表作为矩阵容器,其核心优势在于零外部依赖、对异构数据支持良好以及语法简明。但在工程实践中,也需要了解其在内存连续性和计算密集型场景下的权衡。
| 特性维度 | 原生嵌套列表 (List of Lists) | NumPy 数组 (ndarray) |
|---|---|---|
| 环境依赖 | Python 内置,零第三方依赖 | 需安装 numpy C 扩展库 |
| 内存存储 | 离散指针数组,各行各元素均为独立 Python 对象 | 底层连续 C/Fortran 内存块,紧凑高效 |
| 切片行为 | matrix[0:2] 只截取行,不支持跨列切片 [:, 1] |
支持多维视图切片与花式索引(Fancy Indexing) |
| 算术运算 | 不支持原生矩阵乘法运算(需手写嵌套循环) | 原生支持广播机制与并行优化的 @ 矩阵乘法 |
| 推荐场景 | 算法练习题、轻量级网格/棋盘、配置表、微型数据处理 | 机器学习、图像处理、大规模数值分析与工程仿真 |
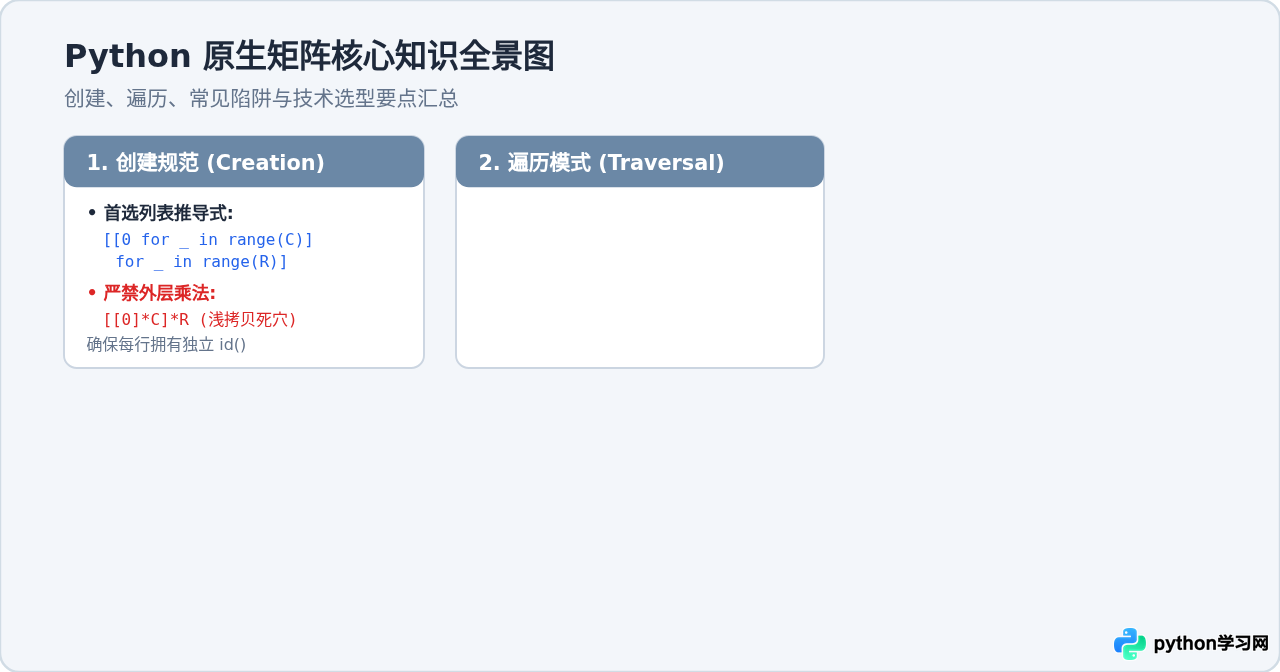
综上所述,掌握 Python 原生列表实现矩阵的核心在于:通过推导式确保每行内存独立,根据业务需求选取合适的行/列遍历模式,并在访问时保持边界严谨性。这套逻辑不仅能够满足绝大多数常规开发中的二维数据组织,也是深入理解 Python 内存管理与对象引用机制的经典范例。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









