

提升Python Web应用响应速度:缓存策略与数据库查询优化
针对Python Web应用响应延迟高的问题,本文详细讲解从性能瓶颈排查、多级缓存架构与防击穿设计,到ORM查询优化、N+1治理与覆盖索引重构的完整落地方法。
提升 Python Web 应用响应速度的核心解决路径,在于缩短数据在持久层与服务进程之间的传输耗时,并阻断重复的计算开销。在典型生产负载下,请求耗时的 70% 至 90% 消耗在数据库 I/O 阻塞上。本文围绕“引入分层缓存减轻后端负载”与“消除低效查询重构数据检索”两项关键抓手展开,通过体系化的排查流程、结构化的代码示例以及具体配置规范,帮助读者建立稳定、低延迟的应用服务架构。
一、精准定位性能瓶颈:排查与分析流程
盲目增加缓存或随意创建索引往往收效甚微,甚至引入数据不一致与额外维护成本。优化工作的起点是建立清晰的度量依据,找出消耗时间最长或并发时容易堵塞的关键路径。
常规排查通常从外向内推进:先通过网关和应用性能监控识别出 P95、P99 延迟最高的端点,再深入到进程内部利用采样工具分析 CPU 占用与 I/O 挂起时间,最后通过数据库慢查询日志与 ORM 调试面板量化 SQL 执行开销。
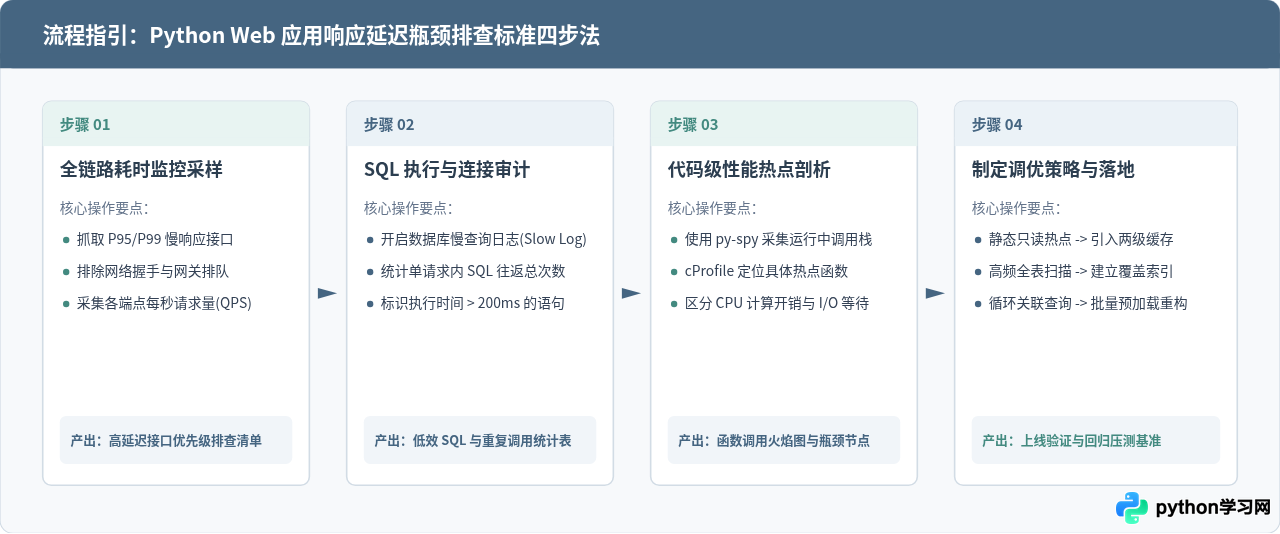
核心排查命令与配置方法
在 Linux 生产或预发环境中,推荐使用非侵入式分析工具 py-spy 捕获在线运行的 Python 进程调用栈。该工具直接读取进程内存,无需向代码注入调试代码:
# 针对指定的 Python Worker 进程生成持续 30 秒的 SVG 火焰图
py-spy record --pid 28419 --duration 30 --rate 100 --output /tmp/worker_profile.svg

# 实时查看正在执行的代码行与锁等待
py-spy top --pid 28419
对于数据库层,通过 MySQL 动态开启慢查询日志,将阈值调整为 0.2 秒以捕获大部分拖慢接口响应的查询:
-- 动态开启慢查询收集(无需重启 MySQL 服务)
SET GLOBAL slow_query_log = 'ON';
SET GLOBAL long_query_time = 0.2;
SET GLOBAL log_queries_not_using_indexes = 'ON';
二、多级缓存策略落地与并发防护
缓存的目标是用空间换时间,将对底层数据库的随机 I/O 转变为内存层面的常数级点查。但在实际工程中,单层缓存往往难以同时兼顾极低延迟与数据一致性,因此推荐采用“本地进程缓存(L1) + 分布式缓存(L2)”的多级架构。
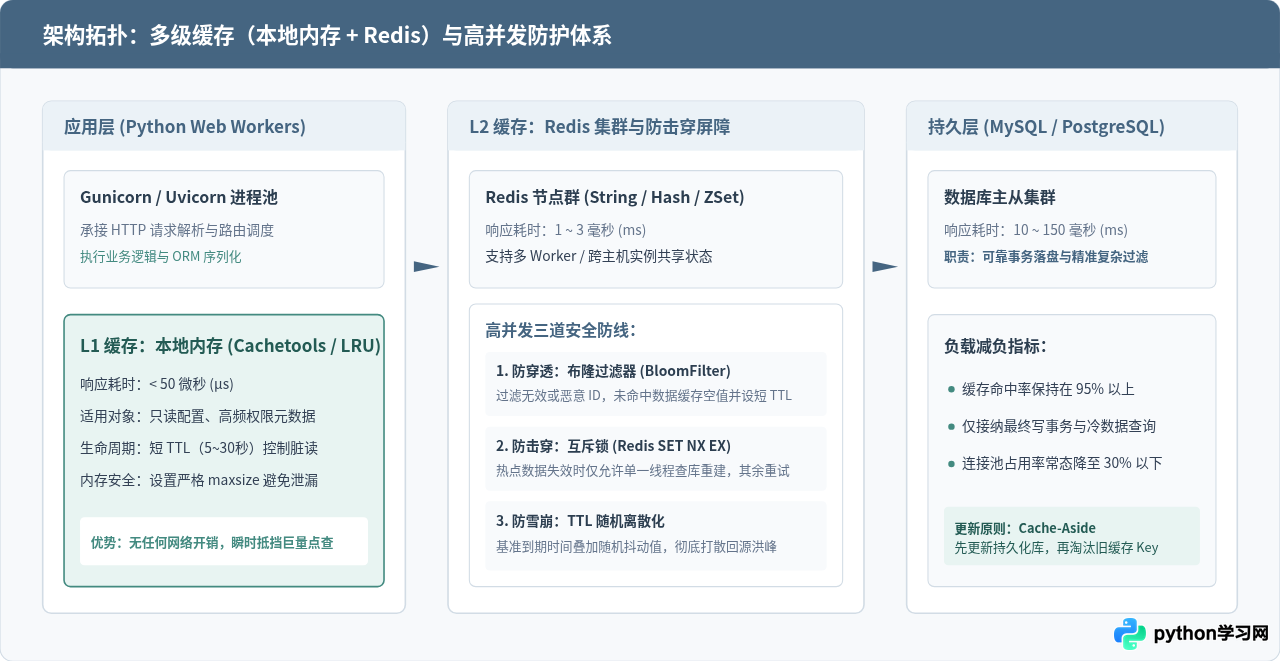
1. 本地进程缓存:消除网络往返
对于数据量小、几乎不发生变化且读取频率极高的数据(如系统枚举、权限树或租户基础配置),即使访问内网 Redis 也会产生数毫秒的网络往返开销。使用 Python 的 cachetools 模块可以在内存中维护带容量上限与过期时间的字典:
from cachetools import TTLCache, cached
import time

# 定义最大容量 2000 项、有效时长 60 秒的本地缓存
local_tenant_cache = TTLCache(maxsize=2000, ttl=60)

@cached(cache=local_tenant_cache)
def get_tenant_config(tenant_id: int) -> dict:
    # 模拟从持久层或远程配置中心获取配置
return fetch_tenant_from_database(tenant_id)Gunicorn 或 Uvicorn 默认采用预分叉(pre-fork)多进程模型运行。各个 Worker 进程拥有独立的内存空间,彼此之间无法共享本地缓存。因此,本地缓存仅适合容忍微小时间窗口内数据不一致的只读场景;一旦涉及需要多进程精准同步的状态,必须下沉到 Redis 中处理。
2. 分布式缓存实践:带互斥锁的 Cache-Aside 模式
Web 场景中最推荐的方案是旁路缓存(Cache-Aside)。读取时先查缓存,未命中再读库并写入缓存;写入时先更新数据库,随后主动删除旧缓存。为避免热点 Key 到期引发数据库被海量并发击穿,可引入基于 Redis SET NX EX 的分布式锁保障同一时刻仅有一个 Worker 执行回源:
import json
import random
import time
import redis

r = redis.Redis(host='127.0.0.1', port=6379, db=0, decode_responses=True)

def get_article_detail(article_id: int) -> dict:
    cache_key = f"article:detail:{article_id}"
    lock_key = f"lock:article:{article_id}"

    # 1. 尝试从 Redis 命中缓存
    cached_data = r.get(cache_key)
    if cached_data:
        return json.loads(cached_data)

    # 2. 缓存未命中,尝试获取互斥锁(有效时间 5 秒,防止回源异常死锁)
    acquired = r.set(lock_key, "1", nx=True, ex=5)
    if acquired:
        try:
            # 双重检查:获取锁后再次尝试读缓存
            double_check = r.get(cache_key)
            if double_check:
                return json.loads(double_check)

            # 3. 执行真正的数据库查询
            article = query_article_from_db(article_id)
            if article is None:
                # 针对不存在的记录缓存空对象,设置 30 秒短 TTL,防止缓存穿透
                r.set(cache_key, json.dumps({}), ex=30)
                return {}

            # 4. 回写缓存,基准 600 秒叠加 60 秒内的随机浮动,防止雪崩
            ttl = 600 + random.randint(10, 60)
            r.set(cache_key, json.dumps(article), ex=ttl)
            return article
        finally:
            # 释放互斥锁
            r.delete(lock_key)
    else:
        # 未抢到锁的并发请求,稍作休眠等待持有锁的线程回写完成,再重新读取
        time.sleep(0.05)
        return get_article_detail(article_id)
三、数据库查询优化实战:消除 I/O 放大
很多 Python Web 系统的性能劣化并不源于数据库承载了多少次连接,而是因为 ORM 自动生成的 SQL 存在严重的“I/O 放大”现象。常见的表现包括:遍历对象时隐式发出海量关联查询(N+1 问题)、使用 SELECT * 拉取庞大的文本字段导致内存膨胀,以及由于索引缺失触发的全表扫描。
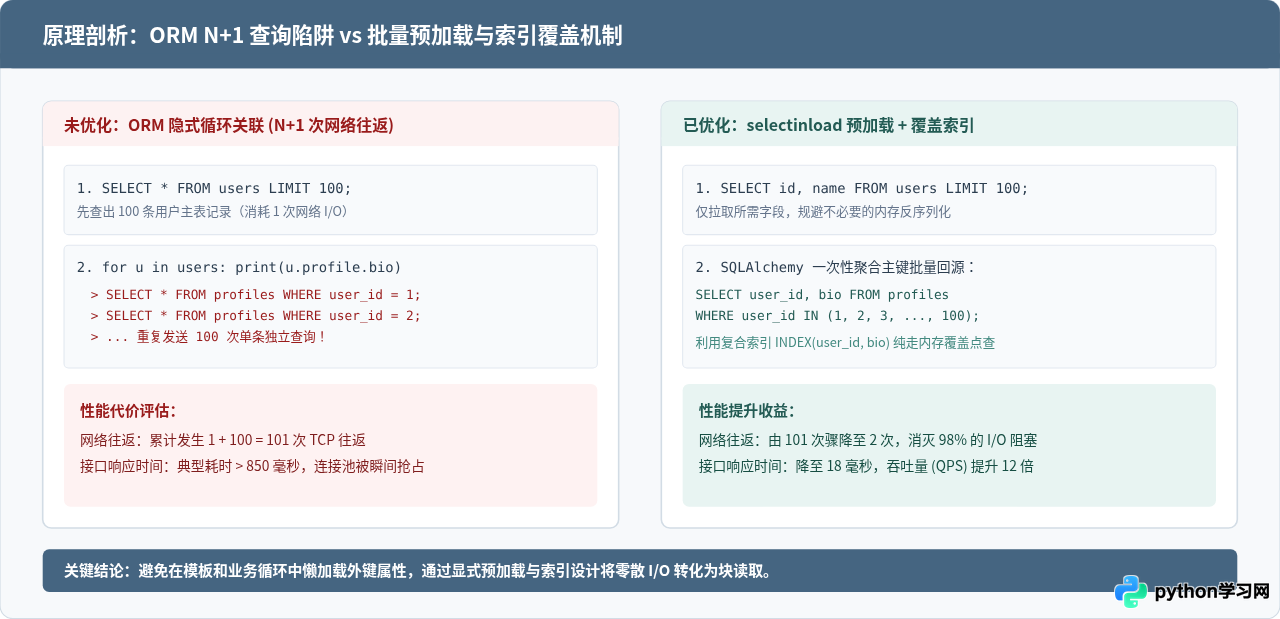
1. 彻底解决 SQLAlchemy 与 Django 中的 N+1 问题
以 Python 常见的 SQLAlchemy 2.0 为例,当查询用户列表并访问其关联的订单时,默认配置会产生 N+1 查询。通过在查询构建阶段显式指定 selectinload 或 joinedload,可将成百上千次循环 SQL 合并为极少数的批量查询:
from sqlalchemy import select
from sqlalchemy.orm import selectinload, joinedload
from models import User, Order

# 错误示例:引发 N+1 查询
# stmt = select(User).limit(50)
# users = session.scalars(stmt).all()
# for u in users:
#     print(len(u.orders))  # 每次循环均向数据库发送一次独立 SELECT!

# 正确优化:使用 selectinload 处理一对多(1 次主表 + 1 次 IN 批量子查询)
stmt = (
    select(User)
    .options(selectinload(User.orders))
    .limit(50)
)
users = session.scalars(stmt).all()

# 对于多对一或一对一单记录关联,推荐使用 joinedload(单次 JOIN 查询获取)
stmt_profile = (
    select(User)
    .options(joinedload(User.profile))
    .limit(50)
)
users_with_profile = session.scalars(stmt_profile).all()
2. 精简字段与规避 SELECT *
数据库在返回宽表数据时,需要从磁盘数据页中加载大量非必要字段,并通过网络将全部文本与二进制数据序列化传递给 Python 进程。Python 解释器构建复杂的 ORM 实体对象时同样伴随显著的 CPU 与内存分配开销:
from sqlalchemy.orm import load_only

# 仅加载页面展示所需的字段,大幅降低网络开销与反序列化时间
stmt = (
    select(User)
    .options(load_only(User.id, User.username, User.email))
    .where(User.is_active == True)
)
active_users = session.scalars(stmt).all()
3. 覆盖索引与 EXPLAIN 审计
为数据表建立索引时,需避免单列索引堆叠,而应根据高频查询场景设计复合索引。利用 B+ 树的覆盖索引特性(Covering Index),可以让查询直接在索引结构中取齐所需字段,免除回表(Look-up)读取聚簇索引数据页的物理 I/O:
-- 场景:高频筛选指定组织下已激活用户,并按创建时间倒序获取 ID 与用户名
-- 创建覆盖复合索引(严格遵循最左前缀法则)
CREATE INDEX idx_org_status_created ON sys_users (org_id, is_active, created_at, id, username);

-- 使用 EXPLAIN 验证执行计划
EXPLAIN SELECT id, username FROM sys_users
WHERE org_id = 108 AND is_active = 1
ORDER BY created_at DESC LIMIT 20;
在 EXPLAIN 分析输出中,务必重点关注以下两列指标:
type:必须达到ref、range或const级别;若显示为ALL,说明触发了全表扫描,必须立即介入优化。Extra:若包含Using index,代表查询完全由索引覆盖完成,性能最优;若出现Using filesort或Using temporary,通常意味着排序未能复用索引有序性,需要调整复合索引字段顺序。
四、连接池调优、批量操作与深分页治理
除单次 SQL 调优外,数据库连接的管理模式与批量数据的写入吞吐量同样决定了 Web 服务的并发上限。
1. SQLAlchemy QueuePool 连接池参数调优
若每次 HTTP 请求都与数据库重新建立 TCP 连接并完成认证握手,单次请求会增加 20 至 50 毫秒的基础延迟。生产环境必须复用连接池,并根据 Worker 进程数精细配置:
from sqlalchemy import create_engine

engine = create_engine(
    "mysql+pymysql://user:password@db-host:3306/production_db",
    pool_size=15,             # 每个进程保持的稳态持久连接数
    max_overflow=10,          # 突发并发时允许动态额外创建的连接上限
    pool_timeout=30,          # 排队等待空闲连接的超时时间(秒)
    pool_recycle=1800,        # 30 分钟主动回收旧连接,避免 MySQL 8小时空闲断开
    pool_pre_ping=True        # 每次取出连接前发送心跳检查,彻底杜绝失效脏连接
)
2. 深分页性能陷阱与游标分页优化
使用类似 LIMIT 100000, 20 的偏移量分页时,数据库引擎必须完整读取并丢弃前 100,000 条记录,随后仅保留最后 20 条,导致查询耗时随页码增加而呈线性暴增。推荐重构为基于主键或时间戳的连续游标分页:
-- 低效做法:深分页导致扫描 100020 条完整数据行
SELECT * FROM articles ORDER BY id ASC LIMIT 100000, 20;

-- 优化做法 1:基于上一页末尾 ID 的游标分页(时间复杂度稳定在 O(log N))
SELECT id, title, published_at FROM articles
WHERE id > 100000
ORDER BY id ASC LIMIT 20;

-- 优化做法 2:延迟关联(通过覆盖索引快速定位 ID 子查询,再回表获取详情)
SELECT a.id, a.title, a.content FROM articles a
JOIN (
    SELECT id FROM articles ORDER BY id ASC LIMIT 100000, 20
) AS sub USING (id);
五、响应速度调优知识全景与落地闭环
在生产环境中提升系统性能,需要建立一套端到端的闭环体系:从指标度量出发,通过两级缓存阻断海量读请求,利用批量预加载与覆盖索引削减持久层压力,最后依托连接池复用与压测手段实现可观测的质量交付。
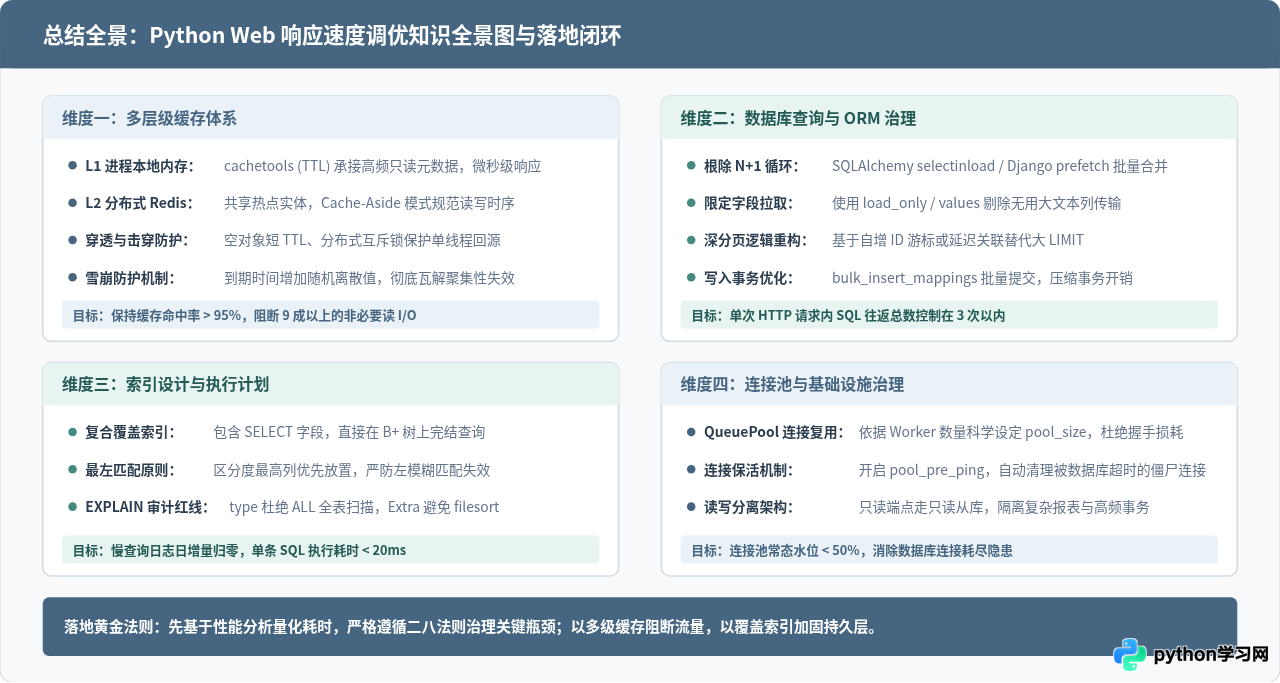
性能优化落地验证清单
| 调优模块 | 核查项目 | 验收合格标准 | 风险防范要点 |
|---|---|---|---|
| 缓存策略 | 本地 LRU 与 Redis 多级缓存覆盖 | 缓存命中率稳定在 95% 以上,单点接口响应 < 10ms | 键名必须添加版本或命名空间,写操作后必须精准驱逐旧 Key |
| 并发防护 | 穿透、击穿与雪崩防护机制 | 高并发压测下,瞬时过期 Key 回源请求被互斥锁收敛为 1 条 | 互斥锁必须设置合理超时时间(ex=5s),防止 Worker 异常崩溃死锁 |
| ORM 治理 | 消除 N+1 查询与过度加载 | 单个接口 HTTP 命中的 SQL 数量恒定且不随数据集线性增加 | 避免在序列化字段属性中隐藏调用外键属性的方法 |
| 索引构建 | EXPLAIN 执行计划审计 | 慢查询日志无新增记录,type 达到 ref/range,无 filesort | 单表索引数量控制在 5 个以内,避免过度索引拖慢插入与更新吞吐 |
| 连接池管理 | QueuePool 参数与连接复用 | 高 QPS 压测下连接池排队超时次数为 0,pre_ping 心跳生效 | 连接池总数(进程数 × pool_size)严禁超过 MySQL max_connections |
通过遵循上述排查流程、落地分层缓存与重构数据库查询,开发者可以在不更换语言平台与硬件资源的前提下,显著压缩 Python Web 应用的 P95/P99 延迟,构建出兼具高并发承载力与高稳定性的生产服务系统。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









