

Python中可变与不可变数据结构详解
深入解析Python中可变与不可变数据结构的核心概念、底层内存模型、传参机制、常见陷阱与工程选型实践。
在Python中,一切皆为对象,但并非所有对象的行为方式都一致。区分数据结构是“可变”(Mutable)还是“不可变”(Immutable),是编写健壮、可预测Python代码的关键基础。所谓可变性,指的是一个对象在内存中创建完毕后,其内部所包含的值是否能够被原地修改;若能原地修改且内存地址保持不变,该对象即为可变对象,反之若任何修改都会引发新对象的创建,则为不可变对象。理解这一机制能够直接解答为什么修改列表会影响外部变量、为什么元组可以用作字典键而列表不行,以及如何规避函数默认参数中的静默Bug。
一、对象的底层构成与分类判定
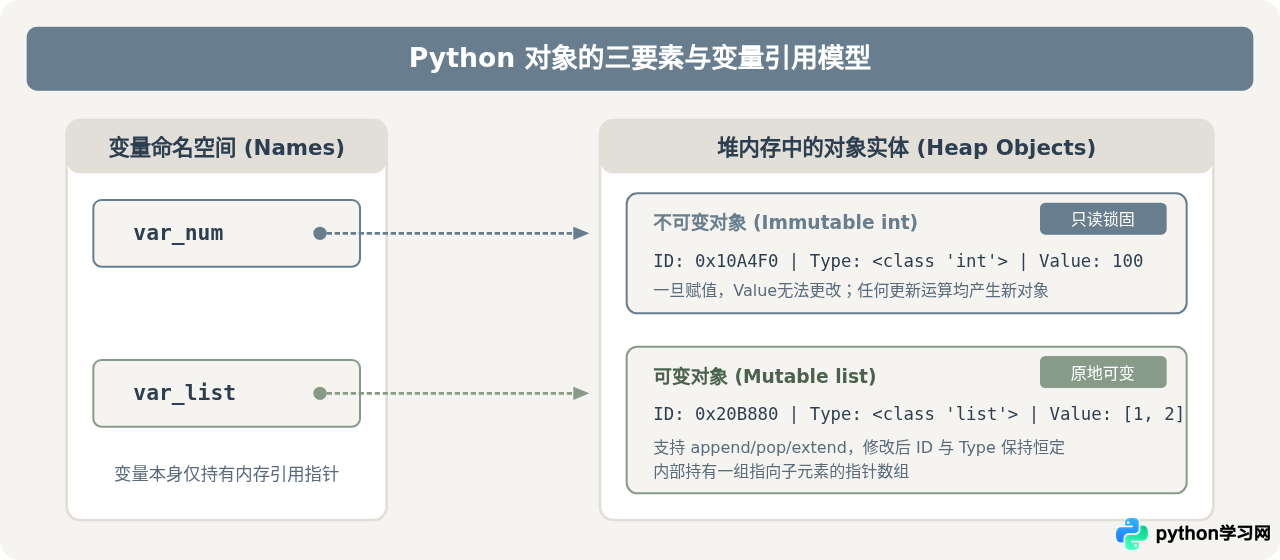
要透彻理解可变性,首先必须建立Python的对象视角。在CPython底层,任何一个Python对象被创建时,都具备三个核心要素:
- 身份标识(Identity):对应对象在内存中的地址,可通过内置函数
id(obj)获取,在C语言层面对应对象结构体指针。通过运算符is可以判断两个变量是否引用同一个内存地址。 - 数据类型(Type):决定了该对象支持的操作与方法,可通过
type(obj)获取,类型一旦创建便终身不可改变。 - 对象的值(Value):对象内部存储的具体数据内容。
不可变数据结构的核心特征是:其所占用的内存空间在分配后,对应的值就无法被原地变更。如果对一个不可变对象进行修改操作(如字符串拼接、整数递增),Python不会修改原始内存块,而是分配一块新的内存存储计算结果,并将变量名称重新绑定(Re-binding)到新对象上。常见不可变类型包括:int、float、bool、str、tuple、frozenset、bytes。
可变数据结构的核心特征是:支持原地(In-place)修改。可以在不改变对象内存地址(id保持一致)的前提下,自由地追加、删除或替换其中的元素。常见可变类型包括:list、dict、set、bytearray。
二、内存运作机制:重绑定与原地修改对比
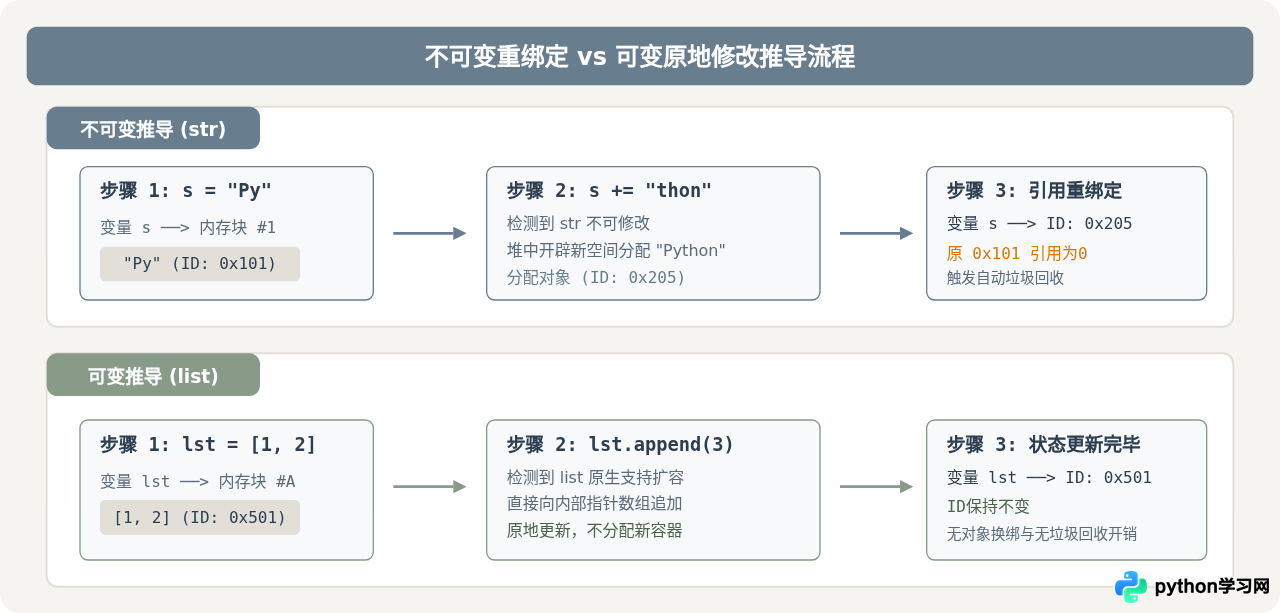
许多初学者会将“变量修改”与“对象修改”混为一谈。在Python中,变量名本身并不是存储数据的盒子,而只是贴在对象上的标签。以下通过具体代码与内存演进对比,直观展示两者的本质差异。
1. 不可变类型的“修改”:重绑定过程
观察下面的字符串拼接操作:
text = "Python"
print("修改前 id:", id(text))

text += "3"
print("修改后 id:", id(text))
示例输出:
修改前 id: 140321528659120
修改后 id: 140321528659840
在上述执行过程中,原始的字符串对象 "Python" 从始至终没有改变。执行 text += "3" 时,解释器开辟了新的内存块存储 "Python3",并将 text 标签指向这个新地址。原字符串对象如果没有其他引用,将被Python垃圾回收机制释放。
2. 可变类型的原地修改:容器内部维护
与字符串不同,对列表进行追加元素操作:
numbers = [10, 20]
print("修改前 id:", id(numbers))

numbers.append(30)
print("修改后 id:", id(numbers))
print("当前内容:", numbers)
示例输出:
修改前 id: 140321528822464
修改后 id: 140321528822464
当前内容: [10, 20, 30]
此时 numbers 的 id 完全一致。列表在底层是一个可动态扩容的指针数组,append 操作只是在当前数组末尾写入了指向整数 30 的指针,对象外壳未变,内存地址得以保持。
三、实战核心场景与典型问题深度剖析
1. 函数参数传递与默认参数陷阱
在Python中,所有函数调用都是共享传参(Call by Sharing)或称按对象引用传递(Call by Object Reference)。传入函数的形参仅仅是实参的一个别名(Alias),指向同一个内存地址。
- 如果传递的是不可变对象,在函数内部对形参重新赋值或运算,只会让形参重新绑定到新对象,外部变量不受影响。
- 如果传递的是可变对象,并在函数内部调用了其原地修改方法(如
append、extend、修改键值),外部实参的内容会同步改变。
最著名的工程问题莫过于默认参数使用可变对象:
# 错误示范:默认参数在函数定义时仅初始化一次
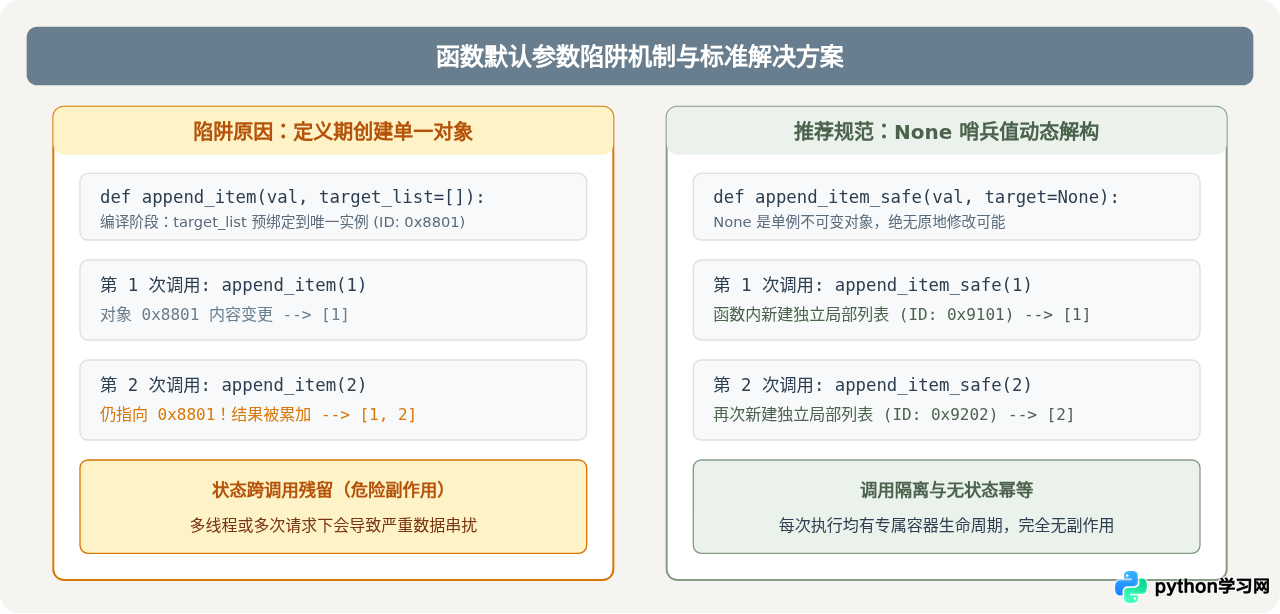
def append_item(val, target_list=[]):
    target_list.append(val)
    return target_list

print(append_item(1))  # 预期 [1]
print(append_item(2))  # 意外得到 [1, 2],而不是 [2]
这是因为 def 语句在模块加载期被解释器执行时,默认参数的 [] 就已经被实例化为一个确定的列表对象存放在函数的 __defaults__ 元组中。后续每次不传实参调用该函数,使用的都是同一个列表对象!
永远使用不可变对象 None 作为默认参数哨兵值,并在函数体内动态创建新容器:
def append_item_safe(val, target_list=None):
    if target_list is None:
        target_list = []
    target_list.append(val)
    return target_list
2. 字典键与集合元素:哈希性(Hashability)硬性约束
Python中的字典(dict)与集合(set)在底层由高效率的哈希表实现。向哈希表中插入键时,解释器必须先调用内置方法 hash(key) 计算其哈希码,并以此决定其在桶中的存储位置。
一个对象要具备可哈希性(Hashable),必须满足两个条件:
- 对象在其生命周期内必须拥有一个不变的哈希值(需要实现
__hash__()方法)。 - 对象必须能够与其他对象比较(需要实现
__eq__()方法)。
如果允许可变对象(如列表、集合、字典)充当字典的键,假设先将 k = [1, 2] 作为键存入字典,之后执行 k.append(3)。如果哈希值随之改变,字典将再也无法根据旧哈希找到对应的桶;如果哈希值不变,键的相等性比较就会被破坏。因此,Python严正规定:所有原生可变数据结构均不可哈希,不能作为字典的键或集合的元素。尝试使用列表作为键会直接抛出 TypeError: unhashable type: 'list'。
3. 不可变容器内的可变元素:元组的“非纯粹不可变”
元组(tuple)本身是不可变对象,但元组所谓的“不可变”,仅仅指的是它所包含的引用指针序列不可变更,并不保证它所引用的对象内容不可变:
bad_tuple = (1, [10, 20])
# bad_tuple[0] = 2  # 报错:TypeError: 'tuple' object does not support item assignment
bad_tuple[1].append(30)  # 完全合法!
print(bad_tuple)  # 输出: (1, [10, 20, 30])
在这个例子中,bad_tuple[1] 存放的指针始终指向原来的列表,指针值没有改变,因此元组的约束没有被打破;但是列表内部的元素却被成功追加了。也正因为如此,包含可变元素的元组同样不可哈希,调用 hash(bad_tuple) 将抛出异常。
4. 浅拷贝(Shallow Copy)与深拷贝(Deep Copy)的边界
在处理复合数据结构时,单纯的赋值 b = a 只是新增了一个标签。为了防止相互影响,我们常常需要拷贝:
- 浅拷贝(
copy.copy()或 切片lst[:]):创建一个新的外层容器对象,但内部所有嵌套子对象的引用依然指向原来的地址。 - 深拷贝(
copy.deepcopy()):递归地复制所有层级的可变容器,在内存中完全建立一整套崭新的镜像副本,彻底实现数据隔离。
四、关键差异总结与工程选型决策
在实际架构与开发工作中,如何精准选择可变或不可变结构?下表总结了两类数据结构的典型特征对照:
| 对比维度 | 不可变数据结构 (Immutable) | 可变数据结构 (Mutable) |
|---|---|---|
| 常见类型 | int, float, str, tuple, frozenset, bytes |
list, dict, set, bytearray |
| 原地修改支持 | 不支持,任何修改生成全新对象 | 支持,id 保持不变 |
| 是否可哈希 | 纯粹不可变对象可哈希(可作 dict 键) |
原生均不可哈希(禁止作 dict 键) |
| 线程安全性 | 天然只读,并发访问安全,无竞态写入 | 并发写入需锁机制(如 threading.Lock)保护 |
| 内存与性能开销 | 尺寸紧凑;频繁细微变更会带来临时对象创建与GC压力 | 预分配额外容量(Over-allocation);原地修改开销低 |
| 典型适用场景 | 配置项、数据记录(Record)、哈希键、常量定义 | 缓冲区、动态收集结果集、频繁更新的查找索引 |
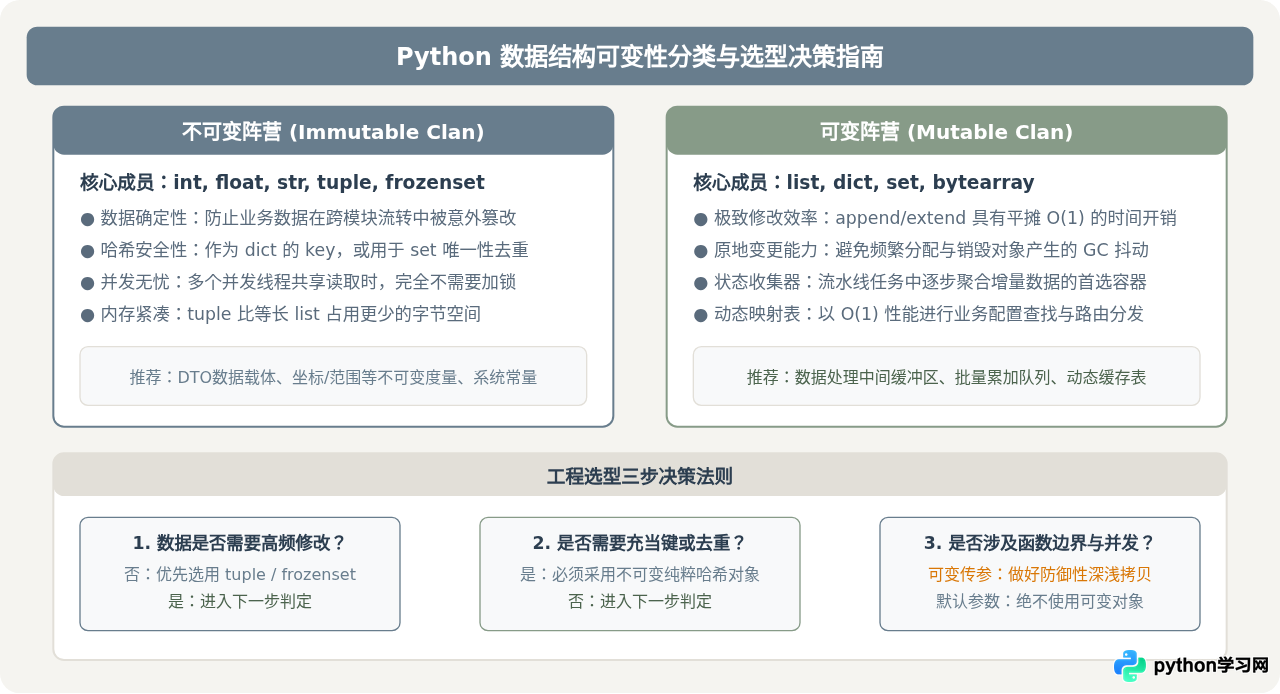
掌握可变与不可变数据结构的运行规律,能使开发者在面对参数传递、数据复用、多线程共享及缓存设计等复杂场景时,写出更加稳定、清晰且高性能的Python程序。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









