

Python三引号真的是注释吗?解析多行字符串与Docstring机制
深入解析Python中三引号字符串的真实语法地位,剖析井号注释、Docstring与普通多行字符串在词法解析、AST构建、字节码生成和运行时内存中的底层差异。
明确的结论是:Python中的三引号根本不是注释,而是合法的多行字符串字面量(String Literals)。许多人在编写Python代码时习惯用成对的 ''' 或 """ 包裹大段说明文字或调试时临时废弃的代码,并将其口头称为“多行注释”。在绝大多数情况下程序看似能够正常运行,但从Python解释器、语法解析器、字节码编译器以及运行期内存机制的角度来看,三引号与真正的注释存在本质差异。将三引号视作注释不仅是不准确的,在特定场景下还会引发不易察觉的性能开销、内存驻留以及隐蔽的语法报错。
一、直观场景:为什么大家都误以为它是多行注释?
假设你正在排查一个生产环境的数据处理函数,需要临时停用一段包含复杂计算的逻辑,或者需要在函数上方写几行业务说明:
# 场景A:很多初学者习惯这样“注释”代码
def calculate_metrics(data_stream):
    """
    临时注释掉旧版本计算逻辑:
    raw_score = sum(data_stream) / len(data_stream)
    adjusted_score = raw_score * 1.15
    """
    # 实际执行的新逻辑
return [item.weight * 1.05 for item in data_stream]在上面的代码中,包裹在三引号内的代码块不会被执行,程序也没有抛出异常。这种“文字被忽略”的表面现象,正是造成“三引号等同于多行注释”错觉的根本原因。但实际上,Python解释器并没有跳过这几行文字,而是忠实地将其解析为一段字符串常量表达式。如果这个字符串恰好位于模块、函数或类的首部,它会被Python特有的机制捕获并转化为文档字符串(Docstring);如果它位于函数内部的其他位置,它则是一个没有赋值给任何变量的独立表达式语句(Expression Statement)。
二、底层流水线差异:井号(#)与三引号在解释器中的全生命周期
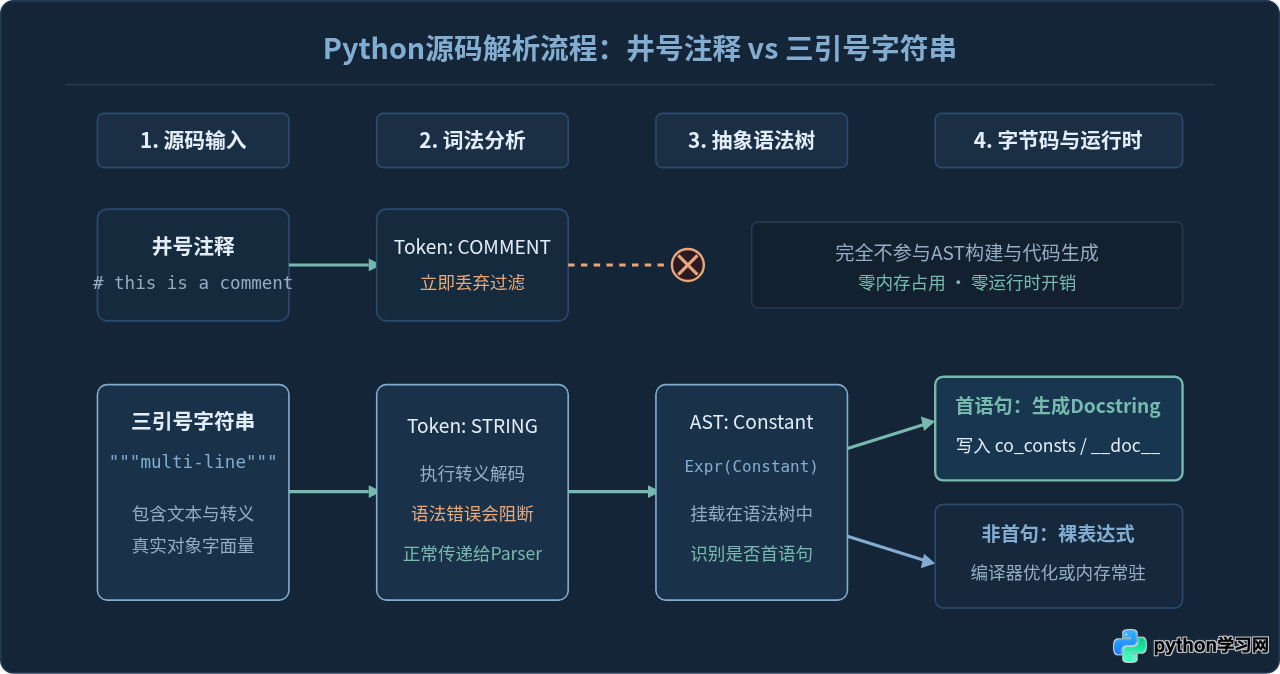
要真正搞清二者的区别,必须回到Python代码从源码文本到字节码执行的编译流程。Python处理源代码主要经历四个阶段:词法分析(Tokenizing)、语法树构建(AST Parsing)、字节码生成(Bytecode Compilation)以及虚拟机执行(Runtime Execution)。
真正的Python注释只有一种语法形式,那就是以 # 开头的单行注释。在词法分析阶段,词法分析器(Tokenizer)一旦扫描到 #,就会将该行后续的字符标记为 COMMENT 标记,并在向语法分析器传递标记流之前直接物理剔除。这意味着注释内容根本不会进入抽象语法树(AST),更不可能进入最终编译出的 .pyc 字节码文件,在运行时内存中没有任何痕迹。
相反,三引号字符串在词法分析阶段会被识别为 STRING 标记。语法分析器会将其构建为具体的语法节点(在AST中为 Expr(value=Constant(value='...')))。它是语法树的一部分,必须经过严格的语法与转义校验,并最终交由代码生成器根据位置决定其宿命。
三、深入解析Docstring机制:它是如何被运行时捕获的?
既然三引号是字符串字面量,那为什么写在函数开头的说明文字会被 help() 函数识别并打印出来呢?这就是Python语法规范中明确规定的 文档字符串(Docstring)绑定机制。
根据 Python 官方规范(PEP 257),当一个字符串字面量作为模块(Module)、类(Class)或函数(Function)定义体的第一条可执行语句出现时,编译器会在构造代码对象(Code Object)阶段识别该节点。编译器不仅会将其压入代码对象的常量表(co_consts)中,还会自动将其赋值给该对象的 __doc__ 特殊属性。
# 演示Docstring的自动绑定
def calculate_tax(income: float) -> float:
    """计算个人所得税应缴额。

    参数:
        income: 税前月收入金额(元)
    返回:
        float: 应缴税额
    """
    return income * 0.1

# 在运行时直接访问 __doc__ 属性
print(calculate_tax.__doc__)
print("常量表内容:", calculate_tax.__code__.co_consts)
运行上述代码后,你会发现 calculate_tax.__doc__ 完整输出了三引号内部的内容。而在 calculate_tax.__code__.co_consts 这个常量元组中,第一个元素就是这段字符串。交互式环境下的 help(calculate_tax) 或IDE代码提示,正是通过读取 __doc__ 属性来提供文档支持的。
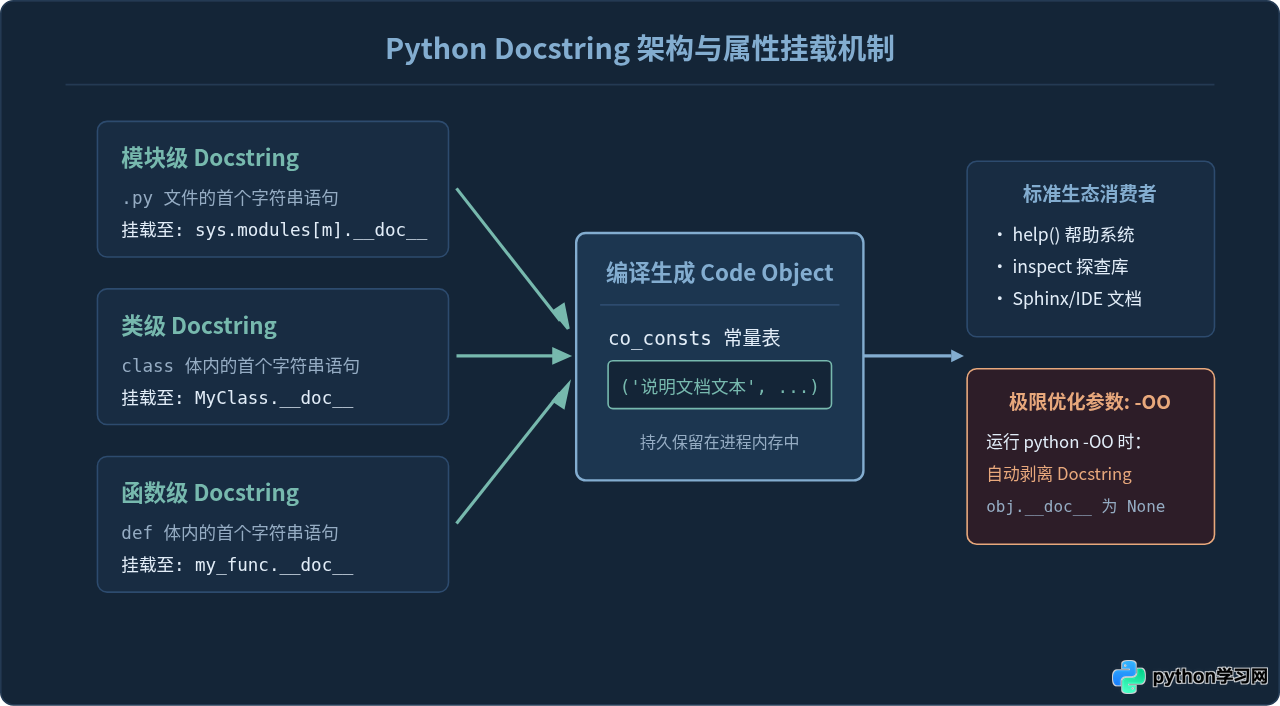
如果在启动Python程序时带上了 -OO 参数(例如 python -OO main.py),Python解释器在编译代码时会进入极限优化模式,不仅会移除 assert 断言,还会主动从字节码常量表中彻底剔除所有的 Docstring。此时访问任何函数或类的 __doc__ 属性都会返回 None。如果你的代码在逻辑中依赖 func.__doc__ 传递关键元数据(例如作为API描述或路由名称),使用 -OO 会直接导致程序崩溃。
四、为什么不能把三引号字符串当作“多行注释”滥用?
如果说函数开头的多行字符串是官方支持的 Docstring,那么在函数体中间、循环内部或者模块末尾随便写几行三引号字符串当作多行注释,究竟会带来什么问题?以下是四个必须了解的技术风险:
1. 转义字符与语法错误(SyntaxError)
真正的注释无论写什么内容(即使是乱码或未闭合的括号),解释器都会直接跳过。但三引号字符串是合法的表达式,其内部必须遵循Python字符串字面量的语法规则。例如 Windows 文件路径中的反斜杠:
# 错误示例:使用三引号注释包含未转义反斜杠的文字
def process_file():
    """
    备忘:测试文件位于 D:\new_project\tools\unit_test.py
    注意:这里的 \u 会被Python识别为Unicode转义序列的前缀
    """
    pass

# 执行时将抛出严重异常:
# SyntaxError: (unicode error) 'unicodeescape' codec can't decode bytes in position ...
如果你使用真正的 # 注释,上面的文本完全合法;但使用三引号时,解释器试图解析字符串中的转义符,直接触发 SyntaxError 终止执行。
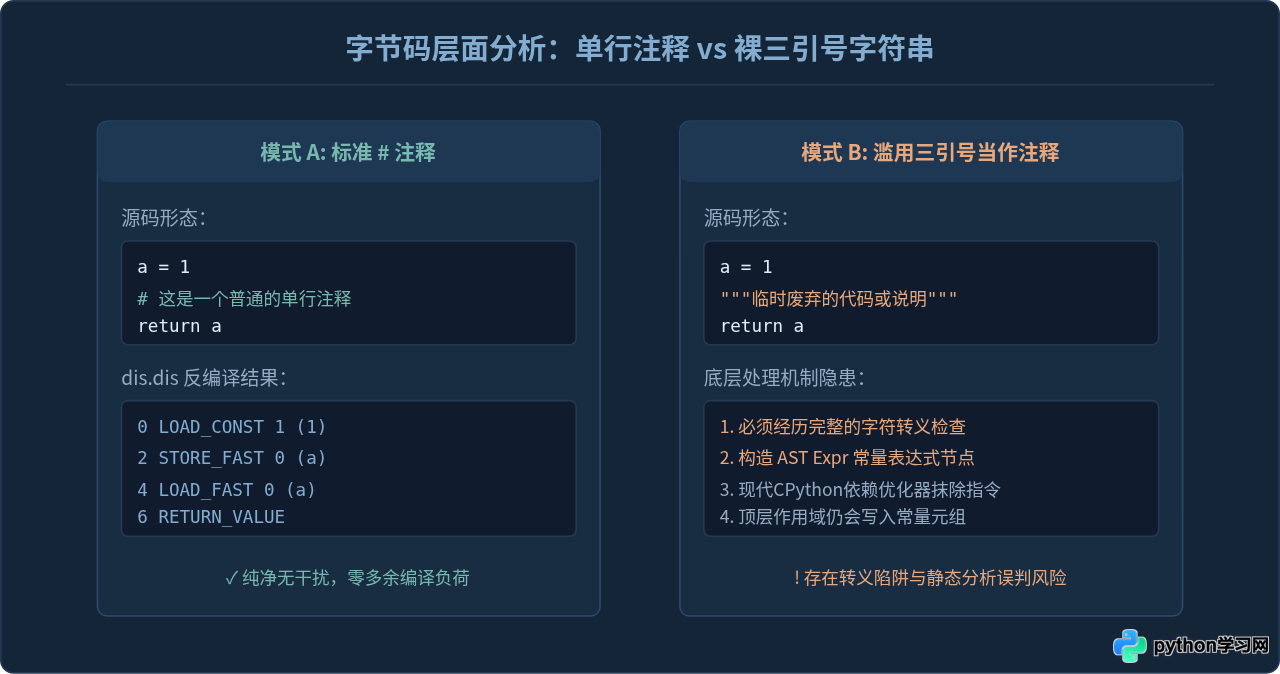
2. 字节码与编译器行为差异(dis模块对比)
我们通过标准库的 dis 模块反编译两段看似相同的代码,观察解释器如何处理函数体中间的三引号字符串:
import dis

def func_with_comment():
    a = 1
    # 这是一个单行注释
    return a

def func_with_triple_str():
    a = 1
    """这是一个中间的三引号字符串"""
    return a

print("=== func_with_comment 字节码 ===")
dis.dis(func_with_comment)

print("\n=== func_with_triple_str 字节码 ===")
dis.dis(func_with_triple_str)
在较旧的Python版本(Python 3.6及以前)中,中间未赋值的三引号字符串会直接生成 LOAD_CONST 然后立即 POP_TOP 的无用操作码,产生明确的指令周期消耗。在 Python 3.7+ 及当前的现代CPython解释器中,AST编译器层面的窥孔优化器(Peephole Optimizer)通常会在生成字节码时优化掉这种孤立无副作用的纯字面量节点,使得生成的字节码指令与注释版本一致。
然而,虽然现代字节码消除了指令,但在编译期、语法树构建期以及内存加载期的开销依然真实存在。尤其是在模块级别(顶层作用域),未赋值的三引号字符串很可能会作为孤立对象被存入模块的全局常量元组中,常驻内存无法回收。
3. 静态检查工具与代码规范冲突
现代Python工程离不开自动化代码质量工具(如 Flake8、Ruff、Pylint、mypy 等)。当你滥用三引号作为注释时:
- PEP 8 违背:PEP 8 官方编码风格指南明确指出,块注释(Block Comments)应该由多行以
#开头的语句组成。 - Pylint 警告:静态检查工具会将函数中间的独立字符串标记为
W0105: String statement has no effect(无意义的字符串语句)。 - 缩进陷阱:在多层循环或复杂条件分支内部,三引号内的每一行都必须注意缩进。如果不小心顶格书写或混用了Tab与空格,在特定的语法嵌套中极易引发意外缩进报错。
五、规范与总结:三种形态的完整横向对比
在日常开发中,究竟该如何准确选择?我们把真正的井号注释、标准文档字符串(Docstring)以及普通多行字符串的特征整理如下:
| 对比维度 | 井号注释 ( # ) | 文档字符串 (Docstring) | 普通多行字符串 (当作注释滥用) |
|---|---|---|---|
| 语法地位 | 真正的注释,非语法元素 | 首语句字符串字面量 | 独立表达式语句 (Expr Statement) |
| 词法分析处理 | 直接丢弃过滤 | 解析为 STRING 标记 | 解析为 STRING 标记 |
| AST语法树 | 不生成任何节点 | 生成 Constant 节点并标记为Doc | 生成普通的 Constant 表达式节点 |
| 运行时访问 | 不可访问,无任何残留 | 绑定至 __doc__ 属性 |
通常无法直接以注释属性访问 |
| 转义字符检查 | 不检查,任何文本均合法 | 严格检查(如 \u、\x 转义) | 严格检查,非法转义抛 SyntaxError |
| PEP 8 推荐度 | 唯一推荐 的多行注释方案 | 唯一推荐 的接口说明规范 | 强烈反对 作为注释使用 |
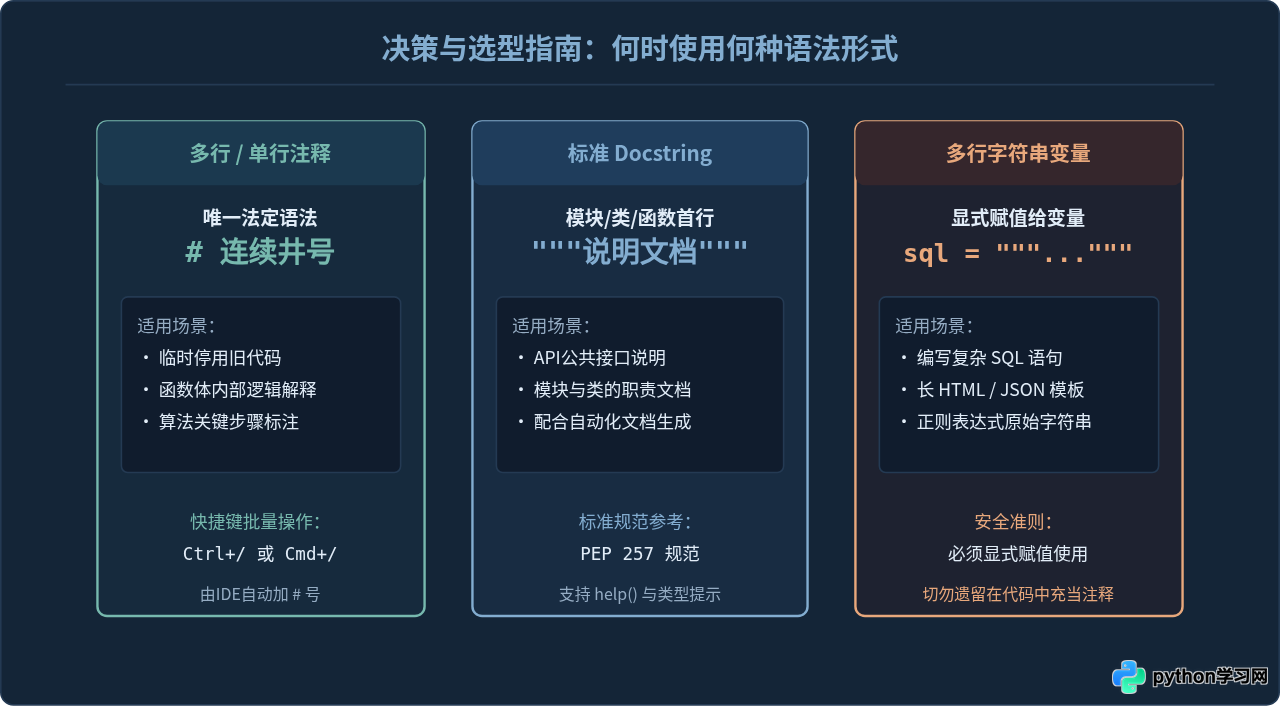
六、工程最佳实践总结
为了编写出整洁、规范且没有隐患的Python代码,请遵循以下三条核心实践准则:
- 牢记多行注释只有一种标准写法:连续使用
#。不要因为敲三引号省事而图一时之快。现代主流编辑器(如 VS Code、PyCharm、Cursor 等)都提供了快捷键(Windows/Linux为Ctrl + /,macOS为Cmd + /),选中任意多行代码即可一键批量加上或去除#前缀。 - 三引号专属于“文档(Docstring)”与“多行数据(Data)”。三引号只有两个合理的归宿:要么紧随
def/class/ 文件开头作为__doc__供文档工具与使用者读取;要么赋值给一个明确命名的变量(如SQL_TEMPLATE = """...""")作为真实数据使用。 - 警惕静态分析报警并定期排查。如果团队的 CI/CD 流程中集成了
flake8或pylint,遇到W0105(无副作用字符串语句)警告时不要轻易通过忽略规则跳过,而应老老实实将其替换为#块注释,保持代码库的规范度与健壮性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









