

Python函数定义与调用语法:参数传递及返回值处理
全面解析Python函数定义与调用的核心语法机制,深入剖析对象引用传递的底层原理、可变与不可变对象传参差异、五大形参定义规范、默认参数可变对象陷阱,以及多元返回值自动打包与解构的最佳实践。
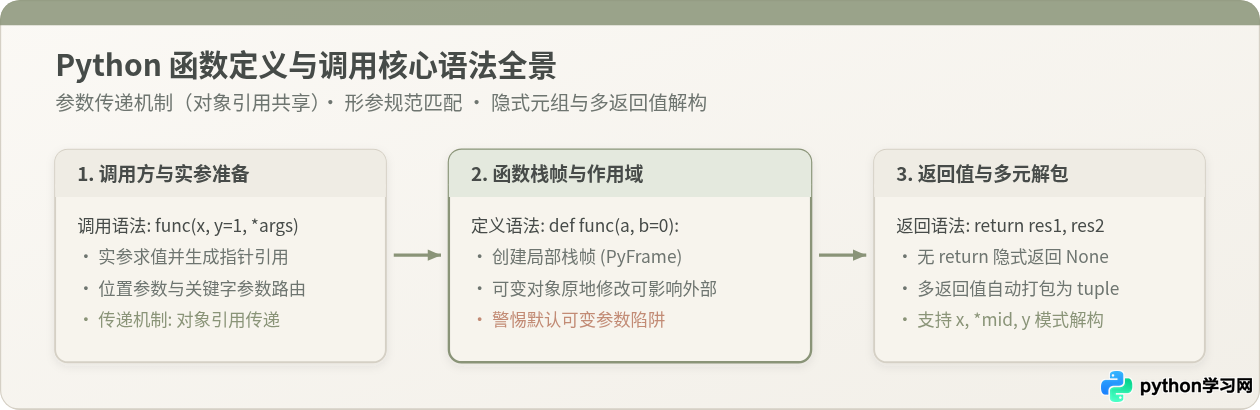
在 Python 中,函数不仅是组织可复用业务逻辑的基本单元,更是一等公民对象。掌握函数的关键在于弄清楚两件事:一是参数是如何传递与绑定的——尤其是 Python 特有的“对象引用传递”机制与 5 类形参的排列规范;二是函数是如何向外界交付计算结果的——包括无处不在的隐式 None、多返回值元组打包与解包匹配。本文系统拆解这套语法链条,帮助你在编写与调试函数时建立清晰确定的心智模型。
一、函数定义与调用的基础语法及生命周期
在 Python 中,定义函数使用 def(define 的简写)关键字,调用函数则在函数名后附加圆括号 ()。与其他编译型语言不同,Python 中的 def 是一条在代码执行时实时求值的可执行语句。当解释器运行到 def 行时,会在内存中动态生成一个 function 类型的对象,并将其绑定到当前的命名空间中。
一个标准函数的通用结构包含函数名称、形参列表、文档字符串(Docstring)、执行体以及返回值语句:
def calculate_discount(price: float, rate: float = 0.1) -> float:
    """计算商品的折扣后价格。

    :param price: 商品原价
    :param rate: 折扣比例,默认为 10%
    :return: 折扣后金额
    """
    if price < 0:
        raise ValueError("商品价格不能为负数")
    discounted = price * (1 - rate)
    return discounted

# 基础调用示例
final_price = calculate_discount(200.0, 0.2)
print(f"结算价格: {final_price}")
为了精准理解函数的执行机制,我们需要理清从定义到调用完成的整个生命周期。当解释器遇到函数调用表达式 func(...) 时,会经历实参求值、分配栈帧、建立参数映射、执行逻辑、返回值出栈并回收栈帧等 5 个明确步骤。
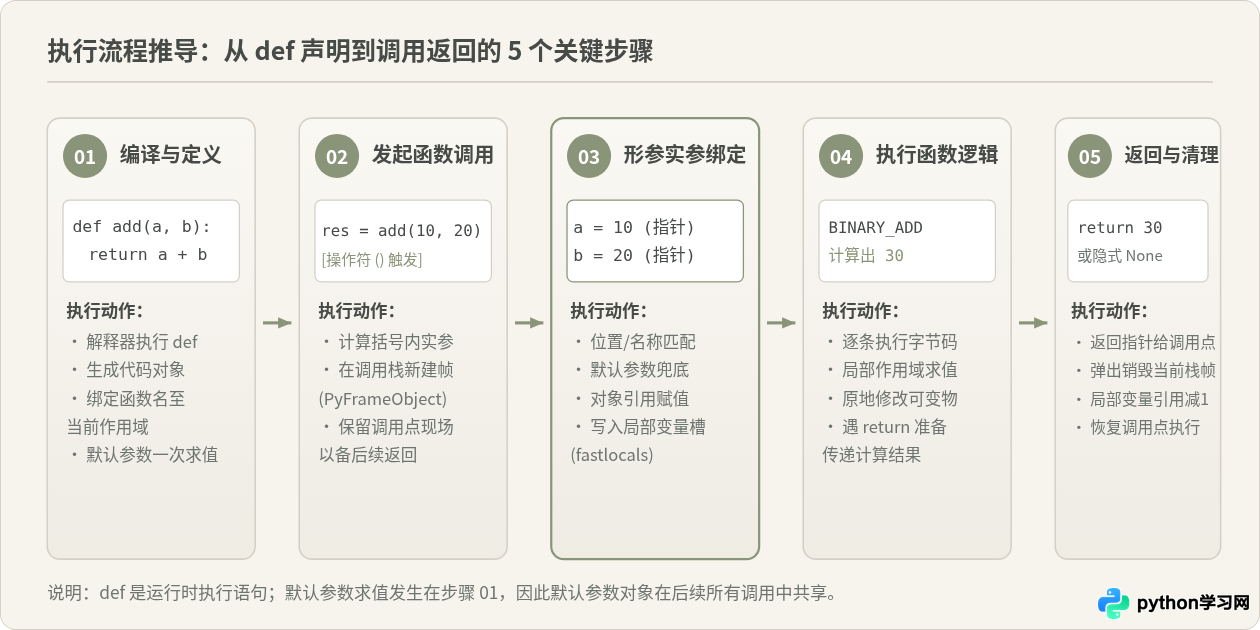
在这个过程中有两项底层机制需要特别留心:第一,默认参数只在步骤 01(即 def 执行定义时)被求值一次,而不是每次调用重新计算;第二,调用时所创建的栈帧(PyFrameObject)在执行结束并返回结果后即被弹出,如果其中的局部变量未被闭包或全局引用持有,其引用计数归零后会被垃圾回收器安全销毁。
二、核心机制辨析:Python 的“对象引用传递”
在技术交流与面试中,常常能听到两种针锋相对的声音:“Python 是按值传递的”与“Python 是按引用传递的”。这两种说法各自看似都有事实支撑,但都不够严谨。
为什么说它们看似合理?如果你把一个整数 n = 10 传给函数并在内部执行 n = 20,外部的 n 依然是 10,看起来完全符合传统语言的“值传递(拷贝)”特性;但如果你把一个列表 lst = [1, 2] 传进函数并执行 lst.append(3),外部的 lst 立即同步变成了 [1, 2, 3],这又完全符合“引用传递”的表现。
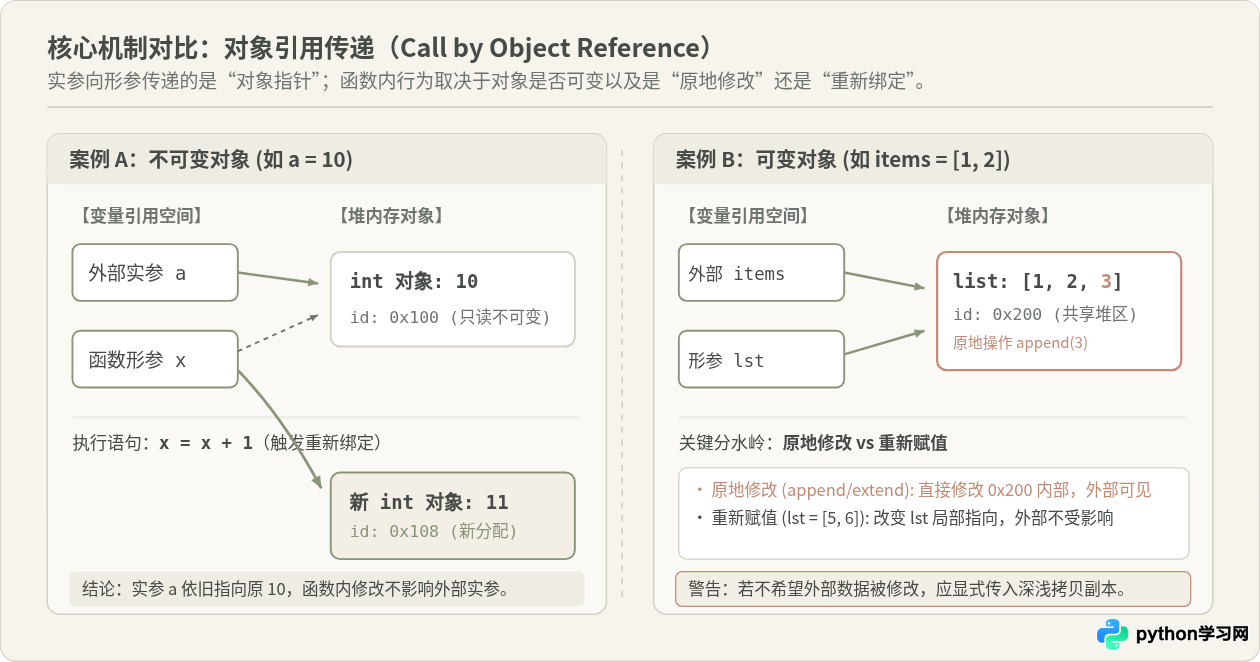
修正后的准确结论:Python 既非纯粹的 C 式按值拷贝,也非 C++ 传统的变量引用别名,其官方规范术语为“对象引用传递”(Call by Object Reference),亦称“共享传递”(Call by Sharing)。在 Python 中,所有变量都只是指向底层对象的“标签”。函数传参时,传递给形参的是实参所持有的“对象内存地址指针的副本”。
函数内部的行为差异,本质上取决于两个独立维度的叠加:对象本身是否可变(Mutable / Immutable),以及函数体内的操作是“原地修改”还是“重新赋值”。
1. 不可变对象(int, float, str, tuple, frozenset)
由于不可变对象在内存中一旦创建就不可改变其内容,任何针对该变量的算术运算或重新赋值操作(例如 x = x + 1),都会迫使解释器在内存中分配一个新的对象,并将形参变量重新绑定(Re-binding)到新对象上。此时,形参脱离了对原对象的指向,而外部实参仍然牢牢指向原对象。
def modify_number(x: int):
    print(f"进入函数时 x 的 id: {hex(id(x))}")
    x = x + 1  # 触发整数对象的创建与重绑定
    print(f"修改之后 x 的 id: {hex(id(x))},数值: {x}")

a = 100
print(f"调用前外部 a 的 id: {hex(id(a))}")
modify_number(a)
print(f"调用后外部 a 的数值依然是: {a}")进入函数时 x 的 id: 0x104b2a8d0
修改之后 x 的 id: 0x104b2a8f0,数值: 101
调用后外部 a 的数值依然是: 100
2. 可变对象(list, dict, set, 自定义类实例)
对于可变对象,形参与实参在初始时刻共享同一块堆内存。如果在函数体内调用了可变对象的原地变更方法(如 append()、extend()、字典键赋值 d[k] = v),这些修改会直接作用在共享堆内存上,外部实参自然能够观察到变化。
然而,如果在函数体内对形参进行了整体赋值(例如 lst = [4, 5, 6]),这仅仅是将形参这个局部变量标签贴到了全新的列表上,并不会影响外部实参。
def operate_list(target_list: list):
    target_list.append(999)      # 原地修改:外部实参受影响
    target_list = ["新", "列表"]  # 局部重绑定:外部实参不受影响

my_data = [1, 2]
operate_list(my_data)
print(f"外部 my_data 最终结果: {my_data}")三、参数传递语法规范与形参体系
Python 拥有非常灵活且严格的形参设计体系。为了消除实参匹配时的二义性,Python 解释器在语法层面规定了 5 类形参的先后声明次序。如果在定义函数时颠倒了这些顺序,代码在编译阶段就会直接抛出 SyntaxError。
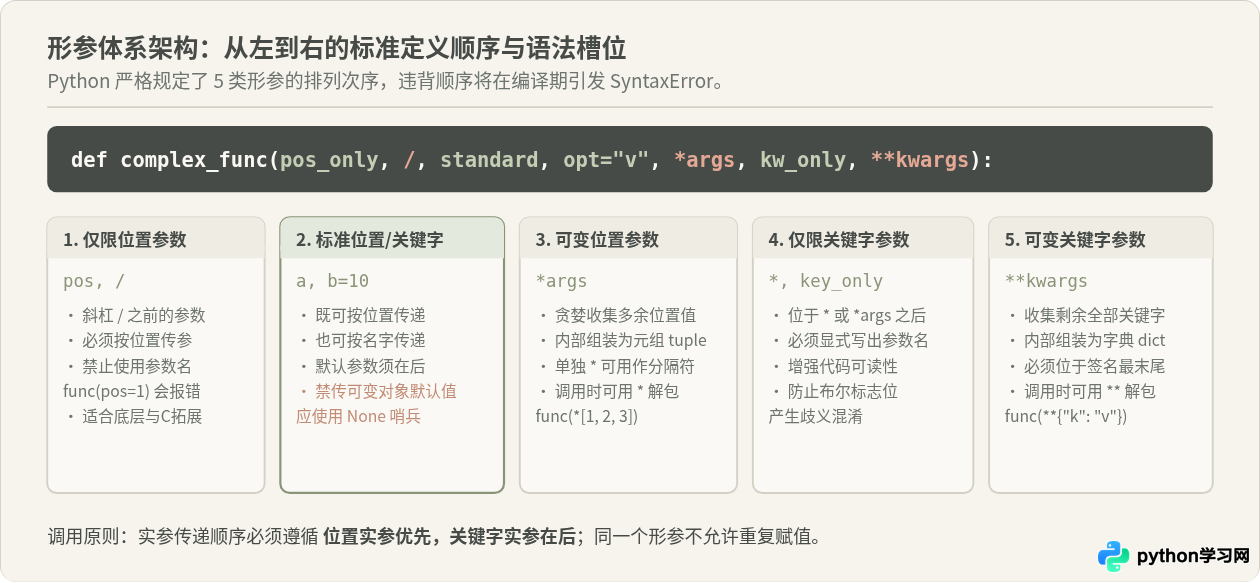
1. 仅限位置参数(Positional-Only Arguments,PEP 570)
位于斜杠 / 左侧的参数为“仅限位置参数”。调用方只能通过位置传入对应实参,绝对不能使用形参名称传入。这在设计底层 API 或数学公式类函数时非常有用,它允许库作者在未来重构时自由修改内部形参名,而不会破坏任何调用者的现有代码。
def format_coordinate(x: float, y: float, /, precision: int = 2):
    return f"({x:.{precision}f}, {y:.{precision}f})"

# 正确调用方式:x 与 y 只能按位置传入
print(format_coordinate(12.3456, 78.9101, precision=3))

# 错误调用方式:若尝试使用 x=12.3456 会抛出 TypeError: positional-only arguments2. 默认参数与经典陷阱:绝对不要使用可变对象作为默认值
默认参数允许为某些形参提供缺省值,使得调用时可以省略该实参。但这里隐藏着初学者最容易踩中的一个经典语法陷阱。
错误写法:def append_item(item, bucket=[]):
现象:连续多次调用 append_item(1) 时,返回的列表并不是每次都只有 [1],而是变成了 [1, 1, 1]!
底层根源:默认参数的表达式并不是在每次函数被调用时计算的,而是在解释器加载并执行 def 语句那一刻求值的!生成的默认列表被保存在了该函数对象的 __defaults__ 内部属性中。所有没有传递 bucket 的调用,其实都在共同操作这同一个全局列表。
标准修正规范:始终使用不可变的 None 作为哨兵值,并在函数体内做动态赋值。
# 推荐的标准范式:None 哨兵模式
def add_log_entry(message: str, tags: list = None) -> list:
    if tags is None:
        tags = []  # 每次调用时独立在局部作用域创建新列表
    tags.append(message)
    return tags

print(add_log_entry("Task A"))
print(add_log_entry("Task B"))['Task B']
3. 可变位置参数 *args 与实参解包
在形参名前加一个星号 *args,表示将调用方传入的任意多个多余位置参数打包成一个元组(Tuple)。反之,如果在调用函数时使用 *iterable,则会将序列解包为独立的位置实参。
4. 仅限关键字参数(Keyword-Only Arguments)
紧跟在 *args 或单个孤立星号 * 之后的形参被称为“仅限关键字参数”。调用方必须显式写出形参名进行传参。这常用于配置项或开关参数,能有效防止调用方把布尔值或数字按错位置传递。
def save_profile(username: str, *, is_admin: bool = False, notify: bool = True):
    return f"用户: {username}, 管理员: {is_admin}, 发送通知: {notify}"

# 正确调用:必须显式声明参数名
print(save_profile("alex", is_admin=True))
# 若写成 save_profile("alex", True) 会直接抛出 TypeError
5. 可变关键字参数 **kwargs 与字典解包
形参名前的双星号 **kwargs 会将调用方传入的所有未被前面形参匹配的关键字参数,统一收集并封装为一个字典(Dict)。它必须位于整个形参列表的最末尾。在调用方,使用 **dict_data 可以将字典展开为成对的关键字实参。
四、返回值处理机制与多元解构
在 Python 中,函数的返回值通过 return 语句输出。return 语句不仅负责传递计算结果,还会立即终止函数的执行流程,退出当前栈帧。
为什么说它看似合理?代码中写 return x, y, z 时,外面可以直接用 a, b, c = func() 接收,感觉上函数似乎一次性返回了 3 个独立的数据。
底层真相:严格从语法和字节码层面上看,Python 函数任何时候都只能返回单一对象。语句 return x, y, z 本质上是利用 Python 的逗号表达式进行了隐式元组打包(Tuple Packing),等价于 return (x, y, z)。外面的 a, b, c = ... 则是基于可迭代对象的序列解包(Sequence Unpacking)。
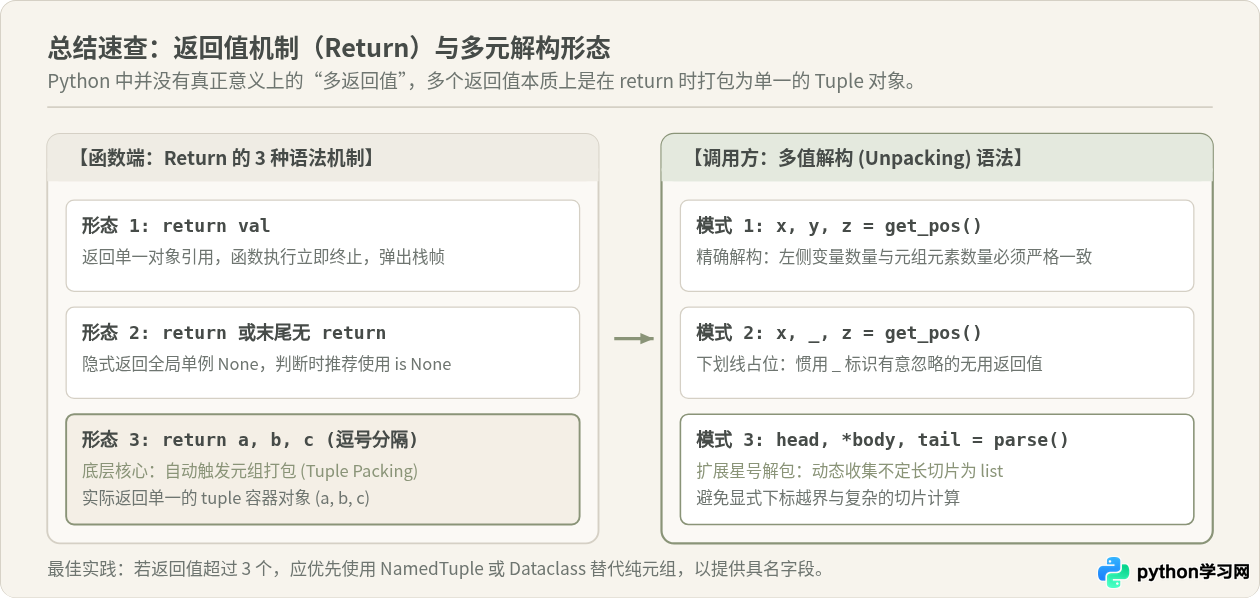
1. 隐式返回 None 与类型判断
如果一个函数内部没有任何 return 语句,或者执行到了只有 return 没有跟任何表达式的分支,Python 会自动隐式返回全局唯一的 None 单例对象。
在判断返回值是否有效时,必须使用身份比较运算符 is None 或 is not None,而不要使用等值比较 == None 或纯布尔判断 if not result:,以防止返回值本身为 0、"" 或 False 时产生误判。
2. 多元返回值的高级解包技巧
得益于 Python 的序列解包语法,调用方接收由元组打包的多元返回值时非常灵活:
- 精确解包:左侧变量个数与元组元素完全一致,如
x, y = get_pos()。数量不符时会触发ValueError: too many/not enough values to unpack。 - 下划线占位:使用单个下划线
_显式忽略调用方不关心的某个返回值,如status, _, data = parse_response(),这既符合 PEP 8 风格指南,又向代码维护者传达了明确的设计意图。 - 扩展星号解包(Extended Iterable Unpacking):使用
*var动态吸收中间或尾部任意长度的连续返回值,其收集结果为一个列表。
def analyze_scores(score_list: list):
    sorted_scores = sorted(score_list)
    # 逗号分隔返回:实际返回 (最低分, 中间分序列, 最高分)
    return sorted_scores[0], sorted_scores[1:-1], sorted_scores[-1]

raw_scores = [88, 95, 72, 85, 99, 61, 90]
lowest, *middle, highest = sorted_scores = analyze_scores(raw_scores)

print(f"最低分: {lowest}")
print(f"最高分: {highest}")
print(f"中间分数段 (列表): {middle}")最高分: 99
中间分数段 (列表): [72, 85, 88, 90, 95]
3. 卫语句(Guard Clauses)与提前返回模式
在编写包含多重校验的业务函数时,避免将主逻辑深层嵌套在 if-else 中。推荐采用卫语句(Guard Clauses)与提前返回:先对不合法、异常或边界条件进行检查,如果不满足条件立即 return,让核心逻辑始终保持在函数最外层的缩进级别上。
# 推荐:扁平清晰的卫语句设计
def process_order(order_id: str, items: list, balance: float):
    if not order_id:
        return False, "订单ID无效"
    if not items:
        return False, "商品清单为空"
    if balance <= 0:
        return False, "账户余额不足"

    # 核心业务处理流程
    total_cost = sum(item["price"] for item in items)
    return True, f"订单扣款成功,共计 {total_cost} 元"
五、编写健壮函数的工程建议
掌握了语法机制之后,在实际工程开发中还应建立起良好的函数编写习惯,使函数具有高内聚、低耦合、易测试的特性:
-
积极引入类型注解(Type Hints):
类型提示不仅能在大型项目中与
mypy等静态分析工具协同工作,还能让函数的签名直接充当清晰、准确的实时技术文档,大幅降低同事维护与二次调用的理解成本。 -
谨慎对待副作用(Side Effects),优先追求纯函数:
如果一个函数修改了外部传入的可变对象,务必在文档字符串中明确标明;如果并不需要修改原数据,应在进入函数后先做浅拷贝(
data.copy())或深拷贝(copy.deepcopy(data)),避免造成难以排查的数据污染。 -
多返回值数量克制:
当一个函数需要返回超过 3 个字段时,直接返回元组会导致调用方容易混淆字段顺序。此时应果断改用标准库中的
typing.NamedTuple或dataclasses.dataclass,为每个属性赋予明确的名字与类型,提高代码的可读性与重构安全性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









