

解决Python运行汉诺塔时的RecursionError报错
深入解析Python运行汉诺塔递归算法时出现RecursionError的根本原因,提供清晰的排查步骤、代码修复示例、递归深度限制调节方法以及显式栈与位运算免递归替代方案。
RecursionError: maximum recursion depth exceeded,绝大多数初学者或开发者会误以为是盘子数量太大导致系统资源耗尽。而实质上,汉诺塔算法的最大递归调用深度仅与圆盘总数呈线性关系 \(O(n)\),哪怕测试 64 层盘子,调用栈最大也仅为 64 层。在常规盘数(如 3、5 或 10)下发生该报错,100% 是因为递归逻辑出现了死循环——即缺失递归基(终止条件)或子调用中漏写了递减参数 n - 1。本文将带你系统复现此报错、理清调用栈机理、排查三大代码陷阱,并给出标准递归修复及彻底规避栈限制的非递归替代方案。
一、报错现场复现与错误栈剖析
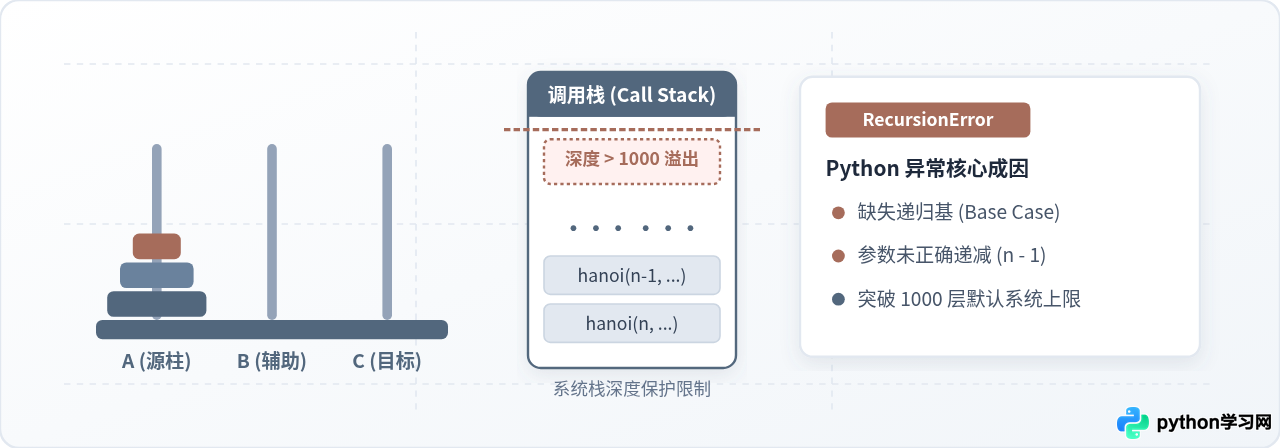
在 Python 中,当一段递归代码无休止地调用自身时,解释器为了防止 C 语言底层的调用栈耗尽导致整个进程崩溃(Segmentation Fault),设置了一个安全深度阈值(默认通常为 1000)。一旦函数调用层级触碰该警戒线,Python 便会立即截断执行并抛出 RecursionError。
下面是一段初学者极易写出的“典型错误代码”:
# 错误示例:缺少递归终止条件或参数没有递减
def hanoi_buggy(n, a, b, c):
    # 期望在 n == 1 时停止,但误写了递归逻辑或漏掉了 return
    hanoi_buggy(n - 1, a, c, b)
    print(f"将盘子 {n} 从 {a} 移动到 {c}")
    hanoi_buggy(n - 1, b, a, c)

# 仅仅调用 3 层盘子
hanoi_buggy(3, 'A', 'B', 'C')
运行上述代码后,终端并不会输出移动方案,而是会瞬间抛出如下 Traceback 堆栈信息:
File "hanoi.py", line 9, in <module>
hanoi_buggy(3, 'A', 'B', 'C')
File "hanoi.py", line 4, in hanoi_buggy
hanoi_buggy(n - 1, a, c, b)
File "hanoi.py", line 4, in hanoi_buggy
hanoi_buggy(n - 1, a, c, b)
[Previous line repeated 996 more times]
RecursionError: maximum recursion depth exceeded while calling a Python object
注意错误提示中的 [Previous line repeated 996 more times]。这说明函数在第 4 行反复调用自己,参数 \(n\) 从 3 减到 2、1、0、-1、-2……一直递减到 -997,直到堆栈深度累计达到 1000 触发保护。
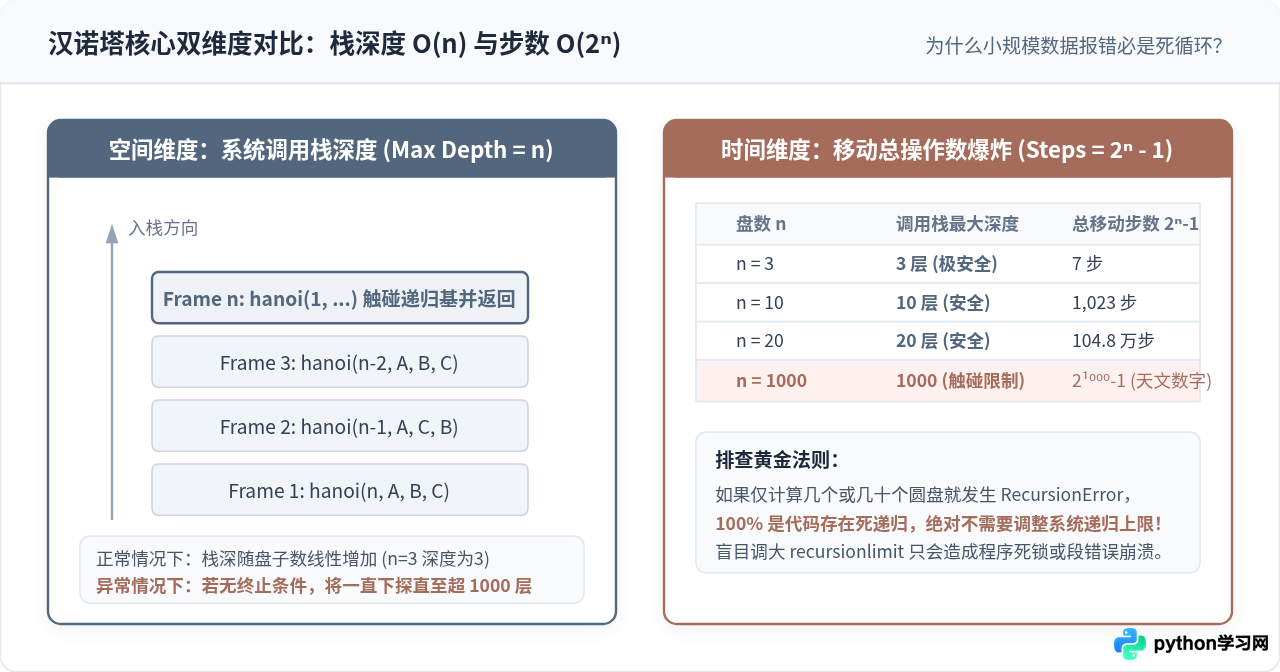
许多人容易将汉诺塔的“移动步数爆炸”与“递归深度溢出”混淆。汉诺塔移动 \(n\) 个盘子的总步数为 \(2^n - 1\),确实呈指数级膨胀;但是,递归算法在完成左子树调用后会立即退栈释放帧空间,因此在任意瞬时,系统栈所保留的最大帧数仅仅是 \(n\) 层。换言之,即便对于 \(n = 30\) 这样需要移动 10 亿步的规模,调用栈深度也仅仅是 30,远低于 1000。因此,只要你的盘子数 \(n < 1000\),遇到该错误可以百分之百断定是程序逻辑存在死循环。
二、递归报错的三大根源与排查步骤
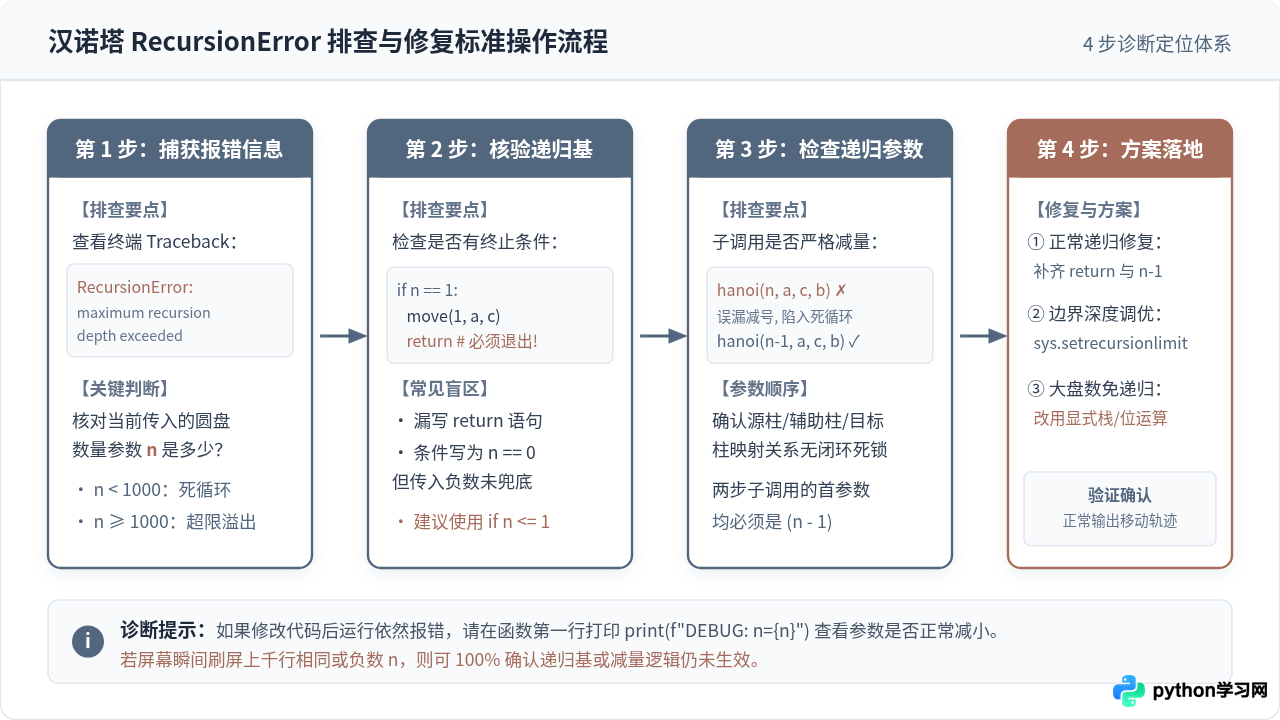
要彻底排除 RecursionError,请按照以下标准顺序逐步核查代码中的关键控制点。
排查点 1:递归基(Base Case)缺失或退出逻辑失效
递归必须有明确的终止条件。最常见的失误有两种:第一种是完全忘记写 if n == 1: 或 if n <= 0:;第二种是虽然写了判断,但漏掉了 return 语句,导致代码执行完打印后继续向下执行递归调用。
# 典型错误:有判断但漏写 return,导致穿透执行
def hanoi(n, a, b, c):
    if n == 1:
        print(f"移动盘 1: {a} -> {c}")
        # 严重漏洞:此处若没有 return,代码会继续执行下方的 hanoi(0, ...)
    hanoi(n - 1, a, c, b)
    print(f"移动盘 {n}: {a} -> {c}")
    hanoi(n - 1, b, a, c)
排查点 2:子问题递归参数传递错误(忘记减 1)
在递归拆解过程中,汉诺塔依赖将规模缩减为 \(n-1\)。如果在调用时笔误写成了 hanoi(n, a, c, b),参数 \(n\) 将永远保持原值不变,函数在第一次子调用时就陷入原地无限空转,瞬间耗尽 1000 层深度。
排查点 3:测试用例传入非正整数或超大规模数值
若用户输入或测试脚本传入了负数(例如 -1)或浮点数,而基准条件仅使用了绝对等于 if n == 1:,那么参数递减过程将跳过 1,一路向负无穷滑落。因此,严谨的递归基应使用小于等于判断 if n <= 1: 或 if n <= 0: return。
如果你不确定自己的代码停在哪里,可在函数入口第一行加入 print(f"[DEBUG] n={n}, a={a}, b={b}, c={c}")。如果终端瞬间刷出负数 \(n\),说明递归基未拦截;如果 \(n\) 始终不改变,说明减量参数写错。
三、标准递归修复代码与深度参数调节
掌握了上述原因后,编写一个健壮、规范的汉诺塔递归函数只需遵循标准的三步分治框架。
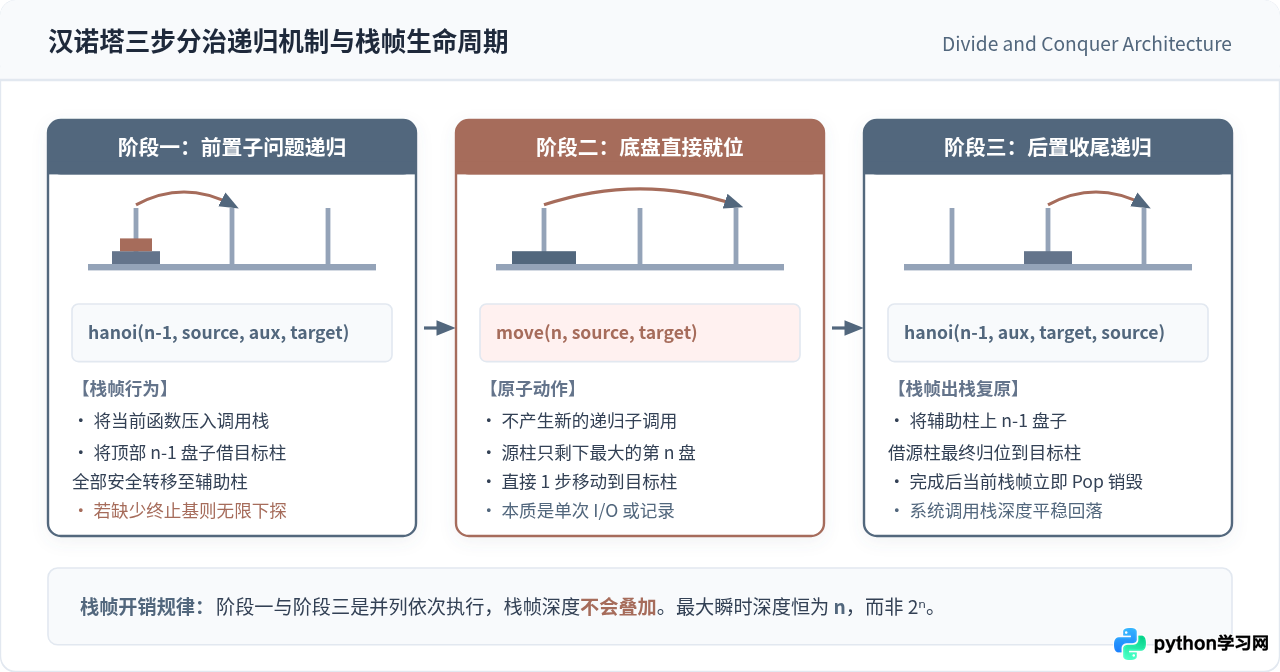
1. 标准且严谨的递归代码实现
推荐采用“以 \(n \le 0\) 为边界守卫”或“以 \(n == 1\) 为最小移动原子”的结构:
def hanoi_solve(n: int, source: str, aux: str, target: str):
    # 边界防守:拦截非法输入
    if n <= 0:
        return

    # 递归基:只有 1 个盘子时直接移动并返回
    if n == 1:
        print(f"盘 1 从 {source} -> {target}")
        return

    # 阶段一:将上方 n - 1 个盘子由 source 借 target 移到 aux
    hanoi_solve(n - 1, source, target, aux)

    # 阶段二:将最底部的第 n 个盘子直接移动到 target
    print(f"盘 {n} 从 {source} -> {target}")

    # 阶段三:将 aux 上的 n - 1 个盘子借 source 移到 target
    hanoi_solve(n - 1, aux, source, target)

# 验证执行(示例:3 个圆盘)
hanoi_solve(3, 'A', 'B', 'C')
执行该脚本,输出结果严丝合缝,准确无误:
盘 2 从 A -> B
盘 1 从 C -> B
盘 3 从 A -> C
盘 1 从 B -> A
盘 2 从 B -> C
盘 1 从 A -> C
2. 真的需要调大 sys.setrecursionlimit 吗?
有些教程会建议使用 sys.setrecursionlimit(5000) 来“解决”报错。在此必须明确指出:对于汉诺塔问题,盲目调大递归限制通常是错误的方向。
- 如果是死循环:调大限制到 5000,程序只是在多跑了 4000 次死循环后再次抛出异常,甚至引发操作系统底层栈溢出导致 Python 解释器无预警闪退。
- 如果是真实需求盘数 \(n \ge 1000\):汉诺塔移动步数为 \(2^{1000}-1\),这个数字约等于 \(1.07 imes 10^{301}\)。即使计算机每秒能执行 100 亿步,也无法在有生之年打印完前几十个盘子。如果在算法题或工程中需要计算更大规模的状态,应使用数学公式或非递归算法。
唯有在极少数基准测试场景下确实需要下探 1200 层调用栈时,才在代码头部加入:
import sys
# 查看当前系统限制(默认 1000)
print(sys.getrecursionlimit())

# 按需调整为安全合理的范围
sys.setrecursionlimit(2000)
四、根治栈溢出:非递归(迭代与位运算)实现方案
如果项目中存在严格的代码审查规范,禁止使用深度可能不可控的递归函数,或者需要在受限运行时中消除任何 RecursionError 风险,可以将汉诺塔改写为显式模拟栈迭代或二进制位运算生成法。
方案 A:显式栈迭代(在堆内存中模拟调用)
系统调用栈受制于固定的几兆字节限制,但 Python 的普通列表(list)分配在堆内存中,可以轻松存储数百万个任务节点。
def hanoi_iterative_stack(n: int, a: str, b: str, c: str):
    # 使用列表作为显式栈,存储任务元组: (盘数, 源柱, 辅助柱, 目标柱)
    stack = [(n, a, b, c)]

    while stack:
        cur_n, src, aux, tgt = stack.pop()

        if cur_n <= 0:
            continue

        if cur_n == 1:
            print(f"盘 1 从 {src} -> {tgt}")
        else:
            # 注意:栈是后进先出(LIFO),所以压栈顺序与执行顺序相反
            # 执行顺序:子问题1 -> 本层移动 -> 子问题2
            # 压栈顺序:子问题2 -> 本层移动 -> 子问题1
            stack.append((cur_n - 1, aux, src, tgt))
            stack.append((1, src, aux, tgt))
            stack.append((cur_n - 1, src, tgt, aux))
方案 B:二进制位运算直接生成(空间复杂度 O(1))
数学上,汉诺塔的第 \(m\) 步操作(\(1 \le m < 2^n\))具有极其优美的位运算规律:
- 当前移动的圆盘编号是 \(m\) 在二进制下最低有效位 1 的位置(即
(m & -m).bit_length())。 - 圆盘移动的方向取决于盘数奇偶性与位状态。
def hanoi_bitwise(n: int, a: str, b: str, c: str):
    total_moves = (1 << n) - 1
    # 若 n 为偶数,顺时针方向为 A -> B -> C;若奇数则为 A -> C -> B
    rods = [a, c, b] if n % 2 != 0 else [a, b, c]

    for m in range(1, total_moves + 1):
        # 计算当前移动的盘子编号(1 到 n)
        disk = (m & -m).bit_length()
        # 根据数学公式计算起止柱索引
        from_rod = (m & (m - 1)) % 3
        to_rod = ((m | (m - 1)) + 1) % 3
        print(f"第 {m} 步: 盘 {disk} 从 {rods[from_rod]} -> {rods[to_rod]}")
位运算解法完全不需要递归调用栈,也没有维护显式栈对象的内存开销,空间复杂度恒定为 \(O(1)\),在算法层面天生免疫 RecursionError。
五、方案选型对比与避坑速查
为了帮助读者在不同开发与面试场景中做出最稳妥的选择,下表全面总结了解决汉诺塔问题时三种主要实现手段的技术特征与选型建议:
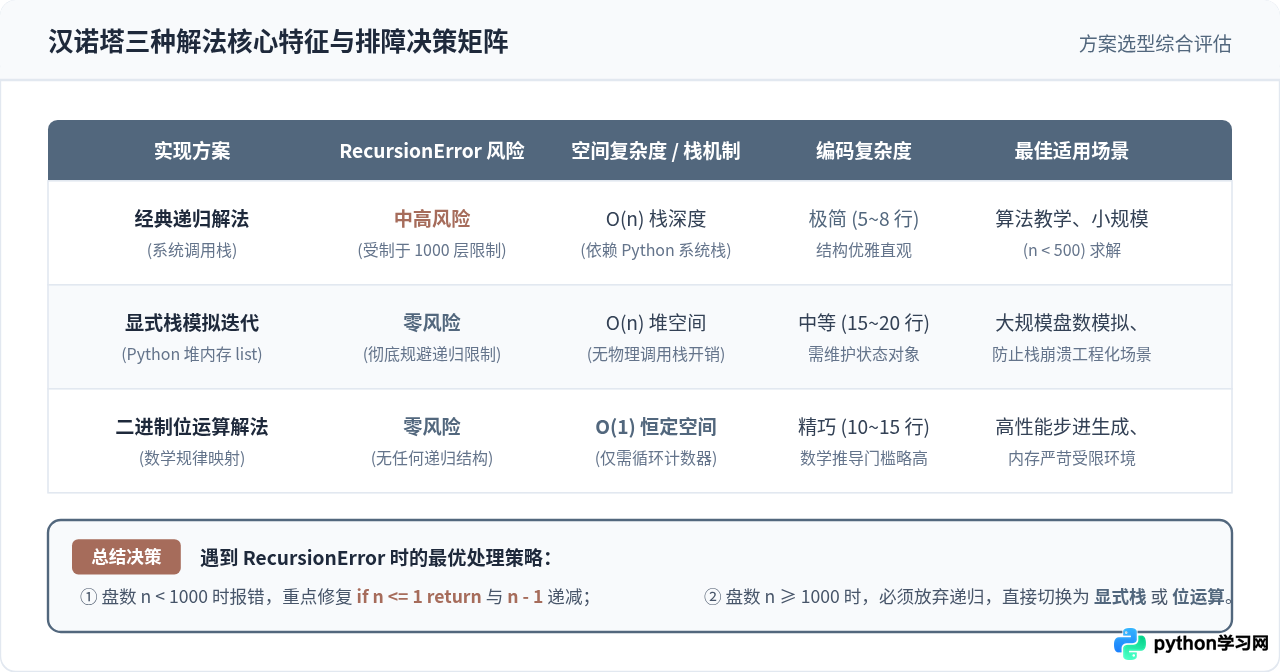
最终检查清单:
- 代码中是否明确定义了
if n <= 1:或if n == 1:并包含return终止? - 两次子调用的首个参数是否都严格写成了
n - 1,杜绝出现n导致的死循环? - 如果是在算法测试平台遇到大规模用例报错,是否应当优先选用显式栈或数学规律?
只要牢牢把握“递归深度仅为 \(O(n)\)”与“必须设置有效递归基”这两个基本定律,Python 汉诺塔中的 RecursionError 便能迎刃而解。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









