

Python汉诺塔不用全局变量怎么计算移动步数

在 Python 中实现经典的汉诺塔递归算法时,统计总移动步数通常有三种不依赖全局变量的优雅方案:利用递归函数返回值直接向下累加、利用外层闭包或局部可变对象传参收集状态、以及利用生成器(Generator)进行按需产出与外部统计。这些方法不仅符合函数的纯度与自包含原则,还能彻底杜绝多线程冲突和多次调用时计数器未重置的隐患。
一、为什么应当避免使用全局变量
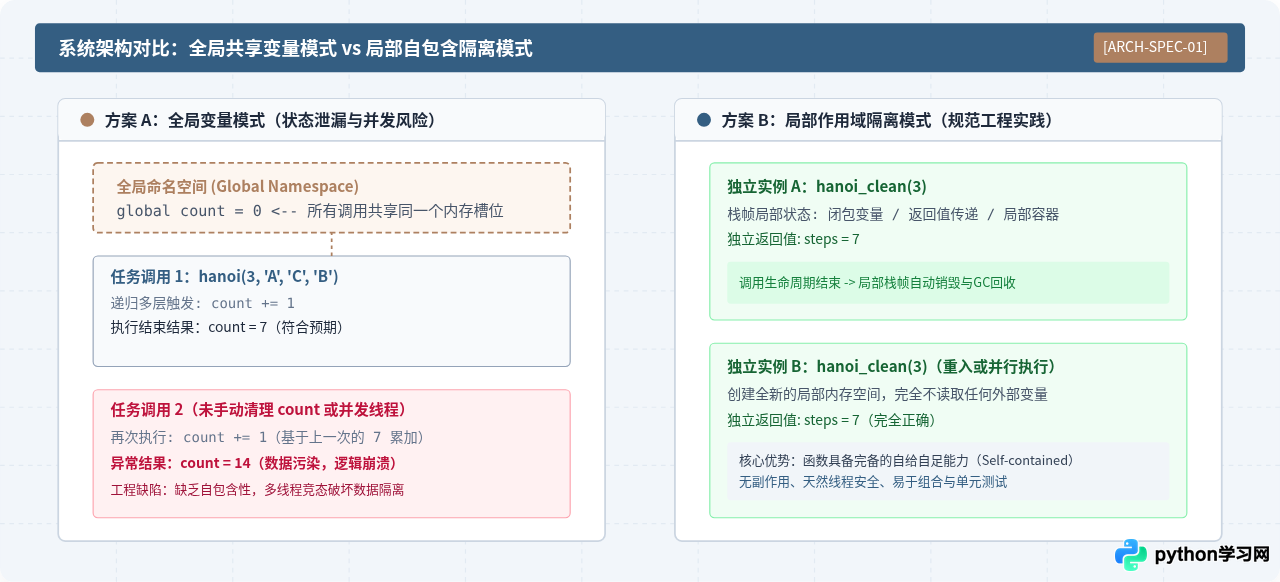
在初学递归时,许多人习惯在函数体外定义一个 count = 0,然后在递归函数内部声明 global count 并在每移动一步时执行 count += 1。这种方式虽然直观,但在工程实践中存在明显的弊端:
- 状态残留与不可重入:如果同一个程序中连续两次调用汉诺塔函数,第二次调用的计数器将直接从第一次的结束值继续累加,除非在调用前显式重置全局变量。
- 并发安全性丧失:多线程环境下若有多个任务同时执行汉诺塔计算,共享的全局变量会发生严重的竞态读写(Race Condition),导致步数错乱。
- 破坏模块封装性:函数依赖外部环境状态,无法独立成为干净的纯工具函数,给单元测试与复用带来额外负担。
二、方法一:利用递归返回值累加(最纯粹的函数式方案)
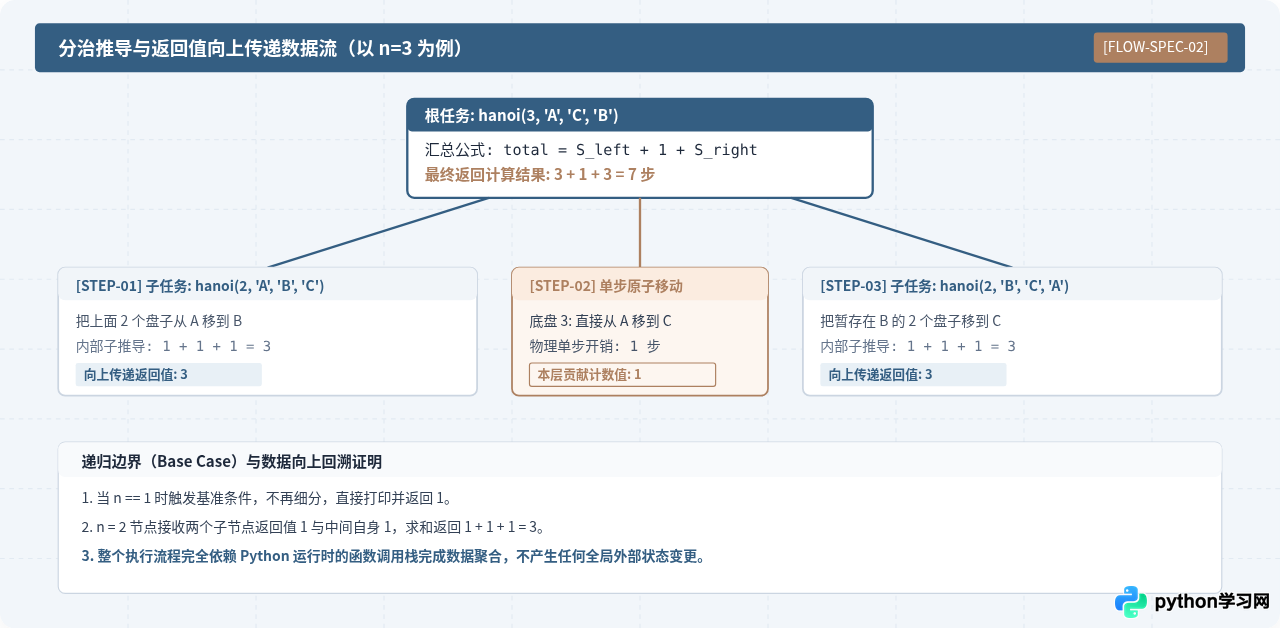
求解汉诺塔的核心思想是分治法。将 $n$ 个盘子从源柱 $A$ 移动到目标柱 $C$(借助辅助柱 $B$)可以严格分解为三个原子阶段:
- 将上面 $n-1$ 个盘子从 $A$ 移动到辅助柱 $B$;
- 将底部的第 $n$ 个最大盘子从 $A$ 直接移动到目标柱 $C$(耗费 1 步);
- 将暂存在辅助柱 $B$ 上的 $n-1$ 个盘子移动到目标柱 $C$。
因此,对于移动步数的数学递推关系为:$T(n) = T(n-1) + 1 + T(n-1) = 2T(n-1) + 1$,基础边界条件为 $T(1) = 1$。我们在代码中直接让递归函数返回当前子任务所消耗的步数,并在上层函数中将三部分相加返回,完全无需任何外部变量。
def hanoi_return(n, source='A', target='C', auxiliary='B'):
    """
    通过函数返回值累加计算汉诺塔移动步数
    :param n: 盘子总数
    :param source: 起始柱
    :param target: 目标柱
    :param auxiliary: 辅助柱
    :return: 移动的总步数
    """
    if n == 1:
        print(f"移动盘子 1: {source} -> {target}")
        return 1

    # 阶段 1:将 n-1 个盘子移到辅助柱
    steps_left = hanoi_return(n - 1, source, auxiliary, target)

    # 阶段 2:移动底层的最大盘子
    print(f"移动盘子 {n}: {source} -> {target}")
    step_current = 1

    # 阶段 3:将 n-1 个盘子从辅助柱移到目标柱
    steps_right = hanoi_return(n - 1, auxiliary, target, source)

    # 向调用栈上一层返回三部分步数的总和
    return steps_left + step_current + steps_right

# 验证调用
total = hanoi_return(3, 'A', 'C', 'B')
print(f"完成!总步数: {total}")
三、方法二:利用闭包与局部容器封装
如果希望在代码写法上维持类似“遇到移动就步数加一”的命令式习惯,同时又严格禁止全局变量污染,可以通过以下两种局部状态封装技巧实现:
3.1 使用外层包装函数与 nonlocal 关键字
定义一个对外的包装函数,在其内部初始化局部计数变量 count = 0,再定义内层辅助递归函数。内层函数使用 nonlocal count 显式声明修改外层作用域而非全局作用域中的变量:
def hanoi_closure(n, source='A', target='C', auxiliary='B'):
    """使用闭包与 nonlocal 实现计数封装"""
    count = 0  # 属于外层函数的局部变量,对全局完全隔离

    def _move(k, src, dst, aux):
        nonlocal count
        if k == 1:
            count += 1
            print(f"步骤 {count}: 移动盘子 1 从 {src} -> {dst}")
            return

        _move(k - 1, src, aux, dst)
        count += 1
        print(f"步骤 {count}: 移动盘子 {k} 从 {src} -> {dst}")
        _move(k - 1, aux, dst, src)

    _move(n, source, target, auxiliary)
    return count  # 调用结束后直接返回内部累积的步数
3.2 传递局部可变容器(列表引用)
Python 中列表、字典等可变对象在参数传递时传递的是对象的内存引用(Pass by Object Reference)。可以在函数入口处创建一个长度为 1 的列表 counter = [0] 并随着各级递归向下传递:
def hanoi_mutable(n, source='A', target='C', auxiliary='B', counter=None):
    """通过传递单元素列表作为累加器引用"""
    if counter is None:
        counter = [0]  # 初次调用在顶层创建容器对象

    if n == 1:
        counter[0] += 1
        print(f"第 {counter[0]} 步: 移动盘子 1 从 {source} -> {target}")
        return counter[0]

    hanoi_mutable(n - 1, source, auxiliary, target, counter)
    counter[0] += 1
    print(f"第 {counter[0]} 步: 移动盘子 {n} 从 {source} -> {target}")
    hanoi_mutable(n - 1, auxiliary, target, source, counter)

    return counter[0]
counter=None 并在函数内部初始化,不要直接写 def hanoi(..., counter=[0]),否则默认参数会在模块加载时常驻内存,导致多次调用时累加器无法清零。
四、方法三:生成器解耦(生产与消费分离)
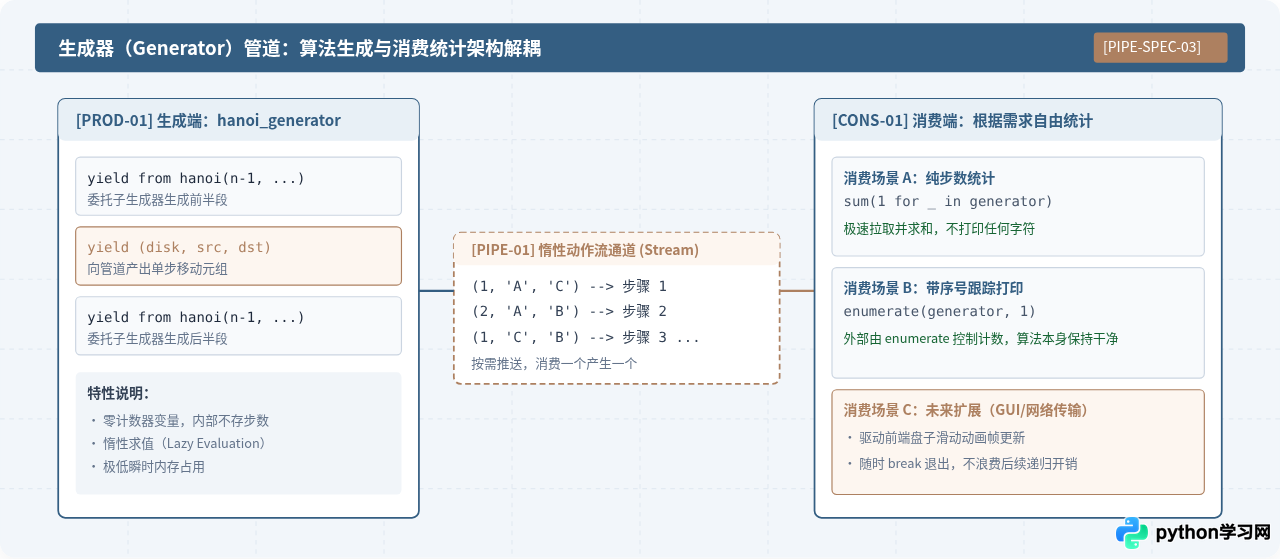
在现代化工业代码中,最推崇的解耦方案是将移动步骤的产生与步骤的消费统计完全分开。通过 Python 的 yield 和 yield from 语法,汉诺塔算法只负责产生移动动作序列,外部调用者根据实际需要自行决定是求总步数、逐行打印、还是接入可视化界面。
def hanoi_generator(n, source='A', target='C', auxiliary='B'):
    """
    生成器函数:按序产出每一次移动的元组 (盘号, 起始柱, 目标柱)
    算法自身零计数变量,完全解耦
    """
    if n == 1:
        yield (1, source, target)
        return

    # yield from 委托子生成器
    yield from hanoi_generator(n - 1, source, auxiliary, target)
    yield (n, source, target)
    yield from hanoi_generator(n - 1, auxiliary, target, source)

# 场景 1:如果仅需获取总移动步数,直接使用内建 sum 统计迭代次数
step_count = sum(1 for _ in hanoi_generator(4, 'A', 'C', 'B'))
print(f"4阶汉诺塔总步数: {step_count}")

# 场景 2:需要边打印边带编号输出时,搭配内置 enumerate
for idx, (disk, src, dst) in enumerate(hanoi_generator(3, 'A', 'C', 'B'), start=1):
    print(f"动作序号 {idx:02d}: 将盘子 {disk} 从 {src} 移至 {dst}")
五、补充:纯数学常数级直算(仅算步数不求过程)
如果业务场景完全不需要输出移动过程,仅仅想要得到 $n$ 个盘子对应的最小移动步数,那么运行递归算法反而是效率最低的(时间复杂度为 $O(2^n)$)。由前面的递归关系式 $T(n) = 2T(n-1) + 1$ 可直接通过数学归纳法推导出闭式解:
$$T(n) = 2^n - 1$$
在 Python 中,不仅可以直接使用幂运算符 2 ** n - 1,还可以利用高效的位运算操作 (1 << n) - 1,在 $O(1)$ 时间复杂度与空间复杂度内瞬时完成计算:
def hanoi_formula(n):
    """
    仅计算步数的数学闭式解
    时间复杂度: O(1)
    空间复杂度: O(1)
    """
    if n < 0:
        raise ValueError("盘子数量必须为非负整数")
    return (1 << n) - 1

# 即便面对 64 个盘子,也能在微秒内算出结果:
print("64个盘子的移动步数:", hanoi_formula(64))
# 输出: 18446744073709551615
六、方案横向对比与工程选型建议
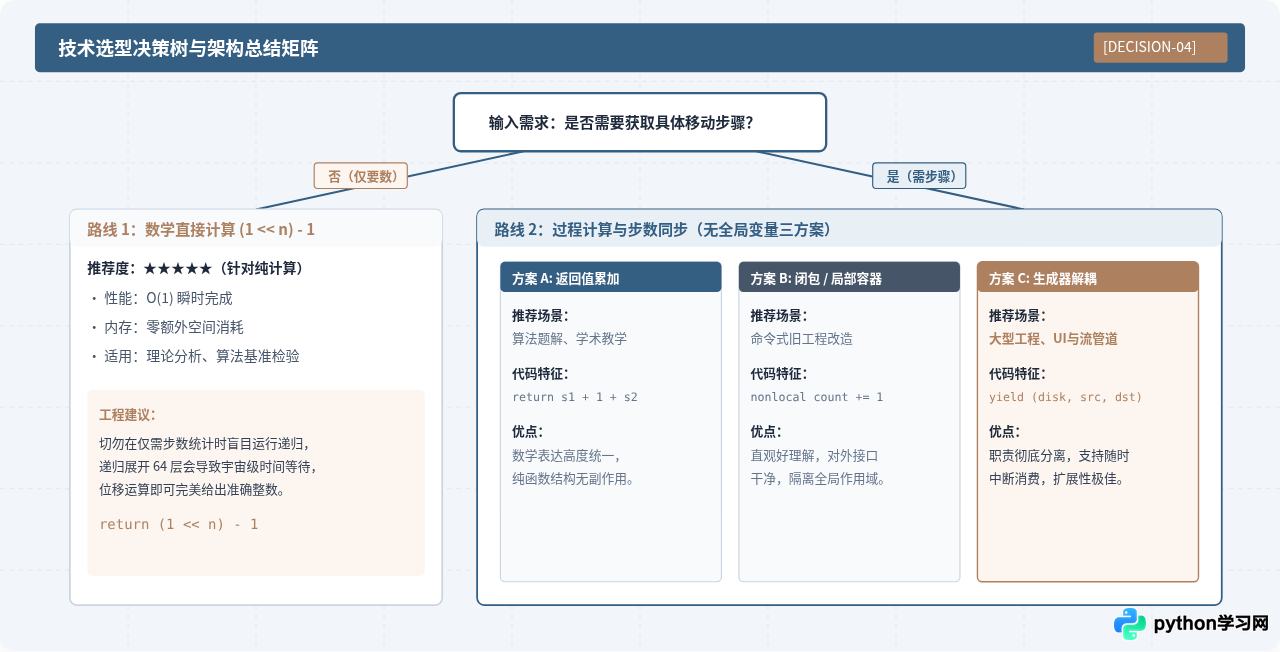
针对不同的实际开发场景,四种方案的适用边界与特性对比如下:
| 实现方案 | 函数纯度 | 时间复杂度 | 空间复杂度 | 适用典型场景 |
|---|---|---|---|---|
| 递归返回值累加 | 最高(纯函数) | $O(2^n)$ | $O(n)$ 栈空间 | 算法教学、规范函数式设计、需要同步验证过程 |
| 闭包 (nonlocal) | 高(局部受控) | $O(2^n)$ | $O(n)$ 栈空间 | 旧代码重构、希望保留命令式步进加一习惯 |
| 生成器 yield | 极高(完全解耦) | $O(2^n)$ | $O(n)$ 栈空间 | 工业级开发、UI动画驱动、流式日志记录、单步调试 |
| 数学公式 $(1 \ll n) - 1$ | 极高 | $O(1)$ | $O(1)$ | 仅需要统计步数数值,不需要具体移动步骤 |
七、注意事项与避坑指南
- 避免使用可变参数默认值:切勿使用
def hanoi(..., count=[0])。Python 的默认参数在函数定义时即完成求值,多个调用会共享该列表,退化为伪全局变量。 - 防范 Python 递归调用栈溢出:Python 默认的最大递归深度约为 1000(可通过
sys.getrecursionlimit()查看)。由于汉诺塔递归树深度等于盘子数量 $n$,如果 $n > 1000$,程序将抛出RecursionError。不过对于汉诺塔来说,$n=64$ 的步数已经是天文数字,通常不可能也不应该将如此巨大的 $n$ 投入递归模拟中。 - 保持职责单一:如果仅需要步数,使用数学常数级公式即可;如果需要模拟真实物理迁移,再选用递归返回值或生成器流式消费。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









