

Python开发者技能图谱:从入门到进阶的完整学习路线
系统梳理从Python核心语法、现代工程化规范、底层核心机制到生产级系统架构的完整开发者技能图谱与实战学习路径。
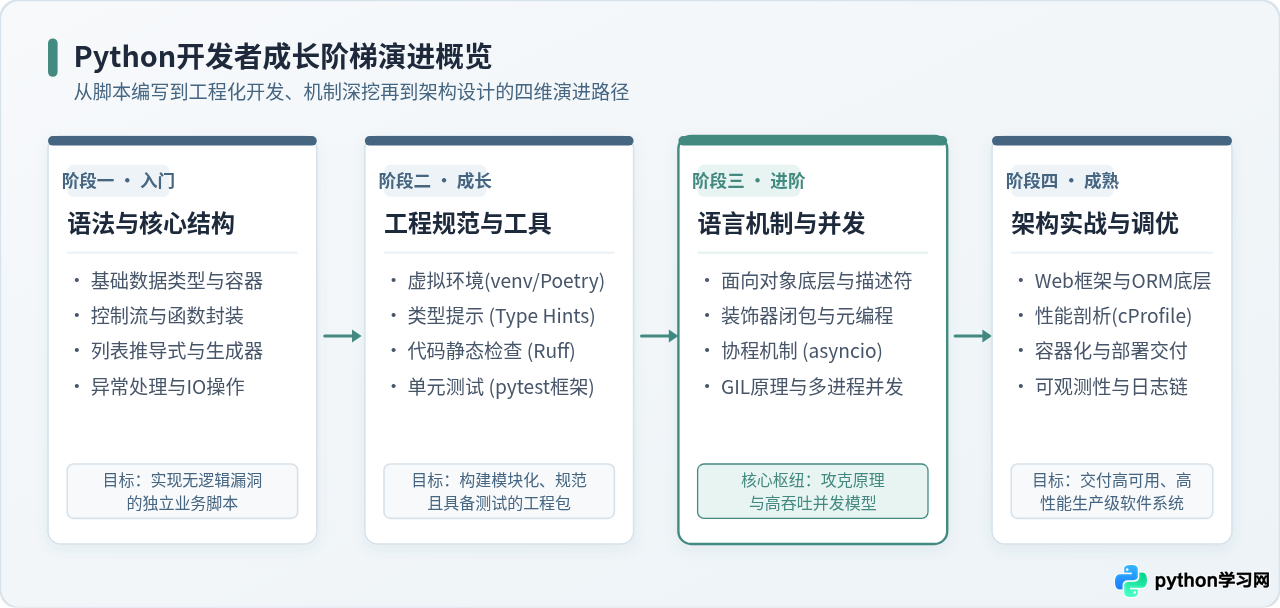
第一阶段:语言核心与语法基石(入门期)
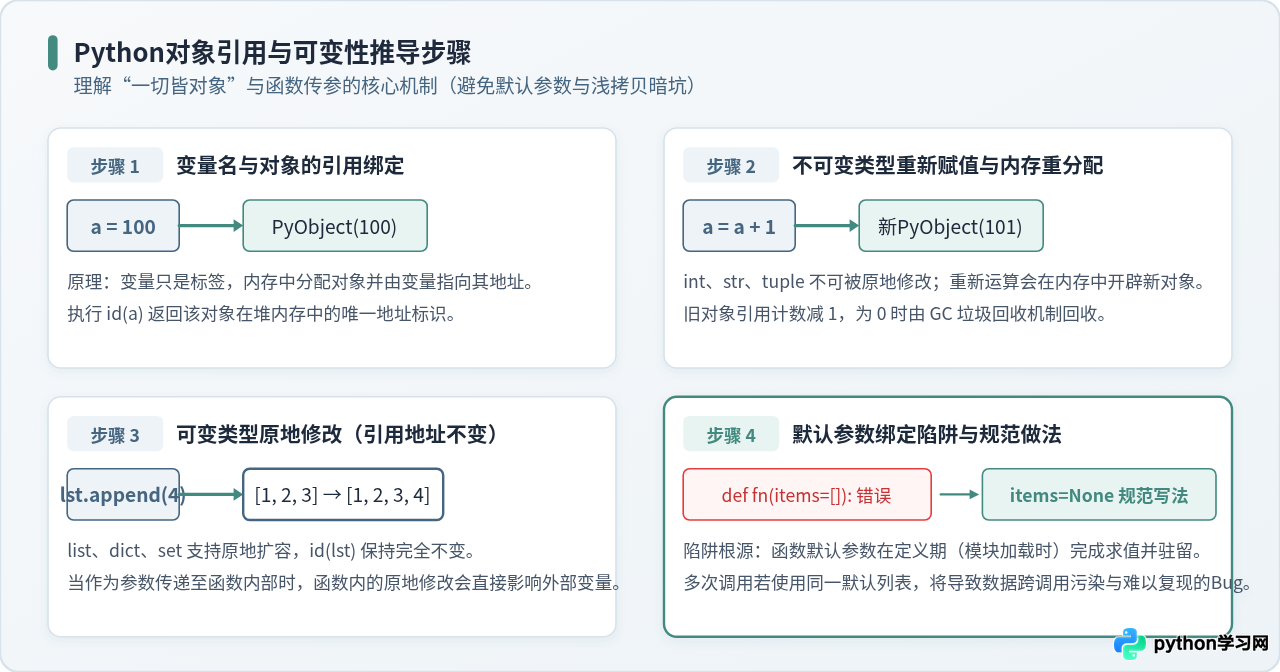
入门阶段的核心目标不是速通第三方库,而是建立准确的程序执行与内存心智模型。很多初学者在写复杂逻辑时频繁出现状态污染或浅拷贝 Bug,根源在于对 Python 的“变量标签模型”与“可变对象(Mutable)vs 不可变对象(Immutable)”理解不够深入。
1. 变量绑定与对象引用机制
在 Python 中,变量不是存储值的盒子,而是贴在对象上的标签。赋值语句 a = 100 表示在内存中创建整型对象 100,并将标签 a 绑定到该对象地址。当执行 b = a 时,两个变量指向完全相同的内存地址,可通过内置函数 id() 验证。
- 不可变对象:包括
int、float、str、tuple、frozenset。对其进行修改运算会生成全新的对象。 - 可变对象:包括
list、dict、set。可直接在原内存地址扩容或修改内部元素。
2. 核心基础陷阱:可变默认参数
函数的默认参数在 Python 模块加载定义时求值一次,且此后该函数对象常驻内存。如果使用可变对象作为默认值,后续调用的修改将在所有调用之间共享累加:
# 错误示例:默认参数在定义期被绑定,后续调用共享同一列表实例
def add_item_bad(item: str, target_list: list = []) -> list:
    target_list.append(item)
    return target_list

# 正确示例:使用 None 作为哨兵值,并在函数体内动态初始化
def add_item_good(item: str, target_list: list | None = None) -> list:
    if target_list is None:
        target_list = []
    target_list.append(item)
    return target_list
(x for x in data))替代冗长的循环;熟练掌握 with 上下文管理器安全读写文件;能准确分析嵌套数据结构的浅拷贝(copy.copy)与深拷贝(copy.deepcopy)区别。
第二阶段:现代工程化开发规范与工具链(成长期)
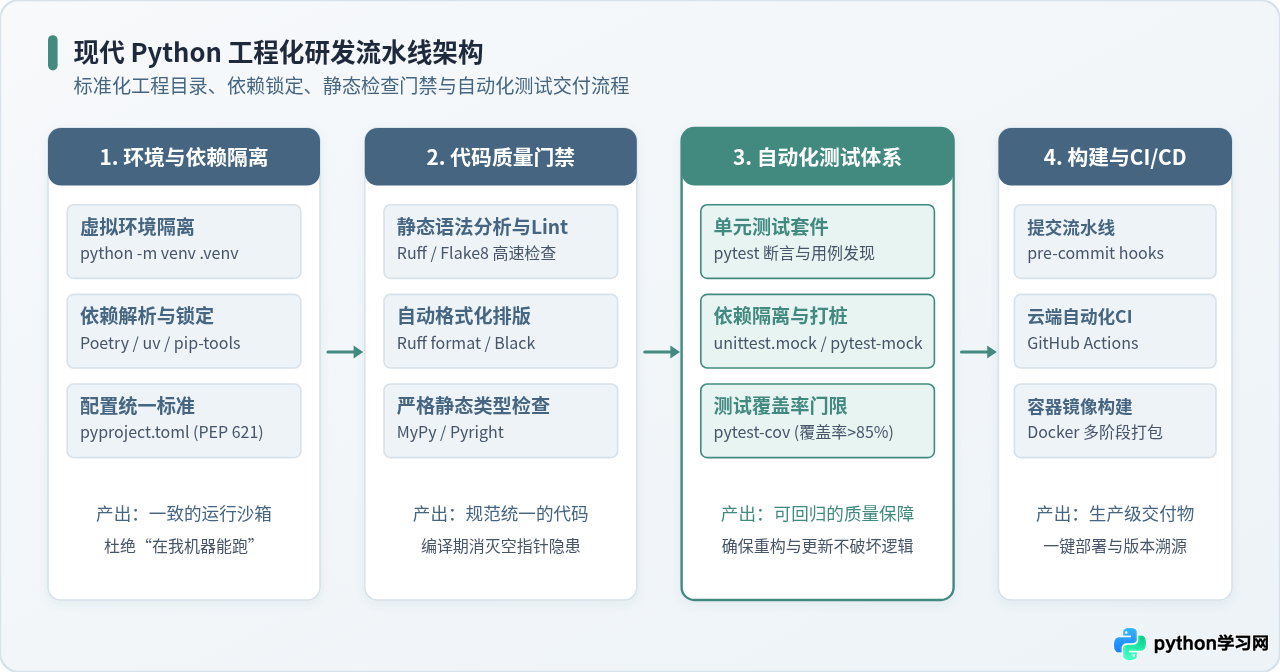
当项目规模从单一脚本扩大到多人协作的多模块项目时,单纯依赖语法知识已不足以保证软件质量。这一阶段的重点是建立现代 Python 工程化流水线,把规范固化在工具链中。
1. 依赖管理与项目隔离
生产环境坚决禁止使用全局 pip install。现代项目采用 PEP 621 规范的 pyproject.toml 作为项目声明核心,并使用具备精确依赖解析与锁定(Lockfile)的工具:
- 轻量级标准:使用 Python 内置的
python -m venv .venv创建虚拟环境,并使用pip-tools生成带哈希校验的requirements.txt。 - 一体化工程方案:使用
Poetry或基于 Rust 编写的高性能工具uv,统一管理依赖解析、构建发布与虚拟环境。
2. 静态类型提示(Type Hints)与静态检查
动态类型为原型开发带来敏捷,但也会在运行时带来 AttributeError 与 NoneType 异常。通过引入静态类型提示与 MyPy / Pyright 检查,可以在代码提交前拦截 80% 以上的基础类型错误:
from typing import TypedDict

class UserProfile(TypedDict):
    uid: int
    username: str
    is_active: bool

def parse_user(raw_data: dict[str, object]) -> UserProfile:
    # 显式校验与类型转换,杜绝隐式类型漂移
    uid_val = int(raw_data["uid"])
    username_val = str(raw_data["username"])
    active_val = bool(raw_data.get("is_active", True))
    return {"uid": uid_val, "username": username_val, "is_active": active_val}
3. 自动化测试与 CI 门禁
放弃手动打印(print)调试,全面采用 pytest 编写单元测试与集成测试。配合 unittest.mock 对外部网络请求、数据库 I/O 进行桩函数隔离,确保本地与 CI(持续集成)流水线测试稳定运行。
第三阶段:进阶核心机制与并发模型(突破期)
跨越初中级分水岭的关键,在于能够透彻理解 CPython 的底层运作机理。面对高负载网络请求或高密集数据计算时,能够根据瓶颈本质准确选择并发方案。
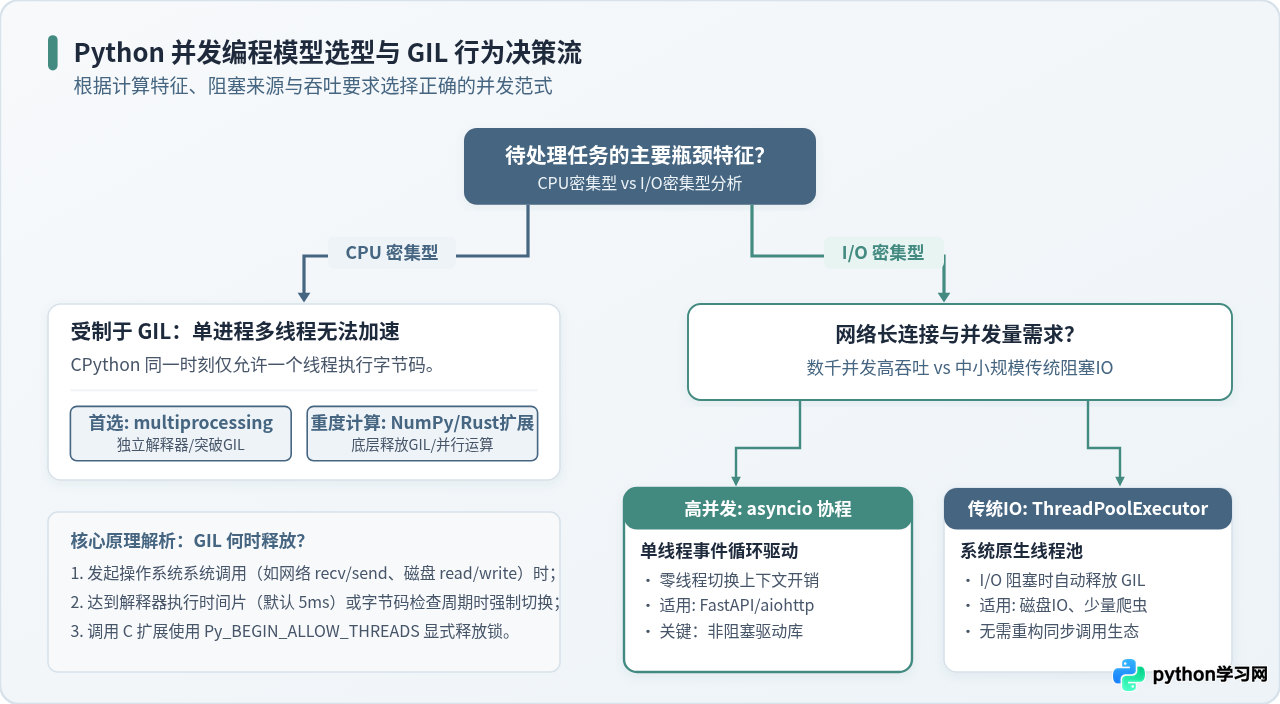
1. 理解 GIL(全局解释器锁)与并发选型
CPython 为了保证多线程下引用计数与内存分配的线程安全,引入了 GIL(Global Interpreter Lock)。GIL 意味着在任意单个时刻,仅有一个线程能执行 Python 字节码。
| 并发方案 | 适用场景 | 能否突破 GIL 限制 | 主要优势与成本 |
|---|---|---|---|
multiprocessing 多进程 |
CPU 密集型(图像处理、加密计算) | 是(每个进程拥有独立 Python 解释器与 GIL) | 充分利用多核 CPU;进程间通信(IPC)与内存开销较大 |
asyncio 异步协程 |
高并发网络 I/O(API 服务、爬虫) | 否(运行在单线程内,基于事件循环调度) | 轻量高效,数万并发仅占用几十兆内存;不可有阻塞同步调用 |
concurrent.futures.ThreadPoolExecutor |
传统阻塞 I/O(文件读写、简单并发调用) | 否(I/O 阻塞时系统底层自动释放 GIL) | 易于改造成型同步代码;受限于线程上下文切换开销(适合数十到百级线程) |
2. 异步协程实战范式
使用 asyncio 时必须避免在事件循环中执行耗时的 CPU 计算或同步阻塞调用(如 time.sleep() 或同步 requests.get()),否则会导致整个事件循环挂起:
import asyncio

async def fetch_metric(metric_id: int) -> dict[str, int]:
    # 模拟非阻塞网络 I/O
    await asyncio.sleep(0.1)
    return {"id": metric_id, "value": metric_id * 10}

async def main() -> None:
    # 使用 TaskGroup (Python 3.11+) 安全并发收集结果,支持结构化并发与异常聚合
    async with asyncio.TaskGroup() as tg:
        tasks = [tg.create_task(fetch_metric(i)) for i in range(5)]
    results = [t.result() for t in tasks]
    print(f"聚合结果数量: {len(results)}")

if __name__ == "__main__":
    asyncio.run(main())
3. 面向对象进阶与元编程
- 魔术方法(Dunder Methods):深入理解
__call__(对象可调用)、__getitem__(实现序列协议)、__enter__/__exit__(资源管理上下文)。 - 描述符机制(Descriptor):理解
__get__与__set__协议,掌握@property、ORM 字段映射以及数据校验框架(如 Pydantic)的底层工作原理。 - 装饰器与闭包:掌握带参数装饰器、类装饰器,以及使用
functools.wraps保持函数签名与文档完整性。
第四阶段:领域实战与生产级系统架构(成熟期)
进入高级阶段后,技术栈从“语言本身”向“生产级系统化能力”迁移。无论是专注 Web 后端微服务、数据平台还是系统自动化开发,都必须掌握以下四个架构维度:
- 数据持久层性能与可靠性:掌握 SQLAlchemy 2.0 异步驱动与连接池参数调优,深刻理解 N+1 查询隐患、事务隔离级别与乐观锁方案。
- 分布式任务与缓存机制:掌握 Redis 缓存失效保护(穿透、击穿、雪崩),运用 Celery / RQ 构建高吞吐异步作业队列与重试补偿机制。
- 性能分析与热点诊断:使用
cProfile分析 CPU 瓶颈,使用tracemalloc排查内存泄漏,结合scalene生成可视化性能分析报告。 - 系统可观测性与部署交付:结构化日志(如
structlog)、接入 OpenTelemetry 追踪调用链,采用多阶段构建的 Docker 镜像进行容器化部署。
学习路线全景总结与能力验收清单
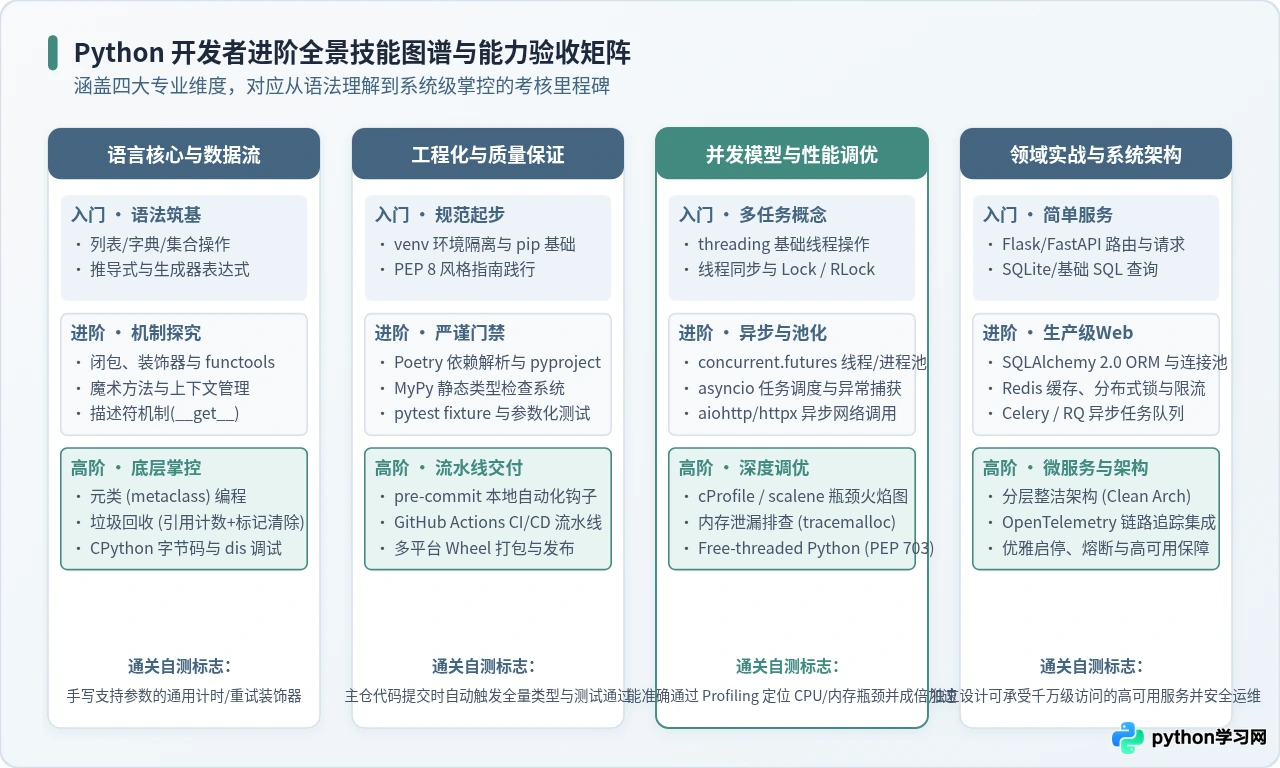
掌握 Python 并不是把每个第三方库的 API 都死记硬背,而是建立起从语言执行原理、工具链规范到架构选型的系统化思维。下表图示汇总了四个维度的关键通关自测标志。
常见学习误区警示
- 误区一:只顾搬砖调库,回避语言底层。很多开发者会写 FastAPI 或 Pandas 代码,但遇到并发卡死或内存暴涨时毫无排查头绪。建议在阶段二和阶段三投入充分精力研读对象模型与并发机制。
- 误区二:过度工程化与滥用元编程。不要在简单业务中盲目使用元类或深层抽象继承,Python 社区崇尚“显式优于隐式(Explicit is better than implicit)”,简单清晰永远是第一准则。
- 误区三:忽视单元测试与类型定义。代码写得快并不等于开发效率高,缺少类型约束与自动化回归测试的工程项目,在业务演进到后期将产生巨大的重构与维护成本。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









