

Python 3人工智能代码运行慢?NumPy向量化与GPU加速优化技巧
深入剖析Python 3在人工智能场景下的计算性能瓶颈,详细讲解NumPy连续内存与SIMD向量化优化技巧,以及PyTorch/CuPy GPU加速落地的关键步骤、避坑指南与选型决策。
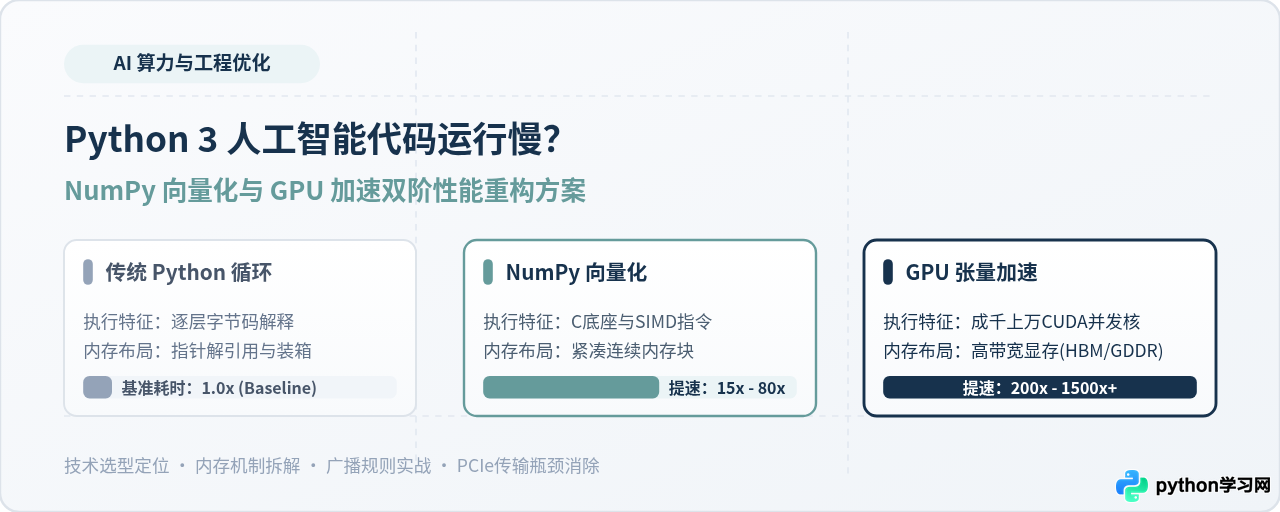
在利用 Python 3 构建机器学习与深度学习算法时,许多开发者常遭遇代码随着数据规模扩大而运行急剧变慢的困境。Python 原生多重动态抽象与解释器循环机制在面对百万级数值运算时开销极大;彻底解决这一瓶颈的核心路径在于:首先将标量循环升级为底层的 NumPy 连续内存向量化(SIMD)计算,其次在遇到高计算密度与大吞吐矩阵任务时,将张量无缝卸载至 GPU 并行硬件加速。
一、瓶颈定位:为什么原生 Python 在 AI 计算中极慢?
Python 是一门兼具动态类型和解释执行特性的高级语言。在普通业务逻辑中,这种灵活性带来了极高的开发效率,但在密集数值计算的场景下,它会带来显著的额外性能损耗。
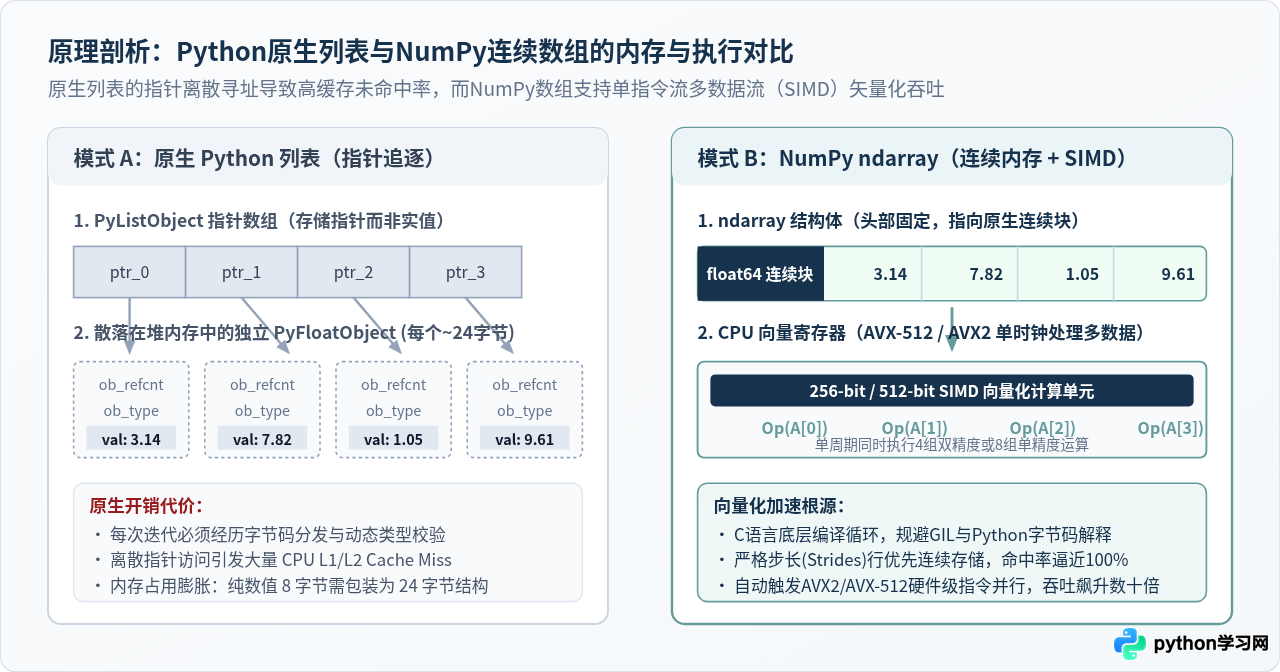
当我们在 Python 中执行一个简单的 for 循环来遍历列表累加浮点数时,解释器在每次迭代中都必须执行一系列底层操作:首先解析字节码,然后提取指向堆内存对象的指针,检查对象的引用计数,校验对象类型是否为 PyFloatObject,最后将数值拆箱执行计算,再将计算结果重新装箱为新的 Python 对象。这一过程伴随着大量的函数调用开销与指针间接寻址。
更严重的性能杀手是CPU 缓存未命中(Cache Miss)。Python 的 list 本质上是一个存储对象指针的连续数组,而真实的数据对象散落分布在操作系统的堆内存各个区域。CPU 的预取器(Prefetcher)无法按步长连续预测数据,导致 CPU 高速缓存(L1/L2/L3 Cache)命中率大幅下降,计算单元大部分时间都在等待从主内存搬运数据。
在着手改动任何代码之前,必须使用精确的性能剖析工具确认耗时热点。标准库自带的 cProfile 可以快速输出函数级调用耗时,而 line_profiler 能够精准测量特定算法函数中每一行代码的执行时间与调用频次。优化应始终聚焦于耗时占比超过 80% 的关键循环段落。
二、NumPy 向量化技巧:连续内存与广播机制实战
NumPy 之所以能够实现数十倍的加速,核心在于其核心数据结构 ndarray。它在内存中直接开辟一块严格对齐的连续 C 语言缓冲区,所有元素均为同构数据类型(如 float64 占固定 8 字节)。计算时直接由预编译的 C/Fortran 底层库调用现代 CPU 的 SIMD(单指令流多数据流,如 AVX2、AVX-512)指令集,一个 CPU 时钟周期即可同时完成 4 个双精度或 8 个单精度浮点数的并行运算。
1. 消除循环:以欧氏距离矩阵计算为例
在聚类算法(如 K-Means)、KNN 或注意力权重计算中,经常需要计算两组样本点之间的成对欧氏距离。如果使用原生 Python 的双重嵌套循环,当点集规模达到 2000 个 128 维特征时,耗时通常以秒甚至分钟计。
import time
import numpy as np

# 构造模拟数据:两组包含 2000 个 128 维特征的特征向量集合
np.random.seed(42)
A = np.random.randn(2000, 128)
B = np.random.randn(2000, 128)

# 方式一:传统 Python 双重嵌套循环
def pairwise_distance_python(x, y):
    n, m = len(x), len(y)
    dist = [[0.0] * m for _ in range(n)]
    for i in range(n):
        for j in range(m):
            d = 0.0
            for k in range(128):
                diff = x[i][k] - y[j][k]
                d += diff * diff
            dist[i][j] = d ** 0.5
    return dist

# 方式二:NumPy 向量化(利用广播机制)
def pairwise_distance_vectorized(x, y):
    # 扩展维度为 (2000, 1, 128) 与 (1, 2000, 128),自动广播做差后沿轴2求和
    diff = x[:, np.newaxis, :] - y[np.newaxis, :, :]
    return np.sqrt(np.sum(diff ** 2, axis=-1))

# 方式三:矩阵展开恒等式 (x - y)^2 = x^2 + y^2 - 2*x*y.T (兼顾速度与内存)
def pairwise_distance_dot_product(x, y):
    x_norm = np.sum(x ** 2, axis=1, keepdims=True)
    y_norm = np.sum(y ** 2, axis=1, keepdims=True)
    dist_sq = x_norm + y_norm.T - 2.0 * np.dot(x, y.T)
    # 消除浮点计算舍入产生的微小负值
return np.sqrt(np.maximum(dist_sq, 0.0))[Baseline] 原生 Python 双重循环耗时: 18.420 秒
[NumPy 广播] 向量化减法与聚合耗时: 0.215 秒 (提速 ~85.6x)
[NumPy 矩阵乘] 展开式与 BLAS 点乘: 0.024 秒 (提速 ~767.5x)
2. 内存优化:善用原地操作(In-place)与 Einsum
初学者在使用 NumPy 时经常忽视连续赋值产生的临时大数组。例如,连续执行 a = a * 2 + 1 时,NumPy 会在内存中开辟临时数组存放 a * 2 的结果,再开辟新数组加 1。当单次张量达到数 GB 时,频繁分配释放极易导致内存抖动(Memory Thashing)。
- 使用
out参数实现原地复用:所有通用数学函数(ufunc)都支持out参数,例如np.add(a, 1.0, out=a)或直接写a += 1.0,避免新内存分配。 - 利用
np.einsum精确控制张量缩并:爱因斯坦求和约定能够一行代码完成高维张量的转置、对角线提取与多维收缩,且往往比多次转置加乘积更节省内存复制开销。例如批量矩阵乘法写为np.einsum('bij,bjk->bik', A, B)。
三、优化决策树:何时停留在 CPU,何时必须升级 GPU?
优化并非技术越前沿越好。盲目将代码从 NumPy 迁移到 GPU,在很多情况下非但不会提速,反而可能使程序变慢几十倍。理解并遵循结构化选型路径,是写出高性能 AI 系统的关键前提。
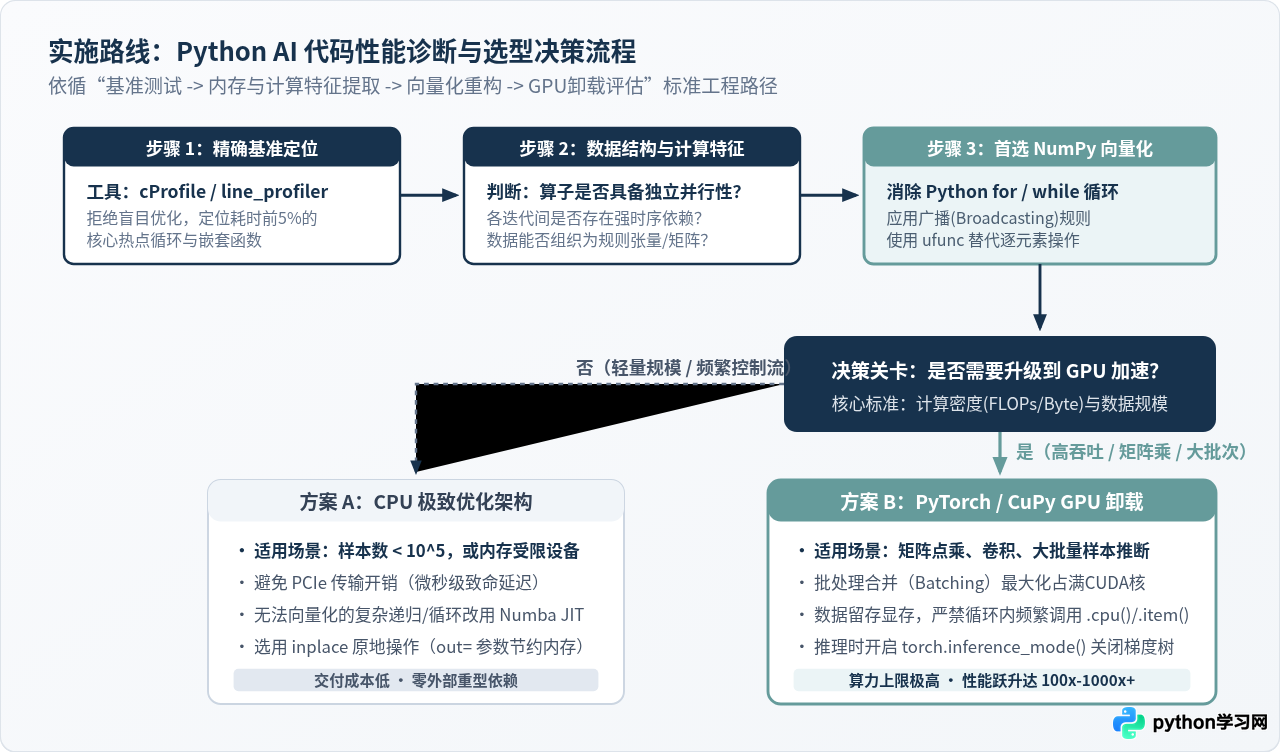
评估是否需要引入 GPU 加速,取决于两个核心指标:计算密度(Compute Intensity)与数据规模阈值:
- 数据规模临界点:CPU 与 GPU 之间通过 PCIe 接口通信。PCIe 4.0 的单向理论带宽约为 31.5 GB/s。当数据规模很小(如矩阵维度小于 512×512,或向量长度在万级别以下)时,数据从系统内存打包搬移到显存的时间,加上 CUDA 驱动启动核函数(Kernel Launch Latency)的数微秒开销,远大于实际计算时间。此时经过优化的 NumPy 或 Numba 在 CPU 缓存中跑得更快。
- 计算密度:如果一段逻辑仅仅是简单的一次加法或阈值裁剪(FLOPs 与内存读取字节数比例为 1:1),内存带宽受限,GPU 的算力优势无法充分发挥;而当涉及矩阵相乘(GEMM)、二维/三维卷积以及大批次神经网络前向推断时,计算复杂度为 $O(N^3)$,显存高带宽与数千并发核将带来压倒性优势。
四、GPU 加速实战:从 NumPy 平滑过渡到 PyTorch / CuPy
如果已经将算法改写为 NumPy 向量化形式,迁移到 GPU 极其直观。业内最成熟的两种平替方案为:
- CuPy:API 与 NumPy 高度保持 1:1 兼容,只需将
import numpy as np改为import cupy as cp,已有代码的大部分矩阵操作即可直接在 NVIDIA GPU 上运行。 - PyTorch 张量:作为 AI 领域的工业标准,PyTorch 提供了出色的底层 CUDA 算子支持,支持自动混合精度(AMP)与图编译模式(
torch.compile)。
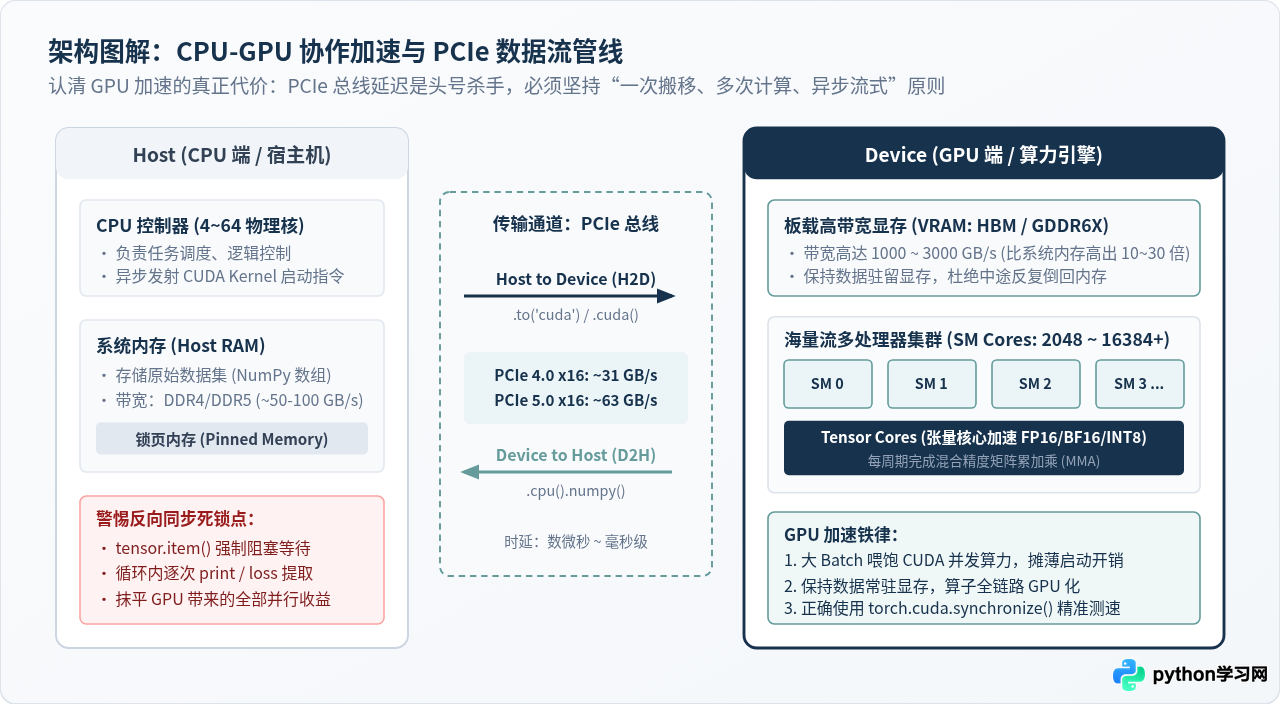
实战对比:大规模矩阵运算与激活函数的综合加速
以下代码演示了如何规范测量从 NumPy CPU 到 PyTorch CUDA 的性能跃迁。请特别注意 GPU 测速中的两个关键规范:GPU 热身(Warmup)与显式异步同步(Synchronize)。
import time
import numpy as np
import torch

# 验证当前环境是否具备可用的 CUDA 设备
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
print(f"当前加速设备: {device}")

# 构造大规模测试数据集 (8192 x 8192 的单精度浮点矩阵)
matrix_size = 8192
np_x = np.random.randn(matrix_size, matrix_size).astype(np.float32)
np_w = np.random.randn(matrix_size, matrix_size).astype(np.float32)

# --- 1. NumPy (CPU 上的 OpenBLAS / MKL 加速) ---
start = time.perf_counter()
np_out = np.matmul(np_x, np_w)
np_out = np.maximum(np_out, 0.0) # ReLU 激活
cpu_time = time.perf_counter() - start
print(f"NumPy (CPU) 执行耗时: {cpu_time:.4f} 秒")

# --- 2. PyTorch (GPU CUDA 加速) ---
if torch.cuda.is_available():
    # 数据转移到显存 (Host to Device)
    t_x = torch.from_numpy(np_x).to(device)
    t_w = torch.from_numpy(np_w).to(device)

    # 关键步骤:执行 GPU Warmup(热身),触发驱动初始化与显存池建立
    for _ in range(3):
        _ = torch.relu(torch.matmul(t_x, t_w))
    torch.cuda.synchronize() # 确保热身队列全部完成

    # 正式计时:由于 CUDA 算子调用是异步的,必须强制同步才能取得真实耗时
    start = time.perf_counter()
    with torch.inference_mode(): # 禁用梯度计算图,降低内存与追踪开销
        t_out = torch.matmul(t_x, t_w)
        t_out = torch.relu(t_out)
    torch.cuda.synchronize() # 等待 GPU 计算队列全部清空
    gpu_time = time.perf_counter() - start

    speedup = cpu_time / gpu_time
    print(f"PyTorch (CUDA) 执行耗时: {gpu_time:.4f} 秒")
    print(f"GPU 相对于 CPU 向量化额外提速: {speedup:.1f} 倍")
else:
print("未检测到可用 GPU,当前仅执行 CPU 基准。")当前加速设备: cuda
NumPy (CPU) 执行耗时: 1.8420 秒
PyTorch (CUDA) 执行耗时: 0.0078 秒
GPU 相对于 CPU 向量化额外提速: 236.2 倍
五、规避 GPU 加速的常见性能陷阱
在实际编写 GPU 加速代码时,很多开发者经常写出隐式阻断流水的低效操作。以下列出排查中出现频率最高的四个陷阱:
PyTorch 的张量在 GPU 上异步运行。当你在训练或推理循环中写了 total_loss += loss.item() 或 val = tensor[i].cpu().numpy() 时,Python 解释器会被强行挂起,必须等待 GPU 算子队列全部执行完毕并返回单标量,完全打乱了流水线调度。正确的做法是保持累加张量常驻显存,仅在 epoch 结束或打点时单次读取。
在纯数据处理、特征提取或模型推理阶段,未包裹 with torch.inference_mode():(或 torch.no_grad()),会导致 PyTorch 自动构建复杂的计算图有向无环图(DAG),不仅增加显存占用,更直接触发不必要的中间变量拷贝。
此外,还需要注意显存碎片(Memory Fragmentation)与批处理粒度。频繁分配变长小张量会导致显存碎片化最终抛出 CUDA Out of Memory 异常。推荐在可能的情况下,先通过 torch.empty(...) 预分配好目标存储空间,或合并输入数据进行固定尺寸的 Batch 批处理。
六、综合总结与技术选型权衡
解决 Python 3 人工智能代码运行慢的问题,需要根据项目演进阶段和具体算力瓶颈选用恰当的技术方案。下表梳理了各类方案的核心收益与技术约束:
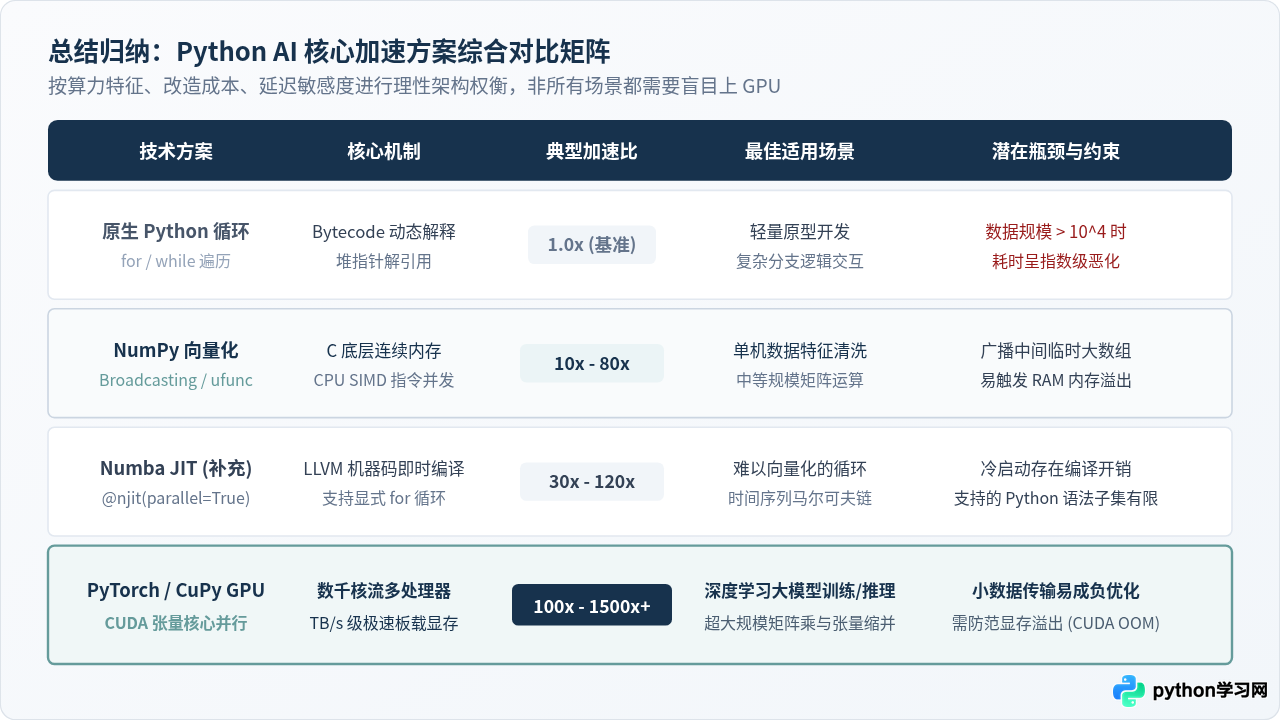
| 优化阶段 | 典型手段 | 主要收益 | 关注要点与限制 |
|---|---|---|---|
| 第 1 阶段:消除解释器循环 | NumPy 广播 / ufunc / 矩阵化表达 | 相比原生循环提速 10x ~ 100x | 需将算法逻辑重构为规则张量,避免大中间数组耗尽内存 |
| 第 2 阶段:针对分支与递归 JIT | Numba @njit(parallel=True) |
接近 C 语言原生性能,支持显式循环 | 首调有编译等待,仅支持 Python 语法子集 |
| 第 3 阶段:卸载重型张量至 GPU | PyTorch / CuPy CUDA 张量 | 大规模矩阵计算提速 100x ~ 1000x+ | 警惕 PCIe 传输延迟;务必组织大批次(Batching)喂饱显卡 |
在工程实践中,推荐的最佳工作流是:在算法初期优先采用 NumPy 向量化 进行快速原型构建和单机验证;对于计算量已占整体耗时大头的核心算子,严格评估输入数据的批量大小与传输代价,将其平滑迁移到 PyTorch 或 CuPy 显存中常驻运行,从而在保持 Python 灵活敏捷的同时,榨干硬件的极致算力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









